 AIREITER
Seit August 2026 ist der Vergleich Qwen 3.8 vs. Kimi K3 weniger eine Frage nach dem pauschal besseren Modell als nach dem Einsatzszenario. Die Gewichte beider Familien stehen zum Download bereit, die jeweiligen Flaggschiffe sind allgemein verfügbar. Kimi K3 besitzt die stärkste verifizierte Bilanz bei agentischem Coding, Qwen 3.8 Max ist beim Tokenpreis vorn – und Qwens Apache-2.0-Modell mit 27B läuft auf einer einzelnen Consumer-GPU. Der Haken bei Kimi: Das „offene“ Flaggschiff soll als Checkpoint 1,56 TB groß sein. Offene Gewichte bedeuten also nicht automatisch praktikables Self-Hosting.
Das wurde mit Qwen 3.8 und Kimi K3 tatsächlich veröffentlicht
Kimi K3 (Moonshot AI) erschien am 16. Juli 2026 als einzelnes Flaggschiff: ein MoE-Modell mit 2,8 Billionen Parametern und 104B aktiven Parametern pro Token, Kimi Delta Attention plus Gated MLA, einem Kontextfenster von 1.048.576 Tokens und nativer Bildverarbeitung. Die Gewichte und ein technischer Bericht folgten am 27. Juli unter der angepassten Kimi K3 License. Die von Emergent zusammengefassten Bedingungen enthalten Auflagen für kommerzielle Reseller im großen Maßstab und Produkte mit mehr als 100 Millionen monatlichen Nutzern.
Alibaba stellte dem nicht ein einzelnes Modell, sondern eine Familie gegenüber. Qwen 3.8 Max ging am 19. Juli als Vorschau an den Start und war ab 3. August auf QwenCloud allgemein verfügbar, mit 2,4T Gesamtparametern und rund 95B aktiven Parametern. Um den 12. August erschienen die Gewichte auf Hugging Face als Qwen/Qwen3.8-2.4T-A95B, unter einer angepassten qwen3.8-max-Lizenz. Wenige Tage später kam Qwen/Qwen3.8-27B: ein dichtes 27B-Vision-Language-Modell unter Apache-2.0 mit nativem 262K-Kontext, der sich via YaRN auf 1M erweitern lässt (von Yotta Labs auf den 13.–14. August datiert).
| Kimi K3 | Qwen 3.8 Max | Qwen3.8-27B | |
|---|---|---|---|
| Parameter gesamt / aktiv | 2.8T / 104B | 2.4T / ~95B | 27B dicht |
| Kontext | 1.048.576 | 1M (991.8K maximaler Input) | 262K nativ, 1M via YaRN |
| Lizenz | Kimi K3 License (angepasst) | Angepasste qwen3.8-max-Lizenz | Apache-2.0 |
| Gewichte verfügbar seit | 27. Juli 2026 | ~12. August 2026 | ~13.–14. August 2026 |
| Vision-Input | Text + Bild (formell) | Text, Bild, Video per API | Text, Bild, Video |
Moonshot hat laut Berichten innerhalb von 48 Stunden nach dem K3-Release neue Consumer-Abonnements pausiert, weil die Nachfrage die GPU-Kapazität überstieg. Das sollte man im Hinterkopf behalten, bevor man ein Produkt vollständig auf einen Anbieter stützt.
Benchmarks: Herstellerwerte und unabhängige Messungen getrennt betrachtet
Beide Anbieter veröffentlichen umfangreiche Benchmark-Tabellen – und beide vermischen darin unterschiedliche Harnesses. Auf Kimis eigener Modellkarte wird ausdrücklich darauf hingewiesen, dass Vergleichswerte anderer Modelle aus verschiedenen Agent-Harnesses stammen und teils auf H20- statt H100-Hardware ermittelt wurden. Die gemeinsamen Zeilen unten sind daher Herstellerangaben, keine auditierten Ergebnisse.
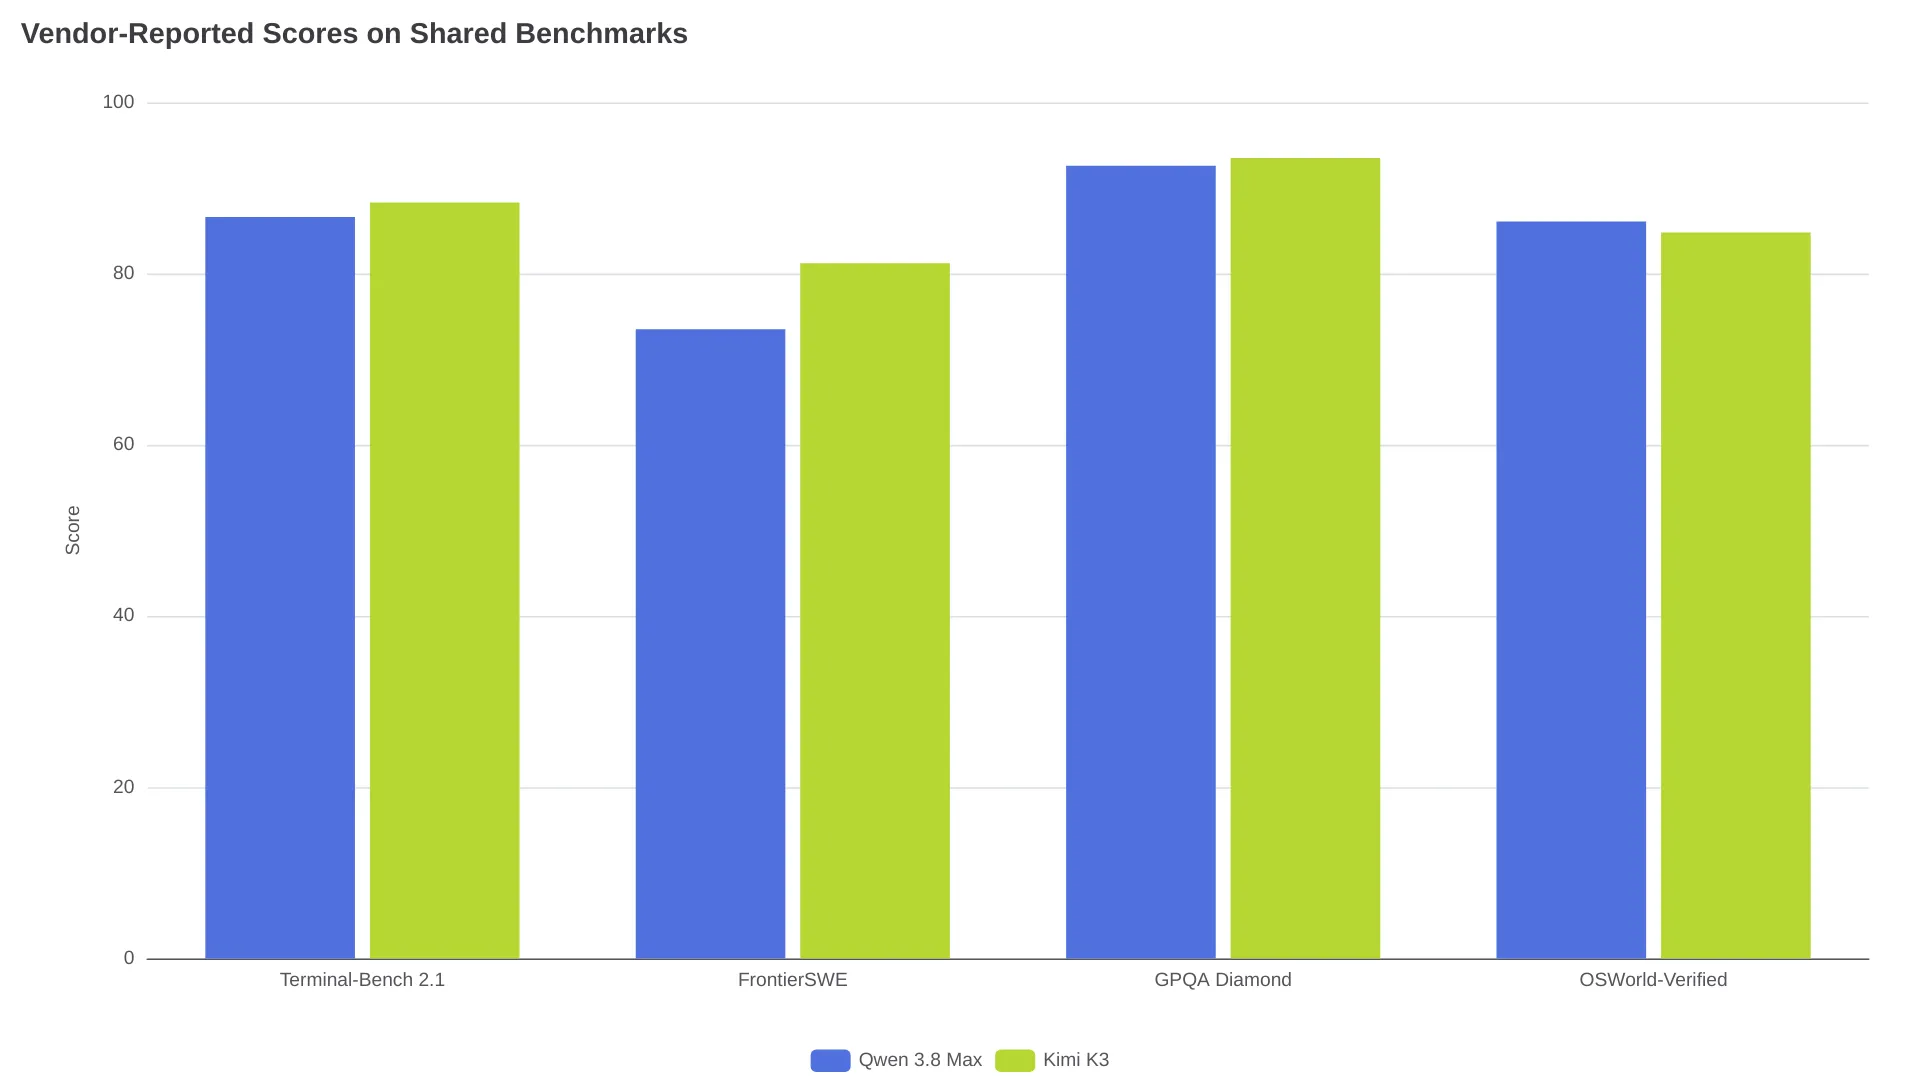
In diesen gemeinsamen Zeilen liegt Kimi K3 bei agentischem Coding vorn: Laut seiner Modellkarte erreicht es bei FrontierSWE 81.2 statt 73.5 und bei Terminal-Bench 2.1 88.3 statt 86.6 (Qwen-Seite: die Modellkarte des 2.4T-Modells). Qwens Launch-Unterlagen nennen dagegen 86.1 bei OSWorld-Verified gegenüber 84.8 auf K3s Karte. Außerdem weist die Qwen-Karte Einzelwerte aus, darunter PaperBench 93.0, IFBench 82.8 und SWE-bench Pro 67.7. K3 nennt seinerseits SWE-Marathon 42.0, BrowseComp 91.2 und MCPMark-Verified 94.5 in Kategorien, für die Qwen keine Werte veröffentlicht.
Bei unabhängigen Daten ist die Lage bislang eindeutig. Das Tracking von Emergent führt Kimi K3 zum Start mit einem Artificial Analysis Intelligence Index von 57 und in der aktuellen Indexversion mit 60, hinter Claude Fable 5 und GPT-5.6 Sol. Der Vergleich von Orcarouter ergänzt einen ersten Platz in der Frontend Code Arena mit 1,679 Elo. Qwen 3.8 Max war zum Launch nicht unabhängig indexiert. Der Tracker von cheapestinference.com meldete 53 als Wert des Artificial-Analysis-Index; Community-Beiträge, die ein Update auf 56 behaupten, sind weiterhin unbestätigt.
Im einzigen direkten Vergleich auf derselben Aufgabe, TrilogyAIs StackPerf-Architekturanalyse (von Orcarouter dokumentiert), erreichte K3 am Preview-Endpunkt 83/100 gegenüber 80/100 für Qwen. Qwen kam auf 354 Repository-Zitate gegenüber 274 bei Kimi, 22 Gateway-Anfragen gegenüber 53 bei Kimi und null fehlgeschlagene Tool-Aufrufe gegenüber zwei bei Kimi.
Eine Zeile fehlt in den gemeinsamen Tabellen: Auf Qwens eigener Modellkarte erzielt der 27B bei OSWorld-Verified 84.3, K3 liegt laut seiner Karte bei 84.8. Damit liegt ein dichtes 27B-Modell bei Computer Use weniger als einen halben Punkt hinter einem 2,8T-Flaggschiff. Beim Coding spielt es nicht in K3s Liga – Terminal-Bench: 73.0 gegenüber 88.3 –, doch LiveCodeBench v6 mit 90.3 und SWE-bench Pro mit 61.7 machen es zu einem ernstzunehmenden Arbeitstier. Ein praxisnaher Vergleichsthread auf r/AISEOInsider zeichnet dasselbe Bild: Qwen gewann häufiger bei One-Shot-Builds, Kimi zog vorbei, sobald Kontext und Überarbeitungstiefe zunahmen.
API-Kosten: $15 für Output und der Preis des Reasonings
Die Listenpreise zeigen klar in eine Richtung. In der Praxis fällt der Abstand noch stärker aus, weil beide Modelle standardmäßig intensiv nachdenken – K3 mit reasoning_effort: max, Qwen mit xhigh – und Reasoning-Tokens als Output abgerechnet werden.
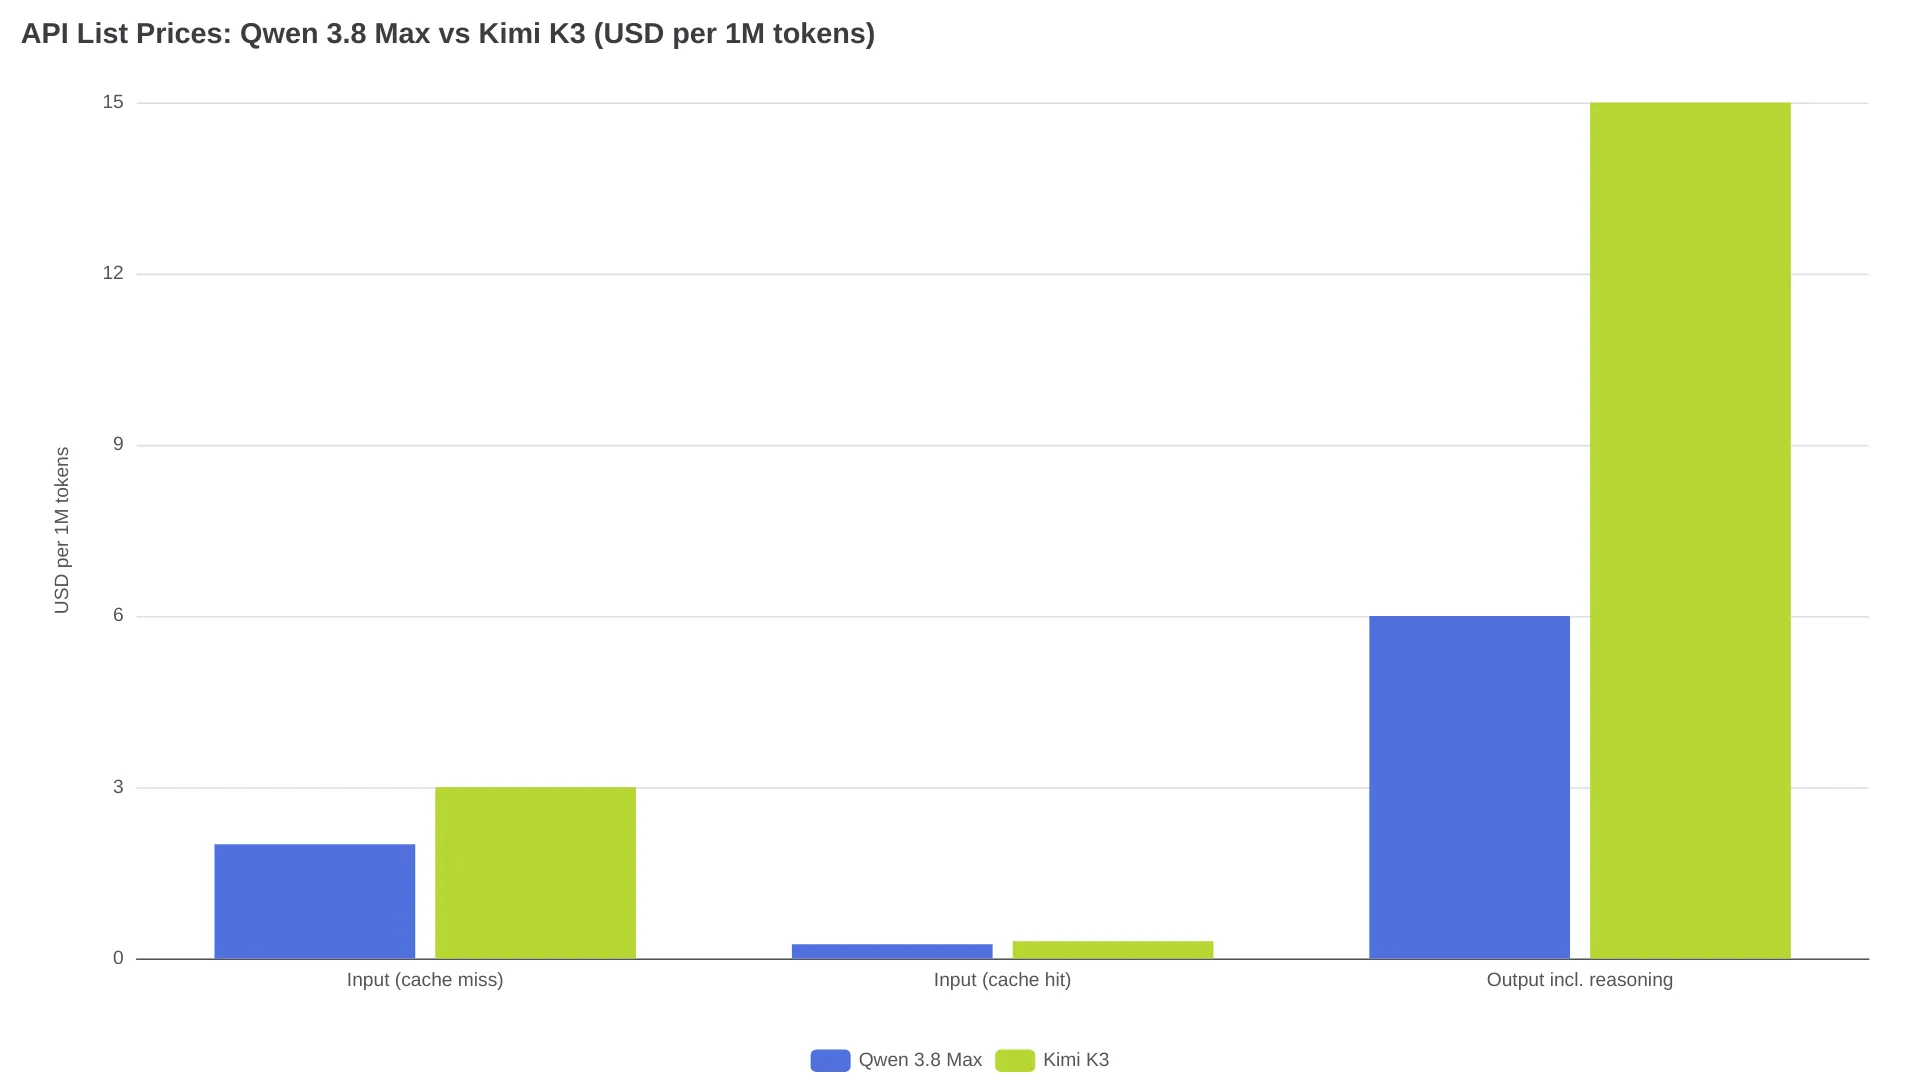
| Pro 1 Mio. Tokens | Qwen 3.8 Max (QwenCloud) | Kimi K3 (Moonshot) |
|---|---|---|
| Input (Cache-Miss) | $2.00 | $3.00 |
| Input (Cache-Hit) | $0.25 | $0.30 |
| Output, inklusive Reasoning | $6.00 | $15.00 |
| Explizites Cache-Erstellen / -Lesen | $2.50 / $0.17 | — |
Zwei durchgerechnete Sessions zu den Listenpreisen vom August 2026:
| Session | Qwen 3.8 Max | Kimi K3 | Abstand |
|---|---|---|---|
| Agentisches Coding: 500K Input (60 % gecacht), 40K Output | $0.72 | $1.29 | 1.8× |
| Dokumentenpipeline mit frischem Kontext: 2M Input, 100K Output | $4.60 | $7.50 | 1.6× |
Daraus ergibt sich eine einfache Routing-Regel: K3 sollte nur dann zum Zug kommen, wenn seine Akzeptanzrate für Ihren Workload die von Qwen um mehr als den Tokenkostenabstand von rund 1.8× übertrifft. Moonshot selbst bietet die günstigere Alternative an: Kimi K2.7 Code für $0.95 Input / $4.00 Output bei 256K Kontext. Die billigste Coding-Route der Kimi-Familie ist also nicht K3. Wer K3 heute routet, findet hier den API-Endpunkt zu den veröffentlichten Moonshot-Tarifen. Die Preisdetails beider Seiten sind zudem in der Preisanalyse zu Qwen3.8-Max und im Kimi-K3-Preisleitfaden aufgeschlüsselt.
Self-Hosting: 1,56 TB gegen eine RTX 4090
Bei den offenen Gewichten liegen die beiden Ansätze um ungefähr zwei Größenordnungen auseinander.
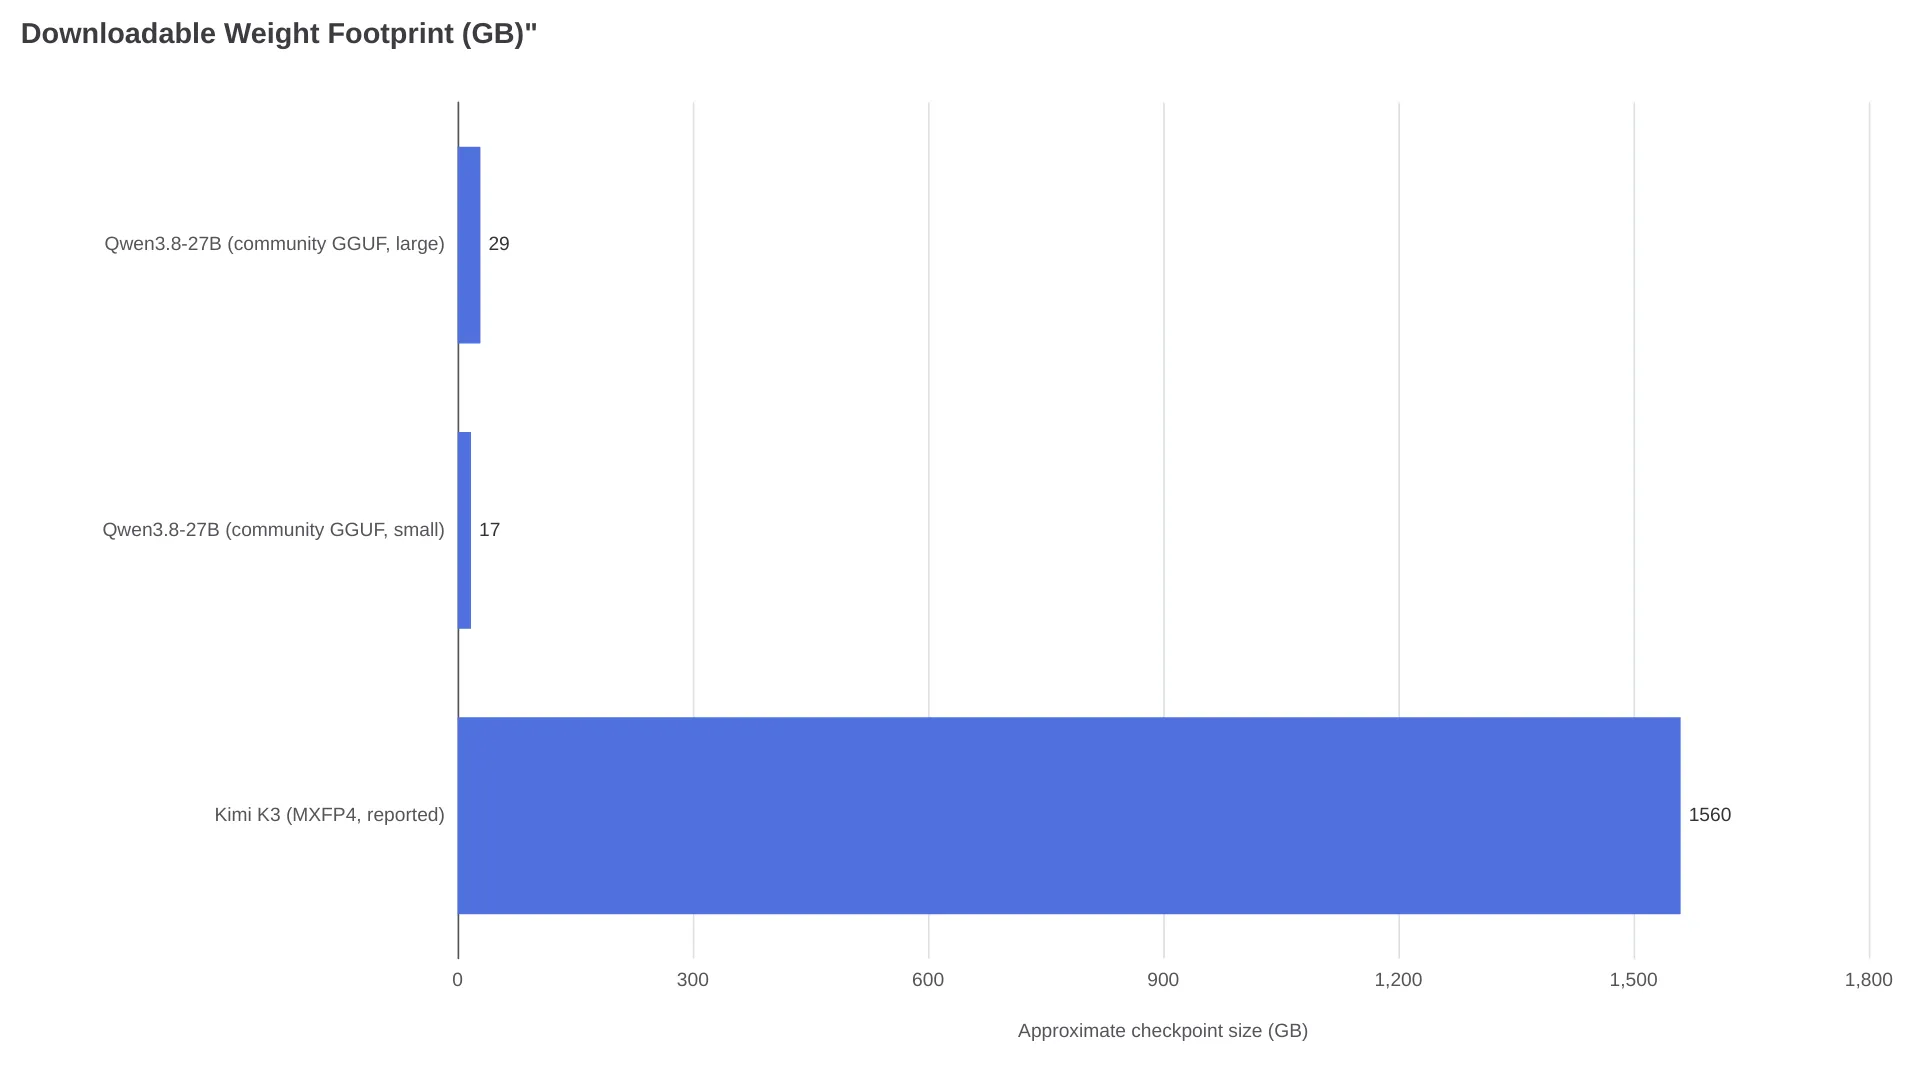
K3 wird mit quantisierungsbewussten MXFP4-Gewichten ausgeliefert (Modellkarte). Ein Checkpoint, der mit 1,56 TB angegeben wird, ist jedoch ein Cluster-Projekt. Dieselbe Quelle empfiehlt vLLM über 64 oder mehr Beschleuniger. Das ist ein spürbarer Mietposten, bevor auch nur ein Token ausgeliefert wurde – zusätzlich zu den Bedingungen der Lizenz für große Einsatzszenarien.
Der 27B erzählt die gegenteilige Geschichte. Community-GGUF-Builds reichen ungefähr von 8.5 GB bis 28.9 GB, die dynamischen GGUF- und NVFP4-Builds von Unsloth kommen mit rund 17 GB als Minimum aus, und für Server-Deployments gibt es eine offizielle FP8-Variante. Das Modell läuft auf Hardware, die viele bereits besitzen:
„Qwen3.8-27B bei 160K Kontext auf EINER RTX 4090 – 47–57 tok/s, vollständiges GPU-Offload“ – Deployment-Beitrag auf r/Qwen_AI
Die Max-Gewichte liegen zwischen diesen Extremen. Qwen3.8-2.4T-A95B und die FP8-Variante lassen sich unter der angepassten qwen3.8-max-Lizenz herunterladen. Das offene Artefakt verarbeitet allerdings nur Text, und sein Thinking lässt sich nicht deaktivieren. Bild-Input, ein Non-Thinking-Modus und der standardmäßige 1M-Kontext gehören zur QwenCloud-API-Schicht, nicht zum Checkpoint. Welche Fähigkeiten der 27B je Quantisierung bietet und wo seine Grenzen liegen, zeigen die Runtime- und VRAM-Tabellen im Qwen3.8-27B-Feldführer. Die Gewichtsveröffentlichung von K3 behandelt der Beitrag zu den offenen Kimi-K3-Gewichten.
Integrationsdetails, die Agent-Projekte entscheiden
Drei Verhaltensweisen auf Ebene der Modellkarten können leicht einen ganzen Debugging-Tag kosten, wenn sie erst in Produktion auffallen.
| Modell | Verhalten / Grenze | Folge für die Implementierung |
|---|---|---|
| Kimi K3 | Thinking ist immer aktiv; Multi-Turn- und Tool-Use-Clients müssen die vollständige vorherige Assistant-Nachricht erneut senden, einschließlich reasoning_content und tool_calls (Karte) | Ohne Reasoning-Trace verschlechtern sich Agent-Schleifen; mit Trace steigen die Kosten mit der Länge der Schleife |
| Qwen3.8-27B | preserve_thinking ist standardmäßig aktiv; reasoning_effort lässt sich auf medium/low senken; YaRN über 262K hinaus ist statische Skalierung (Karte) | Eine Deaktivierung pro Request wird unterstützt; laut Karte verkürzt geringerer Aufwand die End-to-End-Zeit nicht immer, weil Retries die Ersparnis aufzehren; YaRN nur für lange Jobs aktivieren |
| Qwen 3.8 Max vs. K3 Limits | Max: 991.8K Input / 131.07K Output (QwenCloud); K3: 1.048.576 Input / standardmäßig 131K Output, ansteigend in Richtung 1M | Kein „1M-Kontext“-Versprechen garantiert 1M nutzbaren Output; ein Needle-Test eines Drittanbieters fand 18/18 Fakten bei 248K und testete nichts darüber hinaus |
FAQ
Ist Qwen 3.8 fürs Coding besser als Kimi K3?
Nach der derzeit verfügbaren Datenlage: nein. Kimi K3 führt bei den entscheidenden Zeilen für agentisches Coding (FrontierSWE 81.2 vs. 73.5, Terminal-Bench 2.1 88.3 vs. 86.6) und besitzt die einzigen unabhängigen Indexwerte. Qwen 3.8 Max liegt bei Terminal-Aufgaben nah dran und ist pro Token sowie in den modellierten Sessions günstiger. Der 27B gehört dagegen in eine völlig andere Gewichtsklasse.
Was ist günstiger: Qwen 3.8 oder Kimi K3?
Qwen 3.8 Max liegt bei jeder Listenpreiszeile vorn: $2 statt $3 für Input, $6 statt $15 für Output. Da beide Modelle standardmäßig aktives Reasoning als Output abrechnen, wächst Kimis Nachteil mit der Aufgabenschwierigkeit – in der obigen Rechnung auf etwa 1.8× bei einer gecachten agentischen Session.
Lassen sie sich selbst hosten und unter welchen Lizenzen?
Ja, alle drei Checkpoints stehen zum Download bereit. Qwen3.8-27B ist Apache-2.0-lizenziert und passt quantisiert auf eine einzelne 24-GB-GPU. Kimi K3 benötigt für seinen rund 1,56-TB-MXFP4-Checkpoint Hardware im Cluster-Maßstab und steht unter der angepassten Kimi K3 License. Die Gewichte von Qwen3.8-Max sind als Qwen3.8-2.4T-A95B unter der angepassten qwen3.8-max-Lizenz öffentlich verfügbar.
Ist das 1M-Kontextfenster bei beiden real?
In etwa. Kimi K3 spezifiziert 1.048.576 Tokens. Qwen 3.8 Max nennt 1M, bei maximal 991.8K Input. Der 27B unterstützt nativ 262.144 und erreicht 1M nur über YaRN-Skalierung, die Qualität bei kurzen Kontexten kostet. Eine unabhängige Überprüfung gibt es lediglich auf dem 248K-Niveau.
Die Empfehlung – und was sie ändern würde
| Ihr Einsatzbereich | Empfehlung | Warum |
|---|---|---|
| API-Coding-Agents, Qualität zuerst | Kimi K3 | FrontierSWE 81.2, Terminal-Bench 88.3, AA-verifiziert 60 |
| API-Aufgaben mit relevantem Budget, dokumenten-/visionlastig | Qwen 3.8 Max | $6 statt $15 für Output, OSWorld 86.1, expliziter Cache für $0.17/Read |
| Self-Hosting auf vorhandener Hardware | Qwen3.8-27B | Apache-2.0, ~17–29-GB-Quants, 160K Kontext auf einer RTX 4090 |
| Ein Frontier-Flaggschiff selbst hosten | Kimi K3 | Der einzige offene Checkpoint hier mit unabhängigen Frontier-Class-Werten – ein Cluster gehört ins Budget |
Zwei Entwicklungen könnten Teile dieser Tabelle kippen: eine unabhängige Bewertung von Qwen 3.8 Max – die tracker-gemeldeten 53 gegenüber Kimis verifizierten 60 stehen auf schmaler Datenbasis – sowie veröffentlichte Bedingungen für die angepasste qwen3.8-max-Lizenz. Bis eines davon vorliegt, behandelt der direkte API-Vergleich Qwen 3.8 Max vs. Kimi K3 den reinen API-Einsatz ausführlicher.
Weiterführende Artikel: Qwen3.8-27B: Was bestätigt ist und was mit 17GB wirklich läuft · Kimi K3 Open Weights · Qwen 3.8 Max vs Kimi K3: API Edition