 AIREITER
Ein Leaderboard kann zeigen, dass zwei Spracherkenner praktisch gleichauf liegen. Monsoon ergänzt die entscheidende Frage: Gleichauf für welche Sprecher, Regionen, Geräte und Schreibweisen? Die neuen Evaluierungssets für en-IN und hi-IN machen das Open ASR Leaderboard für die mehrsprachige ASR-Bewertung deutlich aussagekräftiger. Die kurzen öffentlichen Aufnahmen verlangen bei der Interpretation aber weiterhin etwas Vorsicht.
Kurz gesagt: Monsoon zeigt, warum Modelle im Leaderboard auseinanderliegen
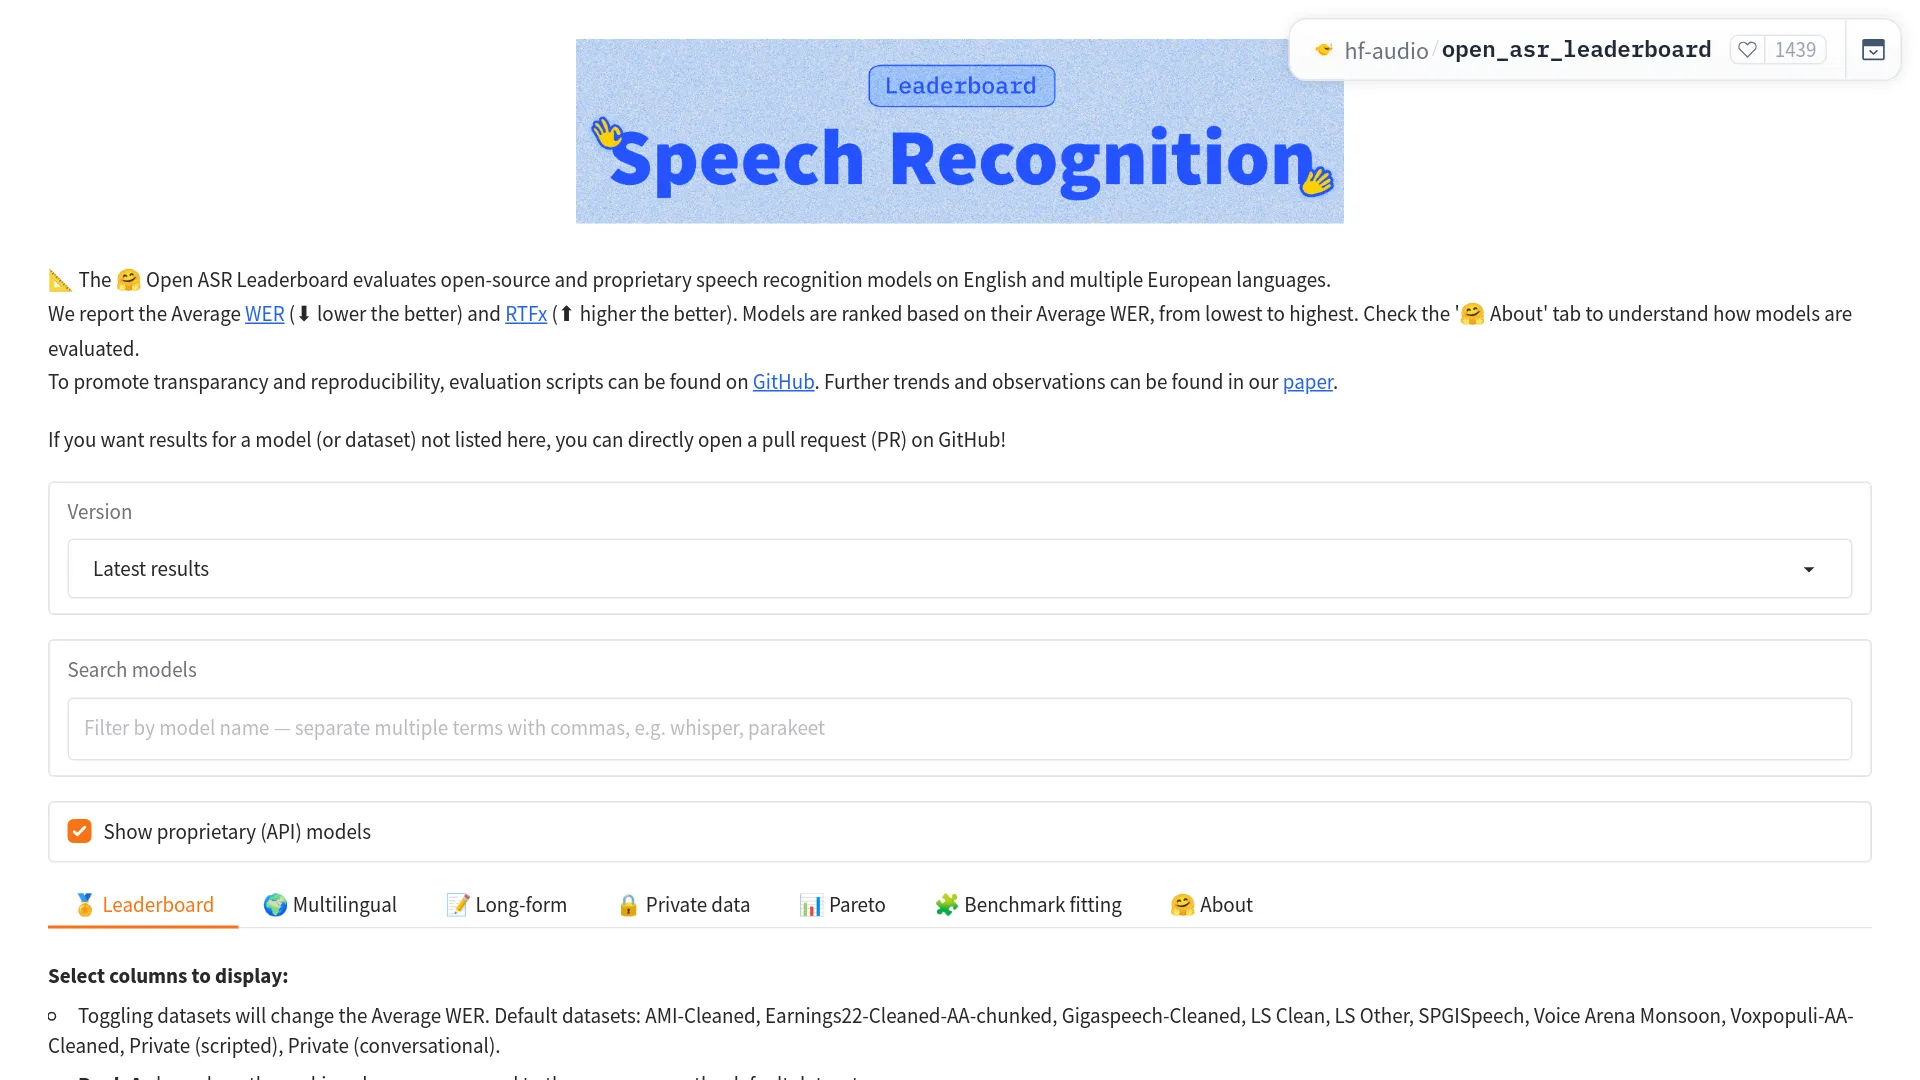
Das Open ASR Leaderboard enthält jetzt zwei Voice-Arena-Evaluierungssets: Monsoon en-IN für Indian English und Monsoon hi-IN für Hindi. Indian English fließt in die Spalten des Haupt-Leaderboards und in den zentral angezeigten Average WER ein. Hindi ist in der mehrsprachigen Ansicht zu finden. Dort muss ein Modell alle ausgewählten Sprachen abdecken, um in die multilingualen Rankings aufgenommen zu werden.
Die vier öffentlichen und privaten Splits umfassen 4.888 sprechergetrennte Sprecher und erfassen zwölf sprecherbezogene Merkmale aus den Bereichen Demografie, Hintergrund, Geografie und Mobilgeräte. Damit lässt sich über die Frage „Welches Modell erreicht den niedrigsten durchschnittlichen WER?“ hinausgehen: Man kann prüfen, wo ein Modell weniger stabil arbeitet. Für die regionale Robustheit und die Bewertung von Hindi-Transkripten ist Monsoon ein wichtiger Schritt nach vorn – aber weder eine Produktionsgarantie noch eine landesweit repräsentative Messung für jede indische Sprache.
Das bringt Monsoon ins Open ASR Leaderboard
Monsoon ergänzt vier Test-Splits, die über dieselbe Pipeline für spontane, dialogorientierte Sprache gesammelt wurden. Für jede Sprache gibt es einen öffentlichen Split zur Reproduktion und einen privaten Split, der benchmark-spezifisches Tuning erschweren soll. Die offizielle Ankündigung bezeichnet die Veröffentlichung als erste Ergänzung einer indischen Sprache im mehrsprachigen Kontext dieses Leaderboards.
Die vier Splits im Überblick
| Split | Audio | Sprecher | Clips | Ursprungsbezirke | Bundesstaaten / Union Territories | Geräte | Referenzformat |
|---|---|---|---|---|---|---|---|
| Monsoon en-IN public | 5.62 h | 1,444 | 2,102 | 428 | 24 / 6 | 556 | Normalisierter Text mit Sprechunflüssigkeiten |
| Monsoon en-IN private | 5.58 h | 1,405 | Nicht öffentlich | 420 | 24 / 6 | 560 | Normalisierter Text mit Sprechunflüssigkeiten |
| Monsoon hi-IN public | 1.33 h | 468 | 753 | 202 | 11 / 3 | 315 | Lattice akzeptierter Varianten |
| Monsoon hi-IN private | 4.47 h | 1,571 | Nicht öffentlich | 295 | 12 / 3 | 582 | Lattice akzeptierter Varianten |
Die öffentliche Monsoon-en-IN-Dataset-Card nennt Audio mit 16 kHz, eine durchschnittliche Clip-Länge von 9,6 Sekunden und einen Median von 10,4 Sekunden. Laut Monsoon-hi-IN-Card liegen Mittelwert und Median im öffentlichen Split bei 6,4 beziehungsweise 5,0 Sekunden. Zusammengenommen ergeben die vier Splits 17.00 Stunden. Monsoon ist damit ein auf Vielfalt ausgelegter Benchmark aus kurzen Gesprächssegmenten – kein Datensatz für lange Telefonate.
Öffentliche Daten zur Reproduktion, private Daten für echte Generalisierung
Die öffentlichen Splits lassen sich von Hugging Face laden. Danach kann ein Erkenner ausgeführt, seine Ausgabe normalisiert und ein Score auf Korpusebene berechnet werden. Für en-IN müssen die gesamten Einfüge-, Lösch- und Ersetzungsfehler durch die Gesamtzahl der Referenzwörter geteilt werden; ein Durchschnitt aus den WER-Werten einzelner Clips ist laut Dataset-Card nicht vorgesehen.
Für Hindi stellt die öffentliche Card den lattice-basierten voi-oiwer-Scorer bereit. Ein minimales Lademuster sieht so aus:
from datasets import load_dataset
from voi_oiwer import oiwer

hi = load_dataset(
    "VoiceArena/MonsoonASR-Open-ASR-leaderboard-hi-IN",
    split="test",
)
hypothesis = "replace with your model output for hi[0]"
result = oiwer(hypothesis, hi[0]["lattice"], "hindi")
score, (ins, dele, sub), ref_words = result[0], result[4], result[5]
Die privaten Splits bleiben zurückgehalten und sind ebenfalls sprechergetrennt. So kann ein Modellteam nicht gezielt auf einzelne Beispiele hin optimieren. Das Design mit privaten Daten führt die Ergebnisse in separaten aggregierten Ansichten, statt das öffentliche Standardranking neu zu definieren.
Die Sprecherabdeckung ist die wichtigste Neuerung
Der öffentliche en-IN-Split umfasst 1.444 Sprecher mit 2.102 Clips, der öffentliche hi-IN-Split 468 Sprecher mit 753 Clips. Laut Abdeckungstabelle der offiziellen Ankündigung entfallen auf die zehn größten Beiträger über alle vier Splits hinweg lediglich 2,8 % bis 6,8 % der Gesamtdauer.
Damit sinkt das Risiko, dass ein besonders aktiver Sprecher, ein bestimmtes Mikrofon oder ein einzelner Aufnahmestil den Score dominiert. Repräsentativ wird die Stichprobe dadurch allerdings nicht automatisch. Die zwölf erfassten Merkmale umfassen Geschlecht, Geburtsdatum, Beruf, Bildungsstand, Familienstand, Einkommen, Ursprungsbezirk und -bundesstaat, aktuelle Stadt, Jahre im aktuellen Bezirk, Gerätehersteller und Gerätemodell.
Indian English ist eine geografische Verteilung – kein einzelner Akzent
Der öffentliche en-IN-Split deckt 428 Ursprungsbezirke, 30 Bundesstaaten und Union Territories, 641 aktuelle Städte sowie 556 Handymodelle ab. Die regionale Verteilung umfasst den Süden mit 35 %, den Osten mit 18 %, Zentralindien mit 18 %, den Norden mit 16 % und den Westen mit 11 %. Kein einzelner Bundesstaat stellt laut der Hugging-Face-Ankündigung mehr als 13 % der Sprecher.
Mit den Feldern native_district, native_state, current_city, years_spent_in_current_district, device_manufacturer und device_model lassen sich regionale und gerätebezogene Teilmengen vergleichen. „Indian English“ steht also weder für eine einzelne Mikrofonbedingung noch für einen einzigen Akzent. Ein Modell kann auf einer regionalen Sprachverteilung stark und auf einer anderen weniger stabil sein – und trotzdem einen konkurrenzfähigen Gesamt-WER erreichen.
Hindi hat eine andere Abdeckung – und ein anderes Scoring-Problem
Der öffentliche Hindi-Split ist kleiner: 1,33 Stunden, 468 Sprecher, 202 Bezirke und 315 Handymodelle. Die Hindi-Daten konzentrieren sich auf den Hindi-Gürtel; laut Ankündigung stammen rund 40 % der Hindi-Sprecher aus Uttar Pradesh. Das ist ein wichtiger Kontext für die Einordnung eines Hindi-Ergebnisses, zeigt aber nicht, dass alle Hindi-sprechenden Gemeinschaften gleich stark vertreten sind.
Hinzu kommen englische Lehnwörter, Code-Switching, zusammen- oder getrennt geschriebene Komposita, unterschiedliche Schreibweisen in Devanagari und romanisierte Varianten. Die hi-IN-Dataset-Card speichert deshalb ein Lattice, in dem für jeden Abschnitt eines Transkripts mehrere akzeptierte Schreibweisen hinterlegt sein können.
Regionale Fehler zeigen Unterschiede, die der Gesamt-WER verdeckt
Das offizielle regionale Beispiel basiert auf dem öffentlichen Indian-English-Split. Acht Modelle liegen zwischen 4.81 und 4.99 WER – eine Differenz von gerade einmal 0.18 Punkten. Die Ankündigung weist darauf hin, dass ein Testset von ungefähr fünf Stunden einen so kleinen Unterschied möglicherweise nicht zuverlässig auflösen kann.
Wird derselbe Datensatz jedoch nach fünf geografischen Zonen aufgeschlüsselt, ergibt sich ein anderes Bild der Modellstabilität:
| Modell | Gesamtbeobachtung | Regionale Spannweite | Konkretes regionales Ergebnis |
|---|---|---|---|
openai/whisper-large-v3-turbo | Insgesamt konkurrenzfähiger Score | 0.46 WER-Punkte | Schwächste Region im Beispiel nicht genannt |
mistralai/Voxtral-Mini-3B-2507 | Insgesamt 0.14 Punkte hinter Whisper | 1.68 WER-Punkte | 4.38 Zentralindien gegenüber 6.06 Osten |
ibm-granite/granite-speech-3.3-2b | Teil der regionalen Analyse | Nicht berichtet | Der Norden war die schwächste Region |
microsoft/VibeVoice-ASR-HF | Teil der regionalen Analyse | Nicht berichtet | Der Süden war die schwächste Region |
Die größere Spannweite bedeutet, dass Voxtral regional variabler arbeitet – nicht, dass viermal so viele Transkriptionsfehler auftreten. Außerdem unterscheiden sich die schwächsten Regionen je nach Modell. Das deutet auf modellspezifische Empfindlichkeiten hin, beweist aber nicht deren Ursache.
Der Nutzer @FoucqueThomas hob nach der Veröffentlichung denselben Unterschied hervor:
„⚡ L'Open ASR Leaderboard ajoute l'hindi et l'anglais indien (4 888 locuteurs, 12 attributs/clip). Résultat : deux modèles quasi identiques sur le WER global affichent jusqu'à ~4x d'écart selon la région du locuteur. Un benchmark enfin honnête sur la diversité vocale.“ — @FoucqueThomas on X
Wenn die eigenen Nutzer überwiegend aus einer bestimmten Region kommen, reicht ein Gleichstand beim aggregierten WER nicht als Entscheidungsgrundlage. Das Beispiel belegt nicht, dass ein bestimmtes Ungleichgewicht in den Trainingsdaten das regionale Muster verursacht hat.
Warum Hindi-Lattice-Scoring für mehrsprachige ASR wichtig ist
Der klassische WER geht von einer kanonischen Referenz aus. Das funktioniert bei Groß- und Kleinschreibung oder einer normalen Schreibweisen-Normalisierung gut, stößt bei code-gemischtem Hindi aber schnell an Grenzen. Eine korrekte Ausgabe kann eine Devanagari-Schreibweise, eine romanisierte Form, eine englische Schreibweise oder eine andere Grenze zwischen Komposita verwenden.
Monsoon hi-IN begegnet diesem Problem mit Referenz-Lattices. Die offizielle Veröffentlichung beschreibt, wie mögliche Varianten erweitert, von muttersprachlichen Linguisten geprüft und anschließend so gefiltert werden, dass nur zum Gesagten passende Formen übrig bleiben. Eine gültige Alternative wird dadurch als korrekt gewertet, statt wegen einer Abweichung von der Schreibweise eines einzelnen Annotators bestraft zu werden.
Für die Hindi-Evaluierung verwendet das Leaderboard die Orthographically-Informed Word Error Rate (OIWER). Akzeptierte Varianten gelten als korrekt, echte Erkennungsfehler werden weiterhin berechnet. Der Commit zur Leaderboard-Integration zeigt, wie die Hindi-Daten und die mehrsprachigen Ansichten pro Sprache in die Anwendung eingebunden wurden.
Diese Bewertungsregel kann die Reihenfolge der Modelle verändern. Laut offizieller Ankündigung steigen die Fehlerraten aller getesteten Systeme, wenn die Hindi-Lattices auf jeweils eine einzige Referenz reduziert werden – allerdings nicht im gleichen Maß. Ein mehrsprachiges Leaderboard kann dadurch sprachlich fairer werden, ohne jedes Ergebnis auf eine einzige universelle Zahl zu reduzieren.
So nutzt du das aktualisierte Leaderboard für die Modellauswahl
Verwende Monsoon zunächst zum Filtern und für die Diagnose. Den Finalisten solltest du anschließend mit Audio aus deiner tatsächlichen Einsatzdomäne prüfen.
- Mit dem Average WER eine Vorauswahl treffen. Indian English fließt jetzt in den zentralen Leaderboard-Durchschnitt ein. Modelle, die nur bei vorgelesenem oder nicht-indischem Englisch gut funktionieren, können sich daher weniger leicht einem Test mit gesprochenem Indian English entziehen.
- Vor dem Vergleich multilingualer Durchschnitte die Sprachabdeckung prüfen. Im Leaderboard-Quellcode werden fehlende ausgewählte Sprachen als
NAangezeigt; außerdem gibt es einen Wert wie3/5für dieCoverage. Einen multilingualen Rang erhält ein Modell erst, wenn es alle ausgewählten Sprachen unterstützt. Siehe den Integrationscode. - Die öffentlichen Monsoon-Daten nach dokumentierten Feldern aufschlüsseln. Vergleiche Ursprungsbezirk, Bundesstaat, Stadt, Gerät und weitere verfügbare Metadaten. Achte auf Streuung und Fehlerhäufungen, nicht nur auf den besten Score einer Teilgruppe.
- Mit repräsentativem Produktionsaudio validieren. Teste die eigene Mischung aus Smartphones, Störgeräuschen, Code-Switching, VAD und unterschiedlichen Sprachlängen. Die öffentlichen Monsoon-Clips sind im Schnitt kürzer als zehn Sekunden und können daher nicht stellvertretend für jedes Callcenter-, Meeting- oder Voice-Agent-Szenario stehen.
Auf X warnte der Praktiker @PlimmApp, dass VAD stille Halluzinationen verbergen kann, wenn die Evaluierung mit Segmenten beginnt, die bereits Sprache enthalten: „the vad step in your pipeline is also the blind spot… a model that emits fluent text over silence never gets charged for it.“ Den vollständigen Kommentar gibt es auf X. Für On-Device-Systeme sollten VAD, Endpointing und der Umgang mit Halluzinationen separat bewertet werden.
Diese Fragen beantwortet Monsoon weiterhin nicht
- Skalierung und Übertragbarkeit auf lange Audios: Der öffentliche en-IN-Split umfasst 5.62 Stunden, der öffentliche hi-IN-Split 1.33 Stunden; die durchschnittlichen Clips sind jeweils 9,6 und 6,4 Sekunden lang. Kleine Score-Unterschiede und das Verhalten bei langen Audios müssen separat validiert werden.
- Repräsentativität für ganz Indien: Eine breite Abdeckung von Bezirken, Bundesstaaten und Geräten ist keine nach Bevölkerungsanteilen gewichtete Erhebung aller Sprecher von Indian English oder Hindi.
- Kausale Erklärungen: Regionale Zusammenhänge zeigen nicht, ob Trainingsdaten, Akustik, Phonetik, Decoding oder ein anderer Faktor die Ursache ist.
- Aussagekraft der privaten Splits: Die sprechergetrennten privaten Splits sollen Generalisierung testen, ihre Beispiele können aber nicht unabhängig eingesehen werden.
- Passung für nachgelagerte Textsysteme: Suche, Untertitel, Analytics und juristische Transkripte können unterschiedliche Anforderungen an Schrift, Normalisierung, Zeichensetzung oder Code-Switching stellen.
Open ASR Leaderboard Monsoon FAQ
Beeinflusst Indian English den Durchschnitt des Haupt-Leaderboards?
Ja. Monsoon en-IN ist Bestandteil der standardmäßigen englischen Leaderboard-Evaluierung und fließt in den Average WER ein. Die Übersicht der Splits zeigt die Größen der öffentlichen und privaten Varianten.
Ist Hindi Teil des Rankings im Haupt-Leaderboard?
Hindi wird in der multilingualen Ansicht angezeigt. Fehlende ausgewählte Sprachen erscheinen als NA; einen multilingualen Rang erhalten nur Modelle mit vollständiger Abdeckung der ausgewählten Sprachen.
Kann ich die öffentlichen Sets herunterladen und selbst bewerten?
Ja. Die Cards für en-IN und hi-IN enthalten Beispiele zum Laden der Daten. Für Hindi solltest du die Ergebnisse auf Korpusebene aggregieren und die Lattices mit OIWER auswerten.
Warum wird Hindi nicht mit dem normalen WER bewertet?
Eine feste Hindi-Referenz kann gültige Varianten in Devanagari, romanisierte Schreibweisen, Code-Mixing oder unterschiedliche Grenzen von Komposita bestrafen. Das Lattice hält die akzeptierten Formen für jeden Transkriptabschnitt fest.
Bedeutet ein niedrigerer Gesamt-WER, dass ein Modell für jede indische Region besser ist?
Nein. Das offizielle en-IN-Beispiel zeigt nahezu gleiche Gesamt-WER-Werte, aber deutlich unterschiedliche regionale Spannweiten. Vor einem produktiven Einsatz solltest du das Verhalten in Teilgruppen untersuchen und repräsentatives Audio testen.
Die praktische Entscheidung
Nutze en-IN für die Vorauswahl anhand des zentralen Scores, hi-IN und OIWER für Hindi- oder Mehrsprachenvergleiche und die regionale Spannweite als Risikosignal, wenn sie groß ausfällt. Anschließend solltest du den Finalisten mit genau dem Audio, den Störgeräuschen, dem VAD-Verhalten und den Textkonventionen validieren, die bei deinen Nutzern tatsächlich vorkommen.