 AIREITER
Bei der Kimi-K3.1-Pro-API entscheidet vor allem die Wahl zwischen Standard und Highspeed über die Rechnung. Der Basistarif liegt bei 2 $ pro 1 Mio. Input-Tokens und 10 $ pro 1 Mio. Output-Tokens. Highspeed verdoppelt beide Preise zugunsten einer höheren Geschwindigkeit. Bereits gecachte Eingaben kosten dagegen in beiden Varianten nur 0,20 $ pro 1 Mio. Tokens (platform.kimi.ai).
| Modell | Input / 1 Mio. | Output / 1 Mio. | Cache-Treffer / 1 Mio. | Cache-Schreiben 5 Min. / 1 Mio. | Cache-Schreiben 1 Std. / 1 Mio. |
|---|---|---|---|---|---|
Kimi K3.1 Pro (kimi-k3.1-pro) | 2,00 $ | 10,00 $ | 0,20 $ | 2,00 $ | 4,00 $ |
Kimi K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed) | 4,00 $ | 20,00 $ | 0,20 $ | 4,00 $ | 8,00 $ |
| Kimi K3 (Vorgängergeneration) | 3,00 $ | 15,00 $ | 0,30 $ | 3,00 $ | 6,00 $ |
Die Preise gelten in US-Dollar pro 1 Mio. Tokens und vor Steuern. Laut den offiziellen Preisangaben von Kimi gibt es über das gesamte Kontextfenster von 1 Mio. Tokens keinen Aufschlag für lange Kontexte (kimi.ai).
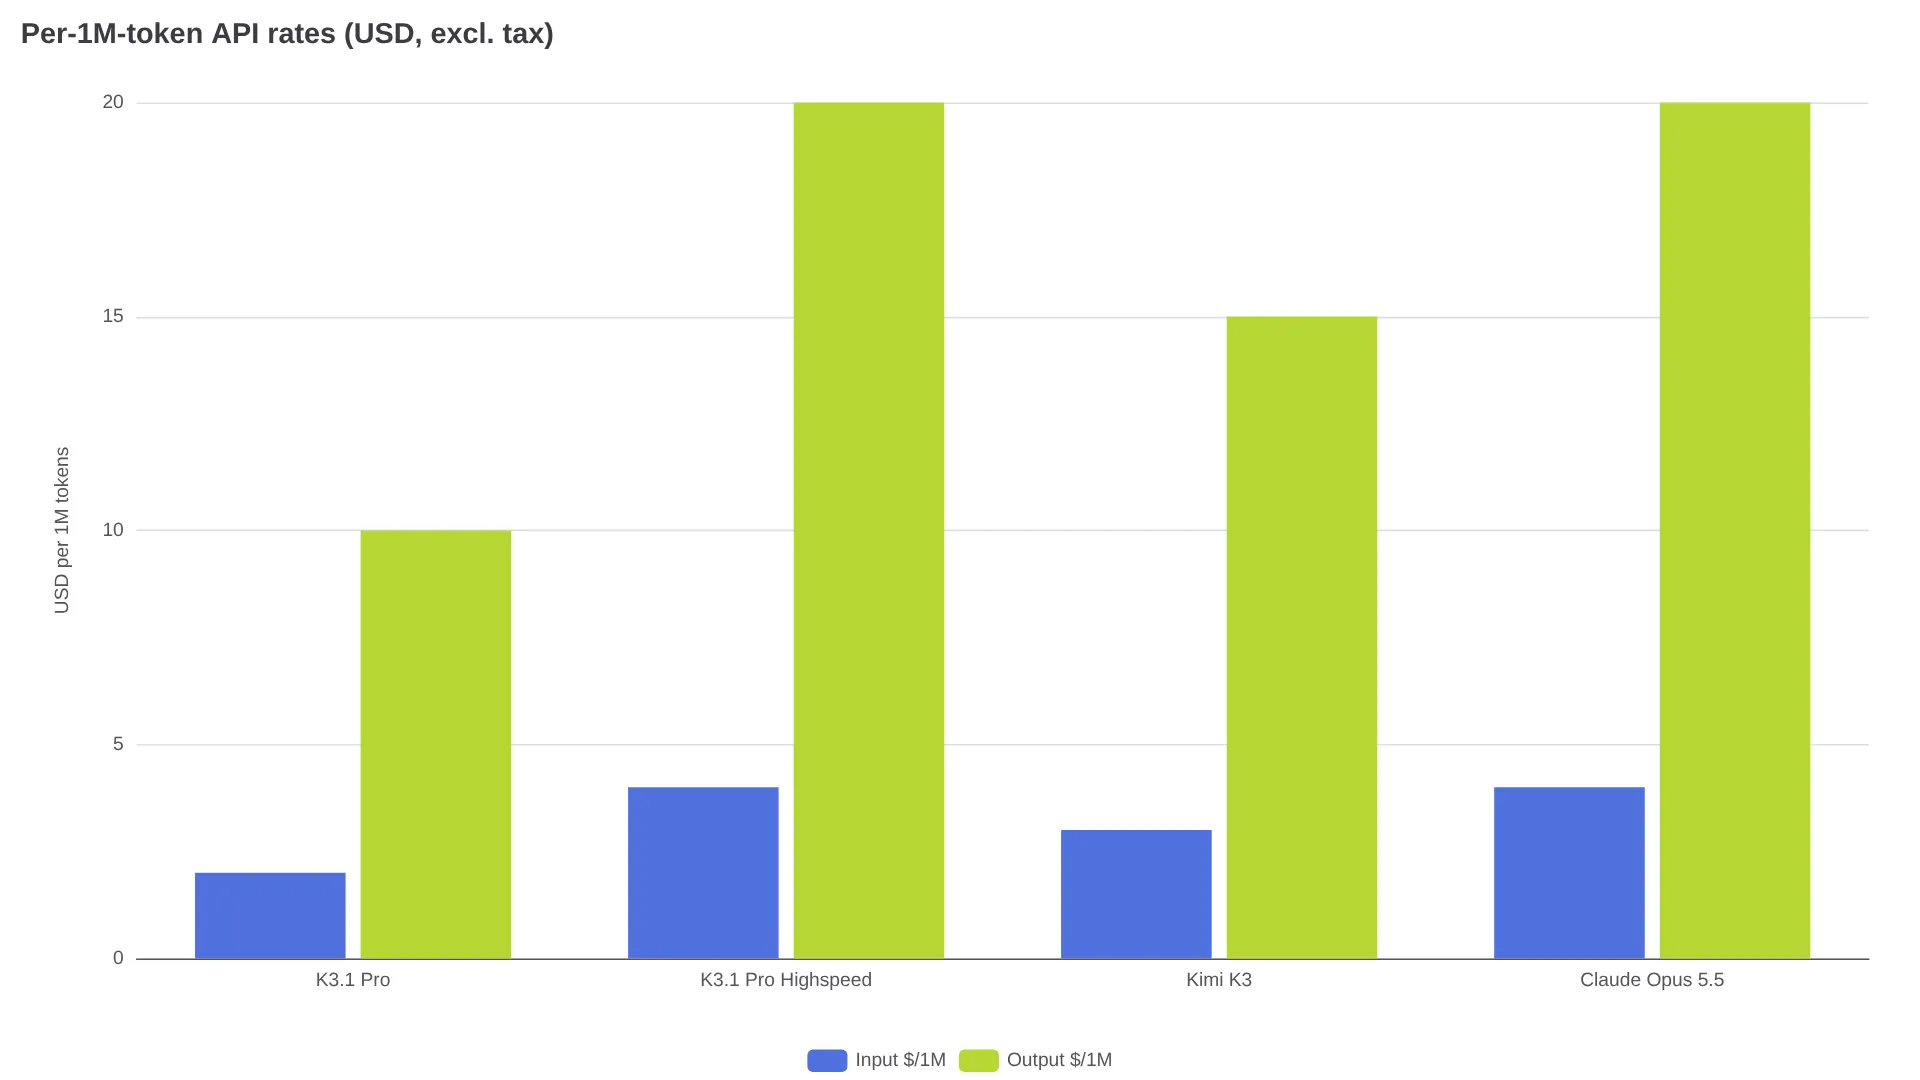
100.000 Tokens Kontext kosten zunächst 0,30 $ – der Rest steht auf einer anderen Zeile
Ein einfaches Beispiel: 100.000 nicht gecachte Input-Tokens plus 10.000 Output-Tokens ergeben bei den offiziellen Tarifen 0,20 $ + 0,10 $, also insgesamt 0,30 $. Für echte Anfragen lässt sich die Rechnung mit dieser Formel aufstellen. Im Standardtarif gelten die angegebenen Werte; bei Highspeed werden Input-, Output- und Schreibkosten verdoppelt:
Gesamt = (uncached_in x 2 + cached_read x 0.20 + write_5m x 2
  + write_1h x 4 + (visible_out + reasoning_out) x 10) / 1M
  + searches x 0.004
Die Formel berücksichtigt die von Kimi ausgewiesenen Kosten für nicht gecachte Eingaben, Cache-Treffer, Cache-Schreibvorgänge nach TTL sowie die Ausgabe (kimi.ai). Zusätzlich kostet jede Websuche 0,004 $. Da pro Anfrage nach Verbrauch abgerechnet wird (kimi.ai), läuft bei einem erneuten Versuch derselbe Zähler noch einmal. Reasoning ist bei K3.1 Pro immer aktiviert und wird zum Output-Tarif abgerechnet. Verborgene Gedankengänge verbrauchen daher dasselbe Budget von 10 $ pro 1 Mio. Tokens wie die sichtbare Antwort. Eine sichtbare Antwort mit 10.000 Tokens und 40.000 versteckten Reasoning-Tokens zählt als 50.000 Output-Tokens und kostet 0,50 $. Ein realer Nutzerbericht mit 935 Input-Tokens und 56.097 Output-Tokens bei 0,5628 $ entspricht dem Output-Tarif von 10 $ pro 1 Mio. Tokens nahezu exakt (x.com).
Auch das Cache-Verhalten wird auf der Rechnung schnell übersehen. Beim erstmaligen Ablegen eines Präfixes fällt eine Schreibgebühr an. Wird dasselbe Präfix innerhalb des gültigen Zeitfensters wiederverwendet, sinken die Kosten auf 0,20 $ pro 1 Mio. Tokens. Standardmäßig bleibt der Cache fünf Minuten aktiv; pro Anfrage ist alternativ eine Stunde möglich (kimi.ai). Ändert sich ein Präfix weit vorne im Kontext, kann dadurch die Wiederverwendung aller nachfolgenden Inhalte ungültig werden (kimi.ai). Ob ein Cache-Treffer tatsächlich erfolgt ist, zeigt nur die Nutzungsaufschlüsselung der jeweiligen Anfrage – ähnliche Formulierungen allein garantieren keinen Treffer.
Kimi-K3.1-Pro-API-Preise im Detail: Standard oder Highspeed?
Highspeed soll bei gleicher Modellintelligenz und demselben 1-Mio.-Token-Kontext ungefähr 2- bis 3-mal schneller arbeiten. Dafür verdoppeln sich Input-, Output- und Cache-Schreibkosten (platform.kimi.ai), wie Moonshot im Ankündigungsbeitrag beschreibt (kimi.ai).
Eine Ausnahme gibt es: Das Lesen bereits gecachter Inhalte kostet in beiden Varianten unverändert 0,20 $ pro 1 Mio. Tokens. Das ist vor allem für Agenten relevant, die lange System-Prompts und Tool-Definitionen wiederholen. Der Rabatt auf solche Wiederholungen bleibt gleich, während frische Tokens und Reasoning bei Highspeed doppelt zu Buche schlagen.
Drei Abrechnungsdetails sind für jede Kalkulation entscheidend:
- Die API wird nutzungsabhängig mit getrennten Zählern für Input und Output abgerechnet. Sie ist unabhängig von Kimi-Mitgliedschaften und Kimi-Code-Abos – ein Mitgliedschaftsguthaben kann API-Aufrufe daher nicht bezahlen (kimi.ai).
- Die API ist OpenAI-kompatibel. Die Modell-IDs lauten
kimi-k3.1-proundkimi-k3.1-pro-highspeed; erreichbar ist sie unterhttps://api.moonshot.ai/v1. Über Gateways findet sich das Modell außerdem alsmoonshotai/kimi-k3.1-probei OpenRouter und im Vercel AI Gateway. - Optionale Websuchen kosten zusätzlich zu den Token-Gebühren 0,004 $ pro Aufruf. Hochgeladene Dateien selbst werden nicht berechnet, ihr eingelesener Inhalt zählt jedoch als Input. Der API-Zugang wird nach einer ersten Aufladung von mindestens 1 $ freigeschaltet und unterliegt gestaffelten Ratenlimits (kimi.ai).
Wann sich Highspeed zum doppelten Preis lohnt – und wann nicht
Highspeed ist nur dann sinnvoll, wenn Wartezeit teurer ist als zusätzliche Tokens. Interaktive Coding-Sessions, Live-Assistenten und Demos mit Nutzern rechtfertigen 4/20 $, wenn jemand direkt auf eine Antwort wartet. Batch-Jobs, nächtliche Agentenläufe und Evaluierungen können dagegen beim Standardtarif von 2/10 $ bleiben und zahlen damit ungefähr die Hälfte der ausgewiesenen Tokenpreise. Als Faustregel lohnt sich Highspeed erst, wenn der Wert der eingesparten Wartezeit die zusätzlichen Tokenkosten übersteigt – bei inputlastigen Läufen entspricht das ungefähr einer weiteren Standardrechnung.
Der günstigere Stellhebel ist meist der Reasoning-Aufwand, nicht der Wechsel des Tarifs. Die API unterstützt reasoning_effort mit low, high und max; max ist voreingestellt und bildet die Grundlage für die von Moonshot gemeldeten Benchmark-Ergebnisse (datacamp.com). Bei einfachen Aufgaben reduziert der Wechsel von max auf high oder von high auf low die Zahl der Reasoning-Tokens, ohne den Highspeed-Aufschlag zu zahlen. Innerhalb einer Sitzung sollte die Stufe nicht gewechselt werden, weil dadurch der Kontext-Cache ungültig wird (datacamp.com).
Erfahrungsberichte aus der Community machen den Unterschied greifbarer. Ein japanischer Nutzer verglich ähnliche Aufgaben und kam zu dem Ergebnis, dass Opus 5.5 nach 14:32 Minuten fertig war, Kimi K3.1 Pro dagegen nach 27:53 Minuten – bei ähnlich guter Ausgabe. Seine Schlussfolgerung: Kimi eignet sich vor allem für Aufgaben, bei denen man warten kann:
半額のはずが、待ち時間はほぼ倍だった。... Opus 5.5是14分32秒、Kimi K3.1 Pro是27分53秒。出来は正直かなり近い。僕なら、待てる作業だけKimiに回す。 — @rutinelabo (x.com)
Auch Reddit-Nutzer beschreiben denselben Zielkonflikt: Highspeed erreiche ungefähr 80 Tokens pro Sekunde, die Standardvariante etwa 30 Tokens pro Sekunde. Zugleich sei die schnelle Variante extrem teuer:
And once again, the model has a high-speed version that costs an arm and a leg and runs at much more speed than eye can read (80t/s), while the normal version will be running at 30t/s if it feels like it. — u/Kiverty (reddit.com)
Die praktische Empfehlung lautet daher: standardmäßig K3.1 Pro verwenden, zuerst reasoning_effort reduzieren und Highspeed nur dann buchen, wenn ein Mensch auf die Antwort wartet.
Self-Hosting nach dem 4. November: Die Realität bei 3T-Modellen
Moonshot will die vollständigen Gewichte von Kimi K3.1 Pro bis zum 4. November 2026 veröffentlichen. Das Modell wird als Vertreter der 3T-Klasse mit einem Kontextfenster von 1 Mio. Tokens beschrieben (kimi.com). Am 2. November war in Moonshots Hugging-Face-Organisation unter huggingface.co/moonshotai noch kein offizielles K3.1-Pro-Repository zu sehen. Dort finden sich weiterhin Kimi K3 und ältere Modelle; in den Suchergebnissen tauchen bislang nur inoffizielle Forks auf. Auch Lizenz, Dateiformate und Quantisierungsoptionen sind noch nicht bestätigt. Drittanbieter-Tracker führen diese Punkte bis zur offiziellen Veröffentlichung als unbekannt (ctrlaltorion.com).
Die Modellgröße spricht gegen die Annahme, dass Self-Hosting hier automatisch günstiger ist. K3.1 Pro ist der nachtrainierte Nachfolger von Kimi K3, einem Mixture-of-Experts-Modell mit 2,8 Billionen Parametern. Die Einstufung als 3T-Modell deutet in dieselbe Richtung (datacamp.com). Da bei MoE-Modellen nicht alle Parameter für jedes Token aktiv sind, lässt sich aus den bislang verfügbaren Informationen keine verlässliche VRAM-Anforderung für eine einzelne Workstation ableiten.
Statt mit einem geratenen GPU-Preis zu rechnen, ist eine symbolische Gewinnschwelle sinnvoller:
API_month = monthly_tokens_1M x blended_$/1M (from formula above)
Self-host wins when cluster_monthly_cost < API_month at sustained utilization
Bei 2 $ pro 1 Mio. Input-Tokens und 10 $ pro 1 Mio. Output-Tokens kosten 1 Milliarde Input-Tokens plus 100 Mio. Output-Tokens insgesamt 2.000 $ + 1.000 $, also rund 3.000 $ API-Gebühren. Self-Hosting kann sich für Teams lohnen, die bereits einen geeigneten Cluster besitzen, dauerhaft große Mengen verarbeiten oder Daten zwingend lokal halten müssen. Ohne vorhandenen Cluster und konstante Auslastung spricht die Rechnung meist für die verbrauchsabhängige API. Für konkrete Pläne sollte man auf den offiziellen Checkpoint und die Lizenz warten.
Zwei Abrechnungsfallen, in die Nutzer immer wieder laufen
Die erste Falle ist Reasoning, das als Output berechnet wird – genau das berücksichtigt die Formel weiter oben bereits. Läufe lassen sich mit max_completion_tokens begrenzen. Für erste Tests empfiehlt sich low; nur bei Problemen sollte auf high erhöht werden. max bleibt den wirklich schwierigen finalen Durchläufen vorbehalten.
Die zweite Falle ist der Verbrauch eines Abo-Kontingents im Vergleich zur planbaren API-Abrechnung. Mehrere zahlende Nutzer berichten, dass ein Fünf-Stunden-Kontingent bei anspruchsvollen Coding-Aufgaben innerhalb von Minuten schrumpfte. Ein Nutzer des teuersten Tarifs meldete, dass sein Monatskontingent nach sechs Stunden aufgebraucht war (reddit.com). Moonshot bestätigte das Problem am 25. Oktober, entschuldigte sich für Ratenlimits und unnötigen Kontingentverbrauch und gewährte einmalig 25 % Kontingent zurück. Gleichzeitig wurden redundante Subagent-Aufrufe und die Ausgabelänge reduziert (x.com). Für rechenintensives Reasoning und Coding bleibt die nutzungsabhängige API mit 0,30 $ pro Einheit aus 100.000 Input- und 10.000 Output-Tokens kalkulierbarer als ein Abo-Kontingent, das in einer einzigen Aufgabe verschwinden kann.
FAQ zu den Kimi-K3.1-Pro-API-Preisen
Wie viel kostet die Kimi-K3.1-Pro-API pro 1 Mio. Tokens?
Der Standardtarif kostet vor Steuern 2,00 $ für Input, 10,00 $ für Output, 0,20 $ für das Lesen gecachter Inputs, 2,00 $ für einen Cache-Schreibvorgang mit fünf Minuten Laufzeit und 4,00 $ für einen mit einer Stunde Laufzeit – jeweils pro 1 Mio. Tokens (kimi.ai).
Was unterscheidet K3.1 Pro von Highspeed?
Highspeed nutzt dieselbe behauptete Intelligenz und dasselbe Kontextfenster von 1 Mio. Tokens, antwortet aber ungefähr 2- bis 3-mal schneller. Der Preis liegt bei 4,00 $ für Input und 20,00 $ für Output pro 1 Mio. Tokens. Cache-Schreibvorgänge werden ebenfalls verdoppelt, Cache-Treffer bleiben bei 0,20 $ (platform.kimi.ai).
Wie lauten die API-Modell-IDs?
Für den Standardtarif verwendet man kimi-k3.1-pro, für die schnelle Variante kimi-k3.1-pro-highspeed am OpenAI-kompatiblen Moonshot-Endpunkt. Gateways führen das Modell als moonshotai/kimi-k3.1-pro (openrouter.ai).
Ist die API-Nutzung in einer Kimi-Mitgliedschaft enthalten?
Nein. API-Abrechnung und Kimi-Mitgliedschaften beziehungsweise Kimi-Code-Tarife sind getrennt. Sie verwenden eigene Schlüssel und Guthaben; Mitgliedschaftsguthaben kann daher nicht für API-Aufrufe eingesetzt werden (kimi.ai).
Kann man Reasoning deaktivieren, um Kosten zu sparen?
Nein. K3.1 Pro führt immer Reasoning aus. Die Kosten lassen sich über reasoning_effort (low, high, max, standardmäßig max) und max_completion_tokens steuern, nicht durch das Abschalten des Denkprozesses (datacamp.com).
Wann erscheinen die Open Weights, und sollte ich warten?
Moonshot peilt den 4. November 2026 an. Am 2. November waren jedoch weder ein offizielles Hugging-Face-Repository noch eine endgültige Lizenz veröffentlicht. Für den Moment ist die API die pragmatische Option. Self-Hosting sollte erst nach Veröffentlichung des offiziellen Checkpoints und der Lizenz neu bewertet werden.
Weiterführend: Der Kimi-K3.1-Pro-API-Leitfaden zu Preisen, Benchmarks und Highspeed enthält die vollständige Benchmark-Auswertung. Die Kimi-K3-Preise behandeln die Tarife der Vorgängergeneration, und auf der Kimi-K3-API-Seite geht es darum, Kimi-Modelle mit einem einzigen Schlüssel anzusprechen.