 AIREITER
Eine API für $0.15 pro Stunde kann für eine Stunde Audio $0.30 berechnen, während eine API mit $0.36 pro Stunde für dieselbe Datei tatsächlich $0.36 kostet. Dieses Abrechnungsdetail entscheidet bei STT-Budgets oft mehr als jedes Genauigkeitsranking – und wird in den meisten Vergleichen irgendwo im Kleingedruckten versteckt.
Welche Speech-to-Text-API 2026 die beste ist, hängt vor allem davon ab, ob du Dateien transkribierst oder einen Live-Sprachagenten betreibst. Für aufgezeichnetes Audio mit kleinem Budget ist AssemblyAI Universal-2 ab $0.15/Stunde ein guter Ausgangspunkt. Bei Live-Agenten, bei denen der Sprecherwechsel entscheidend ist, solltest du Deepgram Flux oder Nova-3 Streaming testen. Für mehr als 90 Sprachen und breite Unterstützung der Sprechererkennung bietet sich ElevenLabs Scribe v2 für $0.22/Stunde im Batch an. Die folgenden Preise sind Pay-as-you-go-Listenpreise der jeweiligen Flaggschiffmodelle, vor Mengenrabatten auf eine Audiostunde normiert.
Batch und Streaming sind zwei verschiedene Produkte
Behandle Batch-Transkription und Echtzeit-Streaming als zwei getrennte Anschaffungen. Batch-APIs rechnen meist pro verarbeiteter Audiostunde ab und arbeiten nach dem Muster „hochladen, später Ergebnis abholen“. Streaming-APIs berechnen dagegen die Sitzungsdauer in Minuten – einschließlich Leerlaufzeit bei geöffneter WebSocket-Verbindung – und stehen oder fallen mit der Geschwindigkeit ihrer Teilergebnisse.
Die Latenz bis zum ersten Teilergebnis, die Finalisierung und die Erkennung des Gesprächsendes messen jeweils einen anderen Zeitpunkt: wann die ersten Wörter erscheinen, wann sich die Ausgabe nicht mehr verändert und wann das System davon ausgeht, dass der Anrufer fertig ist. Wer Anbieter anhand dieser unterschiedlichen Definitionen in ein gemeinsames Ranking presst, erhält ein schiefes Bild – davor warnen auch die Streaming-Vergleiche von Dexto und versusref.
Die praktische Trennlinie:
- Große Archive mit Aufnahmen, Podcasts, Meetings oder Gesprächsprotokollen: Optimiere auf $/Stunde, Genauigkeit der Sprechererkennung, den Umgang mit großen Dateien und den Korrekturaufwand.
- Live-Untertitel oder Telefonagenten: Entscheidend sind stabile Teilergebnisse, Endpointing, der Umgang mit Unterbrechungen und die Ende-zu-Ende-Verzögerung inklusive LLM und TTS.
- Callcenter-Gespräche auf AWS oder GCP: Beschaffung und Abrechnung pro Kanal wiegen oft schwerer als ein Listenpreisunterschied von $0.05 pro Stunde.
„Testet diese APIs mit echten Kundenaufnahmen. Laute Räume. Indische Akzente. Hindi-Englisch-Code-Switching ... Erst Genauigkeit, Latenz und Zuverlässigkeit. Der Preis kommt zuletzt.“ — @Aditya_Chawla20
In diesem Beitrag wurden AssemblyAI mit $0.21/Stunde, ElevenLabs Scribe v2 mit $0.22/Stunde und Deepgram Nova-3 mit knapp $0.26/Stunde verglichen. Das Fazit: Der Abstand von 5 Cent zählt weniger als die Frage, welches Modell mit echten Audios zuverlässig klarkommt.
Was eine Audiostunde kostet
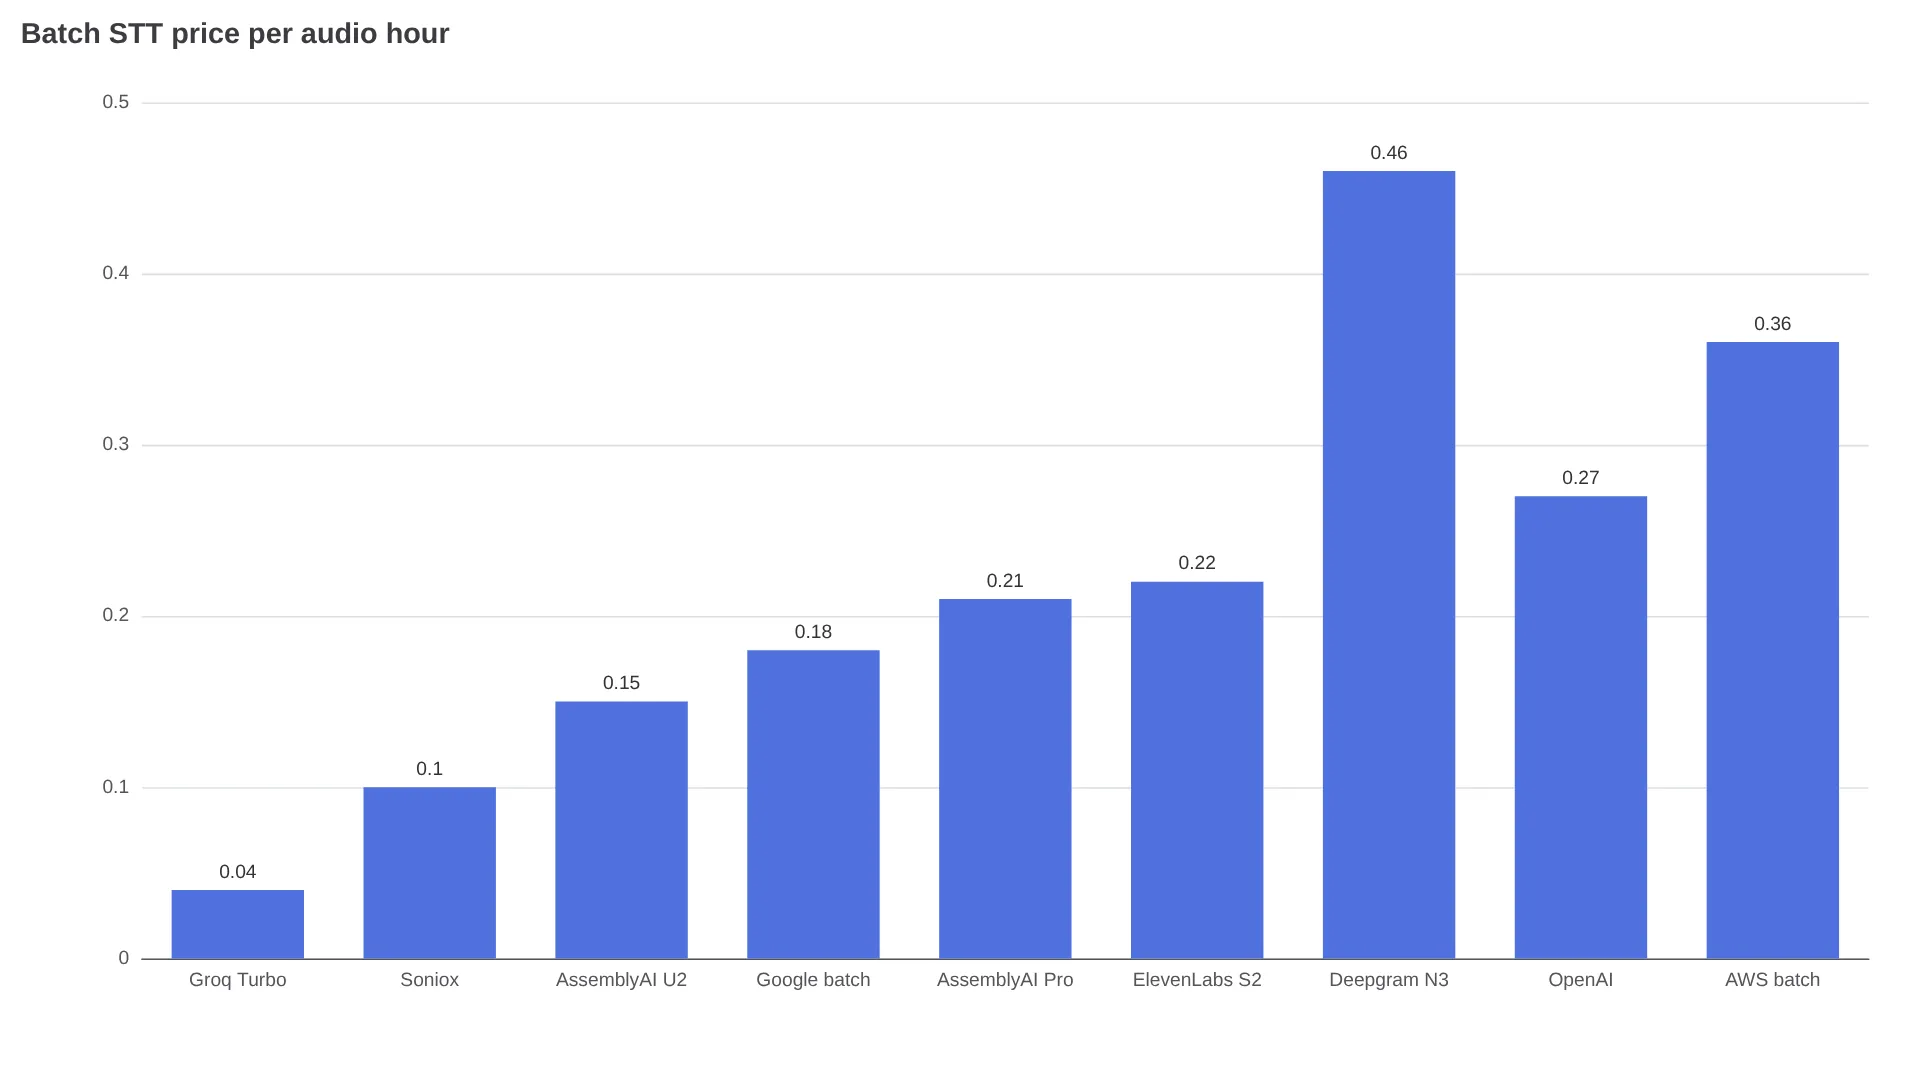
| Anbieter | Batch | Streaming / Echtzeit | Sprachen | Kostenloses Einstiegsangebot |
|---|---|---|---|---|
| Groq Whisper | Large v3 Turbo $0.04/Std. | Kein Streaming-Endpunkt | Mehrsprachiger Whisper-Satz | Kostenloser Tarif mit Limits |
| Soniox | ~$0.10/Std. asynchron | ~$0.12/Std. Echtzeit | 60+ in einem Modell | Keine Angabe |
| AssemblyAI | Universal-2 $0.15/Std.; Universal-3.5 Pro $0.21/Std. | Universal-Streaming $0.15/Std.; Pro Realtime $0.45/Std. | 99 bei U2; 18 bei 3.5 Pro | $50 Guthaben, keine Kreditkarte |
| Google Cloud | Dynamic Batch $0.18/Std.; Standard $0.96/Std. | Standard $0.96/Std. für die ersten 500.000 Minuten | 125+ Locales laut Anbieter | $300 Cloud-Guthaben |
| ElevenLabs Scribe | Scribe v2 $0.22/Std. | Scribe v2 Realtime $0.39/Std. | 90+ | ~4,5 Std. im kostenlosen Tarif |
| Deepgram | Nova-3 $0.26–$0.46/Std. je nach Tarif (Promo vs. regulär, monolingual) | Nova-3 Promo ~$0.29/Std.; Flux English $0.39/Std. ($0.0065/Min.) | 45+ | $200 Guthaben |
| OpenAI | gpt-transcribe $0.27/Std. ($0.0045/Min.) | gpt-live-transcribe $1.02/Std. ($0.017/Min.) | Je Modell angegeben, Whisper 98 | Keine Angabe |
| AWS Transcribe | $0.36/Std. ($0.006/Min.) | $0.60/Std. ($0.01/Min.) | Breit gefächert, je nach Funktion | 60 Min./Monat für 12 Monate |
| Speechmatics | Melia 1 $0.24/Std. Basispreis | Linden 1 $0.30/Std.; Enhanced $0.80/Std. | 55+ | $100 Guthaben |
| Gladia | Solaria-3 €0.16/Std. | €0.68/Std. | 100+ bei Solaria-1; 6 bei Solaria-3 | €50 Guthaben, 1 Jahr |
Die Spanne bei Deepgram entsteht durch Promo- und reguläre Preise für monolinguale Aufnahmen im Batch. Prüfe vor der Budgetplanung den aktuell gültigen Tarif auf der Deepgram-Preisseite.
Die Mehrkanal-Falle
Eine Stunde Stereo-Audio entspricht nicht automatisch einer abrechenbaren Stunde. AssemblyAI und Google rechnen jeden Kanal separat ab. Ein 60-minütiges Gespräch auf zwei Kanälen kostet mit Universal-2 also $0.15 x 2 = $0.30. Dasselbe Gespräch schlägt bei Google Standard mit $0.96 x 2 = $1.92 zu Buche. AWS Transcribe berücksichtigt dagegen bis zu zwei Kanäle in der Dauerabrechnung. Im von CometAPI zitierten Beispiel für US East bleibt der Stereoanruf damit im Batch bei ungefähr $0.36. Kläre die Kanalzählung, bevor du zwei $/Stunde-Angaben vergleichst.
Zusatzfunktionen können das Ranking drehen
Die Basistranskription ist nur der erste Kostenpunkt. Laut der Aufschlüsselung von CometAPI steigt Deepgram Nova-3 für monolinguale Aufnahmen im Batch von $0.0077/Min. auf $0.0097/Min. mit Sprechererkennung und auf $0.0117/Min. mit Sprechererkennung plus Redaction. Keyterm Prompting kostet weitere $0.0013/Min. AssemblyAI berechnet für die Sprechererkennung bei Aufnahmen $0.02/Stunde, beim Streaming aber $0.12/Stunde. Bei ElevenLabs kosten Keyterms in Echtzeit zusätzlich $0.08/Stunde, Entity Detection weitere $0.07/Stunde.
Die Gesamtkosten pro akzeptierter Transkription = API-Verarbeitung + kostenpflichtige Funktionen + Wiederholungen + Speicher/Übertragung + Zeit für manuelle Korrekturen. Im Rechenbeispiel von CometAPI mit $30/Stunde für die Prüfung kam eine Route mit $0.15/Stunde und 8 Minuten Korrekturaufwand auf insgesamt $4.15. Eine Route mit $0.60/Stunde und 3 Minuten Korrekturzeit kostete dagegen $2.10.
Beim Sprachagenten zuerst den Sprecherwechsel testen
Sprachagenten scheitern eher an Unterbrechungen und Pausen als an der WER mit sauberem Audio. Vergleiche deshalb den Mechanismus für Sprecherwechsel, Kontextsteuerung, Echtzeitpreis und die jeweils wichtigste Einschränkung.
| Anbieter | Sprecherwechsel | Echtzeitpreis | Einschränkung |
|---|---|---|---|
| Deepgram Flux | EndOfTurn-Events mit anpassbarem Schwellenwert; Eager Mode plus TurnResumed; laut den von Dexto zitierten Deepgram-Dokumenten kann Eager die Zahl der LLM-Aufrufe um 50–70 % erhöhen | Flux English $0.0065/Min.; Nova-3 Streaming Promo ~$0.0048/Min. | Mehrsprachiges Flux für 10 Sprachen; Promos laufen aus |
| AssemblyAI | Prompt + Keyterms + 1.750 Zeichen der vorherigen Agentenantwort; Endpointing auf Basis der Zeichensetzung | Universal-Streaming $0.15/Std.; Pro Realtime $0.45/Std. | Der günstige Streaming-Tarif konzentriert sich auf Englisch; Leerlaufzeit der Socket-Verbindung wird berechnet |
| ElevenLabs Scribe | ~150 ms Modelllatenz laut Anbieter; 90+ Sprachen; Sprechererkennung im Batch für bis zu 32 Sprecher | Scribe v2 Realtime $0.39/Std. + $0.08/Std. für Keyterms in Echtzeit | Sprechererkennung in Echtzeit nicht aufgeführt; die Anbieterangabe schließt Netzwerk und Agenten-Stack aus |
| OpenAI | Transcript-Deltas über WebSocket; kein serverseitiges VAD; der Client bestätigt den Sprecherwechsel; keine Sprecherlabels oder Wortzeitstempel in Echtzeit | gpt-live-transcribe $0.017/Min. | Endpointing muss clientseitig umgesetzt werden; höchster Echtzeitpreis pro Stunde in dieser Übersicht |
Miss auch Tool-Aufrufe und die LLM-Verzögerung. Ein Entwickler eines Hotelagenten berichtete auf X trotz schneller STT von 5–7 Sekunden Stille nach Tool-Aufrufen: @albertolco88. Diese Ende-zu-Ende-Lücke taucht in reinen STT-Tabellen nicht auf.
Bei Aufnahmen Textqualität und Sprechererkennung getrennt bewerten
Ein auf r/speechtech veröffentlichter Nutzerbenchmark testete ein echtes schwedisches Meeting von 2 Stunden und 22 Minuten mit sechs Sprechern gegen Ground Truth von pyannote. Deepgram war laut dem Bericht am schnellsten und bei der Sprechererkennung am stärksten. ElevenLabs lieferte den besseren schwedischen Transkripttext, erkannte aber zwei der sechs Sprecher nicht. AssemblyAI lag bei der Genauigkeit nahe dran, war für diese Pipeline jedoch deutlich langsamer. Der Autor kombinierte schließlich mehrere Anbieter, statt einen einzelnen Sieger auszurufen.
„Deepgram ist von den drei Anbietern der stärkste und war sehr schnell.“ — u/DoctorNootNoot auf r/speechrecognition
Drei auf Aufnahmen zugeschnittene Prüfungen trennen brauchbare APIs von frustrierenden Lösungen:
- Code-Switching innerhalb einer Äußerung. Entwickler aus dem Thread zu mehrsprachiger Meeting-Transkription berichten von verstümmelten Übergängen, wenn Sprecher mitten im Satz zwischen Finnisch und Englisch oder Spanisch und Englisch wechseln. Universal-3.5 Pro nennt Code-Switching für 18 Sprachen; Gladia und Speechmatics positionieren die Erkennung mehrsprachiger Sprache als Stärke. Kein Anbieter verarbeitet jedes europäische Sprachenpaar ab Werk sauber – teste deshalb deine tatsächlichen Kombinationen.
- Sprechererkennung im großen Maßstab. Frage nach der maximalen Sprecherzahl (ElevenLabs nennt im Batch 32, Azure 35, Speechmatics nennt für Echtzeit kein festes Limit), ob es überhaupt Sprechererkennung in Echtzeit gibt und wie sie Preis und Latenz verändert. Derselbe Benchmark-Autor aus dem schwedischen Test bezeichnete die Verarbeitung bei AssemblyAI als zu langsam für die eigene Produktionspipeline, obwohl die Textgenauigkeit nahe dran war.
- Große Dateien. OpenAI begrenzt Audio-Uploads auf 25 MB, was lange Aufnahmen kompliziert. Batch-orientierte APIs akzeptieren Jobs auf Basis von URLs, mehrstündige Dateien und dauerhaftes asynchrones Abrufen. Ein Nutzer im Thread zu Batch-Transkription berichtete, er könne „keine großen Dateien hochladen“ und verstehe die Verarbeitung über URLs nicht – ein Adoptionshindernis, das keine WER-Tabelle abbildet.
Selbst gehostetes Whisper large-v3 bleibt die Offline-Option. In Echosaws Test mit demselben Audiomaterial über 22,7 Minuten englischer Vorlese- und Meetingsprache lagen gehostete APIs bei sauberen Kapiteln unter 2,1 % WER. Ein Whisper-Setup mit zwei vCPUs kam dagegen auf 10–17 % und verlor Segmente; bei Meeting-Audio erreichte es bei 0,5-facher Echtzeit 32,7 %. Für einen praktikablen Durchsatz setzt Self-Hosting in der Produktion normalerweise eine GPU mit VAD und Chunking voraus.
Cloud, Spezialanbieter oder Self-Hosting
- Hyperscaler aus dem eigenen Ökosystem. Google Dynamic Batch für $0.18/Stunde eignet sich für große, nicht dringende Archive, die ohnehin auf GCP liegen; Standard für $0.96/Stunde ist für Echtzeit teuer. AWS Transcribe passt zu S3-/IAM-Workflows und schließt zwei Kanäle ein. Azure Speech berechnet im Batch ungefähr $0.18/Stunde und in Echtzeit ungefähr $1.00/Stunde, mit einem kostenlosen Echtzeitkontingent von 5 Stunden pro Monat. Speicher-, Übertragungs- und Redaction-Gebühren musst du zusätzlich zur Transkriptionszeile einplanen.
- Günstiger Managed-Batch. Groq Whisper Turbo für $0.04/Stunde unterbietet jede verwaltete API für einfache Batch-Transkriptionen, bietet aber weder Streaming noch eine ausgewiesene Sprechererkennung. Soniox liegt asynchron bei ungefähr $0.10/Stunde und ist damit in der obigen Tabelle der günstigste Batch-Preis, der 60+ Sprachen inklusive Sprechererkennung und Zeitstempeln bündelt – allerdings mit einer dünneren unabhängigen Benchmark-Basis.
- Hybride Pipeline. Nutze ElevenLabs für den Transkripttext, wenn der Anbieter dort überzeugt, Deepgram für die Sprechererkennung und Whisper oder Groq für günstige Überlaufjobs im Batch. Das erhöht zwar den Orchestrierungsaufwand. Wenn aber kein einzelner Anbieter sowohl beim Text als auch bei den Sprecherlabels auf deinem Audiomaterial vorne liegt, sind zwei günstige Aufrufe besser als ein teurer Korrekturdurchlauf.
Hinweis zur Migration: OpenAI führt whisper-1, gpt-4o-transcribe, gpt-4o-mini-transcribe und gpt-4o-transcribe-diarize als veraltet; die Abschaltung ist für den 26. Februar 2027 geplant. Teams, die diese Modelle noch einsetzen, sollten vor diesem Stichtag Ersatz testen – insbesondere dort, wo sich Wortzeitstempel und Verhalten der Sprechererkennung unterscheiden.
Teste sieben Tage lang mit deinem eigenen Audiomaterial
WER-Angaben der Anbieter basieren auf unterschiedlichen Datensätzen, Normalisierungen und Modellversionen und lassen sich nicht direkt miteinander vergleichen. Sammle 30–50 echte Gesprächsbeiträge oder Meeting-Segmente mit deinen Akzenten, Hintergrundgeräuschen und Fachbegriffen. Erstelle einmal manuell die Referenztranskription und streame oder lade anschließend dasselbe Audiomaterial bei zwei oder drei Anbietern hoch, während der restliche Pipeline-Aufbau unverändert bleibt.
Protokolliere Audiolänge, Kanalzahl, aktivierte Funktionen, Modellversion, Latenz der Teilergebnisse, Verzögerung bis zur Finalisierung, Ende-zu-Ende-Latenz des Agenten, Fehlerquote der Sprechererkennung und Korrekturminuten pro akzeptierter Transkription. Bewerte geschäftskritische Begriffe wie Namen, E-Mail-Adressen, Beträge und Produktbezeichnungen getrennt von der allgemeinen WER. Die günstigste Route pro Stunde verliert bei den Gesamtkosten meist, wenn sie den manuellen Prüfaufwand verdoppelt.
FAQ
Welche Speech-to-Text-API ist 2026 am günstigsten?
Soniox mit ungefähr $0.10/Stunde und AssemblyAI Universal-2 mit $0.15/Stunde sind in der obigen Tabelle die günstigsten Managed-Batch-Listenpreise mit Unterstützung für Sprechererkennung. Groq Whisper Turbo für $0.04/Stunde ist bei einfachen Batch-Transkriptionen ohne Streaming und Sprechererkennung noch günstiger.
Welche API bietet die niedrigste Streaming-Latenz?
Laut der Zusammenstellung von Anbieterangaben bei Dexto: ElevenLabs mit ungefähr 150 ms Modelllatenz, Deepgram mit ungefähr 260 ms bis zum Gesprächsende und Speechmatics mit weniger als 350 ms durchschnittlicher Finalisierung. Teste die Latenz bis zum Teilergebnis, bis zur Finalisierung und Ende zu Ende mit deinen eigenen Anrufen.
Welche STT-API eignet sich am besten für Sprachagenten?
Deepgram Flux für nativen Sprecherwechsel, AssemblyAI für Kontext-Prompting, ElevenLabs Realtime für breite Sprachunterstützung im ElevenLabs-Voice-Stack und OpenAI Live Transcription für OpenAI-native Stacks, die das Endpointing selbst implementieren können.
Welche API verarbeitet mehrsprachiges und Code-geswitchtes Audio am besten?
ElevenLabs (90+), AssemblyAI U2 (99; 3.5 Pro 18 mit Code-Switching), Gladia Solaria-1 (100+) und Speechmatics (55+). Teste dein konkretes Sprachenpaar – Wechsel mitten im Satz führt weiterhin zu fehlerhaften Übergängen.
Sollte ich einen Anbieter nutzen oder Transkription und Sprechererkennung kombinieren?
Wenn ein Anbieter beim Text führend ist, bei den Sprecherlabels für dein Audiomaterial aber zurückliegt – wie im oben verlinkten schwedischen Test mit sechs Sprechern –, kann die Kombination mehrerer Anbieter besser sein als jede Einzellösung. Rechne Orchestrierung und doppelte API-Kosten gegen die eingesparte Korrekturzeit auf.
Wird OpenAI Whisper abgeschaltet?
OpenAI führt ältere Transkriptionsmodelle, darunter whisper-1 und Varianten von gpt-4o-transcribe, als veraltet; die Abschaltung ist für den 26. Februar 2027 geplant. Für Dateien ist gpt-transcribe der aktuelle Weg, für Live-Audio gpt-live-transcribe.
| Workload | Starte mit | Warum |
|---|---|---|
| Großes Archiv mit Aufnahmen | AssemblyAI U2 / Google Dynamic Batch / Groq Whisper | Niedrigste $/Stunde; Groq am günstigsten, wenn keine Sprechererkennung nötig ist |
| Live-Sprachagent | Deepgram Flux / AssemblyAI Realtime / ElevenLabs Realtime | Sprecherwechsel, Kontext-Prompts und geringe Modelllatenz |
| Mehrsprachige Meetings | ElevenLabs Scribe v2 / Speechmatics / Gladia | Positionierung mit 90+/55+/100+ Sprachen und Unterstützung für Code-Switching |
| Native AWS- oder GCP-Umgebung | Transcribe / Cloud STT | IAM, Speicher und Beschaffung wiegen schwerer als der Listenpreis |
| Offline oder Datenresidenz | Self-hosted Whisper | Die Audiodaten verlassen deine Hardware nicht |
Weiterführend: Beste Text-to-Speech-API, Beste Voice-Cloning-API 2026, Gemini 3.5 Transcribe API Guide.