 AIREITER
Opus 5.5 gewinnt bei der Qualität, GPT-6.1 Sol beim Listenpreis – allerdings nur, solange einzelne Anfragen unter 272K Input-Tokens bleiben. Wird diese Grenze überschritten, frisst der Aufschlag für lange Kontexte Sols Preisvorteil fast vollständig auf. Dazu berichten mehrere Codex-Nutzer, dass sich Sol in der Praxis ohnehin langsamer anfühlt.
Beide Modelle sind heute verfügbar. Anthropic hat Claude Opus 5.5 am 22. September 2026 veröffentlicht – als erstes Modell der Claude-5.5-Reihe. OpenAI hat GPT-6.1 Sol am 29. September 2026 vorgestellt, mit der API-ID gpt-6.1-sol. Wer nur die technischen Daten vergleicht, übersieht die drei Faktoren, die am Ende über die Rechnung entscheiden: die Langkontext-Grenze, die Effort-Einstellung und das Quotenverhalten bei Abos.
Die Kurzfassung in 30 Sekunden
Nimm Claude Opus 5.5, wenn ein fehlerhafter oder unnötig aufgeblähter Patch teurer wäre als zusätzliche Tokens – etwa bei lang laufenden Migrationen, Audits über mehrere Repositories und unbeaufsichtigten Agents. GPT-6.1 Sol passt besser zu großen Mengen klar abgegrenzter Aufgaben, solange jede Anfrage unter 272K Input-Tokens bleibt: Ticket-Automatisierung, PDF-Extraktion und Business-Workflows.
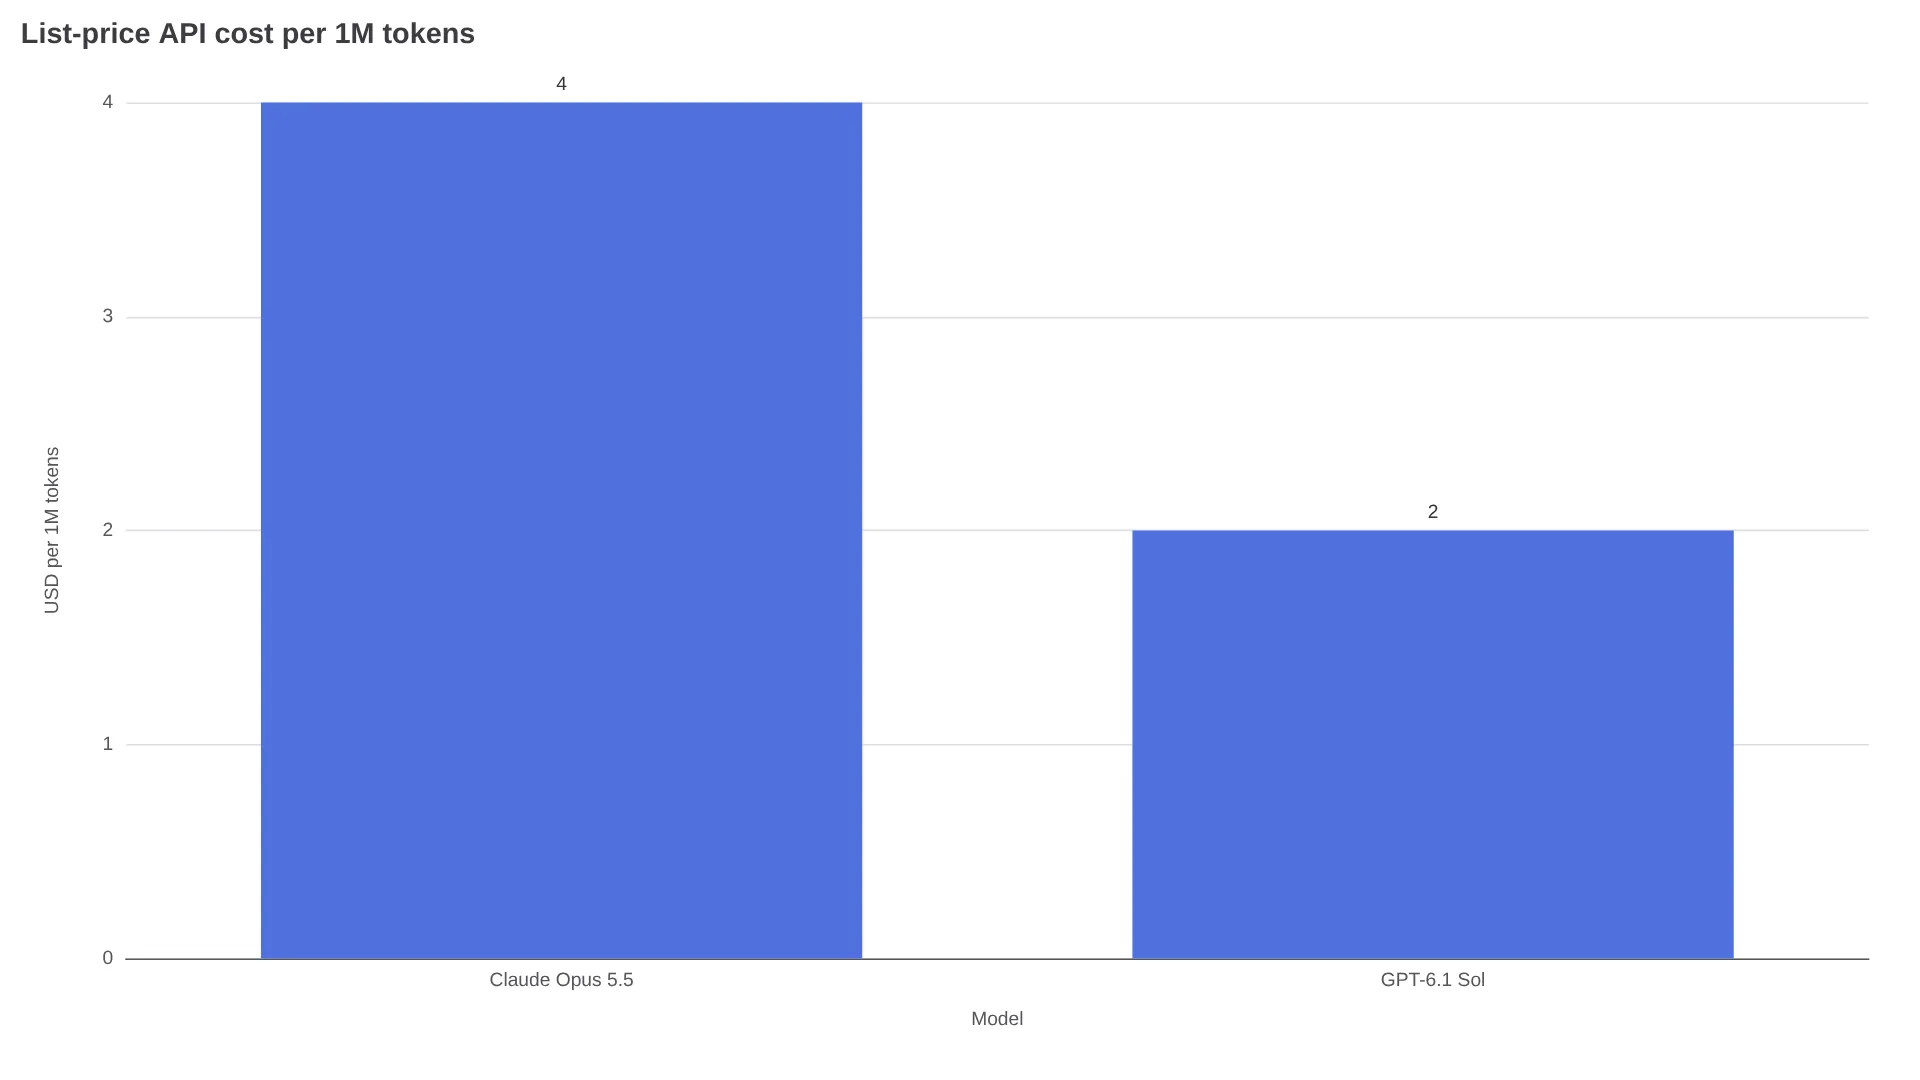
Auf dem Papier liegen die Modelle nicht weit auseinander: 1M gegenüber 1,05M Kontext, jeweils maximal 128K Output-Tokens sowie $4/$20 gegenüber $2/$10 pro Million Input-/Output-Tokens. Beim Verhalten ist der Abstand größer. Opus 5.5 erzielt höhere Werte beim agentischen Coding (66.4 % Terminal-Bench 4.0, 54.4 % FrontierCode v1.1, 57.8 % CursorBench 4.0). Sol hält mit etwa halbiertem Listenpreis und einem dokumentierten Erfolg bei AutomationBench für ein Drittel der Aufgabenkosten dagegen. Für Abonnenten kommt ein Haken hinzu: Reddit-Tests zeigen, dass Sol das Kontingent schneller aufbraucht, als es der API-Preis vermuten lässt.
Preise, Kontext und verfügbare Plattformen
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| Anbieter | Anthropic | OpenAI |
| Veröffentlicht | 22. September 2026 | 29. September 2026 |
| API-ID | claude-opus-5-5-Familie bei den meisten Gateways | gpt-6.1-sol |
| Input / Output pro 1M | $4.00 / $20.00 | $2.00 / $10.00 |
| Gelesener Cache pro 1M | $0.20 | $0.10 |
| Kontextfenster | 1,000,000 Tokens | 1,050,000 Tokens |
| Maximaler Output | 128K Tokens | 128K Tokens |
| Schnellmodus | Fast Mode $8 / $40, bis zu 2,5-fache Geschwindigkeit | Ultrafast bis zu 8-fach in Codex, etwa 2-fache Listenpreise |
| Verfügbar über | Claude Code, API, Bedrock, Vertex, Foundry, OpenRouter | Codex, ChatGPT Work, API, Azure, Bedrock, OpenRouter |
| Nicht enthalten in | — | Regulärem Consumer-Chat zum Start |
Der Wechsel erfolgt bei beiden Modellen über eine Änderung des Modell-Strings. AIReiter stellt beide Modelle über eine gemeinsame Oberfläche bereit, ohne dass du zwei Anbieter-Keys verwalten musst.
Was reale Workloads tatsächlich kosten
Nach den Schlagzeilen ist Sol 50 % günstiger. In der Praxis hängt die Rechnung vor allem von der Größe einzelner Anfragen und vom Cache ab.
OpenAI berechnet den Aufschlag pro Anfrage, sobald mehr als 272K Input-Tokens anfallen: Für die komplette Anfrage gelten dann doppelte Input- und Cache-Preise sowie der 1,5-fache Output-Preis. Anthropic führt das volle 1M-Kontextfenster zu den gleichen Preisen; ein Aufschlag pro Anfrage wird nicht genannt. Gelesene Caches kosten $0.20 gegenüber $0.10. Cache-lastige Schleifen behalten daher einen Teil von Sols Vorteil.
| Workload | Opus 5.5 | GPT-6.1 Sol | Abstand |
|---|---|---|---|
| Ausgewogener Assistent: 1M in / 250K out, Anfragen unter 272K | $9.00 | $4.50 | Sol 50 % günstiger |
| Retrieval, Anfragen unter 272K: 10M in / 1M out | $60 | $30 | Sol 50 % günstiger |
| Retrieval, jede Anfrage über 272K: 10M in / 1M out | $60 | ~$55 | Sol nur ~8 % günstiger |
| Cache-lastige Schleife: 100K-Präfix einmal geschrieben, danach 1.000x (5K frisch + 100K aus dem Cache + 1K out) | ~$60.50 | ~$30.25 | Sol ~50 % günstiger |
Die Summen basieren auf den Listenpreisen und berücksichtigen keine Unterschiede beim Tokenizer. Sol ist vor allem bei kurzen Anfragen mit hohem Volumen im Vorteil; bei riesigen Einzelabfragen schrumpft dieser deutlich.
Bei Abos sieht die Rechnung anders aus als bei der API. Ein von einem Nutzer durchgeführter Vergleich mit 128 festen Prompts zwischen GPT-6.1 Sol, GPT-6 Sol und Opus 5.5 ergab, dass das Sol-Modell beim Abo mehr Kontingent verbrauchte, als der Tokenpreis erwarten ließ. Ein weiterer Kommentator brachte es auf den Punkt:
"my chatgpt just cited this. anyways they may be a match usage-wise but opus is way faster on the wall clock and i regret swapping this month." — u/ebrbrbr, r/ChatGPT-Thread zum Quotentest
Ein weiterer Codex-Nutzer berichtete von demselben Verbrauchsproblem:
"I wouldn't mind using GPT 6.1 Sol if the usage was decent, but man, even though it's more 'efficient' I'm still getting drained on usage. It's unbelievable." — u/Longjumping_Stop6269, r/codex
Die Budgetregel lautet daher: Liegt deine mittlere Anfrage über 272K, rechne den Aufschlag vor einer Migration ein. Bei einem $20- oder $100-Sitz solltest du den Quotenverbrauch pro gemergtem PR messen – nicht Tokens pro Dollar.
Coding und Agents: Benchmarks plus zwei Praxistests
Die folgenden Drittanbieter-Ergebnisse sind nur als Richtung zu verstehen; Harnesses und Effort-Stufen unterscheiden sich. Quellen: Anthropic, OpenAI, DataCamp-Build-Test, OpenRouter-Durchsatz, SpringPrompt-Benchmark-Zusammenfassung.
| Benchmark | Opus 5.5 | GPT-6.1 Sol | Anmerkung |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | nicht veröffentlicht | Von Anthropic ausgeführt, xhigh |
| FrontierCode v1.1 Main | 54.4% | gleichauf mit Fable 5.1, keine Zahl | Unterschiedliche Berichterstattung |
| CursorBench 4.0 | 57.8% | nicht veröffentlicht | Von Anthropic ausgeführt |
| DeepSWE v1.1 | nicht veröffentlicht | gleichauf mit Astra, +6.4 pp gegenüber GPT-6 Sol | Von OpenAI ausgeführt, maximaler Effort |
| AutomationBench (47 Tools) | 40.0% | +2.2 pp gegenüber Opus bei Medium, etwa ein Drittel der Kosten | Unabhängig durchgeführt, keine Fallbacks, laut Anthropics Bericht zum Zapier-Test |
| OSWorld 2.0, Teilmenge | 81.8% | ~60.5% im Offline-Set | Unterschiedliche Teilmengen, von Anbietern durchgeführt |
| GDPval-AA v2.1 | 1,846 Elo | Sol schlägt Opus mit Fallbacks bei GDP.pdf für <1/2 der Kosten | Anbieterübergreifende Aussage von OpenAI |
Opus 5.5 verfügt über die umfangreichere veröffentlichte Benchmark-Sammlung für agentisches Coding. Sols bestdokumentierte Erfolge liegen bei Business-Workflows und Dokumentanalyse zu niedrigeren Aufgabenkosten. Anthropic zufolge wurden die Werte mit aktivierten Schutzmechanismen aus dem Produktionseinsatz ermittelt.
Zwei Drittanbieter-Tests liefern zusätzliche Nuancen:
- Single-File-Tetris-Build (DataCamp, OpenCode, gleicher Prompt, hoher Effort, ein Versuch). Beide Modelle bestanden die schwierige Logik für den Schwerkraftwechsel. Sol erreichte bei Mechanik, Vollständigkeit und Spielgefühl 5.0 gegenüber 4.3. Opus war nach 3 Turns und 2 Tool-Aufrufen fertig, Sol nach 6 Turns und 9 Aufrufen. Dafür kostete Opus $0.87 gegenüber $0.26, nachdem es 22.5K Reasoning-Tokens gegenüber 8.1K bei Sol verbraucht hatte.
- Quotentest mit 128 Prompts (Reddit, feste Prompts, Quotenverbrauch und Zeiten protokolliert). Sol verbrauchte bei derselben Aufgabe mehr Abo-Kontingent als GPT-6 Sol, während Opus auf der Uhr schneller fertig wurde.
Ein wiederkehrender Nutzerbericht betrifft die Zurückhaltung des Modells:
"The biggest win with Opus 5.5 for me isn't even raw coding speed, it's that it doesn't over-engineer simple fixes. Previous models would rewrite 4 files when you asked for a 3-line patch; 5.5 respects the existing architecture" — u/food_fatherr, r/ClaudeAI
Ein Extrembeispiel für Überproduktion spricht allerdings gegen Sol: Ein Entwickler berichtete, dass Sol 30.000 Tests für eine pixelgenaue Aufgabe geschrieben habe – und auf Aufforderung zum Kürzen anschließend nur 25 davon löschte.
Gefühlte Geschwindigkeit gegen Messwerte
Bei der Decodiergeschwindigkeit liegt Opus in den Datenblättern vorn: etwa 96 gegenüber 53 Tokens/s bei Artificial Analysis über SpringPrompt sowie 74 gegenüber 29 beim medianen Durchsatz auf OpenRouter. Beim Time-to-First-Token liegt Sol laut SpringPrompt bei niedriger Effort-Stufe knapp vorn (1.71 s gegenüber 6.89 s). Die zitierten Codex-Berichte zeichnen beim Warten auf das Gesamtergebnis ein anderes Bild – darunter mehrminütige einfache Aufgaben und lange Dokumentjobs.
Beides kann gleichzeitig stimmen: Tokens pro Sekunde messen die Decodierung nach dem ersten Chunk. Die Zeit bis zum fertigen Ergebnis umfasst zusätzlich Reasoning, Warteschlangen und den Overhead des Harnesses.
- Opus im Fast Mode kostet $8/$40 (das Doppelte) und verspricht bis zu 2,5-fache Geschwindigkeit. Sol im Ultrafast-Modus soll in Codex bis zu 8-fach schneller sein, bei etwa doppelten Preisen.
- Die zitierten Codex- und Work-Berichte messen vor allem die Latenz, nicht die API-Decodierung. Ein 40-minütiger PDF-Job verbrauchte in einer einzelnen Anekdote nur 6 % eines 5-Stunden-Fensters – das ist kein typischer Wert.
- Wenn deine Schleife interaktiv läuft (Cursor, Claude Code, Codex CLI), teste vor der Festlegung jeweils drei echte Tickets.
Diese Einstellungen entscheiden über die Rechnung
Die Standardwerte sind wichtiger als das Modell-Badge:
- Starte Opus mit Medium oder High. Die zitierten Nutzerberichte legen nahe, dass Extra High und Max bei gewöhnlichen Patches viel Kontingent verbrauchen, ohne entsprechend mehr zu liefern.
- Die Thinking-Sperren unterscheiden sich. Bei Opus lässt sich Thinking nicht abschalten, erzwungene Tool-Nutzung wird abgelehnt und bearbeiteter Kontext kann bei neueren Accounts einen 400-Fehler auslösen (DataCamp-API-Hinweise). Sol reicht von
nonebismaxund kann den Effort während eines Gesprächs ändern, ohne den Cache ungültig zu machen (DataCamp-Steuerung des Reasonings). Für kostenbegrenzte Schleifen ist das praktischer. - Schutzmechanismen können Aufgaben umleiten. Die meisten Cybersecurity-Aufgaben mit Opus werden außerhalb des Cyber Verification Program auf Opus 4.8 umgeleitet. Biologische Aufgaben benötigen das Life Sciences Program (Anthropic). Bei solchen Aufgaben solltest du daher mit Überraschungen bei Qualität und Quotenverbrauch durch Fallbacks rechnen.
Welches Modell passt zu welchem Workload?
| Wenn du … | Nimm … | Warum |
|---|---|---|
| Eine Migration mit 200K Zeilen, ein Multi-Repo-Audit oder einen 9-stündigen Agent-Lauf ausführst | Opus 5.5 | Höhere agentische Werte, weniger unerwünschte Umschreibungen, konstante Preise bis 1M Kontext |
| 10K Tickets pro Tag mit jeweils unter 272K oder RAG mit kleinen Chunks verarbeitest | GPT-6.1 Sol | Halber Listenpreis, starke Werte bei AutomationBench und GDP.pdf pro Dollar |
| Ein riesiges Retrieval mit mehr als 272K pro Anfrage ausführst | Opus 5.5 oder Sol in Chunks aufteilen | Der Sol-Aufschlag drückt den Vorsprung auf ~8 % |
| PDF-lastige Finanz- und Rechtsfragen bearbeitest | Sol zuerst testen | Angeblicher Sieg gegen Opus mit Fallbacks für <1/2 der Aufgabenkosten; mit eigenen Dokumenten prüfen |
| Mit einem $20-Sitz und interaktiver CLI arbeitest | Beide testen; die zitierten Berichte sprechen für Opus | Nutzer berichten, dass Sol schneller Kontingent verbraucht als die Tokenrechnung erwarten lässt und sich langsamer anfühlt |
Einen universellen Sieger gibt es nicht. Sol ist die Effizienzoption, Opus steht für Zurückhaltung und Autonomie. Eine sinnvolle Aufteilung kann so aussehen: Opus für Planung und Review, Sol für die Ausführung großer Mengen.
Opus 5.5 vs GPT-6.1 Sol: FAQ
Welches Modell ist über die API günstiger?
Sol zum Listenpreis ($2/$10 gegenüber $4/$20, gecacht $0.10 gegenüber $0.20). Wenn jede Anfrage mehr als 272K Input-Tokens enthält, schrumpft der Abstand auf etwa 8 %.
Welches Modell eignet sich besser für Coding-Agents?
Opus 5.5 führt bei den veröffentlichten Werten von Terminal-Bench, FrontierCode und CursorBench. Sol kontert mit Gleichstand zu Astra bei DeepSWE sowie einem AutomationBench-Sieg zu einem Drittel der Kosten.
Welches Modell ist in der Praxis schneller?
Bei der Decodierung liegt Opus vorn (etwa 74–96 Tok/s gegenüber etwa 29–53). Beim ersten Token ist Sol leicht schneller. Codex-Berichte aus dem Oktober 2026 zeichnen Sol bei der Gesamtdauer als langsamer.
Wie lauten die API-Modell-IDs?
gpt-6.1-sol sowie claude-opus-5-5-Slugs bei den meisten Gateways.
Ist GPT-6.1 Sol im regulären ChatGPT verfügbar?
Zum Start am 29. September noch nicht: Zuerst war Sol in Work, Codex und der API verfügbar. Prüfe deinen Sitz erneut, wenn der Zugriff entscheidend ist.
Welche Effort-Einstellung sollte ich verwenden?
Starte Opus 5.5 mit Medium oder High, nicht mit Max. Bei Sol solltest du mit Medium beginnen und erst erhöhen, wenn die Zahl der Wiederholungen steigt. Reasoning-Tokens laufen bei beiden Modellen auf denselben Tokenzähler (DataCamp-Hinweise zur Abrechnung).
Dieser Zielkonflikt lässt sich nicht wegprompten
Opus 5.5 geht sorgfältig mit dem Repository um, berechnet dafür aber das zusätzliche Denken. Sol macht die Tokens günstiger, kann dich dafür mit mehr Arbeit zum Prüfen und längeren Wartezeiten belasten. Wenn ein unbemerkter Fehler einen Bug in die Produktion bringt, bezahl für Opus. Wenn Fehler billig sind und vor allem das Volumen zählt, nimm die Sol-Ersparnis mit – solange du unter 272K bleibst.
Weiterführend: Claude Opus 5.5 im Test und mit Preisen, GPT-6.1 Sol: API-Preise im Test.