 AIREITER
1.595 Elo und Platz 2 im Code Arena Frontend Board; bei FrontierSWE liegt GLM-5.2 nur einen Punkt hinter Claude Opus 4.8. An der Leistung scheitert es also selten, wenn Entwickler nach Alternativen suchen. Seit dem Launch im Juni 2026 tauchen in den unten zitierten Entwickler-Threads vielmehr drei wiederkehrende Probleme auf: Coding-Plan-Quoten sind mitten in der Aufgabe aufgebraucht, zur Spitzenzeit häufen sich Fehler, und in langen Agent-Schleifen relativiert ein hoher Tokenverbrauch den Listenpreis von $1.40/$4.40. Welche GLM-5.2-Alternative passt, hängt daher ganz davon ab, woran Sie gerade scheitern.
Die Kurzempfehlungen nach Wechselgrund
Die fünf wichtigsten Empfehlungen vorab; die Belege folgen weiter unten:
- Quota-Verbrauch und Kosten pro Agent-Schleife: DeepSeek V4 Flash mit $0.14/M Input, $0.28/M Output und 1M Kontext.
- Instabile Agent-Schleifen: Kimi K2.7 Code für $0.95/M Input und $4.00/M Output.
- Maximale Leistung bei den schwierigsten Aufgaben: Claude Opus 4.8 erzielt den doppelten SWE-Marathon-Score von GLM-5.2, allerdings zu Closed-Model-Preisen.
- Self-Hosting oder Datenkontrolle: Qwen3-Coder (Apache 2.0) oder die eigenen MIT-Gewichte von GLM-5.2, falls für einen 4-Bit-Build 372–475 GB RAM verfügbar sind.
- Kein konkretes Problem, aber Wunsch nach dem neueren Modell: GLM-5.3 zum identischen Preis von $1.40/$4.40, laut Z.ai am Launch-Tag bestätigt.
Stärken von GLM-5.2 – und was der Betrieb kostet
Die offizielle Dokumentation von Z.ai führt GLM-5.2 als reines Text-Flaggschiff mit 1M Token Kontext, maximal 128K Token Output und API-Preisen von $1.40/M Input, $4.40/M Output sowie $0.26/M gecachtem Input. Die Gewichte stehen unter der MIT-Lizenz. Veröffentlicht wurde das Modell am 16. Juni 2026, nachdem es seit dem Rollout am 13. Juni zunächst hinter dem GLM Coding Plan verfügbar war. Die Model Card nennt 81.0 bei Terminal-Bench 2.1 gegenüber 85.0 für Opus 4.8, 62.1 bei SWE-bench Pro gegenüber 69.2 sowie 74.4 bei FrontierSWE gegenüber 75.1.
Damit bewegt sich GLM-5.2 zu Open-Weights-Preisen am Rand der Closed-Model-Spitze. Die Probleme beginnen laut Nutzern beim Betrieb. Der Pro-Tarif des Coding Plan stieg rund um den 5.2-Launch von unter $35 auf $65 pro Monat; @bridgemindai dokumentierte den Sprung am selben Tag. Noch deutlich häufiger als der Preis selbst werden jedoch die Quoten kritisiert:
"GLM 5.2 will end your weekly rate limit in a day." — u/intl_spy, r/opencode
"I like GLM-5.2, but my god it is a token muncher." — @atomtanstudio
Ein Entwickler, der selbstentwickelnde Agenten mit GLM-5.2 produktiv einsetzt, berichtete von mehr als $500 an einem einzigen Wochenende. Beim Modellwechsel während eines laufenden Jobs gehe der KV-Cache verloren, sodass derselbe Kontext erneut bezahlt werden müsse (@Xianbao_QIAN). Ein anderer Entwickler formulierte die Grenze des Preis-Leistungs-Verhältnisses so:
"GLM 5.2 is great but my $200/m Codex sub still gets me more usage for $200 of GLM 5.2 API usage. It's a great supplemental model... but not a replacement by any means." — @mweinbach
Hinzu kommen Kapazitätsprobleme zur Spitzenzeit: @gengdaJ, seit GLM-4.5 Kunde des Plans, beschreibt Server, die abends „explodieren“, und den Rückgriff auf ältere Modelle. Genau deshalb suchen auch Nutzer, die GLM-5.2 grundsätzlich mögen, nach Alternativen.
Die Alternativen: Preise, Kontext und passende Einsatzfälle
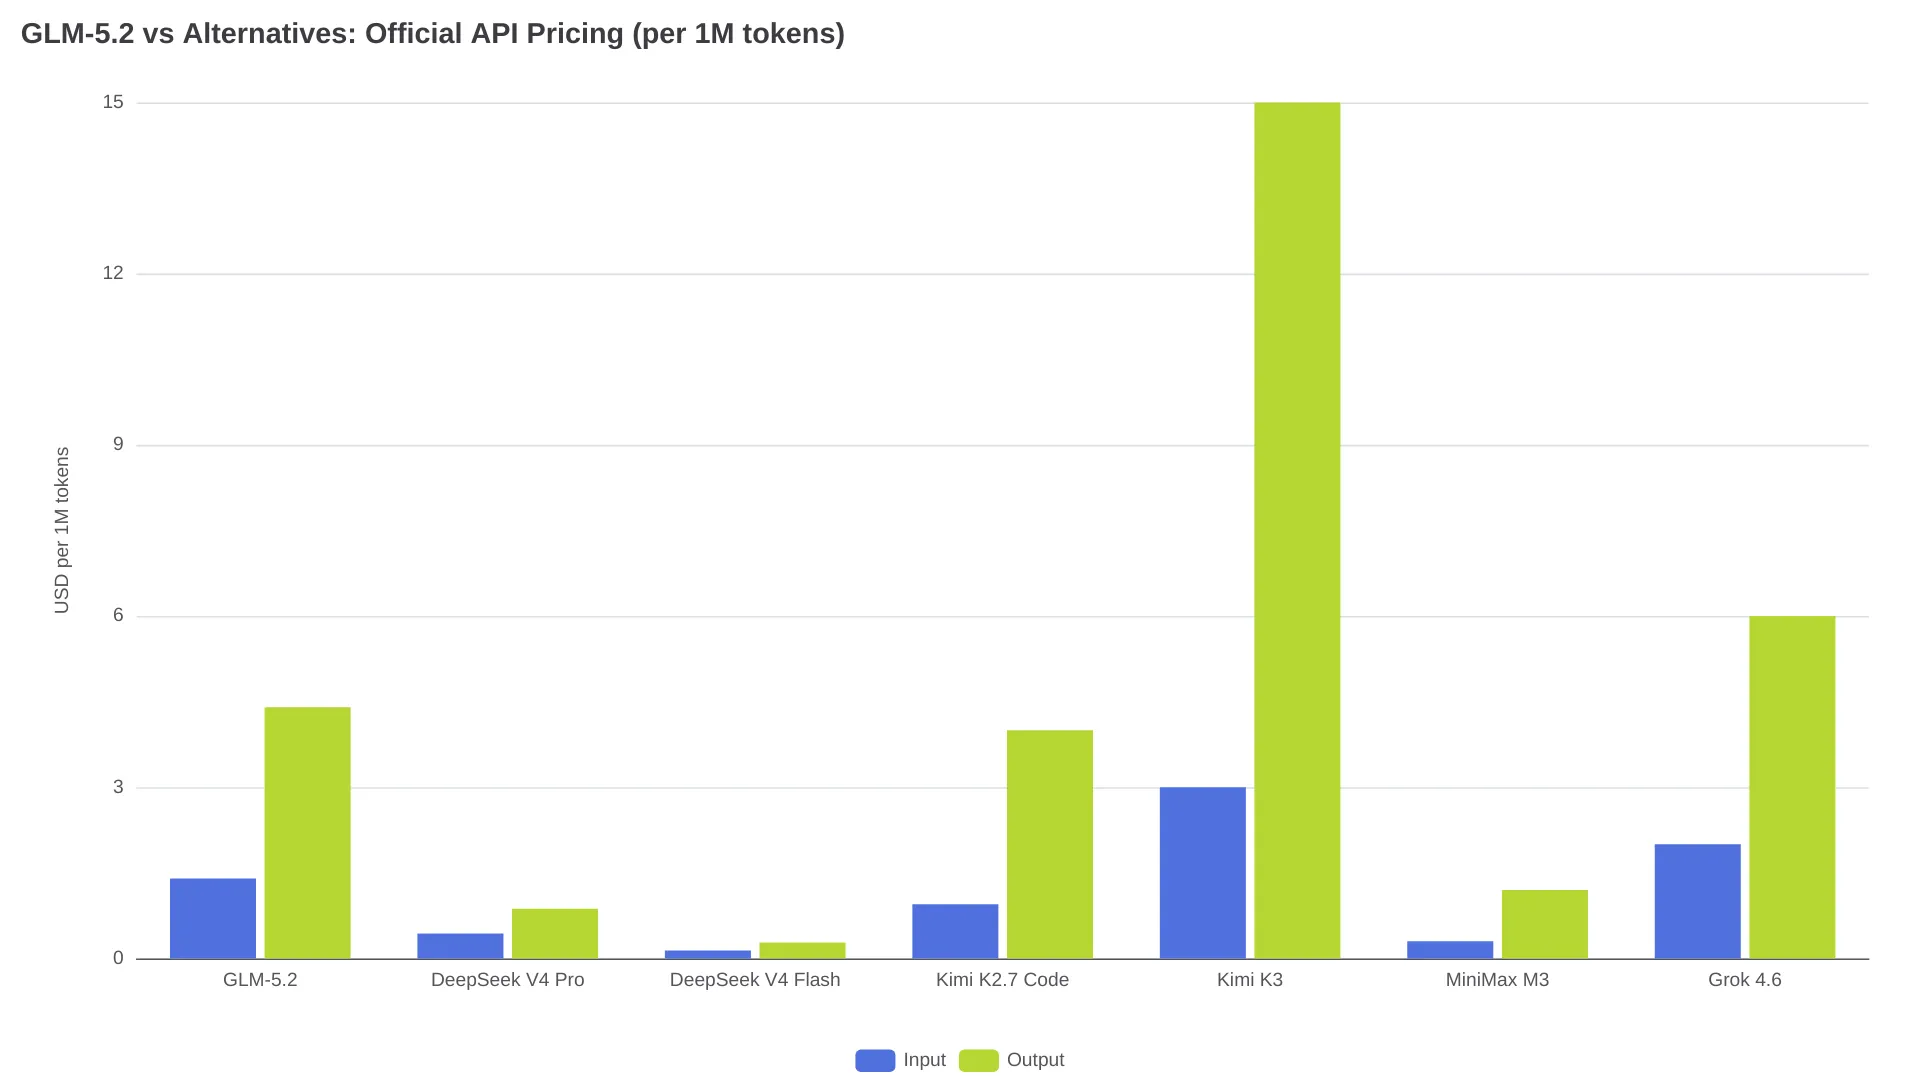
Alle folgenden Preise stammen von den jeweiligen Anbieter-Preislisten und wurden im August 2026 abgerufen. Bei Kimi K3 und MiniMax M3 beziehen sich die Werte auf Input ohne Cache-Treffer; die Tarife bei Cache-Treffern sind deutlich günstiger.
| Modell | Kontext | Gewichte / Lizenz | API-Preis ($/1M, Input / Output) | Wechsel sinnvoll, wenn … |
|---|---|---|---|---|
| GLM-5.2 (Basiswert) | 1M | MIT | $1.40 / $4.40 | — |
| DeepSeek V4 Pro | 1M | Open (MIT, laut Layer3 Labs) | $0.435 / $0.87 | Sie günstigeres anspruchsvolles Reasoning bei gleicher Kontextgröße wollen |
| DeepSeek V4 Flash | 1M | Open | $0.14 / $0.28 | Der Quotenverbrauch das einzige Problem ist |
| Kimi K2.7 Code | 256K | Open (Modified MIT) | $0.95 / $4.00 | Zuverlässige Agent-Schleifen wichtiger als die Kontextgröße sind |
| Kimi K3 | 1M | Closed | $3.00 / $15.00 | Sie Kimi-Stabilität und 1M Kontext benötigen |
| MiniMax M3 | 1M | Closed | $0.30 / $1.20* | Multimodaler Input oder hohes, preissensitives Volumen gefragt ist |
| Qwen3.8 Max / Qwen3-Coder | 1M | Apache 2.0 | Gewichte kostenlos; Hosting variiert | Self-Hosting oder Fine-Tuning das Ziel ist |
| Grok 4.6 | 500K | Closed | $2.00 / $6.00 | Geschwindigkeit und ein großer, aber handhabbarer Kontext zählen |
Zusätzlich zu diesen sieben Modellen folgen unten zwei Upgrade-Wege: Claude Opus 4.8 für Teams, die an den schwierigsten Aufgaben wiederholt scheitern, sowie GLM-5.3 als Upgrade innerhalb derselben Modellfamilie zum gleichen Preis.
\* Der Tarif von MiniMax M3 gilt für Inputs ≤512K Token; oberhalb dieser Schwelle verdoppeln sich die Preise. Laut Launch-Ankündigung von Z.ai kostet GLM-5.3 genauso viel wie GLM-5.2 und ist deshalb im Kostenvergleich nicht aufgeführt.
Welches Modell passt zu welchem Problem?
Quota zu schnell aufgebraucht: Agent-Schleifen über DeepSeek V4 Flash führen
Der Preisunterschied ist massiv: Bei Input ohne Cache-Treffer kostet GLM-5.2 mit $1.40/M das 10-Fache von DeepSeek V4 Flash mit $0.14/M. Beim Output stehen $4.40 gegen $0.28 – ein Faktor von 15.7. Gerade im Umsetzungsteil einer Agent-Schleife, etwa bei Dateiänderungen, Test-Fixes oder Boilerplate, summiert sich das mit jeder Runde. DeepSeek bietet dabei ebenfalls 1M Token Kontext und maximal 384K Token Output. V4 Pro für $0.435/$0.87 behält den Großteil des Preisvorteils und zielt auf anspruchsvollere Reasoning-Läufe; unser Vergleich GLM-5.2 vs DeepSeek V4 Pro zeigt, wo welches Modell vorne liegt, während das direkte Duell mit V4 Flash die Budgetklasse behandelt.
Bei OpenCode-Go-Abonnenten zeichnet sich kein kompletter Wechsel ab, sondern eine Arbeitsteilung: GLM-5.2 übernimmt Planung und Review, ein günstigeres Modell die Routinearbeit. „I use OpenCode Go GLM 5.2 for planning only“, schreibt u/narkeeso; u/Endoky aus demselben Umfeld empfiehlt, „only use GLM 5.2 as escalation model or for planning.“
Fehlerhafte Agent-Schleifen: Kimi K2.7 Code
Wenn nicht die Modellfähigkeit, sondern der Dienst selbst das Problem ist, wird Kimi in den geprüften Threads besonders oft genannt. Die Zusammenfassung eines Nutzers, ursprünglich auf Chinesisch veröffentlicht:
"The model capability is about the same, but the inability to serve it stably is why I chose Kimi over GLM." — @wonjder
Kimi K2.7 Code ist die Wahl für spezialisierte Coding-Aufgaben: $0.95/M Input, $4.00/M Output und $0.19/M bei Cache-Treffern. Das Kontextfenster von 262,144 Token beträgt allerdings nur ein Viertel von GLM-5.2 – das ist der eigentliche Kompromiss. Über Text-, Bild- und Video-Input schließt Kimi außerdem die multimodale Lücke von GLM-5.2 als reinem Textmodell. Reichen 256K nicht für das Repository, bietet Kimi K3 das 1M-Fenster für $3.00/$15.00. Der Output-Preis von $15 liegt 3.4x über GLM-5.2; K3 ist also ein Stabilitätskauf, keine Sparmaßnahme. Die Benchmark-Seite behandelt unser Vergleich Kimi K2.7 Code vs GLM-5.2.
Für die härtesten Aufgaben mehr Leistungsreserve: Claude Opus 4.8
Bei SWE-Marathon – Compiler-Builds, Kernel-Arbeit und mehrstündigen autonomen Jobs – erreicht Opus 4.8 laut Model Card von Z.ai 26.0 gegenüber 13.0 für GLM-5.2. Bei NL2Repo lautet der Abstand 69.7 zu 48.9. GLM-5.2 bleibt laut derselben Model Card auf beiden Boards das bestplatzierte offene Modell, doch gerade bei den längsten Aufgaben wächst der Abstand. Opus ist Closed Source, nicht selbst hostbar und preislich im Premiumsegment; der Vergleich GLM-5.2 vs Opus zeigt, wann sich dieser Aufpreis rechnet.
Self-Hosting und Datenhoheit: Qwen3-Coder oder die GLM-Gewichte selbst
Qwen3-Coder und Qwen3.8 Max erscheinen unter Apache 2.0, bieten 1M Token Kontext und sind auch in kompakten Varianten für den Betrieb auf einer einzelnen GPU erhältlich. Sowohl Layer3 Labs als auch glm5.app führen sie als Self-Hosting-Empfehlung. Für Fine-Tuning und private Deployments sind sie unter diesen Alternativen die praktische Wahl; unsere Analyse zu Qwen 3.8 Max Open Weights behandelt die Modellfamilie.
Die kontraintuitive Option lautet: GLM-5.2 selbst hosten, denn die MIT-Lizenz erlaubt es. Praktisch sind die Hardware-Anforderungen jedoch hoch: BF16-Gewichte benötigen 1.51 TB, und selbst eine 4-Bit-Quantisierung aus Unsloths GGUF-Release braucht zum Laden 372–475 GB Speicher. Ein 4-Bit-Build gehört damit in einen Multi-GPU-Server, vollständiges BF16 in ein Cluster. Auch die lokale Tool-Unterstützung ist noch jung: llama.cpp erhielt GLM-5.2-Indexer-Support erst am 24. Juli 2026 mit PR #25407. GLM-5.2 selbst zu hosten ist eine Entscheidung für Datensouveränität, nicht für Komfort; ohne Cluster sind Qwens kompakte Varianten die workstationtaugliche Alternative.
Multimodal und günstig bei hohem Durchsatz: MiniMax M3
MiniMax M3 kombiniert 1M Kontext mit multimodalem Input für $0.30/M Input und $1.20/M Output. Diese Werte gelten für die Stufe ≤512K; oberhalb der Schwelle verdoppeln sich beide Preise, was bei der Budgetplanung berücksichtigt werden sollte. Für Teams bietet MiniMax Token-Pläne für $20/$50/$120 monatlich an. Sie gelten für das M3-, M2.7-, Bild- und Sprachportfolio des Unternehmens; die Quoten werden in rollierenden 5-Stunden- und Wochenfenstern gemessen.
Wenn Geschwindigkeit an erster Stelle steht: Grok 4.6
Grok 4.6 kostet laut Liste $2.00/M Input und $6.00/M Output bei 500K Kontext. Die API-Seite von xAI beansprucht branchenführende Coding- und Tool-Calling-Fähigkeiten, veröffentlicht dazu aber keine Benchmark-Tabelle. Diese Positionierung sollte daher auch als solche behandelt werden. Ein Nutzersignal gibt es trotzdem: @bourneliu66 schreibt, Grok habe GLMs Platz in seinen „big three“ übernommen und sei seiner Einschätzung nach stärker, schneller und günstiger. Vor einer Übernahme dieser Rangfolge sollte sie gegen die eigene Workload geprüft werden.
Kein Problem mit GLM, nur der Wunsch nach der neuesten Version: GLM-5.3
GLM-5.3 kam am 18. August 2026 zur API – laut Ankündigung von Z.ai zu demselben Preis wie GLM-5.2. Wer nicht wegen konkreter Probleme, sondern aus Upgrade-Sorge nach Alternativen sucht, findet im Vergleich GLM-5.2 vs GLM-5.3 die tatsächlichen Änderungen.
Das Split-Stack-Muster: GLM-5.2 behalten, aber anders einsetzen
In den oben genannten Threads endet die Suche oft nicht mit einer vollständigen Migration. Stattdessen wird GLM-5.2 zum Planungs- und Review-Modell herabgestuft, während ein günstigeres Modell die Ausführung übernimmt. Das passt zum Profil des Modells: Z.ai positioniert es für lang laufende Engineering-Agent-Aufgaben, zugleich ist es im Budgetsegment das teuerste Modell pro Token.
Zwei technische Details entscheiden über Erfolg oder Misserfolg dieser Aufteilung. Erstens der Verlust des KV-Cache: Jeder Wechsel während eines Laufs – zwischen Modellen oder zwischen Anbietern desselben Modells – verursacht erneut Kosten für den Kontext. Zweitens unterscheiden sich die Provider erheblich: Nutzer in r/opencodeCLI berichten über große Geschwindigkeitsunterschiede zwischen Fireworks, NeuralWatt und OpenCode Go, obwohl sie dasselbe Modell bedienen.
Ein einzelner OpenAI-kompatibler Endpoint vereinfacht die operative Seite: Für beide Abschnitte bleibt dieselbe GLM-5.2 API-Request-Struktur erhalten, bei nachlassender Provider-Qualität kann umgeroutet werden, und es fällt nur eine Rechnung an. Kontext wird dadurch aber nicht kostenlos: Cache-Wiederverwendung funktioniert weder modell- noch providerübergreifend. Genau das war der Kostentreiber hinter dem $500-Wochenendbericht. Deshalb sollte das Routing an Aufgabengrenzen erfolgen, nicht mitten im Lauf. Wenn die Aufteilung in Claude Code stattfinden soll, behandelt unser Guide zu GLM-5.2 in Claude Code die Harness-Seite.
Entscheidung in 30 Sekunden
| Ihr Problem | Empfehlung | Worauf Sie verzichten |
|---|---|---|
| Wöchentliche Quote an einem Tag verbraucht | DeepSeek V4 Flash | Etwas Agentic-Coding-Politur gegenüber GLM |
| Agent-Schleifen scheitern an Provider-Fehlern | Kimi K2.7 Code | 1M Kontext (stattdessen 256K) |
| Die schwierigsten mehrstündigen Aufgaben scheitern | Claude Opus 4.8 | Offene Gewichte, niedrige Preise, Self-Hosting |
| Gewichte müssen auf eigener Hardware laufen | Qwen3-Coder | GLMs Elo-Spitzenplatz bei Frontend-Coding |
| Hoher Tokenverbrauch bei allgemeinen Aufgaben | MiniMax M3 | Oberhalb von 512K Input verdoppeln sich die Preise |
| Regulierte Umgebung oder Procurement-Vorgaben | Selbstgehostete Qwen- oder GLM-Gewichte | Komfort eines Managed Service |
| Sie möchten das neueste GLM | GLM-5.3 | Nichts; gleicher Preis |
FAQ
Was ist insgesamt die beste Alternative zu GLM-5.2?
DeepSeek V4 Pro ist der ähnlichste Allround-Ersatz: 1M Kontext, offene Gewichte und pro Token 3-5x günstiger. Kimi K2.7 Code ist die bessere Wahl, wenn Zuverlässigkeit in langen Agent-Läufen wichtiger ist als die Benchmark-Differenz.
Ist DeepSeek fürs Programmieren besser als GLM-5.2?
Für schwieriges algorithmisches Reasoning liegt DeepSeek V4 Pro laut dem Vergleich von glm5.app vorn. Bei langfristiger Agent-Arbeit über mehrere Dateien hinweg bleibt GLM-5.2 dank 1M Kontext und seines langfristigen Agenten-Trainings – laut Z.ai die erklärte Spezialisierung – voraus. Praktisch heißt das: DeepSeek führt aus, GLM plant.
Welche GLM-5.2-Alternative ist am günstigsten?
DeepSeek V4 Flash für $0.14/M Input und $0.28/M Output. Input bei Cache-Treffern kostet $0.0028/M und ist bei wiederholtem Kontext damit faktisch kostenlos.
Welche Alternativen bieten wie GLM-5.2 ein Kontextfenster von 1M Token?
DeepSeek V4 Pro und V4 Flash, Kimi K3, MiniMax M3 und Qwen3.8 Max führen alle Fenster mit 1M Token. Kimi K2.7 Code mit 256K und Grok 4.6 mit 500K nicht.
Lässt sich GLM-5.2 lokal ausführen, statt zu wechseln?
Technisch ja, denn es gibt MIT-Gewichte. Ein 4-Bit-Build benötigt allerdings 372–475 GB RAM, und der Support in llama.cpp wurde erst am 24. Juli 2026 gemergt. Für die meisten Teams ist ein gehosteter API-Zugang deshalb der einzige praktikable Weg.
Was kosten GLM-5.2-Alternativen monatlich im Abo?
Die Token-Pläne von MiniMax kosten $20–$120 monatlich. Kimi Code CLI startet bei $19 pro Monat und Z.ai's Coding Plan bei $18 pro Monat, laut der Preisübersicht von Digital Applied; der Z.ai-Pro-Tarif liegt seit der Erhöhung im Juni bei $65.