 AIREITER
Gemini 3.8 Flash kostet bis zum 31. Dezember 2026 $0.75 pro einer Million Input-Tokens und $3.75 pro einer Million Output-Tokens. Mehr Reasoning kann abgeschlossene Aufgaben jedoch verteuern. Teste das Modell daher gezielt für multimodale und spezialisierte Agenten, statt sämtliche Gemini 3.7 Flash-Anfragen umzustellen.
Die wichtigste Antwort zum Start: Was Gemini 3.8 Flash tatsächlich ist
Gemini 3.8 Flash startete laut Googles Ankündigung am 2. September 2026. Die stabile API-Modell-ID lautet gemini-3.8-flash. Google positioniert das Modell für Softwareentwicklung, autonome Agenten und mehrstufige Workflows in Unternehmen. Auf der Modellseite von Google AI for Developers wird es als stabil geführt. Die Model Card von Google DeepMind bezeichnet es als Modell auf Basis von Gemini 3.7 Flash.
Was sich gegenüber Gemini 3.7 Flash geändert hat
Google zufolge führt Gemini 3.8 Flash bei schwierigen Aufgaben mehr Reasoning-Schritte aus und ruft Tools iterativ auf. Gleichzeitig weist Google darauf hin, dass ein höherer Arbeitsaufwand mehr Tokens verbrauchen kann. Artificial Analysis kommt beim Intelligence Index mit hohem Reasoning auf 59 Punkte gegenüber 56 für Gemini 3.7 Flash. Die Kosten pro Aufgabe liegen dabei jedoch bei $0.58 statt $0.40. (Googles Ankündigung; Vergleich von Artificial Analysis)
Erst den Workload analysieren, dann das Modell auswählen
Gemini 3.8 Flash spielt seine Stärken aus, wenn eine Anfrage von großem Kontext, mehreren Tools oder multimodalen Informationen profitiert. Kurze, wiederholbare Aufgaben brauchen die zusätzlichen Schleifen möglicherweise nicht.
Gemini 3.8 Flash für multimodale und spezialisierte Agenten einsetzen
BenchmarkList meldet 61.4 % bei Finance Agent v2, 54.9 % bei HLE-Verified, 87.8 % bei LVBench, 86.2 % bei CharXiv-R und 86.2 % bei LABBench2. Die Datensätze unterscheiden zwischen Ergebnissen aus dem Launch-Post, selbst gemeldeten Resultaten und unabhängig bezogenen Werten. Die Zahlen sind daher Anhaltspunkte und kein einheitlicher, unabhängiger Test. (Modelleintrag bei BenchmarkList)
| Workload | Relevante Daten | Entscheidung |
|---|---|---|
| Finanz- und strukturierte Analysen | Finance Agent v2: 61.4 % | Guter Kandidat für einen kontrollierten Pilotbetrieb |
| Verständnis langer Videos oder Diagramme | LVBench: 87.8 %; CharXiv-R: 86.2 % | Guter Kandidat, wenn reine Textmodelle schlecht passen |
| Biologische und wissenschaftliche Workflows | LABBench2: 86.2 %; BioMysteryBench, für Menschen schwierige Aufgaben: 56.5 % | Mit fachkundiger Prüfung testen |
| Lange Dokumente und PDFs | Input-Limit von 1,048,576 Tokens; PDF-Eingaben werden unterstützt | Für Retrieval und Zusammenfassungen nützlich, Recall anschließend prüfen |
In seiner Model Card führt Google weiterhin Halluzinationen, Timeouts und gelegentliche Verzögerungen als Einschränkungen auf. (Model Card von Gemini 3.8 Flash)
Gemini 3.7 Flash für einfache, effizienzorientierte Anfragen behalten
Eine Pipeline für Klassifizierung, Extraktion, Tagging oder kurze Zusammenfassungen braucht möglicherweise kein zusätzliches Reasoning. Artificial Analysis hat Gemini 3.8 Flash bei geringem Reasoning mit $0.24 pro Aufgabe und 0.8 Minuten gemessen. Bei hohem Reasoning waren es $0.58 und 2.5 Minuten. Bei Gemini 3.7 Flash lagen die Werte für hohes Reasoning bei $0.40 pro Aufgabe und 2.2 Minuten.
Setze 3.8 dort ein, wo zusätzliches Reasoning fehlerhafte Aufgaben verhindert. Für Workloads, bei denen mehr Output lediglich zusätzliche Kosten verursacht, bleibt 3.7 die passendere Wahl.
Nicht als universellen Sieger für autonome Coding-Agenten betrachten
BenchmarkList führt 89.4 % bei Terminal-Bench 2.1 und 73.7 % bei DeepSWE 1.1 auf, aber nur 19.1 % bei Terminal-Bench 4.0. Außerdem werden 59.0 % bei OSWorld 2.0 genannt, einer Evaluation für langfristige Computer-Use-Aufgaben. (Coding- und Agenten-Ergebnisse von BenchmarkList)
Bei einem Terminal- oder Desktop-Agenten, der versteckte Zustände erkennen, Änderungen überprüfen und nach Tool-Fehlern weitermachen muss, solltest du Gemini 3.8 Flash zunächst anhand desselben Workflows mit deinem aktuellen Modell vergleichen.
Entscheidend sind die Kosten pro Aufgabe, nicht pro einer Million Tokens
Gemini 3.8 Flash: API-Preise bis 2026
Googles offizieller Launch-Post nennt die folgenden direkten API-Preise. Der Einführungspreis gilt bis zum 31. Dezember 2026, ab dem 1. Januar 2027 greift der reguläre Tarif. (Googles Ankündigung)
| Zeitraum | Input-Preis | Output-Preis | Praktische Einordnung |
|---|---|---|---|
| Bis 31. Dez. 2026 | $0.75 / 1M Tokens | $3.75 / 1M Tokens | Einführungspreis |
| Ab 1. Jan. 2027 | $1.50 / 1M Tokens | $7.50 / 1M Tokens | Beide Preise verdoppeln sich |
Output-Tokens kosten zum Einführungspreis fünfmal so viel wie Input-Tokens. Googles Dokumentation nennt außerdem Batch API, Flex Inference und Priority Inference. Auf der zitierten Modellseite stehen dafür jedoch keine konkreten Preise.
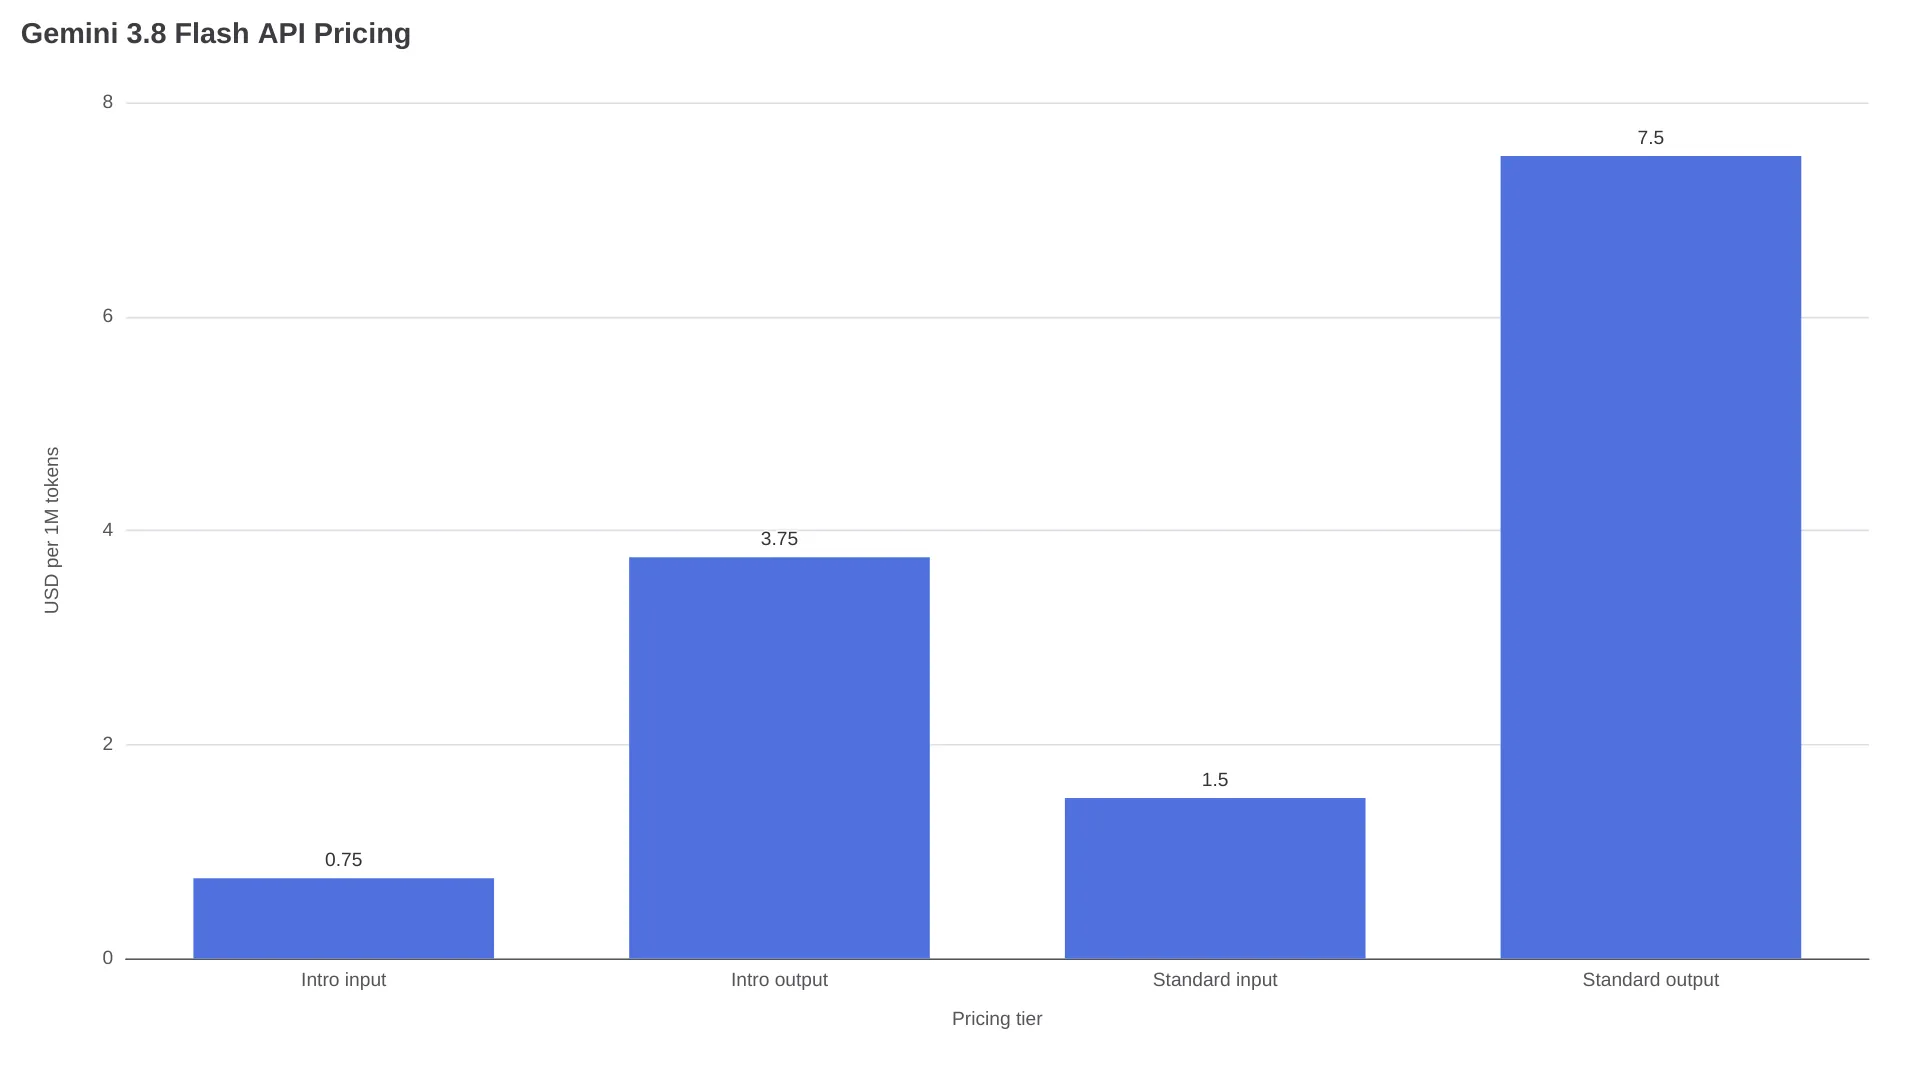
Eine Aufgabe mit 2 Millionen Input-Tokens und 500.000 Output-Tokens kostet zum Einführungspreis $3.38: (2 × $0.75) + (0.5 × $3.75). Mit dem Tarif ab dem 1. Januar 2027 kostet derselbe Mix $6.75: (2 × $1.50) + (0.5 × $7.50).
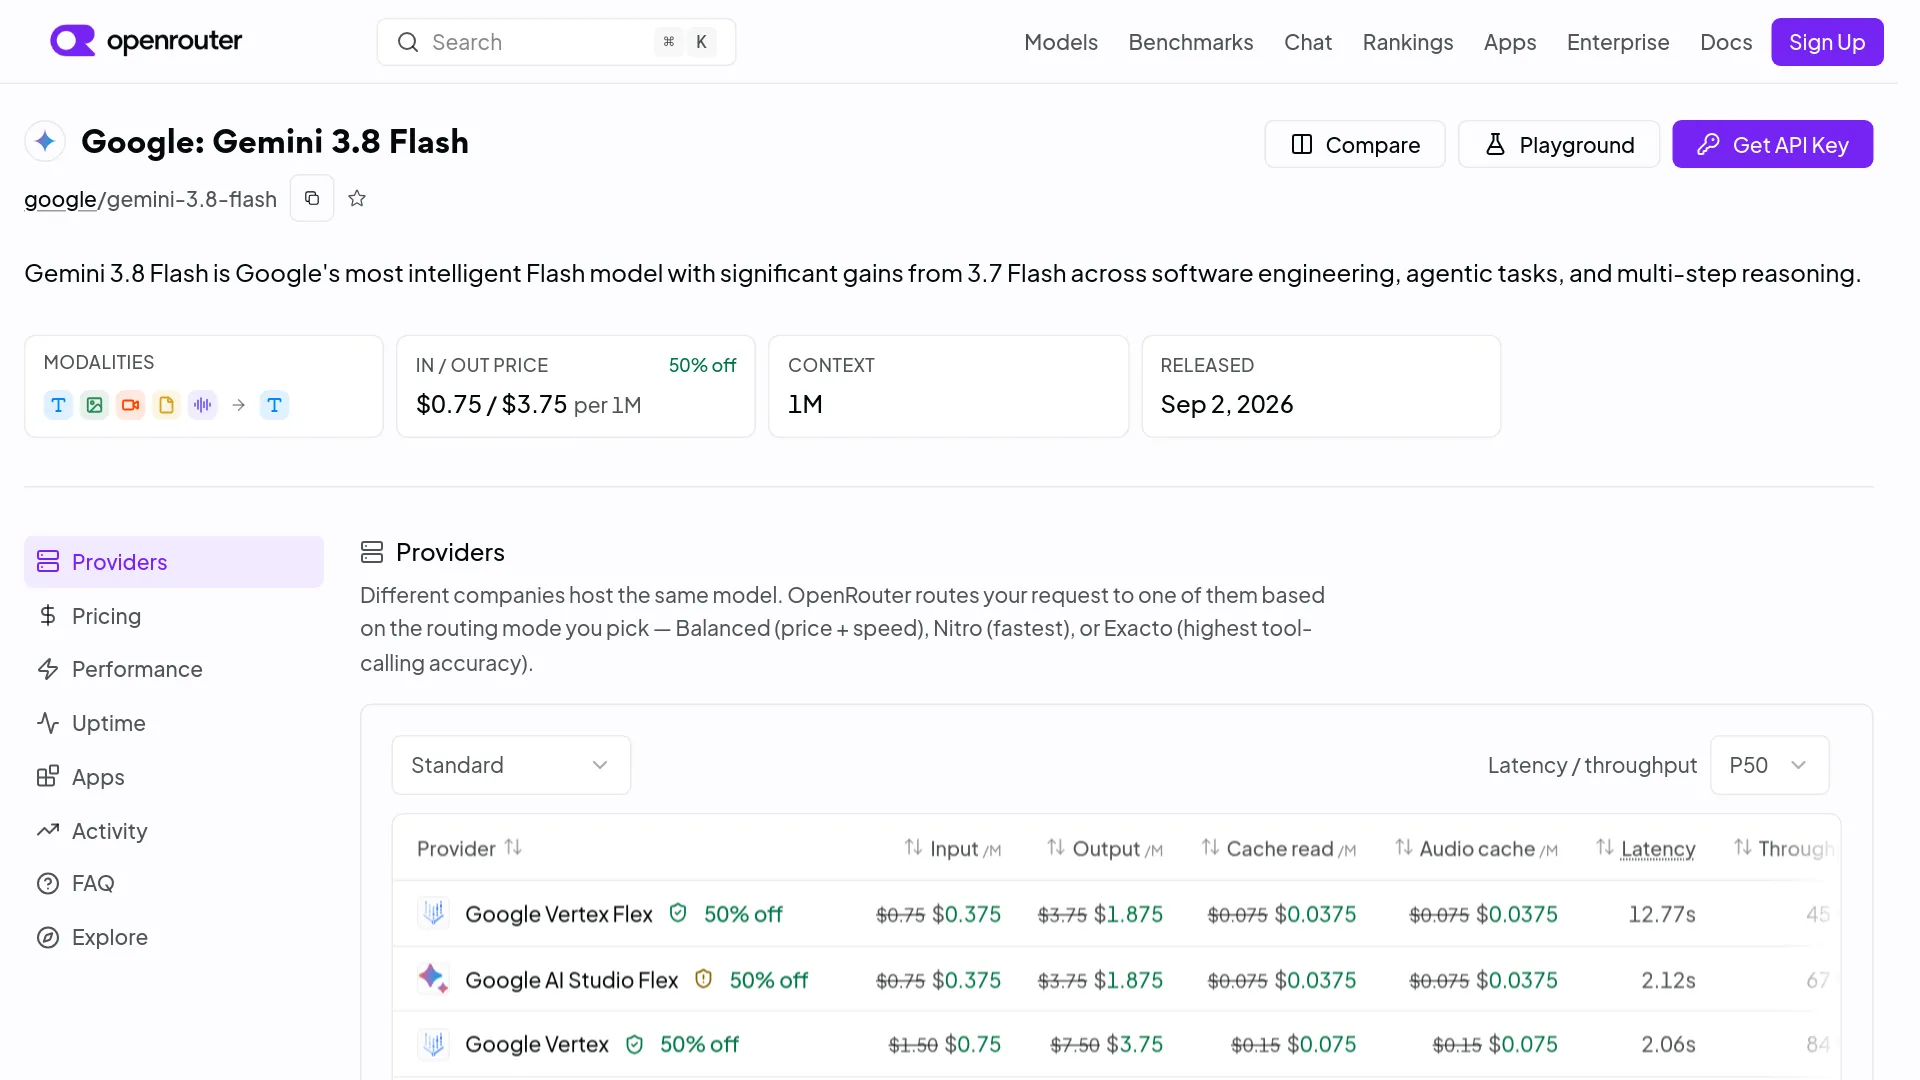
Die OpenRouter-Seite zu Gemini 3.8 Flash führt separat die Routen über Google Vertex und Google AI Studio, Cache-Preise, Latenz, Durchsatz und einen angezeigten Rabatt auf. Prüfe vor einem Vergleich mit Googles direkter Preisliste immer Anbieter und Abrechnungsweg.
Warum ein günstiger Token am Ende eine höhere Rechnung bedeuten kann
Artificial Analysis nennt für Gemini 3.8 Flash folgende Messwerte nach Reasoning-Stufe:
| Reasoning-Stufe | Intelligence Index | Kosten pro Aufgabe | Zeit pro Aufgabe |
|---|---|---|---|
| Niedrig | 52 | $0.24 | 0.8 Minuten |
| Mittel | 57 | $0.41 | Nicht angegeben |
| Hoch | 59 | $0.58 | 2.5 Minuten |
Für mittleres Reasoning nennt Artificial Analysis in der zitierten Analyse keine Zeitangabe. Dieselbe Analyse berichtet, dass Gemini 3.8 Flash während der Intelligence-Index-Evaluation 120 Millionen Output-Tokens erzeugte. Bei vergleichbaren Modellen lag der Median bei 71 Millionen Tokens. Das ist ein Messwert über die gesamte Evaluation und keine Prognose für jede API-Anfrage. Er zeigt aber, warum der Token-Preis allein keine belastbare Grundlage für das Produktionsbudget ist. (Modellprofil von Artificial Analysis)
Für einen internen Vergleich solltest du pro abgeschlossener Aufgabe sämtliche Input-, gecachten Input-, Reasoning- und Output-Tokens erfassen. Teile die API-Ausgaben anschließend durch die erfolgreich erledigten Aufgaben und nicht durch die Zahl der gesendeten Anfragen. Tool-Aufrufe, Wiederholungen und manuelle Korrekturen gehören ebenfalls in die Rechnung.
API-Limits und Funktionen
Was die stabile API unterstützt
Die offizielle Modellseite nennt ein maximales Input-Limit von 1,048,576 Tokens und ein maximales Output-Limit von 65,536 Tokens. Gemini 3.8 Flash akzeptiert Text, Bilder, Videos, Audio und PDFs als Eingabe und gibt Text aus. Unterstützt werden Caching, Code Execution, File Search, Function Calling, Google Maps Grounding, Search Grounding, strukturierte Ausgaben, URL Context sowie Computer Use als Preview. (offizielle Modelldokumentation)
Für Thinking stehen die Stufen low, medium und high zur Verfügung. minimal wird nicht unterstützt und führt zu einem Fehler. Das Modell erzeugt nativ weder Bilder noch Audio. Außerdem führt die Entwicklerdokumentation keine Unterstützung für die Live API auf.
Wo du es einsetzen kannst – und warum Cyber etwas anderes ist
Google führt Gemini 3.8 Flash für die Gemini API, Google AI Studio, Android Studio, Stitch, Google Antigravity, Gemini Enterprise, die Gemini-App, den AI Mode in der Google-Suche und Gemini in Google Sheets auf. (Googles Ankündigung)
Gemini 3.8 Flash Cyber ist eine separate Variante für Cybersicherheit. Laut Google wird der Zugang über Fairwind für vertrauenswürdige Verteidiger priorisiert, darunter staatliche Stellen, Betreiber kritischer Infrastruktur und Software-Maintainer. Im Launch-Post werden mehr als 70 % Erfolg bei einem internen Benchmark zur Schwachstellensuche über 20 Programmiersprachen hinweg sowie 47.2 % pass@1 beim Patching mit CWE-Bench genannt. Diese Werte beziehen sich auf Cyber und nicht auf das allgemeine Modell. Googles Ankündigung beschreibt den Zugang über Fairwind. Gehe daher nicht davon aus, dass die allgemeine Flash-API-Route automatisch Zugriff auf Cyber bietet. (Googles Cyber-Ankündigung)
Der frühe Produkt-Rollout kann sich je nach Konto und Oberfläche unterscheiden. Ein Reddit-Nutzer berichtete:
„3.8 Flash wird jetzt auch in der Gemini-Web-App bei mir angezeigt, es scheint also offiziell verfügbar zu sein. Ich bin in Australien und habe ein Pro-Abo, aber in AntiGravity oder der iOS-App ist es noch nicht aufgetaucht.“ — u/DMAC80, r/GeminiAI
Prüfe bei einer Anwendung die konfigurierte API-Modell-ID gemini-3.8-flash sowie alle Antwort-Metadaten, die deine Integration bereitstellt. Die Selbstbeschreibung eines Modells bestätigt nicht, welcher Endpunkt tatsächlich verwendet wird.
Was die bisherigen Daten noch nicht belegen
| Dokumentierte Einschränkung | Praktische Bedeutung |
|---|---|
| Artificial Analysis misst bei hohem Reasoning 13.39 Sekunden bis zum ersten Antwort-Token, danach jedoch etwa 304.6 Output-Tokens pro Sekunde. (Modellprofil von Artificial Analysis) | Rechne zunächst mit einer Reasoning-Pause und anschließend mit schneller Generierung. |
| Die Model Card von DeepMind nennt einen Wissensstand bis März 2026; für einige Bereiche reicht er nur bis Januar 2025. (Model Card von Gemini 3.8 Flash) | Für aktuelle Informationen Search Grounding oder verifiziertes Retrieval verwenden. |
| Computer Use ist nur als Preview verfügbar, die Entwicklerdokumentation nennt keine Option für Self-Hosting, und die Ausgabe besteht aus Text statt Bild, Audio oder Video. (Googles Entwicklerdokumentation) | Für diese Anforderungen einen separaten Deployment-Weg oder ein Fallback-Modell vorsehen. |
Ein risikoarmer Rollout-Plan für den Produktionseinsatz
- Wähle 30–50 reale Aufgaben aus, die deinen Produktionsmix abbilden – einschließlich Fällen mit langem Kontext und bekannten Fehlern.
- Lass Gemini 3.8 Flash mit niedriger, mittlerer und hoher Thinking-Stufe gegen dein aktuelles Modell antreten.
- Protokolliere sämtliche Tokens, Cache-Treffer, Tool-Runden, Wiederholungen, die Zeit bis zum ersten Token, die Abschlusszeit, manuelle Korrekturen und die Rate akzeptierter Aufgaben.
- Berechne die Kosten pro erfolgreich erledigter Aufgabe und trenne interaktive Anfragen von Batch-Verarbeitung.
- Leite zunächst nur einen kleinen Teil der Produktionsanfragen über Gemini 3.8 Flash, bevor du die Standardroute änderst.
- Behalte Gemini 3.7 Flash für einfache Aufgaben, wenn zusätzliches Reasoning die Kosten pro akzeptiertem Ergebnis nicht verbessert.
- Plane ab dem 1. Januar 2027 mit $1.50 für Input und $7.50 für Output pro einer Million Tokens.
Der beste erste Test hat ein überprüfbares Ergebnis: eine Änderung über mehrere Dateien hinweg inklusive Tests, ein Dokumenten-Workflow mit bekannter Antwort oder eine multimodale Extraktionsaufgabe mit geprüften Labels.
FAQ zu den Gemini 3.8 Flash API-Preisen
Wie viel kostet Gemini 3.8 Flash?
Googles direkter API-Einführungspreis beträgt bis zum 31. Dezember 2026 $0.75 pro einer Million Input-Tokens und $3.75 pro einer Million Output-Tokens. Ab dem 1. Januar 2027 steigen die genannten Preise auf $1.50 und $7.50.
Ist Gemini 3.8 Flash besser als Gemini 3.7 Flash?
Bei mehreren Reasoning- und Agenten-Messungen zum Start liegt es vorn, darunter beim Intelligence Index von Artificial Analysis mit hohem Reasoning: 59 gegenüber 56. Für einfache Workloads kann Gemini 3.7 Flash trotzdem günstiger sein, weil 3.8 möglicherweise mehr Output-Tokens erzeugt.
Eignet sich Gemini 3.8 Flash für Coding-Agenten?
Das Modell ist ein ernstzunehmender Kandidat. Gemeldet werden 89.4 % bei Terminal-Bench 2.1 und 73.7 % bei DeepSWE 1.1. Das Ergebnis von 19.1 % bei Terminal-Bench 4.0 zeigt jedoch, dass langfristige Terminal- und Desktop-Workflows separat getestet werden müssen.
Ist Gemini 3.8 Flash kostenlos?
Die API wird zu den genannten Token-Preisen abgerechnet. Prüfe die aktuellen Konditionen für AI-Studio-Projekte separat von der direkten API-Preisliste.
Was ist Gemini 3.8 Flash Cyber und wer erhält Zugriff?
Gemini 3.8 Flash Cyber ist auf die Suche nach Schwachstellen und automatisiertes Patching ausgerichtet. Google zufolge wird der Zugang über das Fairwind Program für vertrauenswürdige Verteidiger priorisiert. Das Modell ist nicht als allgemein zugängliches Modell über einen gewöhnlichen Gemini 3.8 Flash API-Schlüssel verfügbar.
Starte mit niedrigem oder mittlerem Reasoning auf einem festen Aufgabensatz. Miss die Kosten pro akzeptiertem Ergebnis und erhöhe den Aufwand nur dort, wo die zusätzliche Arbeit einen messbaren Fehler verhindert.