 AIREITER
Ein Aufruf von gemini-2.5-pro am 2. Dezember wird nicht einfach fehlschlagen. Stattdessen antwortet ein anderes Modell. Google hat gemini-2.5-pro und gemini-2.5-flash am 2. November 2026 eingestellt. Ab dem 1. Dezember 2026 leitet die Gemini Developer API diese IDs automatisch auf gemini-3.8-flash und gemini-3.5-flash-lite um – zu den Preisen der jeweiligen Ersatzmodelle. Genau darin liegt das Risiko: Es handelt sich nicht nur um einen neuen Modellnamen, sondern um einen Wechsel der Modellklasse mit inkompatiblen Parametern. Wer den alten String bis Dezember unverändert lässt, verschiebt die eigentliche Migration lediglich.
Was Google für den 1. Dezember angekündigt hat
Google hat gemini-2.5-pro und gemini-2.5-flash in der Gemini Developer API eingestellt. Beide IDs sind aus der Auswahl in Google AI Studio verschwunden, und der API-Zugriff ist inzwischen auf Entwickler beschränkt, die das jeweilige Modell bereits verwendet haben. Ab dem 1. Dezember 2026 laufen Anfragen zwar weiterhin durch, aber unter einem anderen Modell und zu einem anderen Preis.
Die Zuordnung stammt aus Googles Übersicht zu den Gemini-API-Einstellungen:
| Aufgerufene alte ID | Antwortendes Modell ab 1. Dez. 2026 | Abrechnung ab 1. Dez. |
|---|---|---|
gemini-2.5-pro | gemini-3.8-flash | Preise von Gemini 3.8 Flash |
gemini-2.5-flash | gemini-3.5-flash-lite | Preise von Gemini 3.5 Flash-Lite |
gemini-2.5-flash-lite | unverändert, keine Umleitung | unverändert |
Google nennt den 1. Dezember 2026 als Umleitungsdatum für beide stabilen IDs. Als Hinweis dient der Changelog-Eintrag vom 2. November 2026. Google-DeepMind-Mitarbeiter Patrick Loeber hat ihn in einem PSA verlinkt und darauf hingewiesen, dass anspruchsvollere Integrationen die Migrationsanleitung berücksichtigen müssen.
Die Ankündigung betrifft ausschließlich die Gemini Developer API und AI Studio. Für Vertex AI gilt ein separater Zeitplan: Google Cloud nennt für dieselben Modellnamen Termine im Oktober 2026. Auch Firebase AI Logic führt eine eigene Liste unterstützter Modelle. Wer Vertex AI nutzt, sollte daher in der Cloud Console nachsehen, statt automatisch vom 1. Dezember auszugehen.
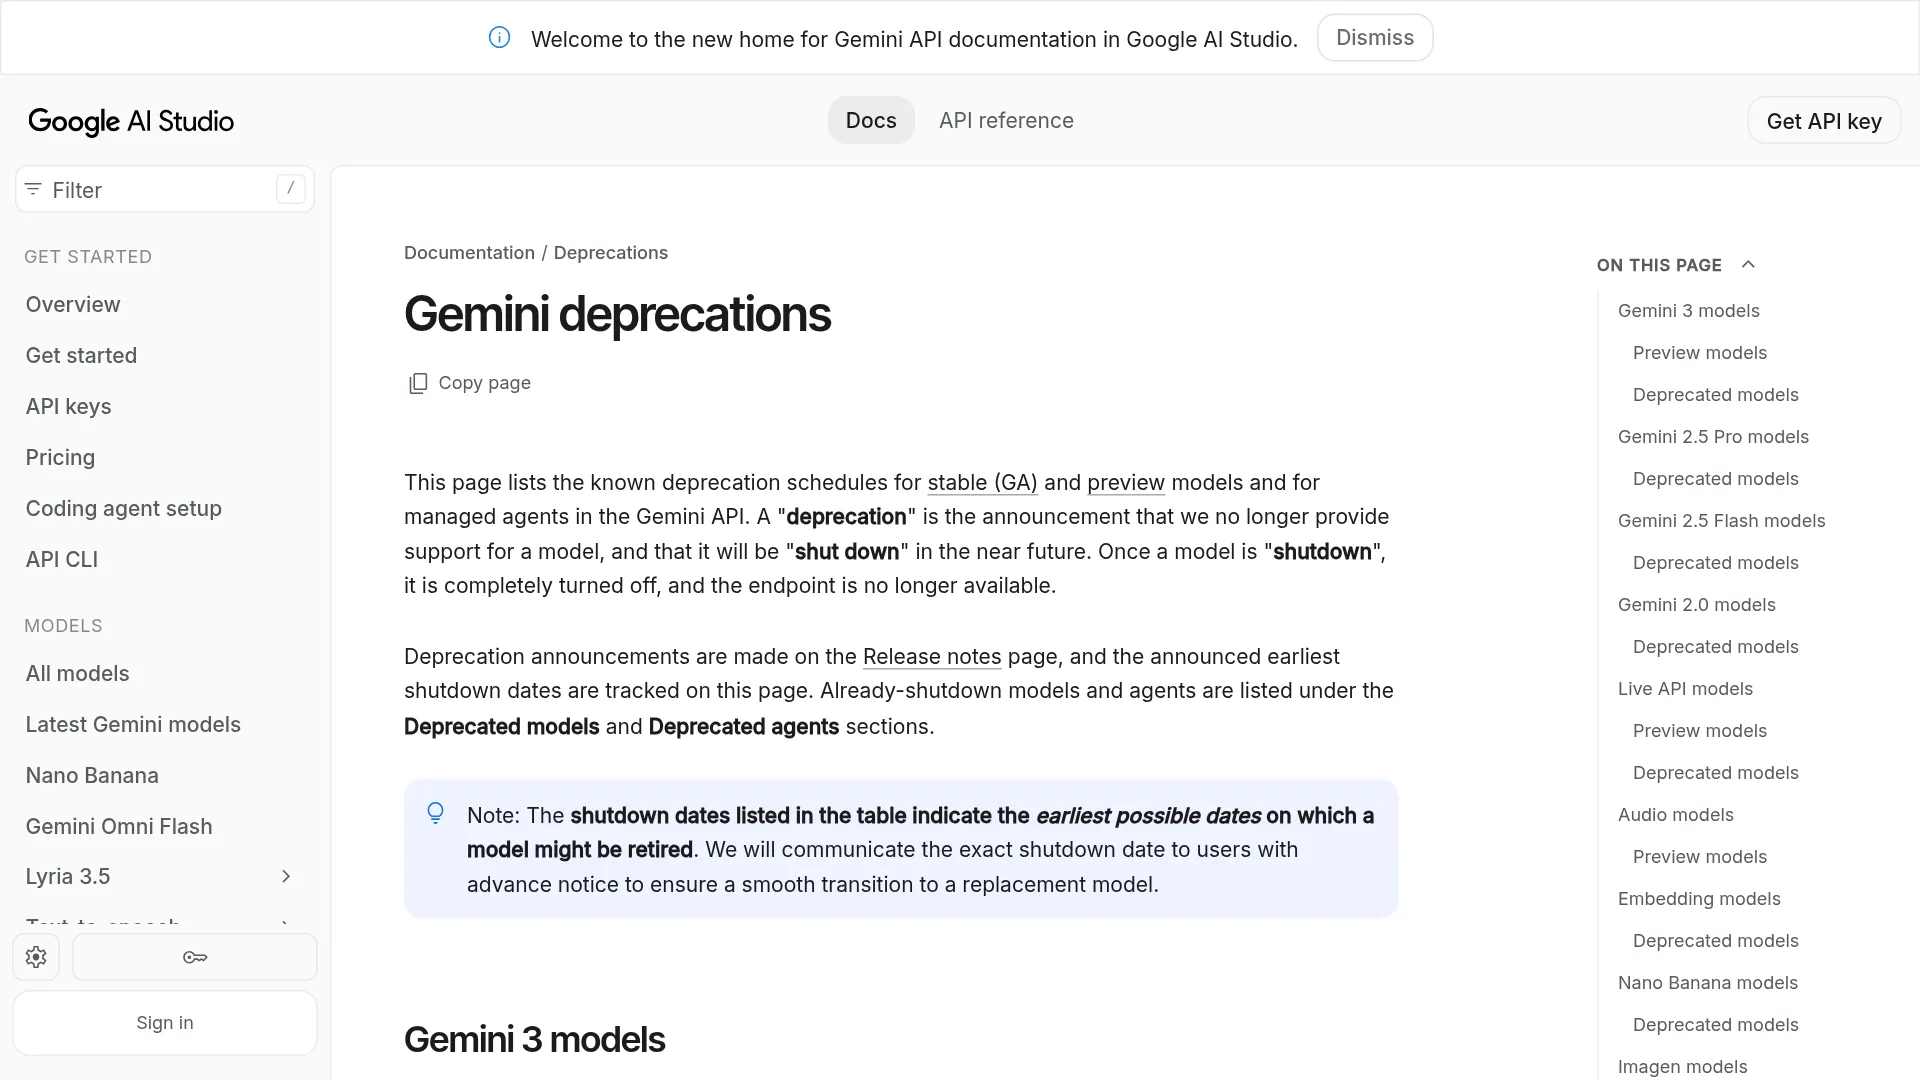
Am 18. September bezeichnete Google 2.5 noch als „nicht eingestellt“, am 2. November folgte dann doch die Abkündigung. Der 1. Dezember sollte deshalb als verbindlicher Termin behandelt werden. Die Changelog-Historie dokumentiert diesen Kurswechsel.
Was die Umleitung im Dezember und Januar kostet
Der Gemini-2.5-Pro-Traffic wird im Dezember günstiger, bevor die Eingabekosten im Januar steigen. Bei Gemini 2.5 Flash bleibt die Abrechnung für Texteingaben nach der Umstellung gleich, während Audioeingaben deutlich günstiger werden. Alle folgenden Werte sind Listenpreise für den kostenpflichtigen Tarif pro 1 Mio. Tokens aus Googles Gemini-API-Preisliste, Stand 3. November 2026. Einen Überblick auf Modellebene bieten die Beiträge zu Gemini-3.8-Flash-Preisen und Gemini 3.5 Flash-Lite.
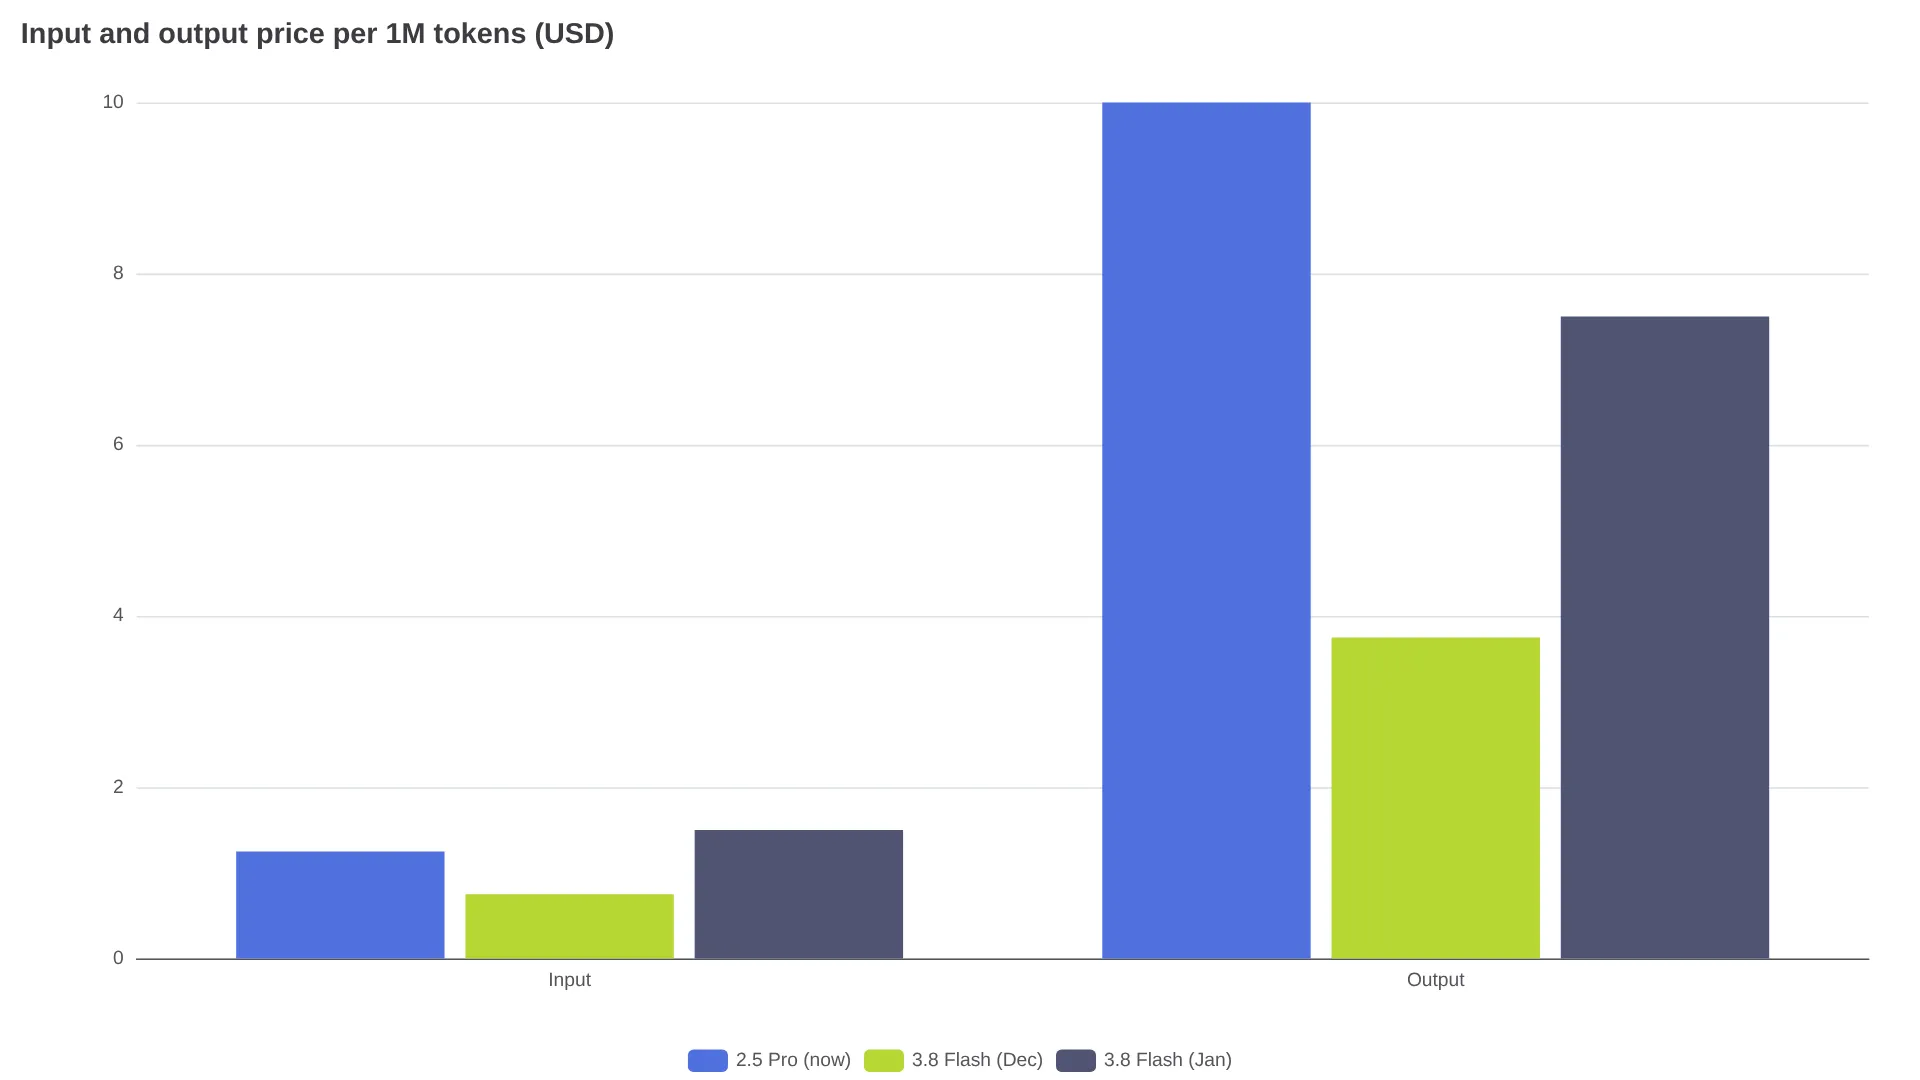
| Modell und Zeitraum | Eingabe / 1 Mio. | Ausgabe inkl. Thinking / 1 Mio. |
|---|---|---|
gemini-2.5-pro, Prompts ≤200k Tokens, bis 30. Nov. | $1.25 | $10.00 |
gemini-2.5-pro, Prompts >200k Tokens, bis 30. Nov. | $2.50 | $15.00 |
gemini-3.8-flash, 1.–31. Dez. 2026 | $0.75 | $3.75 |
gemini-3.8-flash, ab 1. Jan. 2027 | $1.50 | $7.50 |
Bei Gemini 3.8 Flash gibt es unabhängig von der Prompt-Länge nur eine Preisstufe. Workloads mit mehr als 200.000 Tokens im Kontext profitieren daher am stärksten. Ein Prompt mit 300.000 Eingabe- und 4.000 Ausgabetokens für ein langes Dokument kostet bei Gemini 2.5 Pro zu $2.50/$15.00 ungefähr $0.81, mit der Dezember-Preisgestaltung von Gemini 3.8 Flash zu $0.75/$3.75 etwa $0.24 und ab Januar zu $1.50/$7.50 rund $0.48. Nur kurze, eingabelastige Chats landen im Januar ungefähr wieder auf dem alten Kostenniveau.
Bei der Flash-Umstellung ist die Rechnung überschaubarer:
| Modell | Text-/Bild-/Videoeingabe | Audioeingabe | Ausgabe |
|---|---|---|---|
gemini-2.5-flash bis 30. Nov. | $0.30 | $1.00 | $2.50 |
gemini-3.5-flash-lite ab 1. Dez. | $0.30 | $0.30 | $2.50 |
Für Context Caching, Batch und Prioritätsverarbeitung gilt dasselbe Muster: Die Textpreise bleiben bestehen, die Audiopreise sinken. Für die Budgetplanung ist jedoch ein Detail wichtig: Thinking-Tokens werden als Ausgabe abgerechnet. Außerdem können die Ersatzmodelle bei langen Aufgaben eine andere Anzahl an Thinking-Tokens erzeugen. Gleiche Ausgabemengen dürfen daher nicht vorausgesetzt werden. Wer belastbar planen will, sollte usage_metadata aus dem echten Traffic vergleichen.
Warum derselbe Modell-String funktionierenden Code ausbremst
Die automatische Umleitung hält zwar den HTTP-Status 200 aufrecht, verändert aber das Modell unter der Haube. Gemini 3.x setzt Anfrageregeln durch, die Gemini 2.5 noch akzeptiert hat. Selbst Code, der den Modellnamen nicht anfasst, kann ab dem 1. Dezember fehlschlagen oder unbemerkt ein anderes Verhalten zeigen.
Gemini 3.x ersetzt thinking_budget durch thinking_level. Gemini 3.8 Flash akzeptiert low, medium und high, weist minimal jedoch zurück. Bei Gemini 3.5 Flash-Lite ist minimal der Standard. Werden beide Felder gesendet, antwortet die API mit HTTP 400. Eine gemeinsame minimal-Konfiguration für beide Ersatzmodelle legt daher den Pfad zu 3.8 Flash lahm. Google empfiehlt minimal für Extraktion, Routing und Klassifizierung sowie medium oder high für Subagenten, Tool-Aufrufe, Codeausführung und mehrstufiges Schlussfolgern, damit Tools nicht vorzeitig beendet werden.
Auch Sampling- und Verlaufseinstellungen ändern sich laut dem Gemini-3-Migrationsleitfaden. temperature, top_p und top_k werden bei Gemini 3.x derzeit ignoriert und sollen bei künftigen Generationen mit HTTP 400 zurückgewiesen werden. candidate_count wird nicht unterstützt. Enthält der letzte nicht leere Turn die Rolle model – etwa durch den klassischen Prefill-Trick mit einem Abschluss wie Translation: –, liefert die API HTTP 400. Google verweist stattdessen auf system_instruction und strukturierte Ausgaben.
Auch Function Calling wird strenger geprüft. Gemini 3.x validiert thought_signature und verlangt, dass jede FunctionResponse die passende Call-ID und den passenden Namen enthält. Wird die Signatur entfernt oder der Model-Turn ohne sie neu aufgebaut, entstehen leere STOP-Antworten oder Abschlüsse mit MISSING_THOUGHT_SIGNATURE statt eines sauberen Fehlers. Regressionstests sollten daher den Antworttext prüfen und sich nicht nur darauf verlassen, dass keine Exception auftritt.
Nutzer haben genau dieses Fehlerszenario bereits wenige Stunden nach der Ankündigung beschrieben:
Google hat gerade ein Datum für das Ende von Gemini 2.5 genannt. Das entscheidende Detail ist aber nicht die Abkündigung, sondern die automatische Umleitung. ... Dein Code wird also keinen 404-Fehler auslösen. Stattdessen antwortet plötzlich unbemerkt ein anderes Modell. — @VarunChopr17597
Wenn dein Agent weiterhin gemini-2.5-flash aufruft, läuft er ab dem 1. Dezember mit Gemini 3.5 Flash-Lite, dessen Standard beim Thinking auf minimal steht. — @MarMarLabs
Im November migrieren: die Checkliste in 7 Schritten
Am sichersten ist ein expliziter Wechsel der Modell-ID samt Anpassung der Parameter im November. Danach sollte ein direkter Vergleich mit dem Ersatzmodell folgen. Die automatische Umleitung ist keine Migrationsstrategie.
- Alle Verweise und Preview-Aliase finden. Durchsuche Code, Konfigurationen, Evaluierungs-Harnesses und Dokumentation nach den beiden betroffenen IDs – das unveränderte Lite-Modell wird dabei ausgeschlossen:
grep -rnE 'gemini-2\.5-(pro|flash)([^-]|$)' .
- IDs explizit austauschen. Ändere in einem Branch
gemini-2.5-prozugemini-3.8-flashundgemini-2.5-flashzugemini-3.5-flash-lite– nicht erst am Morgen des 1. Dezember. - Thinking-Konfiguration korrigieren. Ersetze
thinking_budgetdurchthinking_level, setze den Wert je nach Modell (mediumoderhighfür Agenten mit 3.8 Flash; bei Flash-Lite explizitminimalodermedium/high) und verwendeminimalnicht gemeinsam mit 3.8 Flash. - Alte Parameter entfernen. Lösche
temperature,top_p,top_k,candidate_countsowie vorbefüllte abschließende Model-Turns, bevor du testest. - SDK und Tool-Anbindung aktualisieren. Aktualisiere auf ein aktuelles SDK, bewahre vollständige Model-Turns einschließlich
thoughtSignature, erzeugeFunctionResponsemit Call-ID und Namen und teste mehrstufige Tool-Aufrufe von Anfang bis Ende erneut. - Baselines mit dem Ersatzmodell erneut ausführen. Vergleiche Qualität, Latenz, Ausgabelänge und die Token-Zähler aus
usage_metadataanhand von Produktionsprompts. Ein Flash-Modell wird sich bei jeder Aufgabe anders verhalten als ein Pro-Modell. - Kosten zweimal neu berechnen. Plane den Pro-Pfad im Dezember mit $0.75/$3.75 und ab Januar mit $1.50/$7.50 und prüfe für den Flash-Pfad die Audio- und Cache-Positionen erneut.
Teams, die bereits Gemini 3.x oder gemini-2.5-flash-lite einsetzen, können diese Migration überspringen. Alle anderen sollten Schritt 6 vor dem 30. November abschließen. Eine grüne Testsuite am 1. Dezember kann sonst lediglich bedeuten, dass der Router antwortet – nicht, dass das Verhalten unverändert geblieben ist.
Wer Agenten baut, sollte vor der Festlegung der Thinking-Level für tool-lastige Workloads außerdem die Kostenanalyse von Gemini 3.8 Flash für Agentenaufgaben lesen.
FAQ
Wird Gemini 2.5 Pro am 1. Dezember 2026 abgeschaltet?
Nein. Google nennt den 1. Dezember 2026 für die Gemini Developer API als Umleitungstermin: Anfragen an gemini-2.5-pro werden an gemini-3.8-flash weitergeleitet, statt einen Fehler zurückzugeben.
Werden umgeleitete Anfragen zum alten oder zum neuen Preis abgerechnet?
Zum neuen Preis. Eine nach dem 1. Dezember als gemini-2.5-pro gesendete Anfrage wird zu den Preisen von Gemini 3.8 Flash abgerechnet. Eine Anfrage an gemini-2.5-flash läuft zu den Preisen von Gemini 3.5 Flash-Lite.
Muss ich den Code ändern, obwohl die Umleitung automatisch erfolgt?
Ja. Thinking-Konfiguration, Sampling-Parameter, vorbefüllte Turns und Function-Calling-Anbindung unterscheiden sich bei Gemini 3.x. Unveränderter Code kann ignorierte Parameter, HTTP-400-Fehler oder unbemerkt ein anderes Reasoning-Verhalten erzeugen.
Gilt der 1. Dezember auch für Vertex AI?
Nein. Der 1. Dezember ist der Termin für die Gemini Developer API. Google Cloud nennt für Gemini 2.5 auf Vertex AI und der Enterprise Agent Platform separate Einstellungstermine im Oktober 2026.
Ist Gemini 2.5 Flash-Lite betroffen?
Nein. Laut Google ist gemini-2.5-flash-lite nicht eingestellt und bleibt bis auf Weiteres verfügbar.
Welches Ersatzmodell eignet sich für welchen Workload?
Die Auswahl sollte sich an der Aufgabe orientieren und anschließend evaluiert werden. Ein Flash-Modell ist nicht automatisch gleichwertig mit dem bisherigen Pro-Modell.
| Aktueller Workload | Explizites Ziel | Darauf achten |
|---|---|---|
| Allgemeine Pro-Prompts, Coding, lange Dokumente | gemini-3.8-flash mit medium+ | Wechsel von Pro zu Flash; Qualität, Ausgabelänge und Januar-Preis für Eingaben neu bewerten |
| Agenten mit Tools | gemini-3.8-flash mit medium oder high | thought_signature, Response-IDs und vorzeitiges STOP bei minimal |
| Klassifizierung, Extraktion, Routing | gemini-3.5-flash-lite mit minimal | Günstigste passende Option; bei zusätzlichen Tools auf medium erhöhen |
| Audio-Transkriptionspipelines | gemini-3.5-flash-lite | Audioeingabe sinkt von $1.00 auf $0.30; Cache-Positionen erneut prüfen |
Was bis zum 30. November zu tun ist
Ändere die beiden Modell-Strings noch diese Woche, passe Thinking und Tool-Anbindung an und erstelle eine neue Baseline mit den Ersatzmodellen, solange Gemini 2.5 noch antwortet. Die Umleitung im Dezember hält den Betrieb am Laufen. Nur eine Migration im November hält jedoch Verhalten und Kosten unter deiner Kontrolle.