 AIREITER
Für alltägliche Aufgaben in Devin wirkt SWE-2 Flash wie die naheliegende Standardwahl: 200 Token pro Sekunde zum Fünftel der Kosten von SWE-2. Sobald ein Job allerdings eher Terminal-Bench 4.0 ähnelt, sieht die Rechnung anders aus: Dort erreicht SWE-2 Flash 20,0 % gegenüber 27,3 % für SWE-2 und mehr als 40 % bei den Spitzenreitern.
Fazit: Flash für die Masse, SWE-2 für die schwierigen 10 %
Bei umfangreichen, klar umrissenen Entwicklungsaufgaben innerhalb von Devin verdient sich SWE-2 Flash den Standardplatz. Das Modell nimmt gewisse Benchmark-Nachteile in Kauf, liefert dafür aber die dreifache Generierungsgeschwindigkeit und deutlich geringere Kosten pro Aufgabe.
| Aufgabentyp | Weiterleiten an | Warum |
|---|---|---|
| Automatisierungen, Code-Reviews, kleine Features, Dokumentationsänderungen | SWE-2 Flash | Cognition sieht SWE-2 Flash für alltägliche Aufgaben vor; Geschwindigkeit ist wichtiger als tiefgreifende Planung |
| Große Refactorings, unbekannte Repositories, terminalbasierte Aufgaben wie bei Terminal-Bench 4.0 | SWE-2 | SWE-2 liegt bei Terminal-Bench 4.0 mit 27,3 % zu 20,0 % und bei DeepSWE 1.1 mit 73,0 % zu 60,1 % vor SWE-2 Flash |
| Sicherheitskritische oder lokale On-Premises-Aufgaben | Abwarten | Die Gewichte von SWE-2 Flash sind nicht öffentlich; Cognition hat lediglich ein künftiges Programm zur sicheren Weitergabe angekündigt |
Der kostenlose Zugang in Devin Desktop und CLI bis zum 30. November 2026 macht eigene Tests günstig. Neue Standardaufgaben sollten zunächst mit SWE-2 Flash laufen; bevor du dich festlegst, misst du den Nacharbeitsaufwand.
Was SWE-2 Flash tatsächlich ist: Inkling-Small mit zusätzlichem Mid-Training
SWE-2 Flash ist Cognitions schnelles Coding-Modell und basiert auf Inkling-Small von Thinking Machines. Als Grundlage dient ein Mixture-of-Experts-Modell mit insgesamt 276B und 12B aktiven Parametern. Vor dem Reinforcement Learning durchläuft es eine neue Mid-Training-Phase von Cognition.
Für diese Phase wählte Cognition Datenmischungen anhand von Token-Effizienz-Diagrammen aus und trainierte das Modell in drei Abschnitten über einige Billionen Token – die knappsten Daten kamen zuletzt. Der Loss auf zurückgehaltenen Daten sank stabil logarithmisch. Anschließendes Reinforcement Learning mit geprüften Aufgaben hob Terminal-Bench 4.0 laut Cognitions Beitrag vom 4. November 2026 von 0,9 % auf 20,0 % und FrontierCode 2.0 von 3,2 % auf 24,0 %. Außerdem gibt Cognition für SWE-2 Flash 200 Token pro Sekunde an, gegenüber 60 Token pro Sekunde bei SWE-2.
„Cognitions neuestes Modell ist da: SWE-2 Flash! Ein Flash-Modell mit insgesamt 276B und 12B aktiven Parametern. Ich hätte nicht gedacht, dass wir ein Flash-Modell für SWE-2 sehen würden – ich bin überrascht, aber erfreut. Die Benchmark-Werte sehen gut aus, das Modell ist nicht allzu weit vom 2,8T-SWE-2-Modell entfernt.“ — @ItsmeAjayKV, erste Reaktion eines echten Nutzers
Benchmarks erzählen unterschiedliche Geschichten – entscheidend ist die Testsuite
Die Benchmark-Ergebnisse von SWE-2 Flash fallen je nach Suite deutlich unterschiedlich aus. Bei strukturierten Softwareaufgaben sieht das Modell stark aus, bei offenen Terminal-Szenarien deutlich schwächer. Ein einzelner Durchschnittswert würde diese Unterschiede verschleiern.
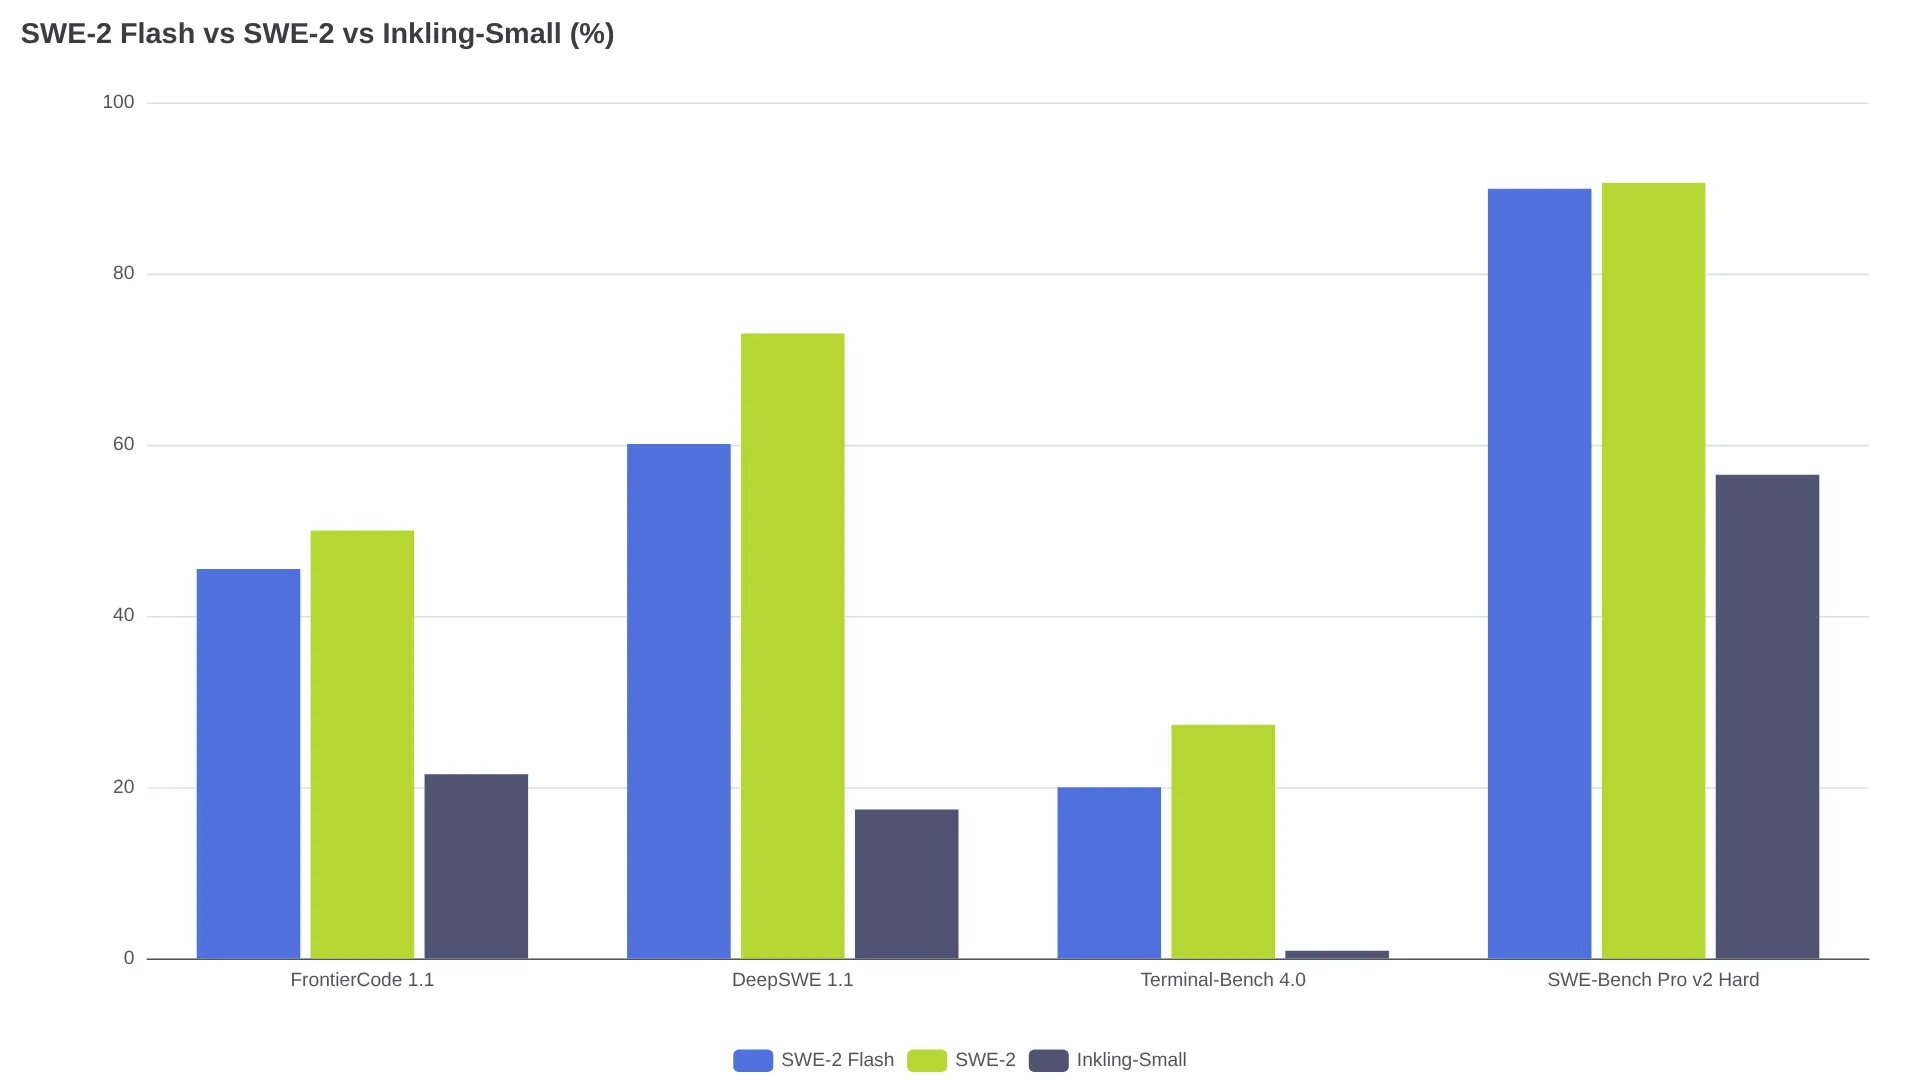
| Benchmark | SWE-2 Flash | SWE-2 (2.8T-A104B) | Inkling-Small | Bestes Ergebnis in Cognitions Tabelle |
|---|---|---|---|---|
| FrontierCode 1.1 Main | 45,5 % | 50,0 % | 21,5 % | 50,0 % SWE-2 |
| FrontierCode 2.0 | 24,0 % | 23,8 % | 3,2 % | 27,7 % Claude Haiku 5.5 |
| DeepSWE 1.1 | 60,1 % | 73,0 % | 17,4 % | 77,0 % DeepSeek V4.1 Flash |
| Terminal-Bench 2.1 | 89,2 % | 92,8 % | 64,7 % | 94,4 % Claude Haiku 5.5 |
| Terminal-Bench 4.0 | 20,0 % | 27,3 % | 0,9 % | 42,3 % DeepSeek V4.1 Flash |
| SWE-Bench Pro v2 Hard | 89,9 % | 90,6 % | 56,5 % | 90,6 % SWE-2 |
| SWE-Atlas QA | 50,0 % | 56,3 % | 27,4 % | 71,0 % DeepSeek V4.1 Flash |
| ExploitBench | 34,8 % | 36,1 % | 11,3 % | 44,7 % GPT-6 Luna |
Der Fortschritt hat klare Grenzen. Bei FrontierCode 1.1 Main kommt SWE-2 Flash auf mehr als das Doppelte von Inkling-Small (45,5 % gegenüber 21,5 %). Bei SWE-Bench Pro v2 Hard steigt der Wert von 56,5 % auf 89,9 % und liegt damit praktisch auf dem Niveau von SWE-2 mit 90,6 %.
Die Schwachstellen von SWE-2 verschwinden nicht. Gute Ergebnisse bei SWE-Bench Pro lassen sich nicht einfach auf lange Terminal-Sitzungen übertragen. In derselben Tabelle erreicht GLM 5.3 Flash bei Terminal-Bench 4.0 beispielsweise 41,8 %.
Die Aussage zum Open-Weight-Modell braucht Kontext. SWE-2 Flash schlägt Muse Spark Open in den meisten Zeilen – etwa mit 60,1 % gegenüber 60,0 % bei DeepSWE 1.1 und 24,0 % gegenüber 6,2 % bei FrontierCode 2.0. Bei Terminal-Bench 4.0, SWE-Atlas QA und DeepSWE 1.1 liegen jedoch DeepSeek V4.1 Flash und GLM 5.3 Flash vor SWE-2 Flash. Alle Werte stammen von den jeweiligen Anbietern, jedes Modell lief mit seiner besten Konfiguration, und die Test-Harnesses unterscheiden sich zwischen den Anbietern.
Was der fünfte Preis bedeutet, wenn es keine Preisliste gibt
Ein Preis pro Token existiert nicht, weil es keinen eigenständigen Endpunkt gibt. Das einzige Preissignal ist Cognitions Verhältnis bei den Aufgabenkosten: Ein Rollout mit SWE-2 Flash soll ein Fünftel der Kosten von SWE-2 verursachen – inklusive Modell, Harness und Serving-Stack.
Diese Relation ist hilfreich, aber unvollständig. Auch die Kosten pro SWE-2-Aufgabe hat Cognition nie veröffentlicht. OrcaRouters Aufschlüsselung zu SWE-2 konnte deshalb lediglich Fable 5.1 als Referenz nennen: 3,28 $ pro FrontierCode-Aufgabe bei mittlerem Aufwand und 12,83 $ bei maximalem Aufwand. Die dort aufgeführten Devin-Tarife waren Free für 0 $, Pro für 20 $ pro Monat, Max für 200 $ pro Monat sowie Teams für 80 $ plus 40 $ pro Sitzplatz – Abonnementpreise, keine Token-Abrechnung. Ein Fünftel der Aufgabenkosten taucht daher nicht automatisch als niedrigere Devin-Rechnung auf.
Praktisch bedeutet das: Das kostenlose Zeitfenster bis zum 30. November 2026 in Devin Desktop und CLI für Nutzer von Pro, Max und Teams ist die günstigste Möglichkeit, den tatsächlichen Verbrauch zu messen. Entscheidend sind erledigte Aufgaben pro Woche und die Nacharbeitsquote, nicht die Tokenzahl. Erledigt SWE-2 Flash Standard-Tickets mit 200 Tok/s im ersten Anlauf, fällt die tatsächliche Ersparnis höher aus als das 1/5-Versprechen vermuten lässt. Muss dagegen regelmäßig zu SWE-2 eskaliert werden, verschwindet der Kostenvorteil.
Wer Zugang bekommt: Devin-exklusiv und ein Gewichte-Programm, das keine Open Weights verspricht
Der Zugang zu SWE-2 Flash ist derzeit stark eingeschränkt. Cognition nennt Devin Desktop und Devin CLI als aktuelle Plattformen.
Es gibt weder eine öffentliche API-Kennung noch Gewichte auf Hugging Face oder eine Möglichkeit zum Self-Hosting. Cognition begründet die Einschränkung mit dem Cyber-Risiko: Das Training von SWE-2 Flash zielte ausdrücklich auf Aufgaben aus der Cybersicherheit und steigerte ExploitBench von 11,3 % auf 34,8 %. Dieselben Fähigkeiten könnten jedoch auch Angreifern helfen. Als Lösung ist ein Programm geplant, über das Gewichte sicher mit vertrauenswürdigen Industriepartnern und Forschungslaboren geteilt werden. Details sollen in einigen Wochen folgen. Das ist als kontrollierter Zugang zu verstehen, nicht als Zusage für Open Weights.
Außerhalb von Devin lässt sich SWE-2 Flash heute nicht direkt testen: Es gibt weder einen öffentlichen Endpunkt noch eine Möglichkeit zum Self-Hosting.
Flash oder SWE-2? Eine Routing-Regel auf Aufgabenebene
Für viele Aufgaben ist SWE-2 Flash zuständig, für unklare Aufgaben SWE-2.
SWE-2 Flash eignet sich zunächst für Automatisierungen, Dependency-Updates, zusätzliche Tests, Antworten auf Review-Kommentare, kleine Features mit klaren Abnahmekriterien und Dokumentationsänderungen. Das passt zu den Suites, in denen SWE-2 Flash nur wenige Punkte hinter SWE-2 liegt: bei FrontierCode 2.0 mit 24,0 % gegenüber 23,8 % und bei SWE-Bench Pro v2 Hard mit 89,9 % gegenüber 90,6 %.
Zu SWE-2 solltest du wechseln, wenn eine Aufgabe Planung über mehrere Dateien, lange Terminal-Sequenzen oder sicherheitsnahe Analyse erfordert. Die Abstände sind dort relevant: Bei DeepSWE 1.1 fehlen 12,9 Punkte, bei SWE-Atlas QA 6,3 Punkte und bei Terminal-Bench 4.0 7,3 Punkte. HamiRevs SWE-2-Test beschreibt SWE-2 als Modell, das im Vergleich zu SWE-1.7 auf weniger Schritte und frühere Änderungen optimiert ist – eine Ausrichtung auf kurze Aufgaben, die SWE-2 Flash noch weiterführt.
Starte jedes Ticket mit SWE-2 Flash und begrenze den ersten Versuch auf zwei Schleifen. Wenn die Arbeit feststeckt, eskalierst du zu SWE-2. Nach dem kostenlosen Zeitraum im November solltest du die Entscheidung anhand der tatsächlichen Devin-Kosten neu bewerten, statt nur mit dem Verhältnis von 1/5 zu rechnen. Offen bleibt die Transparenz: Das Programm für die sichere Weitergabe der Gewichte könnte private Deployments ermöglichen. Solange die Bedingungen nicht bekannt sind, können regulierte Teams ihre Planung jedoch nicht auf SWE-2 Flash stützen.
SWE-2 Flash: Häufige Fragen
Ist SWE-2 Flash per API verfügbar?
Eine eigenständige SWE-2-Flash-API gibt es nicht. Der Zugang erfolgt über Devin Desktop und Devin CLI und ist für Pro, Max und Teams bis zum 30. November 2026 kostenlos.
Verfügt SWE-2 Flash über Open Weights?
Nein. Cognition verweist auf das Cyber-Risiko und verspricht lediglich ein künftiges Programm zur sicheren Weitergabe an ausgewählte Partner und Forschungslabore.
Wie schneidet SWE-2 Flash im Vergleich zu SWE-2 ab?
SWE-2 Flash erreicht 200 Tok/s gegenüber 60 Tok/s und kostet laut Cognitions Aufgabenkostenrechnung ein Fünftel. Bei DeepSWE 1.1 liegt SWE-2 mit 73,0 % gegenüber 60,1 % weiterhin vorne, bei Terminal-Bench 4.0 mit 27,3 % gegenüber 20,0 %.
Wie groß ist das Kontextfenster von SWE-2 Flash?
Cognition hat für SWE-2 Flash keine Angaben zu Kontextfenster, maximaler Ausgabe oder Modalitäten veröffentlicht. Es sollte daher nicht angenommen werden, dass die Limits von Inkling-Small übernommen werden.
Was passiert nach dem kostenlosen Zeitraum am 30. November?
Cognition hat die Abrechnung von SWE-2 Flash nach dem Aktionszeitraum nicht erklärt. Wahrscheinlich wird die Nutzung über das Devin-Abonnement laufen und nicht über einen separaten Tokenpreis.