 AIREITER
Statt Forschungsergebnisse nach einer einzelnen Aufgabe wieder zu verwerfen, soll Tencent Hyra 2.0 daraus wiederverwendbare Modelle und wissenschaftliche Werkzeuge machen. Der entscheidende Vorbehalt: Der Agent selbst bleibt intern bei Tencent, öffentlich verfügbar sind nur ausgewählte Ergebnisse.
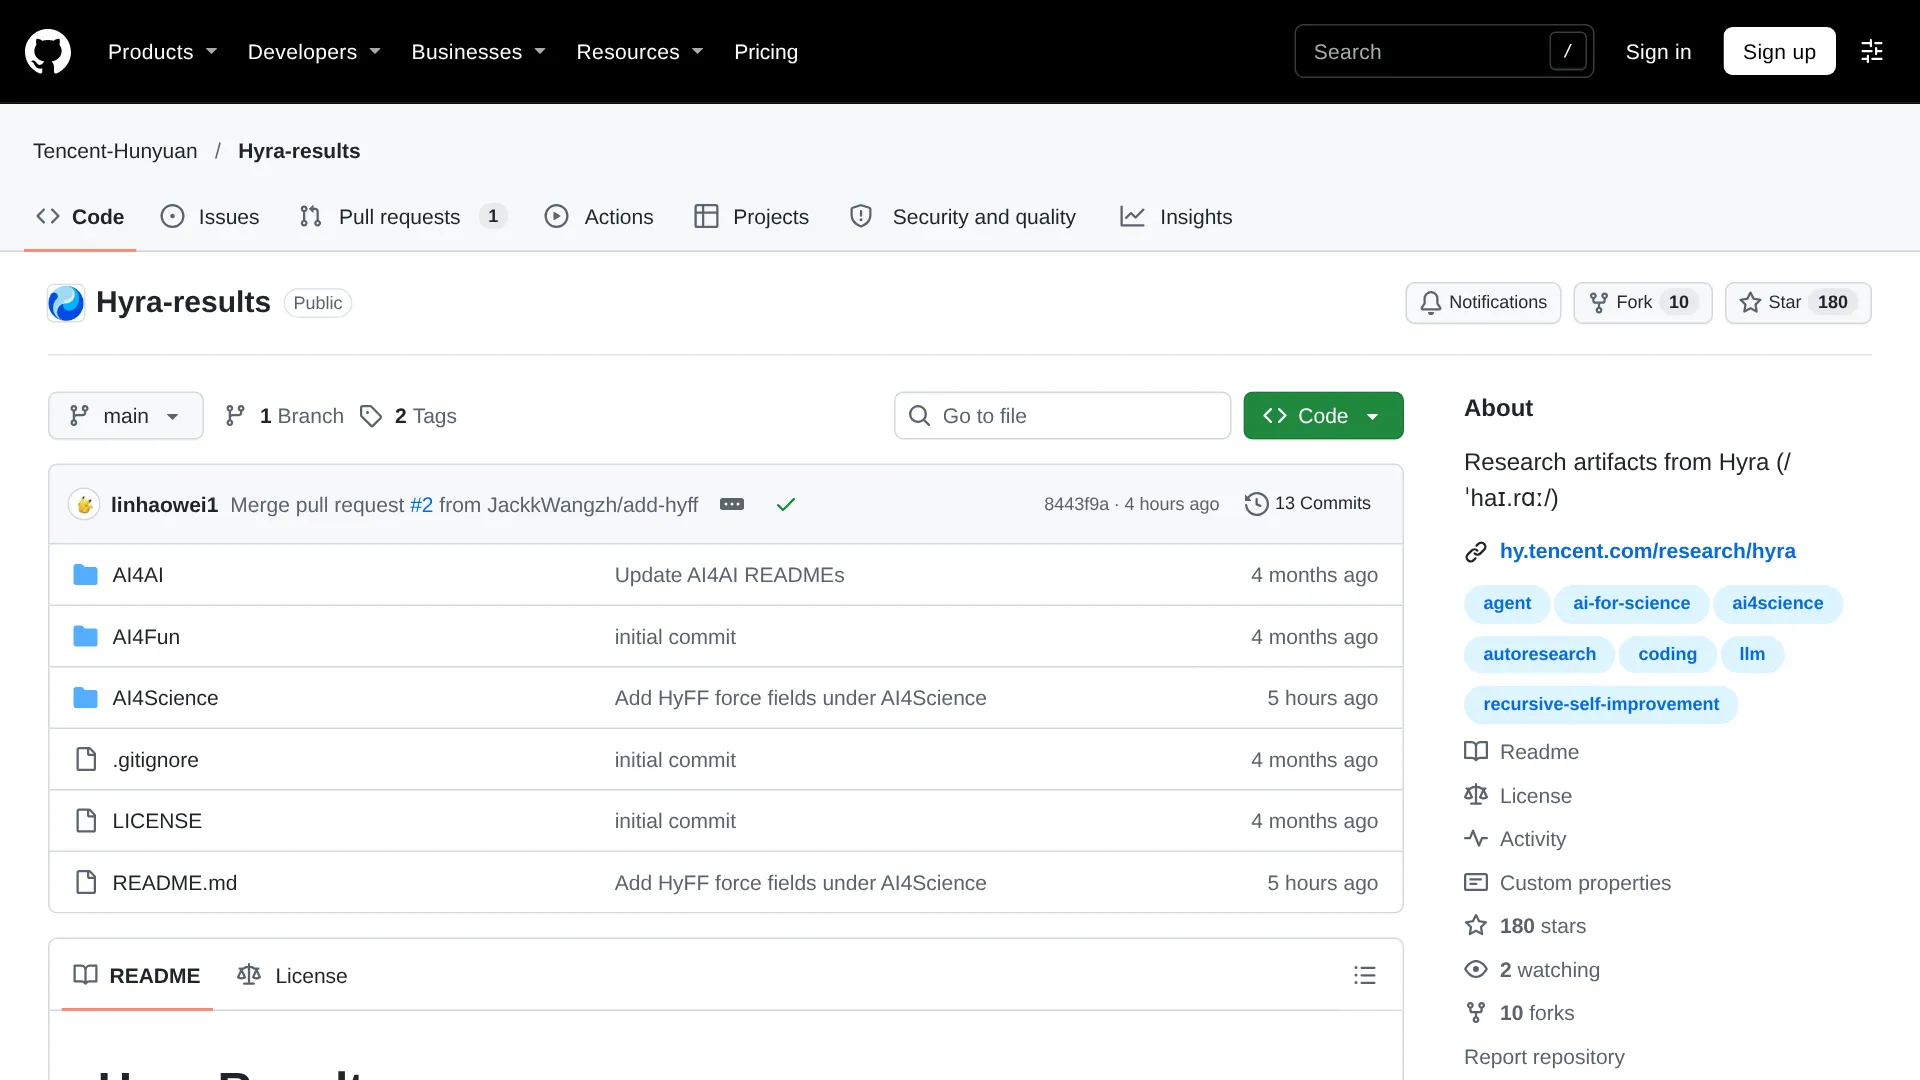
Das Repository Hyra-results trennt herunterladbare Artefakte klar von bloß angekündigten Resultaten. Diese Unterscheidung zieht sich durch den gesamten Überblick.
Hyra 2.0: Forschungsinfrastruktur statt Chatmodell
Hyra 2.0, ausgeschrieben Hunyuan Research Agent 2.0, ist Tencents hierarchisches System zur Automatisierung wissenschaftlicher Forschung und technischer Entwicklung. Tencent Hunyuan positioniert es nicht als weiteres universelles Chatmodell, sondern als Infrastruktur für wiederverwendbare wissenschaftliche Modelle, Validierungspipelines und mehrstufige Workflows.
In der offiziellen Ankündigung auf X vom 2. November 2026 beschreibt Tencent Hyra 2.0 als „die nächste Entwicklungsstufe des Hunyuan Research Agent“, die sich „von der Lösung von Problemen hin zum Aufbau wiederverwendbarer Werkzeuge, Modelle und Workflows“ bewegt. Im öffentlichen Repository Hyra-results liegen Resultate und ausgewählte trainierte Modelle, nicht jedoch das vollständige Orchestrierungssystem. Weder Ankündigung noch Repository nennen eine öffentliche Demo, ein Installationspaket, eine API, Preise oder Kontingente. Man kann Hyra 2.0 eher als Labor verstehen; die veröffentlichten Proteinmodelle HyInv und HyPLM-Flash sind Proben, die daraus hervorgegangen sind.
So hält Hyra 2.0 Forschungsprojekte über Wochen am Laufen
Für langlaufende Forschungsarbeit setzt Hyra 2.0 auf drei Agentenebenen, persistenten Speicher und eine unabhängige Prüfung. Der Startbericht von IT之家, der sich auf Tencents offiziellen Hunyuan-WeChat-Account bezieht, beschreibt die Aufteilung in Overall, Mission und Worker. Dadurch sollen Experimente über Tage oder Wochen weiterlaufen, ohne ihren Kontext zu verlieren.
Overall-Agenten stimmen sich mit menschlichen Forschenden ab, klären Ziele und verteilen Rechenbudgets. Mission-Agenten verantworten jeweils eine Forschungsrichtung, wählen experimentelle Wege und stehen für die Schlussfolgerungen ein. Worker-Agenten lesen Code, führen reale Experimente aus, analysieren Fehlschläge und können die Einschätzung eines Mission-Agenten hinterfragen. Mehrere Worker dürfen dabei parallel auf unterschiedlichen Basismodellen arbeiten.
Darunter liegen drei Mechanismen für dauerhaftes Wissen:
- Projektstatus hält fest, wo ein Forschungsprogramm gerade steht, sodass Aufgaben in persistenten Warteschlangen Unterbrechungen überstehen.
- Geschichteter Agentenspeicher trennt kurzfristige Beobachtungen von Erkenntnissen mit längerem Horizont, statt alles in ein einziges Kontextfenster zu kippen.
- Gemeinsame Books speichern Wissen nach Evidenzgrad: Beobachtungen aus einzelnen Durchläufen, reproduzierte Befunde und von Menschen bestätigte Konventionen. Methoden mit nachweislicher Übertragbarkeit werden als kleine wiederverwendbare Skills für spätere Durchläufe extrahiert.
Zwei Schutzmechanismen ergänzen das Konzept. Jede Schlussfolgerung wird mit konkreten Logs und Code-Versionen ausgeliefert; ein separater Review-Worker prüft die Behauptung aus einem neuen Ausgangspunkt, bevor sie Menschen erreicht. Große Rechenjobs benötigen weiterhin menschliche Freigabe. Zudem bindet das System laut technischer Analyse von Eyerys übliche Laborinfrastruktur ein, darunter Unternehmens-Messaging, Plattformen zur Job-Einreichung und Code-Repositories.
Diese Absicherung kostet Ressourcen. Ein Praktiker schätzte, dass Worker, die gegenseitig ihre Sitzungen prüfen, die Token-Kosten deutlich erhöhen könnten (@d6355v). Tencent hat weder Token-Budgets und Rechenkosten noch Fehlerraten oder die Trefferquote der unabhängigen Prüfung veröffentlicht. Die Architektur ist daher als Ansatz für verlässliche Langzeitforschung zu verstehen, dessen Betriebskosten offenbleiben.
Diese Ergebnisse von Hyra 2.0 sind bislang öffentlich
Die öffentlich sichtbaren Belege für Hyra 2.0 lassen sich in zwei Gruppen einteilen: herunterladbare Artefakte mit Gewichten und Code sowie von Tencent gemeldete Ergebnisse, die noch auf externe Reproduktion warten. Die Tabelle verlinkt jede Zeile mit der überprüfbaren Quelle.
| Artefakt | Was es ist | Kennzahl | Stand der Evidenz |
|---|---|---|---|
| HyInv | Protein-Inverse-Folding-Modell mit 1,96 Mio. Parametern, 7,8 MB Gewichte, CLI + Python-API | Etwa 57-mal schnellere Generierung als ProteinMPNN; 25 ms statt etwa 1 s bei Proteinen mit 148 Resten (1x H20-GPU), laut TSNs Analyse | Artefakt einsehbar (MIT); Benchmark ausführbar; Kernergebnis noch nicht unabhängig reproduziert |
| HyPLM-Flash | Maskiertes Protein-Sprachmodell mit 650 Mio. Parametern, 2,6 GB Gewichte, INT8-Engine | Etwa 130.000 Reste/s auf 1x H20; schnellste Inferenz in Tencents Test mit 12 Modellen und 35 Aufgaben, durchschnittlicher Rang 3; ProteinGym-Spearman 0,409, gleichauf mit der ESM-2-650M-Klasse, laut TSNs Analyse | Artefakt einsehbar (MIT); benötigt CUDA-GPU; die zwei Auswertungen umfassen unterschiedliche Modell- und Aufgabenzahlen |
| HyFF | 5 ML-Kraftfelder (Presto, Vivace, Moderato, Andante, Largo), 2,3 Mio.–1,2 Mrd. Parameter, 83 Elemente | Largo-Energiefehler 0,364 meV/Atom gegenüber 0,380 bei DPA4-Pro bei 9,7-facher Geschwindigkeit; Andante 29-mal so schnell wie UMA-S-1.2 bei MD mit 2.586 Atomen, 1x H20 | Artefakt einsehbar (Apache-2.0) mit Paket hyff; Geschwindigkeiten beziehen sich auf einen H20-Workload |
| Petty-Vermutung Dim-5 | Beweisartefakt: Jeder reelle normierte Raum der Dimension 5 enthält 6 äquidistante Punkte (bisheriger Bestwert Dimension 4, Makeev 2005), laut Repository-Index | Klärt Dimension 5 | Paper einsehbar; kein Journal-Peer-Review berichtet |
| Yau-Kreiswirkung | Behauptetes Gegenbeispiel: geschlossene 7-Mannigfaltigkeit, positive Schnittkrümmung, keine effektive Kreiswirkung, laut Repository-Index | Löst den uneingeschränkten Fall; der einfach zusammenhängende Fall bleibt offen | Paper einsehbar; kein Journal-Peer-Review berichtet |
| HyQEC | Quantenfehlerkorrekturcode aus der qLDPC-Challenge-Linie, laut Prompt Blueprints | Etwa 48 % höhere Kodierungseffizienz als der bisherige Spitzenreiter | Angekündigt; vollständiges Artefakt auf GitHub ausstehend |
| XiangShan RISC-V | Optimierung eines Open-Source-Prozessors, laut Prompt Blueprints | +5,79 % Score pro GHz bei minimaler Flächenzunahme; Multi-Core-Bugs behoben | Angekündigt; Benchmarkname und Baseline nicht offengelegt |
| Roboterhand | Hand mit fünf Fingern und abgestuften Fingerlängen, laut Eyerys | +28,6 % Geschwindigkeit bei der Objektrotation in einer Simulation mit festem Budget | Angekündigt; bislang nur Simulation |
Gegenüber Hyra 1.0 verschiebt sich der Fokus von Antworten zu verwertbaren Assets. Hyra 1.0 demonstrierte, dass die iterative Schleife funktionieren kann: Sein Eintrag sums_diffs verbesserte eine kombinatorische Konstante von 1,14489 auf 1,21079, und Tencent schreibt dem System Fortschritte bei einem 50 Jahre alten Problem der additiven Kombinatorik zu. Die Startanalyse von Prompt Blueprints hält fest, dass Hyra 2.0 diese iterative Engine beibehält, sie aber um Hierarchie, persistente Projekte und Skill-Extraktion erweitert, damit jeder Erfolg wiederverwendbar wird.
Was Sie ausführen können – und was bei Tencent bleibt
Die Produkte von Hyra 2.0 lassen sich ausführen, der Orchestrator selbst ist jedoch nicht öffentlich installierbar. Das Repository Hyra-results steht unter Apache-2.0, und jeder Ergebnisordner soll die finalen Artefakte samt Reproduktionsskripten enthalten. Der Einstieg:
git clone https://github.com/Tencent-Hunyuan/Hyra-results.git
ls AI4Science/hyinv
Danach stehen drei Wege offen:
- HyInv (am einfachsten): In
AI4Science/hyinvfinden sich Gewichte, Inferenzcode und der technische Bericht. Der Referenzpfad läuft auf CPU und GPU; der beschleunigte BF16-Pfad ist nur für GPUs der Hopper-Klasse validiert. - HyPLM-Flash (benötigt CUDA): Öffnen Sie
AI4Science/hyplm_flashund führen Sie anschließendweights/download.shaus, um die 2,6-GB-Gewichte herunterzuladen, zusammenzuführen und zu prüfen. Planen Sie eine GPU der H20/H100-Klasse ein; INT8 ist für die Repräsentationsextraktion vorgesehen, BF16 für feinauflösende Variantenregression. - HyFF (für die beworbenen Geschwindigkeiten H20 nötig): Der HyFF-Bereich bietet fünf Kraftfeldmodelle mit jeweils 9 MB–4,8 GB sowie das Paket
hyfffür Einzelstrukturen, Batches und molekulardynamische NVE/NVT/NPT-Simulationen.
Geschlossen bleiben der Overall/Mission/Worker-Orchestrator, Prompts, Scheduler, Evaluatoren und der Speicher für Books und Skills. Da große Rechenjobs menschliche Freigabe benötigen, arbeitet das System bei der Ressourcenverteilung nicht vollständig autonom. Kurz gesagt: Der Agent selbst lässt sich nicht installieren; das am leichtesten testbare Artefakt beginnt bei einem 7,8-MB-Download. Wie TSN anmerkt, ist ein direkter Vergleich von HyInv und ProteinMPNN auf identischen Backbones günstig aufzusetzen.
Wie belastbar sind die Leistungsangaben?
TSN berichtete, dass alle Leistungswerte von Tencent oder dessen Modelldokumentation stammen und bis zum 2. November 2026 keine unabhängige Reproduktion veröffentlicht wurde. Jede Zahl sollte daher nur zusammen mit ihren Bedingungen gelesen werden.
Erstens: Geschwindigkeit ist nicht Qualität. Die 57x von HyInv vergleichen den Generierungsdurchsatz auf einer Nvidia H20 – etwa 25 ms gegenüber etwa 1 s bei 148 Resten sowie 54 ms gegenüber 2,6 s bei 402 Resten – und nicht den Erfolg im Nasslabor. Die strukturelle Ähnlichkeit wird gegenüber vorhergesagten Strukturen bewertet; eine Nasslaborvalidierung wird nicht berichtet:
57x gegenüber ProteinMPNN und rund 2.500 Designs/s sind Durchsatzwerte, keine Aussage über die Designqualität. Als Nächstes würde ich Self-Consistency-RMSD und Sequence Recovery sehen wollen ... Inverse Folding ist ohnehin selten der Engpass – der Refold-Schritt danach ist es.
Zweitens brauchen Effizienzangaben Hardware- und Geltungsbereich. „Schnellstes unter 12“ bei HyPLM-Flash bezieht sich auf Tencents Blog-Auswertung mit 12 Modellen und 35 Aufgaben. Die dazu passende Auswertung im Repository umfasst 28 Checkpoints und 32 Aufgaben und weist für ProteinGym Zero-Shot einen Spearman-Wert von 0,409 aus, statistisch gleichauf mit ESM-2 650M, ESM C 600M und E1-600M. Die 29x- und 9,7x-Werte von HyFF gelten für ein System mit 2.586 Atomen auf einer H20. Zudem ist Andantes Kraftfehler mit 7,65 meV/Å leicht schlechter als der von UMA-S-1.2 mit 7,55 meV/Å: hohe Geschwindigkeit bei annähernd gleicher Genauigkeit, kein klarer Durchmarsch.
Drittens ist die Wiederverwendung – die zentrale These von 2.0 – noch nicht belegt. Die Startmaterialien erklären nicht, wie ein erzeugter Skill vor der Wiederverwendung validiert wird, wer ihn freigibt oder ob die Wiederverwendung projektübergreifend gemessen wurde:
Wiederverwendbare Werkzeuge statt einmaliger Antworten zu bauen, ist die richtige Richtung. Die meisten Agentenläufe verwerfen alles, was sie gelernt haben, sobald die Aufgabe endet. Spannend wäre, wie Hyra entscheidet, dass ein Werkzeug gut genug ist, um es zu behalten und erneut einzusetzen.
Ein weiterer Praktiker stellte dieselbe Validierungsfrage aus der Perspektive des Human-in-the-Loop (@ModelPlaneHQ). Tencents Startmaterialien und die oben verlinkten Drittanalysen veröffentlichen keinen direkten Vergleich mit Konkurrenten wie Googles AI Co-Scientist oder dem Sakana AI Scientist. Jede Rangfolge würde heute also allein auf Tencents eigenen Zahlen beruhen. Für jedes agentenerstellte Modell sind stattdessen vier Fragen sinnvoll: auf welcher Hardware, bei welcher Qualitätseinstellung, von wem reproduziert und wo wiederverwendet?
FAQ
Ist Hyra 2.0 Open Source und kann ich es ausprobieren?
Das Framework ist geschlossen, die Artefakte sind offen. Für den Agenten gibt es keine öffentliche Demo, API oder Installation. HyInv und HyPLM-Flash verwenden MIT-lizenzierte Modellpakete, während HyFF unter den Apache-2.0-Bedingungen des Repositorys steht; prüfen Sie jeweils README und Lizenz im entsprechenden Ordner.
Worin unterscheidet sich Hyra 2.0 von Hyra 1.0?
Hyra 1.0 konzentrierte sich auf iterative Problemlösung, darunter ein lange offenes Ergebnis der Kombinatorik. Hyra 2.0 ergänzt die Overall/Mission/Worker-Hierarchie, persistenten Projektstatus, Books-Wissen, Skill-Extraktion und das ausdrückliche Ziel, wiederverwendbare Modelle und Workflows zu erzeugen.
Sind die mathematischen Ergebnisse peer-reviewed?
Nicht als Journalpublikationen. Die Papers zur Petty-Dimension-5 und zum Yau-Gegenbeispiel sind öffentlich und einsehbar. Der Repository-Index dokumentiert außerdem Lean-4-Formalisierungen für drei frühere Ergebnisse mit endlichem Kern (Beurling-Ahlfors, partielles Hadamard, Kommutator). Sie alle sollten als Behauptungen behandelt werden, die noch auf fachliche Prüfung warten.
Welche Hardware brauche ich, um die Proteinmodelle zu reproduzieren?
Der Referenzpfad von HyInv läuft auf CPU und GPU und benötigt einen Download von 7,8 MB. HyPLM-Flash braucht für seine 2,6-GB-INT8-Engine eine CUDA-GPU, empfohlen wird die H20/H100-Klasse; die Geschwindigkeitswerte von HyFF setzen eine H20 voraus.
Hyra 2.0 nüchtern einordnen
Hyra 2.0 setzt darauf, dass wissenschaftlicher Fortschritt nicht in erster Linie aus einer Antwort, sondern aus dem Werkzeug bestehen sollte. Wiederverwendbare Skills sollen sich dabei zu dem summieren, was Tencent als sich aufbauende Intelligenzrendite bezeichnet (智能复利). Der Start zeigt veröffentlichte Modelle und Werkzeuge, die dem System zugeschrieben werden. Ob sie spätere Forschung wiederholt beschleunigen, bleibt jedoch ungemessen, bis Wiederverwendungsrate, Validierungskosten und unabhängige Reproduktionen neben den Geschwindigkeitsrekorden stehen.