 AIREITER
Welche Wahl sinnvoll ist, entscheidet vor allem der Workload. Claude Opus 5 ist für die meisten klar abgegrenzten und ausgabelastigen Aufgaben der sicherere Einstieg. Claude Fable 5.1 ist dagegen ein Spezialist, den es bei lang laufenden Agents und ungewöhnlich großen, wiederverwendbaren Kontexten zu testen gilt. Die beworbenen Einsparungen von Fable 5.1 entstehen primär durch Cache-Lesevorgänge – nicht durch günstigere Ein- oder Ausgabetokens.
Die Workload-Struktur entscheidet zwischen Fable 5.1 und Opus 5
Für die meisten Teams bietet sich Opus 5 als Startpunkt an: Bei anspruchsvolleren Aufgaben lässt sich der Aufwand erhöhen, während nur nachweislich schwierige Fälle an Fable 5.1 geroutet werden. Auch die Dokumentation von Anthropic zu Fable 5.1 empfiehlt grundsätzlich Opus 5 für die meisten Workloads und den Wechsel zu Fable 5.1 erst dann, wenn Evaluierungen mit höherem Opus-5-Aufwand die Anforderungen nicht erfüllen.
| Ihre wichtigste Vorgabe ist … | Starten Sie mit … | Warum |
|---|---|---|
| Kurze oder klar begrenzte Anfragen | Opus 5 | Die Preise für Eingabe und Ausgabe betragen jeweils die Hälfte von Fable 5.1. |
| Produktivverkehr mit hohem Ausgabeanteil | Opus 5 | Der günstigere Cache-Lesepreis von Fable reduziert nicht die Kosten generierter Tokens. |
| Dateiübergreifende Coding-Aufgaben mit klarer Spezifikation | Opus 5 | Die geringeren Kosten machen wiederholte Versuche und höheren Aufwand leichter kalkulierbar. |
| Lang laufende Agents mit Tool-Nutzung | Fable 5.1—nach einer Evaluierung | In den veröffentlichten Vergleichen von Anthropic liegt Fable bei agentischen Aufgaben und Tool-Nutzung vorn. |
| Große Kontexte, die über mehrere Turns hinweg wiederverwendet werden | Fable 5.1—nach Kostenmodellierung | Sein Preis für Cache-Lesevorgänge beträgt die Hälfte von Opus 5. |
| Produktiv-Router mit sensiblen Fallbacks | Zuerst Opus 5 | Fable 5.1 verändert das Verhalten von Thinking-Blöcken und dem Konversationsverlauf. |
Entscheidend ist der Vergleich von Opus 5 mit passendem Aufwand und passenden Kosten gegen Fable 5.1 mit der richtigen Kontextstruktur und Zuverlässigkeitsanforderung.
Was unterscheidet Fable 5.1 konkret von Opus 5?
Claude Fable 5.1 ist Anthropics höher positioniertes Modell für anspruchsvolles Reasoning und agentische Arbeit über lange Abläufe hinweg. Claude Opus 5 wird als kostengünstigeres Modell für ernsthafte Coding-Aufgaben, Agents und professionelle Anwendungen positioniert. Beide bieten ein Kontextfenster von 1 Million Tokens und maximal 128.000 Output-Tokens. Für Fable spricht also die Ausführung über lange Abläufe, nicht ein offiziell größeres Kontextlimit.
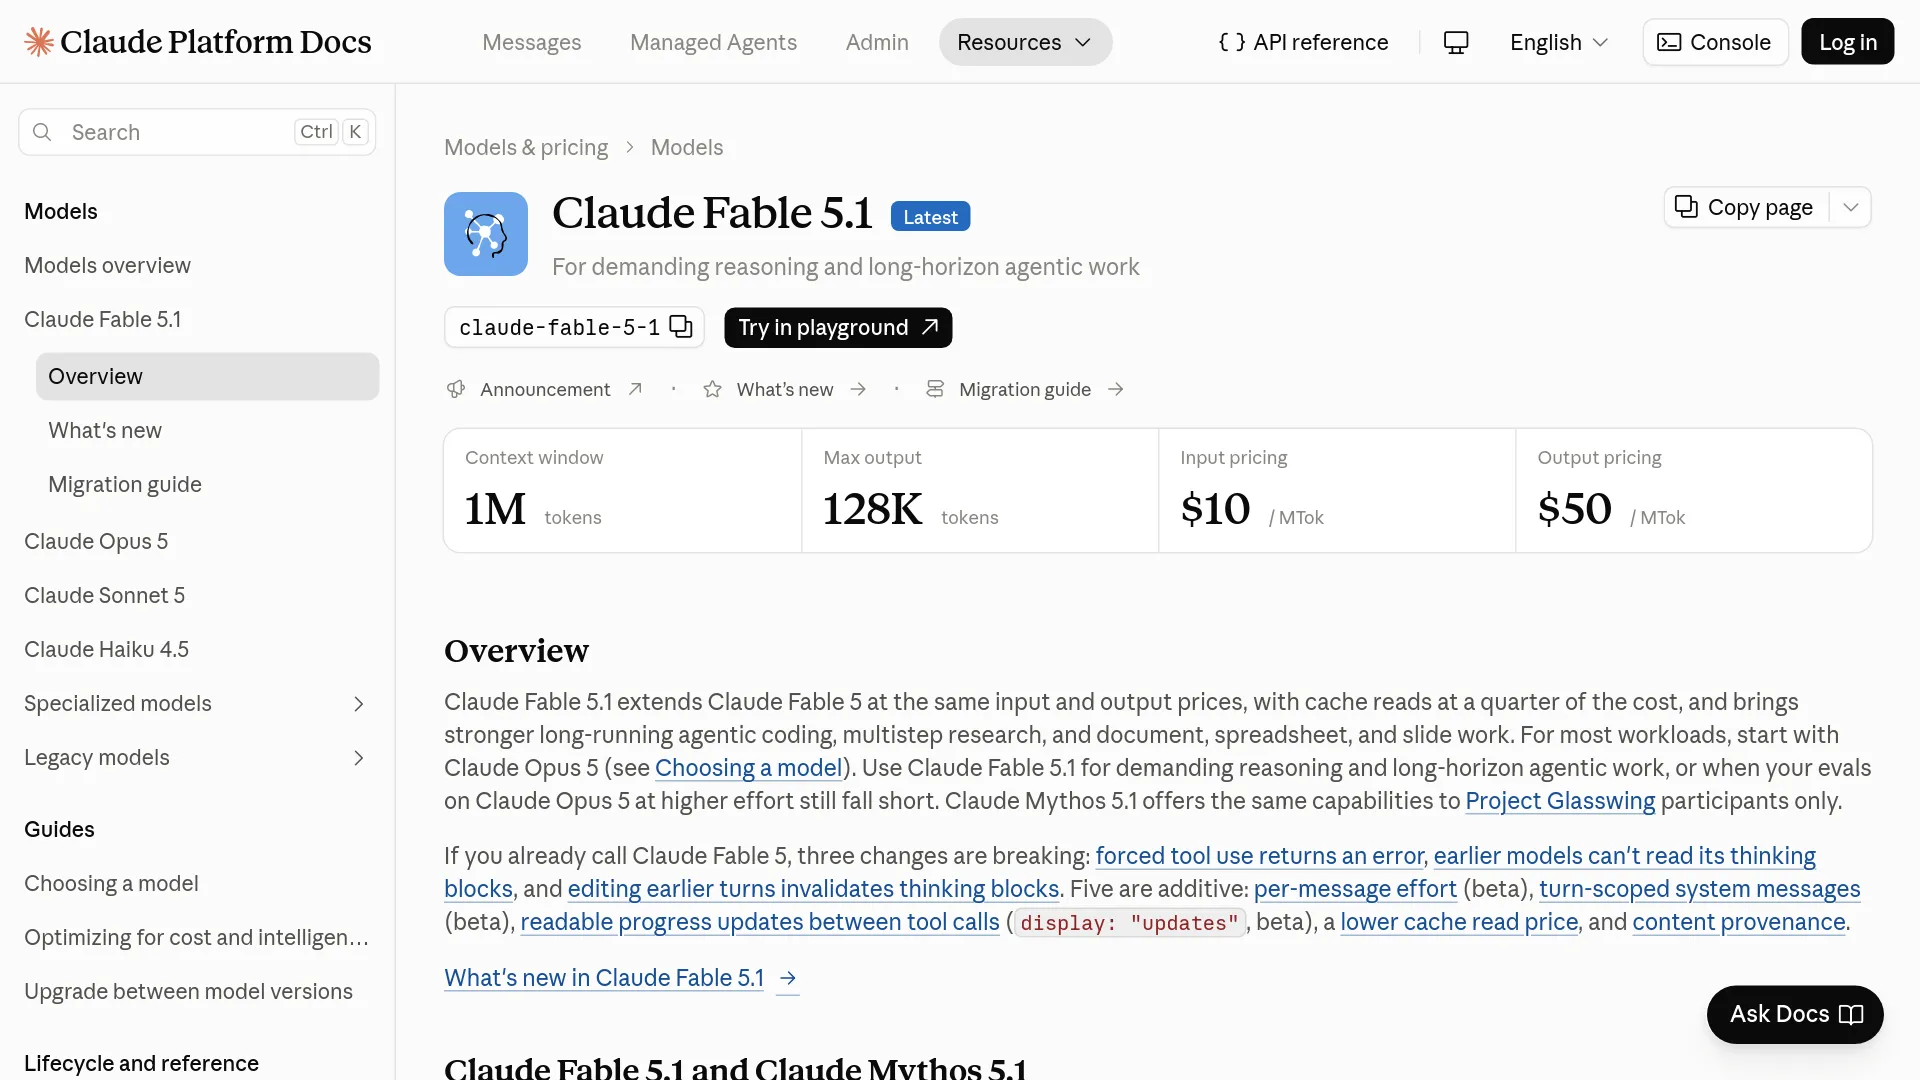
| Spezifikation | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| API-Modell-ID | claude-fable-5-1 | claude-opus-5 |
| Kontextfenster | 1 Million Tokens | 1 Million Tokens |
| Maximale Ausgabe | 128.000 Tokens | 128.000 Tokens |
| Eingabemodalitäten | Text und Bilder | Text und Bilder |
| Ausgabemodalität | Text | Text |
| Thinking | Adaptiv, immer aktiv | Reasoning mit steuerbarem Aufwand |
| Aufwandssteuerung | low, medium, high, xhigh, max | Konfigurierbare Aufwandsstufen |
| Positionierung durch Anthropic | Anspruchsvolles Reasoning und Agents für lange Abläufe | Die meisten Workloads und ernsthaftes Coding |
| Release-Status | Aktiv/aktuell; veröffentlicht am 1. September 2026 | Aktives Opus-Modell; veröffentlicht am 24. Juli 2026 |
Deployment-spezifische Modell-IDs und die Verfügbarkeit finden sich auf der Modellseite zu Fable 5.1 sowie der Produktseite zu Claude Opus 5.
Fable 5.1 liegt in den Benchmarks vorn – aber nicht pauschal
In der veröffentlichten Benchmark-Tabelle von Anthropic liegt Fable 5.1 bei jeder aufgeführten Zeile, für die beide Modelle ausgewiesen sind, vor Opus 5. Da die Tabelle vom Anbieter selbst stammt, sind die Ergebnisse ein nützlicher Hinweis auf die Launch-Evaluierung – aber keine Garantie für den Produktiveinsatz.
| Anthropic-Evaluierung | Fable 5.1 | Opus 5 | Vorsprung von Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | 23.6 Punkte |
| Terminal-Bench 4.0 | 55.8% | 52.3% | 3.5 Punkte |
| GDPval-AA v2 | 1,853 Elo | 1,824 Elo | 29 Elo |
| OSWorld 2.0, strikt | 41.7% | 39.6% | 2.1 Punkte |
| Humanity’s Last Exam, mit Tools | 65.0% | 63.6% | 1.4 Punkte |
| AutomationBench | 31.4% | 26.9% | 4.5 Punkte |
| CursorBench 3.2.0 | 73.4% | 70.0% | 3.4 Punkte |
Anthropic zufolge waren Schutzmechanismen für den Produktiveinsatz aktiviert; einzelne Eingriffe konnten zu Nullwerten führen oder Aufgaben an Fallback-Modelle weiterleiten. Für Terminal-Bench-Science 0.1 nennt das Unternehmen zudem einen Standardfehler von ungefähr 3.5–4.5 Prozentpunkten pro Modell. Ein Abstand von 23.6 Punkten ist damit aussagekräftiger als die Differenz von 1.4 Punkten bei Humanity’s Last Exam.
Eine externe Evaluierung von CodeRabbit mit 45 Aufgaben und 105 bekannten Problemstellen ermittelte für Fable 5.1 einen Recall von 61.0% und eine Precision von 37.3%. Opus 5 kam auf 55.2% Recall und 39.3% Precision. Beide Modelle erzeugten 166 verarbeitete Kommentare; die Autoren weisen jedoch darauf hin, dass sich die Setups unterschieden.
„Fable 5.1 ist ein Spezialist für Reviews.“ — Beschreibung des Evaluationsergebnisses durch CodeRabbit (CodeRabbit)
Die API-Preise verschieben den praktischen Vergleich
Für nicht gecachte Eingaben und Ausgaben kostet Fable 5.1 doppelt so viel wie Opus 5, beim Lesen aus dem Cache hingegen nur die Hälfte. Daraus ergibt sich ein Umschlagpunkt bei langen, repetitiven Agent-Sessions. Nicht jede Anfrage an Fable 5.1 wird dadurch günstiger.
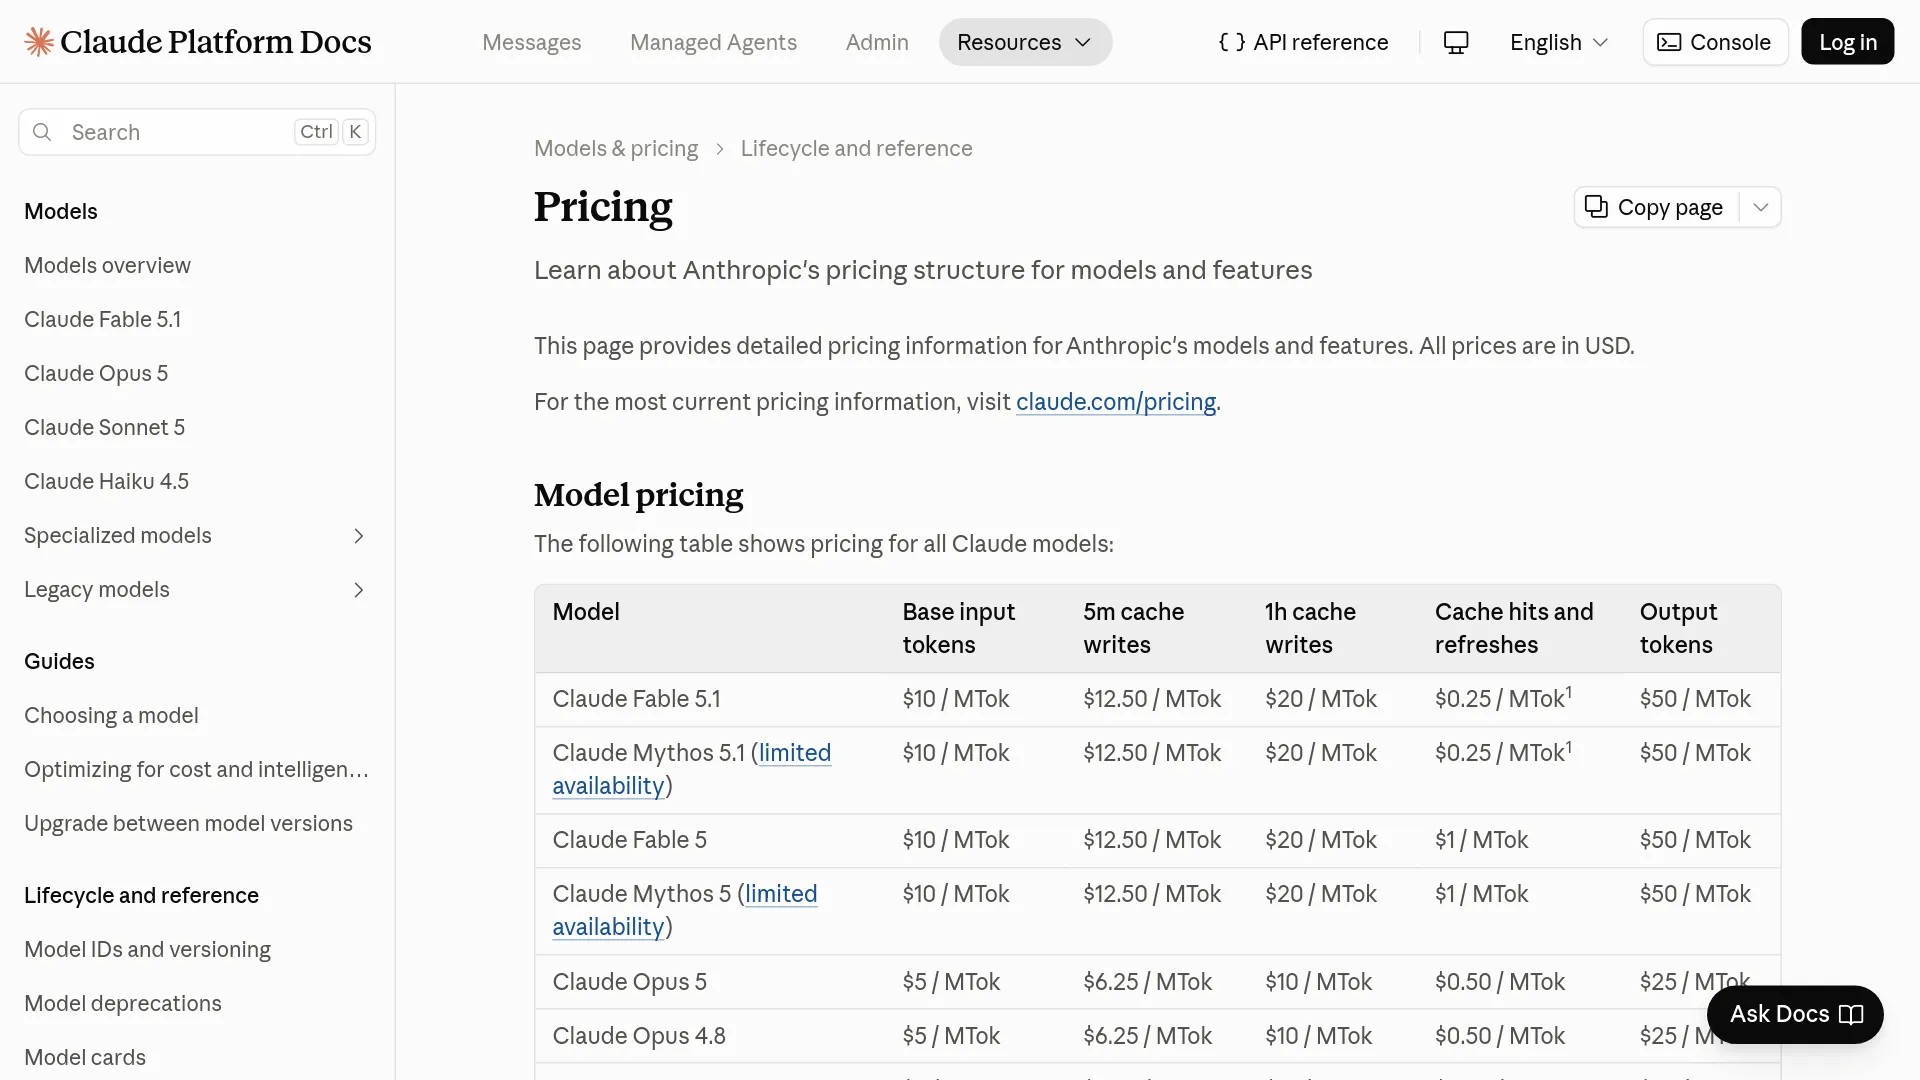
Die folgenden Preise stammen aus der aktuellen API-Preisdokumentation von Anthropic und gelten in USD pro Million Tokens.
| Abrechnungsposition | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| Basis-Eingabe | $10.00 | $5.00 |
| 5-Minuten-Cache-Write | $12.50 | $6.25 |
| 1-Stunden-Cache-Write | $20.00 | $10.00 |
| Cache-Read | $0.25 | $0.50 |
| Ausgabe | $50.00 | $25.00 |
| Batch-Eingabe / -Ausgabe | $5.00 / $25.00 | $2.50 / $12.50 |
Die Preise für Eingabe und Ausgabe von Fable 5.1 entsprechen weiterhin denen von Fable 5. Die beworbenen Einsparungen beruhen auf dem Cache-Read-Preis: $0.25 pro Million Tokens statt $1.00 bei Fable 5. Anthropic schätzt die Kosten für typische Workloads auf rund 25% niedriger und für stark agentische Workloads auf bis zu etwa 45% niedriger. Das sind jedoch Workload-Schätzungen, kein pauschaler Rabatt.
Eine Rechnung pro Turn verdeutlicht den Zielkonflikt. Sei C der gecachte Kontext, I die neue Eingabe und O die Ausgabe – jeweils in Millionen Tokens. Ohne Cache-Write-Gebühren kostet Fable 5.1 10I + 0.25C + 50O, während Opus 5 auf 5I + 0.50C + 25O kommt.
Die günstigeren Cache-Reads von Fable gleichen die höheren Preise für frische Eingaben und Ausgaben nur aus, wenn gilt:
0.25C > 5I + 25O
Bei einem frischen Prompt mit 2.000 Tokens und einer Antwort mit 1.000 Tokens gilt I = 0.002 und O = 0.001. Der gecachte Kontext muss ungefähr 140.000 Tokens überschreiten, bevor die reine Read-Arithmetik für Fable spricht. Mit Cache-Write-Kosten verschiebt sich dieser Umschlagpunkt weiter nach hinten.
Deshalb sollten kurze Extraktions-, Klassifizierungs-, Umschreib- und einmalige Coding-Aufrufe nicht aus Preisgründen auf Fable 5.1 umgestellt werden. Es gibt kaum oder keinen wiederverwendbaren Präfix, der rabattiert werden könnte, und jeder generierte Token kostet doppelt so viel wie bei Opus 5.
Wo die Modelle in realen Workflows passen
Praktisch verläuft die Trennlinie zwischen klar begrenzter Ausführung und Ausdauer über lange Abläufe. Opus 5 ist leichter zu rechtfertigen, wenn eine Aufgabe präzise spezifiziert oder ausgabelastig ist. Fable 5.1 wird interessanter, wenn ein Agent einen Plan über viele Schritte halten, wiederholt Tools einsetzen, Fehler korrigieren und einen großen Kontext über zahlreiche Turns hinweg mitführen muss.
Coding Agents: Entscheidend ist erledigte Arbeit, nicht die Benchmark-Platzierung
Für gewöhnliche Repository-Arbeit ist Opus 5 der bessere erste Test: klar abgegrenzte Bugfixes, definierte Refactorings, Code Reviews und Aufgaben, bei denen geringere Kosten Wiederholungen oder höheren Aufwand erlauben. Fable 5.1 verdient einen Pilotversuch bei dateiübergreifenden Änderungen, Migrationen, Debugging auf Systemebene und asynchronen Coding-Sessions, in denen ein später Fehlschlag teurer ist als eine langsamere Antwort.
Das Community-Feedback deutet auf zwei unterschiedliche operative Risiken hin. In einer umfangreichen Diskussion auf r/ClaudeCode schrieb der Nutzer u/CyCoCyCo:
„Erfolg hatte ich nur, wenn ich Ziel-Prompts erstellen und diese vollständig durchlaufen ließ.“ — u/CyCoCyCo auf Reddit
Das belegt eine Beschwerde über Prompting und Workflow, aber nicht, dass Opus 5 in jedem Codebestand scheitert. Andere Nutzer beschrieben in derselben Diskussion Schwierigkeiten bei längeren, kontextintensiven Aufgaben, darunter das Abweichen von Anweisungen und Fixes, die neue Fehler einführten.
Fable 5.1 weist ein anderes Beschwerdebild auf: In einer Release-Diskussion berichteten Nutzer von ungewöhnlich schnellem Verbrauch von Tokens oder Kontingent. Der Bericht ist anekdotisch und belegt kein allgemeingültiges Subscription-Limit. Für einen Pilotversuch ist er dennoch ein Anlass, die Nutzung mitzuverfolgen, statt das Modell allein anhand der Ausgabequalität zu bewerten.
Ein sinnvoller Pilot für Coding Agents erfasst:
- Aufgaben, die ohne menschliches Eingreifen abgeschlossen wurden.
- Wiedereröffnete Bugs oder Regressionen, nachdem das Modell Erfolg gemeldet hat.
- Gesamte Eingabe-, Cache-Eingabe- und Ausgabe-Tokens.
- Benötigte Zeit und Anzahl der Tool-Aufrufe.
- Zeit für menschliche Korrekturen sowie die Kosten spät gescheiterter Durchläufe.
Recherche und dokumentenintensive Arbeit: Hier ist der Fall für Fable klarer
Fable 5.1 ist der stärkere Kandidat, wenn eine Aufgabe einen sehr großen Dokumentenbestand, wiederholte Tool-Aufrufe, visuelle Diagramme, mehrstufige Recherche oder ein Ergebnis umfasst, das mehrere Überarbeitungsrunden überstehen muss. Anthropic positioniert das Modell ausdrücklich für Dokumente, Tabellenkalkulationen, Präsentationen, Diagramme, Tabellen und lang laufende Recherche.
Opus 5 verfügt über dieselbe Kontextkapazität von 1 Million Tokens und wird von Anthropic ebenfalls als fähig für komplexe Dokumente und anspruchsvolle Agents beschrieben. Handelt es sich um eine einzelne Analyse mit umfangreicher generierter Ausgabe, kann der niedrigere Opus-Preis wichtiger sein als Fables Cache-Vorteil. Bevor Fables Benchmark-Vorsprung zur Produktionsanforderung wird, sollte ein repräsentativer Testlauf erfolgen.
Computer Use und Geschäftsautomatisierung: Den gesamten Ablauf testen
Fable 5.1 liegt in den OSWorld- und AutomationBench-Zeilen von Anthropic vor Opus 5. Solche Aufgaben messen allerdings eine Folge von Aktionen, nicht eine einzelne Antwort. Bei Browser- oder Geschäftsprozess-Agents sollte geprüft werden, ob das Modell den korrekten Endzustand erreicht, wie oft es sich erholen muss und ob eine fehlgeschlagene Aktion den restlichen Durchlauf unbrauchbar macht.
Die relevante Kennzahl lautet Kosten pro abgeschlossenem Ergebnis, nicht nur Kosten pro Million Tokens. Ein Modell, das bei langen Workflows wiederholte Versuche verhindert, kann trotz höherem Preis wirtschaftlich sein. Ein Modell, das das Nutzungskontingent verbraucht, bevor es den Endzustand erreicht, ist es nicht.
Diese Integrationsdetails sollten Teams vor einem Wechsel prüfen
Die Migrationsdokumentation für Fable 5.1 beschreibt Änderungen bei erzwungener Tool-Nutzung, Thinking-Blöcken und der Validierung des Konversationsverlaufs. Teams mit eigenem Message Router sollten dies testen, bevor sie das Standardmodell ändern.
| Änderung | Mögliche Auswirkung | Migrationsmaßnahme |
|---|---|---|
| Erzwungene Tool-Nutzung | tool_choice: {"type":"any"} oder die Auswahl eines benannten Tools kann HTTP 400 zurückgeben. | auto mit klaren Tool-Anweisungen verwenden oder, wo passend, strukturierte Ausgaben einsetzen. |
| Portabilität von Thinking-Blöcken | Frühere Modelle können Thinking-Blöcke von Fable 5.1 nicht lesen; Fallback-Turns können sie verwerfen. | Modellwechsel und Fallback-Pfade prüfen. |
| Änderungen am Konversationsverlauf | Das Bearbeiten einer früheren Nachricht, des System Prompts oder der Tool-Liste kann spätere Thinking-Blöcke ungültig machen. | Den Verlauf als append-only behandeln oder unterstützte turn-spezifische Steuerungen verwenden. |
| Thinking-Konfiguration | Fable 5.1 nutzt adaptives Thinking und unterstützt das Deaktivieren von Thinking nicht auf dieselbe Weise wie Opus 5. | Ausgaben über die Aufwandseinstellungen steuern und den Token-Verbrauch erneut testen. |
Der Fallback-Aspekt ist bei Routern mit mehreren Modellen relevant. Eine Fable-5.1-Anfrage kann mit ihrem Reasoning-Kontext fortgesetzt werden, ein Fallback auf Opus 5 kann jedoch keine Thinking-Blöcke von Fable 5.1 verarbeiten. Verwirft der Router sie stillschweigend, muss der Fallback möglicherweise neu planen – mit zusätzlicher Latenz und weiteren Tokens. Sowohl den Erfolgs- als auch den Fehlerpfad mit produktionsnahen Verläufen testen.
Eine kleine Evaluierung ist aussagekräftiger als große Modellversprechen
Für beide Modelle sollten dieselben Prompts, Tools, Kontexte, Aufwandseinstellungen und Abnahmetests gelten. Andernfalls wird aus dem Modellvergleich schnell ein Vergleich der Testumgebung.
- Begrenzte Spur: klar abgegrenzte Bugfixes, Extraktion, strukturiertes Schreiben und Code Reviews ausführen. Nützliche Ausgabe, Korrekturzeit und Kosten erfassen.
- Spur für lange Abläufe: ein dateiübergreifendes Feature, eine Migration, eine Rechercheaufgabe oder einen Browser-Workflow ausführen. Erfolg im Endzustand, Wiederherstellung, Regressionen und benötigte Zeit erfassen.
- Cache-intensive Spur: einen stabilen System Prompt, Tool-Satz sowie Repository- oder Dokumentpräfix wiederholen. Cache-Hit-Quote und Gesamtrechnung einschließlich Cache-Writes und Ausgabe erfassen.
Opus 5 sollte zunächst mit der Aufwandseinstellung getestet werden, die tatsächlich ausgerollt würde. Anschließend ist ein höherer Opus-Aufwand zu prüfen, bevor die Aufgabe zu Fable 5.1 wandert. Für Fable sollten mindestens medium und high getestet werden; die Namen der Aufwandsstufen lassen sich nicht automatisch zwischen den Modellen übertragen. Anthropic zufolge steuern sie den Zielkonflikt aus Tiefe und Kosten. Tests von Drittanbietern ergaben zudem, dass höheres Reasoning die aggregierten Ergebnisse bei Code Reviews nicht automatisch verbessert.
FAQ: Fable 5.1 vs. Opus 5
Welches Modell eignet sich besser fürs Coding?
In den von Anthropic veröffentlichten Ergebnissen für Terminal-Bench und CursorBench liegt Fable 5.1 vor Opus 5. Für die meisten klar abgegrenzten und kostensensiblen Coding-Aufgaben ist Opus 5 dennoch der bessere Ausgangspunkt. Eine Evaluierung mit einem repräsentativen Repository zeigt, ob die höhere Abschlussqualität von Fable dessen Preis und Latenz ausgleicht.
Ist Fable 5.1 den doppelten API-Preis wert?
Nicht standardmäßig. Für Eingaben und Ausgaben verlangt es doppelt so viel wie Opus 5, während Cache-Reads nur halb so teuer sind. Finanziell interessant wird Fable, wenn ein Workload wiederholt einen großen Kontext verwendet und vergleichsweise wenig Ausgabe erzeugt.
Hat Fable 5.1 ein größeres Kontextfenster?
Nein. Anthropic gibt für beide Modelle ein Kontextfenster von 1 Million Tokens und maximal 128.000 Output-Tokens an. Fable unterscheidet sich durch seine Positionierung für Reasoning über längere Abläufe und Agent-Trajektorien, nicht durch ein offiziell größeres Fenster.
Sollte ich den Opus-5-Aufwand erhöhen, bevor ich wechsle?
Ja. Die Modellrichtlinien von Anthropic empfehlen, Opus 5 mit höherem Aufwand zu evaluieren, bevor zu Fable 5.1 gewechselt wird. Die zusätzlichen Token-Kosten sollten der Qualitätsverbesserung gegenübergestellt werden, statt jede Anfrage mit maximalem Aufwand auszuführen.
Kann ich sicher von Fable 5.1 auf Opus 5 zurückfallen?
Ein solcher Fallback lässt sich bauen, die Portabilität des Konversationszustands sollte aber nicht vorausgesetzt werden. Frühere Modelle können Thinking-Blöcke von Fable 5.1 nicht lesen, und die Verlaufvalidierung von Fable 5.1 kann Router offenlegen, die frühere Turns bearbeiten. Den Fallback deshalb mit realen Tool-Schemas und Nachrichtenverläufen testen.
Wo können Entwickler auf Fable 5.1 und Opus 5 zugreifen?
Anthropic führt beide Modelle für Claude-Pläne und den Entwicklerzugang über die eigene Plattform sowie Cloud-Marketplace-Integrationen auf. Die genauen Modell-IDs und die Verfügbarkeit können je nach Anbieter abweichen. Deshalb sollte die deployment-spezifische Kennung in der Dokumentation zu Fable 5.1 oder auf der Produktseite zu Opus 5 geprüft werden.
Die praktische Wahl ist eine Routing-Regel, kein dauerhaftes Upgrade
| Entscheidung | Opus 5 verwenden | Fable 5.1 verwenden |
|---|---|---|
| Standardmodell für gemischten Traffic | Ja | Erst nach einer Evaluierung |
| Kurze einmalige Aufrufe | Ja | Kein Preisargument |
| Ausgabelastige Generierung | Ja | Meist nicht |
| Große gecachte Präfixe | Sorgfältig vergleichen | Potenzieller Kostenvorteil |
| Lang laufendes autonomes Coding | Zuerst Pilotversuch | Starker Kandidat |
| Strikt begrenzte Refactorings | Meist | Wenn Opus Abnahmetests nicht besteht |
| Browser- oder mehrstufige Automatisierung | Zuerst Pilotversuch | Starker Benchmark-Fall |
| Eigener Fallback-Router | Einfachere Basis | Erfordert Migrationstests |
Opus 5 bleibt die Basis. Beide Modelle sollten auf demselben Set aus klar begrenzten Aufgaben und Aufgaben über lange Abläufe getestet werden. Zu Fable 5.1 sollte nur geroutet werden, wenn es mehr abgeschlossene Arbeit pro Dollar liefert.
Modellspezifische Kostendetails finden sich unter Claude Fable 5.1 API pricing; als breitere Modellreferenz dient Claude Opus 5.