 AIREITER
"Sonnet 5 ist nah an Opus 4.8, aber günstiger" ist Anthropics eigene Werbeaussage. Wir wollten wissen, wo das nicht mehr stimmt, also ließen wir vier identische Aufgaben über die Claude Code CLI durch beide Modelle laufen und protokollierten die tatsächlichen Kosten, die Dauer und die Anzahl der Tool-Aufrufe aus jeder API-Antwort. Am wichtigsten war dabei Folgendes: Wir setzten Sonnet 5 auf xhigh Effort, um das zu erreichen, was Opus 4.8 standardmäßig macht, und die von uns gemessene Preisdifferenz verschwand nahezu — während Opus 4.8 in ungefähr der halben Zeit fertig wurde.
Sonnet 5 vs Opus 4.8 auf einen Blick
Claude Sonnet 5 | Claude Opus 4.8 | |
|---|---|---|
Erschienen | 30. Juni 2026 | |
Kontextfenster | 1M tokens | 1M tokens |
Maximale Ausgabe | 128K tokens | 128K tokens |
Preise (Eingabe/Ausgabe pro 1M tokens) | $5/$25 | |
Schnellmodus | Nicht unterstützt | Unterstützt (Research Preview), bis zu ~2,5x Ausgabegeschwindigkeit bei Premium-Preisen |
Effort-Stufen | low / medium / high / xhigh / max | low / medium / high / xhigh / max |
Positionierung | Günstigeres, auf Agenten ausgerichtetes Modell der Sonnet-Klasse | Anthropics Flaggschiff, Option mit der höchsten Genauigkeit |
Kontextfenster und maximale Ausgabe sind identisch — hier kein Unterscheidungsmerkmal. Ein Unterschied ist: Sonnet 5 läuft auf einem neuen Tokenizer, der laut Anthropic bei demselben Text „ungefähr 30 % mehr Tokens“ erzeugt als Sonnet 4.6, sodass sich ein übernommenes max_tokens Budget oder eine Kostenschätzung von Sonnet 4.6 nicht direkt übertragen lässt.
Offizieller Benchmark-Vergleich
Nach den eigenen Offenlegungen von Anthropic, zusammen mit einer Drittanalyse von llm-stats.com, ist das Muster konsistent: Sonnet 5 gewinnt oder erreicht bei ein paar Benchmarks Gleichstand, und Opus 4.8 führt bei den meisten anderen, meist im einstelligen Bereich.
Benchmark | Sonnet 5 | Opus 4.8 | Abstand |
|---|---|---|---|
Terminal-Bench 2.1 | 80.4% | 74.6% | Sonnet 5 +5.8 |
Humanity's Last Exam (with tools) | 57.4% | 57.9% | Nahezu Gleichstand |
Humanity's Last Exam (no tools) | 43.2% | 49.8% | Opus +6.6 |
SWE-bench Verified | 85.2% | 88.6% | Opus +3.4 |
SWE-bench Pro | 63.2% | 69.2% | Opus +6.0 |
Toolathlon | 54.3% | 59.9% | Opus +5.6 |
OSWorld-Verified (computer use) | 81.2% | 83.4% | Opus +2.2 |
CursorBench | 61.2% | 63.8% | Opus +2.6 |
USAMO 2026 problems | 79.5% | 96.7% | Opus +17.2 |
Zwei Dinge stechen hervor. Der größte Vorsprung von Opus 4.8 liegt bei schwieriger Mathematik (USAMO), nicht beim Coding — die Coding-Abstände (SWE-bench, Terminal-Bench) liegen alle im einstelligen Bereich, und Sonnet 5 gewinnt tatsächlich einen davon klar. Beim allgemeinen, mit Tools erweiterten Reasoning (HLE with tools) liegen die beiden so nah beieinander, dass man von einem Unentschieden sprechen kann.
Es gibt außerdem eine Sicherheitskennzahl, die es zu erwähnen gilt, auch wenn sie kein Fähigkeits-Benchmark ist: Laut denselben Offenlegungen lag in Browser-Use-Szenarien ohne zusätzliche Schutzmaßnahmen die gemessene Erfolgsrate von Prompt-Injection-Angriffen bei Sonnet 5 bei 0,93 %, gegenüber 31,5 % bei Opus 4.8. Anthropic hat für diese spezifische Lücke keine detaillierte Erklärung veröffentlicht. Wenn Sie irgendetwas Agentenhaftes entwickeln, das das offene Web unbeaufsichtigt durchsucht, lohnt es sich, die eigenen Schutzmaßnahmen zu testen, statt anzunehmen, dass das Flaggschiffmodell automatisch die sicherere Standardwahl ist.
Wir haben vier direkte Tests selbst durchgeführt
Der Großteil dessen, was derzeit verfügbar ist, übernimmt entweder die offizielle Benchmark-Tabelle oben oder teilt subjektive Eindrücke von einzelnen Modellen. Wir haben keinen kontrollierten Kosten- und Latenzvergleich mit demselben Prompt gefunden, also haben wir unseren eigenen durchgeführt.
Methodik: vier Aufgaben, ausgeführt am 2026-07-01, jedes Mal derselbe Prompt an claude-sonnet-5 und claude-opus-4-8 über die Claude Code CLI gesendet (claude -p --model <id> --effort <level> --output-format json). Kosten, Dauer und Turn-Anzahlen werden direkt aus der API-Antwort jedes Laufs ausgelesen und nicht aus Token-Zahlen geschätzt. Jede Modell-/Effort-Konfiguration wurde pro Aufgabe einmal ausgeführt — reale Zahlen aus einem einzelnen Lauf, nicht aus einer statistisch gemittelten Stichprobe. Betrachten Sie die Größe jeder Lücke eher als Tendenz denn als exakten Wert; die Richtung war bei jedem von uns durchgeführten Test konsistent.
Test 1: Der Kostenumkehr-Check
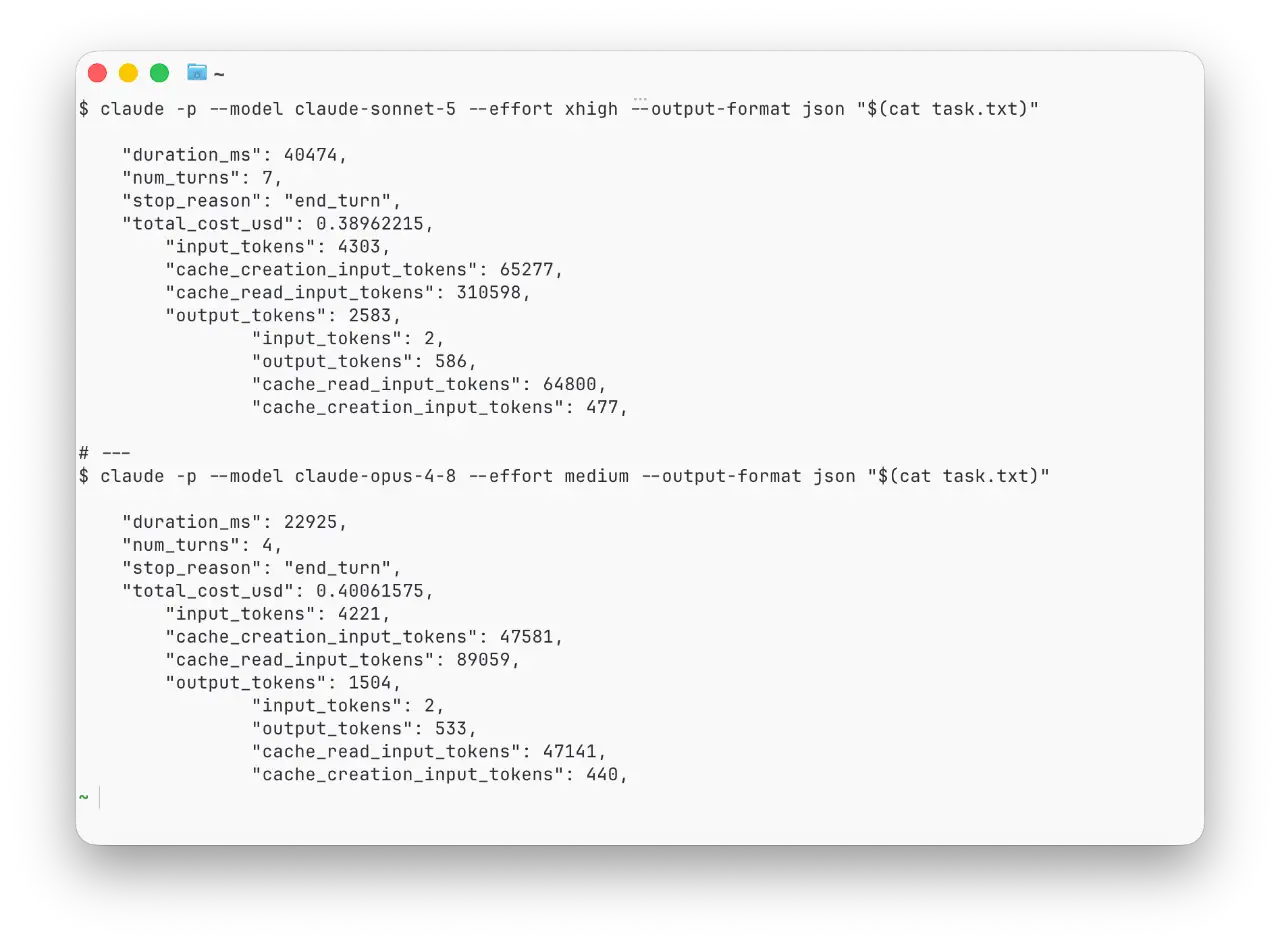
Die Frage, die wir am meisten beantworten wollten: Bleibt Sonnet 5 günstiger, wenn man das Effort-Level erhöht, um eine schwierigere Aufgabe auszugleichen? Wir haben dieselbe Coding-Aufgabe wie in Test 2 (unten) mit Sonnet 5 xhigh gegen Opus 4.8 medium durchgeführt.
Einrichtung | Kosten | Dauer | Durchläufe | Ergebnis |
|---|---|---|---|---|
Sonnet 5, effort | $0.390 | 40.5s | 7 | 8/8 tests pass |
Opus 4.8, effort | $0.401 | 22.9s | 4 | 7/7 tests pass |
Ein Kostenunterschied von 3 % — im Wesentlichen ein Nullsummenspiel — und Opus 4.8 hat bei seiner niedrigeren Einstellung die Aufgabe in 57 % der Zeit mit fast der Hälfte der Turns abgeschlossen. Beide lieferten korrekten, funktionierenden Code. Das deckt sich mit dem, was die Leute bereits auf Hacker News anmerken: Ein Kommentator dort schätzte, dass Opus 4.8 bei mittlerem Reasoning ungefähr 0,45 $ kostet, während Sonnet 5 bei xhigh/max für vergleichbare Arbeit ungefähr 0,52 $ kostet.
Test 2: Programmieraufgabe bei gleichem Aufwand
Gleiche Eingabeaufforderung, beide Modelle mit high Aufwand: Schreibe eine effiziente Funktion für die längste palindromische Teilzeichenkette, generiere Testfälle, die die Randfälle abdecken, führe sie aus, behebe alles, was fehlschlägt.
Einrichtung | Kosten | Dauer | Durchläufe | Ergebnis |
|---|---|---|---|---|
Sonnet 5 (high) | $0.378 | 37.4s | 7 | 8/8 bestanden |
Opus 4.8 (high) | $0.439 | 28.9s | 5 | 8/8 bestanden |
Beide landeten beim gleichen Expand-around-Center-Ansatz und bestanden jeden Test beim ersten Durchlauf. Opus 4.8 kam schneller und in weniger Durchgängen ans Ziel, für etwa 16 % mehr Geld. Wenn die Qualität identisch ist, geht dieser Punkt allein wegen der Geschwindigkeit an Opus.
Test 3: Schreiben / Wissensarbeit
Eine betriebswirtschaftliche Entscheidungsfrage ohne eindeutige richtige Antwort: Berate ein SaaS-Unternehmen mit 12 Mitarbeitern dazu, ob es 3–4 Wochen damit verbringen sollte, für Disaster Recovery in eine zweite AWS-Region zu migrieren, sechs Wochen bevor der Abschluss ihrer Series A erfolgt.
Einrichtung | Kosten | Dauer | Durchläufe |
|---|---|---|---|
Sonnet 5 (hoch) | $0.072 | 14.7s | 1 |
Opus 4.8 (hoch) | $0.084 | 22.7s | 1 |
Beide gaben im Wesentlichen dieselbe Empfehlung — die vollständige Migration überspringen und stattdessen ein leichtgewichtiges Backup-/Runbook bereitstellen — mit vergleichbarer Qualität der Begründung. Sonnet 5 brauchte dafür etwa zwei Drittel der Zeit und kostete 14 % weniger. Dies ist der eine Test, bei dem „Sonnet 5 hält bei Wissensarbeit gut mit“ klar zum Ausdruck kam.
Test 4: Agentic Lookup — Denkt Sonnet 5 wirklich „zu viel nach“?
Einige Reddit-Threads beschreiben Sonnet 5 als eher dazu neigend, einfache Anfragen zu überdenken, als Opus 4.8. Wir haben eine wirklich einfache getestet: die Byte-Größe jeder .py Datei in einem Verzeichnisbaum zu summieren und zu melden, welches Unterverzeichnis davon am meisten enthält.
Einrichtung | Kosten | Dauer | Runden |
|---|---|---|---|
Sonnet 5 (high) | $0.119 | 18.5s | 3 |
Opus 4.8 (high) | $0.120 | 12.1s | 2 |
Beide kamen auf dieselbe richtige Antwort. Die Kosten unterschieden sich nur um einen Rundungsfehler, aber Sonnet 5 brauchte einen zusätzlichen Tool-Call-Durchlauf und etwa 50 % mehr Zeit. Das ist ein echter, wenn auch kleiner, Datenpunkt für den Vorwurf des „Overthinking“ – und er deckt sich mit Test 1: Sonnet 5 braucht tendenziell mehr Schritte, um am selben Ziel anzukommen.
Also, welches sollten Sie tatsächlich verwenden?
Wählen Sie Opus 4.8 für Codierungsaufgaben, bei denen Geschwindigkeit zählt, agentische Workflows mit vielen Tool-Aufrufen oder alles, bei dem Sie sonst versucht wären, Sonnet 5s Aufwand über
highhinauszuschrauben, um dem Ergebnis zu vertrauen — genau dann verschwindet Sonnet 5s Kostenvorteil.Wählen Sie Sonnet 5 für umfangreiche, budgetkritische Arbeiten sowie allgemeine Wissens- und Schreibaufgaben, aber lassen Sie es bei
mediumoderhighAufwand. Erhöhen Sie es nicht reflexartig aufxhigh„nur zur Sicherheit“ — genau dort bricht die Preisgeschichte zusammen.Beides funktioniert für einfache Nachschlagen-Abfragen und Single-Turn-Anfragen; der praktische Unterschied, den wir gemessen haben, war ein zusätzlicher Turn und ein paar Sekunden, nicht eine falsche Antwort.
FAQ
Ist Claude Sonnet 5 tatsächlich günstiger als Opus 4.8?
Bei gleichen Anstrengungsstufen: ja — deutlich. Aber wenn Sie Sonnet 5 auf xhigh hochsetzen, um eine schwierigere Aufgabe auszugleichen, kann sich der Abstand auf ein paar Prozent verringern, während Opus 4.8 bei einer niedrigeren Anstrengungseinstellung schneller fertig wird. Prüfen Sie, welche Anstrengungsstufe Sie tatsächlich verwenden, bevor Sie annehmen, dass Sie Geld sparen. Die vollständige Preisliste für Haiku, Sonnet und Opus finden Sie in unserem Claude API pricing guide.
Wie steht es um Claude Sonnet 5 im Vergleich zu Sonnet 4.6?
Ein Generationssprung, keine Wahl zwischen Modellstufen – und die Kosten entwickeln sich dort ebenfalls nicht in dieselbe Richtung. Sonnet 5 schlägt Sonnet 4.6 auf Terminal-Bench um zweistellige Werte, aber in unseren eigenen direkten Kostentests war Sonnet 5 bei jedem von uns getesteten Aufwandsniveau teurer als Sonnet 4.6, hauptsächlich wegen des neuen Tokenizers. Vollständige Tests und Zahlen in Sonnet 5 vs Sonnet 4.6: Ist es tatsächlich günstiger?
Ist Claude Sonnet 5 vs Opus 4.6 ein fairer Vergleich?
Nicht wirklich — Opus 4.6 ist eine Generation hinter Opus 4.8 zurück. Wenn Sie entscheiden, was Sie heute verwenden sollen, vergleichen Sie mit Opus 4.8, nicht mit seinem Vorgänger.
Unterscheidet sich das Kontextfenster zwischen den beiden?
Nein — beide bieten ein Kontextfenster von 1 Mio. Tokens und eine maximale Ausgabelänge von 128K.
Warum ist die Prompt-Injection-Rate von Opus 4.8 bei der Browser-Nutzung so viel höher?
Laut den Offenlegungen von Anthropic liegt dieser Wert bei 31,5 % ohne zusätzliche Schutzmaßnahmen gegenüber 0,93 % bei Sonnet 5, insbesondere in unbeaufsichtigten Browser-Use-Szenarien. Anthropic hat keine detaillierte Erklärung veröffentlicht. Betrachten Sie dies als Anlass, Ihre spezifischen Schutzmaßnahmen zu testen, statt anzunehmen, dass das Flaggschiff-Modell automatisch die sicherere Standardwahl ist.
Anhang: Exakte Prompts und Rohausgabe
Für alle, die dies reproduzieren möchten, hier sind die exakten Prompts, die wir für jeden Test gesendet haben (Test 1 und Test 2 verwendeten denselben Coding-Prompt, nur mit unterschiedlichen Aufwandsstufen).
Tests 1 & 2 — Programmier-Prompt:
Schreiben Sie eine Python-Funktion `longest_palindromic_substring(s: str) -> str`, die
die längste palindromische Teilzeichenkette von s zurückgibt, wobei ein Ansatz
verwendet wird, der effizienter ist als brute-force O(n^3) (z. B.
expand-around-center oder Manachers Algorithmus). Speichern Sie sie in
solution.py.

Schreiben Sie dann test_solution.py mit mindestens 6 Testfällen, die Folgendes abdecken:
leerer String, einzelnes Zeichen, alle Zeichen gleich, kein Palindrom länger als 1,
ein Palindrom mit gerader Länge und ein Palindrom mit ungerader Länge.

Führen Sie die Tests mit pytest aus und stellen Sie sicher, dass alle bestehen.
Falls welche fehlschlagen, beheben Sie den Code und führen Sie die Tests erneut aus,
bis alle bestehen. Geben Sie die endgültige pytest-Ausgabe an.
Test 3 — Schreib-/Wissensarbeits-Prompt:
Du berätst ein kleines SaaS-Unternehmen (12 Mitarbeitende, 80k MRR, derzeit in einer
einzigen AWS-Region) dazu, ob es vor seiner Series-A-Finanzierungsrunde, die in 6 Wochen
abschließt, auf eine zweite AWS-Region für Disaster Recovery erweitern sollte.

Das Engineering schätzt, dass die Migration 3–4 Wochen dauert und in diesem Zeitraum
den Großteil der Teamkapazität beanspruchen würde, wodurch zwei vom Kunden gewünschte
Features verzögert würden.

Verfasse eine Executive-Empfehlung von etwa 350 Wörtern: Sollen sie es jetzt tun, es
verschieben oder einen Mittelweg finden? Begründe mit den Abwägungen. Kein
Vorspann, nur die Empfehlung.
Test 4 — agentic lookup prompt:
Im aktuellen Verzeichnisbaum finden Sie alle Dateien mit der Erweiterung .py, addieren Sie ihre
Gesamtgröße in Bytes, und teilen Sie mir mit, welches einzelne Unterverzeichnis (direktes Kind des
Arbeitsverzeichnisses) die meisten .py-Dateien nach Anzahl enthält. Nur die beiden
Zahlen/die Antwort, es ist nicht nötig, neue Dateien zu schreiben.
Hier ist die tatsächliche API-Antwort für den Sonnet 5 (xhigh)-Lauf aus Test 1, auf die für Kosten und Timing relevanten Felder gekürzt:
{
  "duration_ms": 40474,
  "num_turns": 7,
  "stop_reason": "end_turn",
  "total_cost_usd": 0.38962215,
  "usage": {
    "input_tokens": 4303,
    "cache_creation_input_tokens": 65277,
    "cache_read_input_tokens": 310598,
    "output_tokens": 2583
  }
}
Das sind die unbearbeiteten total_cost_usd, duration_ms und Token-Zahlen, die die Claude Code CLI für diesen Lauf zurückgegeben hat — die Zahlen in der Test-1-Tabelle oben stammen direkt aus solchen Feldern, eine JSON-Antwort pro Lauf.