 AIREITER
Für bezahlte Claude-Tarife soll Claude Opus 5.5 jetzt der Standard für Wissensarbeit sein. Das ist in der Praxis weitgehend nachvollziehbar: Bei Recherche, Analyse und Schreiben liefert das Modell überzeugend ab. Der Haken, der sich in Nutzerberichten immer wieder zeigt: Die Quoten von Pro, Max und Team sind schneller aufgebraucht als erwartet.
Am 22. September 2026 erschien Opus 5.5 als erstes Modell der Claude-5.5-Familie. Anthropic versprach für die meisten Aufgaben ein Niveau wie bei Claude Fable 5.1, allerdings bei 40% niedrigeren Betriebskosten als Opus 5 (anthropic.com). Mit dem Daily-Driver-Leitfaden vom 12. November 2026 machte das Unternehmen die Rolle des Modells unmissverständlich: Für Recherche, Analysen, Texte, Berichte, Tabellen und Präsentationen soll Opus 5.5 mit mittlerem Aufwand der Startpunkt sein; erst danach wird hochskaliert (claude.com). Dieser Test bündelt die offiziellen Empfehlungen, unabhängige Benchmarks und Berichte zur Quotennutzung. Es handelt sich nicht um einen Labortest des Herstellers.
Das Kurzfazit: Opus als Standard, Aufwand auf Medium
Opus 5.5 kann als ausgewähltes Standardmodell bleiben. Für normale Wissensarbeit ist Medium die richtige Einstellung. Bevor ein Modellwechsel ansteht, sollte zunächst der Aufwand erhöht werden. Wenn Tempo oder Durchsatz wichtiger sind als Urteilsvermögen, bieten sich Sonnet 5.5 oder Haiku 5.5 an.
Dahinter steckt Rechenlogik, keine Markentreue. In den Coding- und Wissensarbeits-Evaluierungen von Anthropic erreichte oder übertraf Opus 5.5 auf Medium Opus 5 auf High. Factory, zitiert in Anthropics Daily-Driver-Leitfaden, meldete ebenfalls: Medium lag auf dem Niveau von Opus 5 auf High, benötigte dabei aber 20–25% weniger Output-Tokens. Medium ist zudem die Voreinstellung in den Claude-Apps und in Claude Code. Die meisten Abonnenten erhalten dieses Verhalten also ohne Anpassung.
Entscheidend ist jedoch nicht der API-Listenpreis, sondern die Aboquote. Über die API kostet Opus 5.5 $4 pro Million Input-Tokens und $20 pro Million Output-Tokens; bei Opus 5 waren es noch $5/$25. Cache Reads liegen bei $0.20 pro Million. Laut Anthropics Daily-Driver-Leitfaden verbrauchen höherpreisige Modelle die Abolimits aber schneller. Nutzer berichten zudem von 5-Stunden-Fenstern, die bei intensiven Sessions schon nach 15–30 Minuten leer sind, sowie von Wochenlimits, die deutlich früher schwinden als in der September-Startphase.
Was die neue Standardauswahl für Pro, Max und Team bedeutet
Für Abonnenten zählt vor allem, wie sich die Quote mit dem neuen Standardmodell verhält. Zum Start erklärte Anthropic, die Nutzungslimits in Fünf-Stunden-Fenstern für Pro, Max, Team und sitzbasierte Enterprise-Tarife anzuheben und Abonnenten einen speicherbaren Reset des Rate Limits zu geben (anthropic.com). Das geschah trotz der weiter unten beschriebenen Nutzerberichte vom späten Oktober über schneller sinkende Quoten. Der Leitfaden von Anthropic weist außerdem darauf hin, dass Pro sowie Standard-Team- und sitzbasierte Enterprise-Plätze Fable 5.2 außerhalb von Startangeboten in der Regel nicht innerhalb der normalen Limits enthalten: Fable wird über Nutzungsguthaben abgerechnet. Opus sollte deshalb als enthaltenes Arbeitstier eingeplant werden, Fable als kostenpflichtige Ausnahme.
Wo Opus 5.5 als Daily Driver überzeugt
Rechercheberichte, die einer Zahlenprüfung standhalten
Der anspruchsvollste Testfall war ein quellenbasierter Bericht zur Unternehmensentwicklung: Die Ergebnisveröffentlichung war absichtlich schwer auffindbar, und jede erfundene Zahl oder jedes erfundene Zitat machte den gesamten Bericht unbrauchbar. Opus 5.5 bestand 16 von 18 Berichten über verschiedene Aufwandsstufen hinweg. Laut Anthropic schafften weder Fable 5.1 noch Opus 5 denselben Maßstab in einem einzigen Versuch (claude.com). Die externe Prüfung von Walleye Capital, ebenfalls in Anthropics Launch-Beitrag erwähnt, ergänzt das Bild: Opus 5.5 löste die Testreihe bei der niedrigsten Aufwandsstufe größtenteils. Bei höherem Aufwand entdeckte es zudem einen Off-by-one-Indexierungsfehler in den Anweisungen des Evaluators selbst – einen Fehler, den laut Walleye kein zuvor getestetes Modell erkannt hatte.
Für den Alltag heißt das: Offene Rechercheaufgaben mit klar definiertem Ergebnis und beigefügten Quellen delegieren – anschließend Zahlen prüfen, nicht nur die Formulierungen.
Analysen mit Tabellen, Deal-Mathematik und dichten Charts
Bei einer fiktiven Fusion zweier HR-Softwareunternehmen erstellten sowohl Opus 5 als auch Opus 5.5 ein Excel-Modell und eine Präsentation für das Management; beide kamen zur gleichen Einschätzung des Deals. Opus 5.5 war nach 63 statt 93 Minuten fertig, kostete laut Bericht 50% weniger in der Erstellung, lieferte ein gründlicheres Modell und machte weniger kleinere Fehler (claude.com). Für Finanz-Workflows insgesamt meldete Hebbia eine Kriterienabdeckung von 86.6% für Opus 5.5 gegenüber 60.3% für Opus 5. Rogo berichtete laut Anthropics Launch-Beitrag, Opus 5 auf High im BigFinance Bench mit rund 60% weniger Output-Tokens übertroffen zu haben.
Auch bei Bildern setzt sich das Muster fort. Anthropic bezeichnet Opus 5.5 als sein bestes Opus-Modell für Vision-Aufgaben: dichte Dokumente, Chart-Werte, Screenshots und Diagramme. Schon auf der niedrigsten Aufwandsstufe soll Opus 5.5 dichte Charts präziser gelesen haben als Opus 5 auf der höchsten (claude.com). Der veröffentlichte Chartography-Wert liegt ohne Tools auf der höchsten bewerteten Stufe bei 64.4% (claude.com), auf der Launch-Scorecard mit Tools bei 89.0%. Beim Elo für professionelle Arbeit in GDPval-AA erreicht Opus 5.5 1846, gegenüber 1735 für Fable 5.1 und 1708 für Opus 5 (anthropic.com).
Praktisch bedeutet das: Die fertige Tabelle oder Präsentation direkt anfordern, Chart-Grafiken anhängen statt Werte abzutippen und das Abbruchkriterium schon in der ersten Nachricht nennen.
Beim Schreiben zählen fertige Dokumente statt Gliederungen
Die Schreibstärke von Opus 5.5 lässt sich nicht pauschal auf „besserer Stil“ reduzieren. Es geht eher um Instruktionstreue und Nachvollziehbarkeit. Anthropic zufolge bleibt das Modell beim Thema, stellt Ergebnisse an den Anfang, verwendet weniger Jargon, folgt vorgegebenen Stilregeln und erklärt, was es gemacht hat, was es herausgefunden hat und welche Eingaben noch fehlen. Die unabhängigen Bewertungen zeigen in dieselbe Richtung: Hayz Labs vergibt für Opus 5.5 jeweils 100 Punkte für Schreiben und Coding sowie 94 für Recherche. Beim Oktober-Check lag es für WebDev und Agenten auf Platz eins, auf Arena bei kreativem Schreiben auf Platz zwei.
Die ehrliche Einschränkung: Einen exakten Hausstil zu treffen, braucht weiterhin Iterationen.
Die Aufwandseinstellung bestimmt den Preis
Opus 5.5 bietet laut eesels Aufschlüsselung der Aufwandsstufen fünf Stufen: Low, Medium, High, Very High/Extra High und Max. Das Thinking lässt sich laut Hayz Labs nicht deaktivieren. Verglichen mit diesem Regler fällt der Einfluss des Tokenpreises auf die Rechnung kaum ins Gewicht.
Die von eesel zusammengefassten Zahlen von Artificial Analysis beziffern dieselbe schwierige Aufgabe auf etwa $0.55 bei Low, $1.34 bei Medium und $5.98 bei Max. Beim Intelligence Index liegen die Werte ungefähr bei 42, 51 beziehungsweise 58. Ein Max-Durchlauf kann in der Größenordnung von 119,000 Output-Tokens erzeugen. Bei $20 pro Million Output-Tokens entsteht dort der wesentliche Kostenblock. Die Pareto-Auswertung von Hayz Labs kommt zu einem ähnlichen Bild: Über 14 Tage betrug der Median pro Agentenaufgabe etwa $1.61 ($1.76 als Median der Haupttabelle), High lag bei rund $1.82.
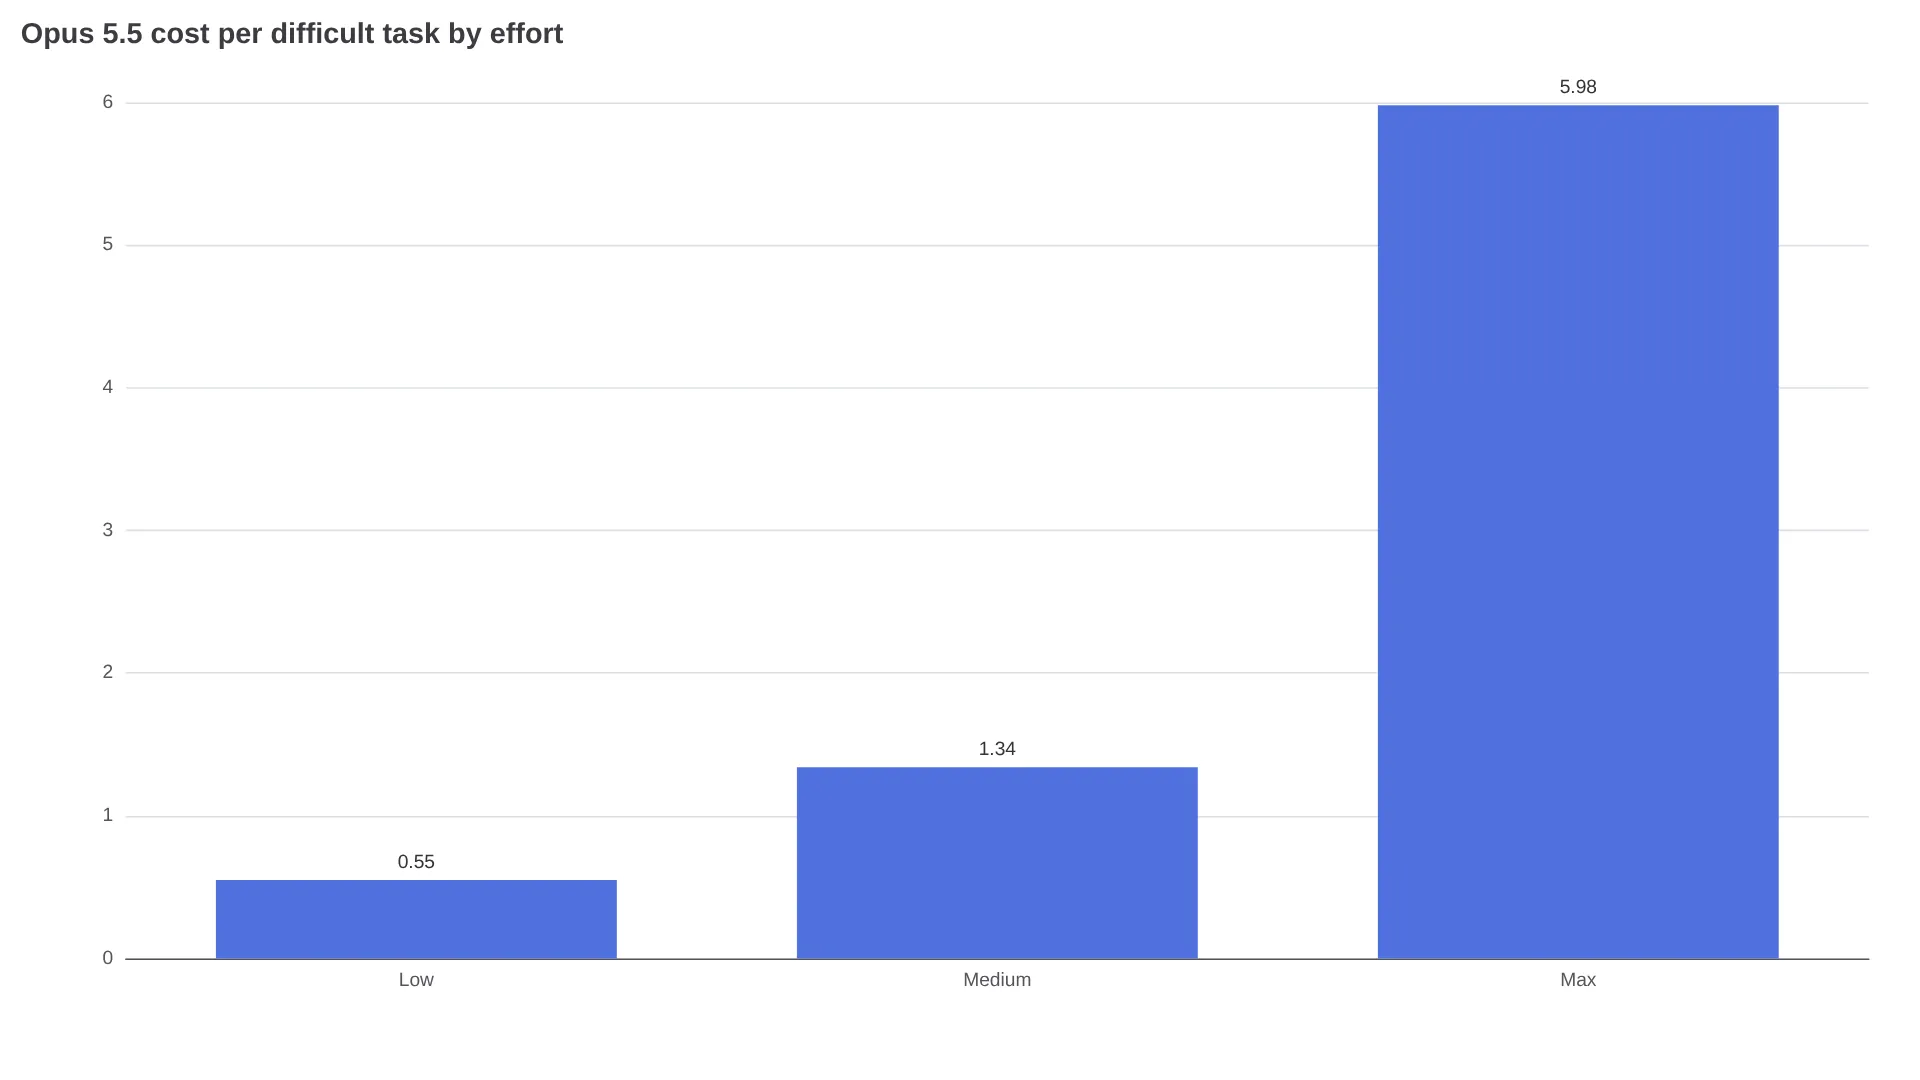
Mehr Aufwand kostet Zeit und Geld, ohne das Ergebnis zwangsläufig zu verbessern. Anthropic rät selbst dazu, Formulierungen wie „think hard“ zu streichen: Das Modell denkt ohnehin mit, während Aufwandsstufe und Aufgabe die Tiefe bestimmen. Erst wenn Medium nachweislich nicht weiterkommt, sollte die nächste Stufe folgen.
Das Kontextfenster umfasst 1 Million Tokens, mit bis zu 128,000 Output-Tokens beziehungsweise 300,000 im Batch-Modus, sowie nativer Bildverarbeitung, wie das Datenblatt von eesel aufführt. Einen Aufpreis für langen Kontext gibt es laut eesels Preisübersicht nicht. Das ist besonders für Workflows zur Prüfung umfangreicher Dokumente relevant.
Die richtige Modellwahl: Opus 5.5, Sonnet 5.5, Haiku 5.5 und Fable 5.2
Anthropics November-Leitfaden und unabhängige Kostenanalysen führen zur selben Regel: Zuerst den Aufwand anpassen, erst danach das Modell wechseln. Die folgenden Preise stammen aus der Preistabelle in Anthropics Daily-Driver-Leitfaden.
| Modell | API-Preis pro 1 Mio. (In/Out) | Geeignet für | Wechseln, wenn |
|---|---|---|---|
| Haiku 5.5 | $0.10 / $0.50 bis 100K Tokens | Schnelle Abfragen, Zusammenfassungen, Sortierung, klar eingegrenzte Aufgaben mit hohem Volumen | Die Analyse umfangreicher wird oder mehr Urteilsvermögen verlangt |
| Sonnet 5.5 | $2 / $10 | Klare, gut abgegrenzte Aufgaben, Feinschliff für Dokumente, Folien auf Basis eines definierten Briefings | Extra High oder Max regelmäßig nötig wird |
| Opus 5.5 | $4 / $20 | Die meisten Recherche- und Analyseaufgaben, Finanzarbeit, fertige Dokumente | Medium auch nach einem ernsthaften zweiten Versuch auf High nicht weiterkommt |
| Fable 5.2 | $8 / $40 | Offene technische Aufgaben, Wissenschaft, Coding und Finanzen mit langfristig arbeitenden Subagent-Teams | Es um normale Wissensarbeit geht – dafür ist es meist überdimensioniert |
Die wichtige Schwelle: Sonnet 5.5 auf Extra High oder Max kann pro Aufgabe fast so viel kosten wie Opus 5.5 und bleibt beim Urteilsvermögen dennoch zurück. Nutzer von Coding-Tarifen beschreiben dieselbe Dynamik auf Aboebene: Sonnet nicht dauerhaft über Medium laufen lassen, sondern die Aufgabe lieber auf Opus 5.5 bei Low verschieben (siehe etwa @cupid25157). Das passt zur offiziellen Leiter „Aufwand vor Modell“ und zur Kostenrechnung je Aufgabe.
Fable markiert die Obergrenze, nicht den direkten Konkurrenten. Im November-Thread zu Fable 5.2 ordnet Anthropic Fable und Mythos den ambitioniertesten offenen technischen Aufgaben zu, während Opus 5.5 für die meisten Coding- und Wissensaufgaben der stärkste Daily Driver sei (@claudeai). Bei Abonnements ist der Unterschied noch deutlicher: Standard-Pro- und Team-Plätze rechnen Fable häufig über Guthaben ab. Der beiläufige Griff zum vermeintlich besseren Modell kann daher direkt eine Guthabenrechnung auslösen.
Quoten schonen: Warum das 5-Stunden-Fenster so schnell leer ist
Offizielle Benchmarks lassen diesen Punkt aus, in Nutzerberichten dominiert er dagegen: Nicht die Leistungsfähigkeit sorgt für Frust, sondern der Quotenverbrauch.
„Die Opus-5.5-Limits werden heute Nacht ZERSTÖRT!! Mehrere Leute berichten, dass die 5-Stunden-Quoten in normalen Sessions bereits nach NUR 15–30 Minuten verbraucht sind. Die Wochenlimits sinken VIEL schneller“ — @TekonBurns, über den Verbrauch in Claude-Code-Sessions
Einige Nutzer erleben die Veränderung als abruptes Ende der Startphase. @kgauravnm schreibt, „die Flitterwochenphase von Claude Opus 5.5 ist offiziell vorbei“, und verweist auf träges Verhalten sowie schnell schwindende Wochenlimits. Berichte von Team-Plätzen wie jener von @ps_ios_dev beschreiben Medium-Nutzung als „rasend“ schnell – selbst nach dem kostenlosen wöchentlichen Reset. Eine wichtige Einschränkung bleibt: Die Analyse eines Claude-Code-Logs mit 67,000 Nachrichten von @sonuv_dev fand bei Tool-Aufrufen, Fehlerraten und Beschwerderaten weitgehend konstante Werte – „im Grunde null Hinweise auf einen Nerf“. Das spricht dafür, dass zumindest ein Teil des Problems aus intensiverer Standardnutzung und teurerem Reasoning resultiert, nicht aus einer heimlichen Verschlechterung. Und an der Leistungsgrenze zählt die Modellwahl: @mohitsharmadl berichtet von einem Fall, in dem Fable 5.2 auf Medium Bugs beseitigte, an denen Opus 5.5 auf High scheiterte. „Opus für alles“ kann also Quote am falschen Limit verschwenden.
Ein Quoten-Playbook, das sowohl die offiziellen Hinweise als auch funktionierende Nutzerpraktiken abbildet:
- Opus 5.5 auf Medium als Standard setzen; High ist eine gezielte Eskalation bei einem diagnostizierten Problem, keine Dauerhaltung.
- Nach Teilaufgaben aufteilen: Haiku für Abruf und Sortierung, Sonnet für klar begrenzte Entwürfe und Feinschliff, Opus für Urteile, Audits und die finale Freigabe.
- Sonnet nicht gewohnheitsmäßig über Medium laufen lassen. Den Kostensprung berücksichtigen und die Aufgabe stattdessen zu Opus auf Low/Medium verschieben.
- Dateien anhängen und Repositories verbinden, statt denselben Kontext wiederholt einzufügen. Langer, erneut gesendeter Kontext erzeugt in jedem Turn zusätzliche Tokens und erhöht damit die gemessene Nutzung.
- Den Rate-Limit-Reset für eine echte Woche mit Deadline aufheben, statt ihn für Experimente zu verbrauchen.
- Fable für die enge Aufgabengruppe reservieren, in der es gewinnt – langfristige, Multi-Agenten- und offene technische Arbeit – und vorher prüfen, ob der Tarif es über Guthaben abrechnet.
FAQ: Die wichtigsten Fragen zum Daily Driver
Ist Claude Opus 5.5 gut genug als Daily Driver?
Ja, für Recherche, Analysen und Textarbeit, bei denen Urteilsvermögen und Prüfbarkeit zählen. Hayz Labs führt es bei Agenten und WebDev auf Platz eins und vergibt Spitzenwerte fürs Schreiben; die von Anthropic zitierten Unternehmensprüfungen weisen in dieselbe Richtung. Für Volumenaufgaben sollte daneben ein günstigeres Modell bereitstehen.
Ist Opus 5.5 für Alltagsaufgaben besser als Sonnet 5.5?
Bei mehrdeutigen oder folgenreichen Aufgaben: ja. Für klare, gut abgegrenzte Aufgaben mit hohem Volumen ist Sonnet auf Low oder Medium schneller – Anthropic bewertet Sonnet als Fast und Opus als Moderate (claude.com) – und der Tokenpreis liegt etwa bei der Hälfte. Der Fehler besteht darin, Sonnet standardmäßig auf Extra High oder Max zu betreiben; damit verschwindet der Preisvorteil.
Wann sollte ich Opus 5.5 statt Fable 5.2 einsetzen?
Opus eignet sich für die meisten Wissensaufgaben und üblichen Coding-Aufgaben. Zu Fable sollte erst bei offenen, langlaufenden oder stark agentischen technischen Projekten eskaliert werden, wenn Opus auf High weiterhin nicht vorankommt. Vorher die Abrechnung des Tarifs prüfen, da Standard-Pro- und Team-Plätze Fable häufig über Guthaben abrechnen.
Funktioniert der Kontext von 1 Million Tokens zuverlässig bei langen Dokumenten?
Für Audit-Aufgaben mit angehängten Dateien ist dies die stärkste Opus-Konfiguration, die Anthropic bisher ausgeliefert hat; dazu gehört auch das Ergebnis von 16 aus 18 quellenbasierten Berichten. Sehr lange Jobs verbrauchen dennoch rasch Aboquote. Daher Abrufaufgaben auf Haiku und Urteilsaufgaben auf Opus verteilen, statt alles im größten Kontext laufen zu lassen.
Der Kompromiss, den man im Blick behalten sollte
Für Wissensarbeit ist Opus 5.5 auf Medium die richtige Standardeinstellung. Offen bleibt, ob die von Nutzern seit Ende Oktober gemeldete Quotenknappheit zum neuen Normalzustand wird. Falls ja, dürfte ein größerer Teil jeder Woche auf Sonnet laufen, als es die Kommunikation zum Start nahelegte.
Weiterführend: Claude Opus 5.5 pricing review, Claude Opus 5.5 High review, Claude Opus 5.5 vs GPT-6.1 Sol.