 AIREITER
Wer Coding-Agenten den ganzen Tag laufen lässt, sollte bei Gemini 4 Hydrogen vs. Claude Sonnet 5.5 vor allem auf zwei Dinge schauen: Hydrogen ist bei einer 50/50-Mischung aus Ein- und Ausgabe rund 25 % günstiger (4,50 statt 6,00 US-Dollar pro Million Tokens). Sonnet 5.5 bringt Terminal- und Computer-Use-Aufgaben jedoch weiterhin öfter ohne manuelle Nachhilfe zu Ende. Weder Preisliste noch Benchmark-Tabelle verraten allein, was ein erfolgreich abgeschlossener Agenten-Task tatsächlich kostet.
Sowohl Gemini 4 Hydrogen als auch Claude Sonnet 5.5 bieten 1 Mio. Tokens Kontext für schnelles Coding und agentische Schleifen. Hydrogen ergänzt das Paket um vier einstellbare Thinking-Stufen.
Was sich beim Wechsel von Sonnet 5.5 zu Hydrogen sofort ändert
Ein Team mit 200 Agenten-Tasks pro Tag merkt den Wechsel an zwei Stellen: auf der Rechnung und bei der nötigen Eingriffsquote. Hydrogen senkt den Tokenpreis und erzeugt in der unabhängigen Geschwindigkeitsstichprobe von LLM Leaderboard rund 198 Tokens pro Sekunde, gegenüber etwa 144 bei Sonnet 5.5. Das passt zum Profil eines „Bulk Executors“: schnelle Entwürfe, paralleles Einlesen von Dateien und zügige Reparaturen.
Sonnet 5.5 ist eher der sorgfältige Fertigsteller. In Googles Launch-Tabelle liegt Sonnet 5.5 bei den drei terminalintensiven und Computer-Use-Benchmarks vorn: Terminal-Bench 4.1, OSWorld 2.1 und Terminal-Bench-Science. Die Details stehen in der folgenden Tabelle. Genau bei solchen Aufgaben entscheidet sich, ob ein Agent nach einem fehlgeschlagenen Befehl wieder auf Kurs kommt oder stecken bleibt.
Eine Reddit-Diskussion aus der Launch-Woche zeigt auf Task-Ebene eine ähnliche Trennung:
„hydrogen ist in Ordnung, aber ehrlich gesagt fühlt es sich nicht besser an als sonnet 5.5.“ — u/FewKey5274 auf r/GeminiAI
Der Thread ist kein kontrollierter Coding-Benchmark. Er taugt daher nur als Warnsignal: Einzelerfolge bei isolierten Aufgaben sagen wenig über die End-to-End-Leistung in einem Harness aus. Vor einer Migration sollten beide Modelle im identischen Workflow getestet werden.
4,50 vs. 6,00 US-Dollar: Die Mischkosten sind nur der Anfang
Die offiziellen API-Preise sind klar. Laut Googles Ankündigung kostet Hydrogen 1,50 US-Dollar pro Million Input-Tokens und 7,50 US-Dollar pro Million Output-Tokens – einheitlich über das gesamte Kontextfenster. Sonnet 5.5 kostet laut Anthropics Preisübersicht und dem direkten Vergleich von OpenRouter 2,00 US-Dollar für eine Million Input-Tokens sowie 10,00 US-Dollar für eine Million Output-Tokens.
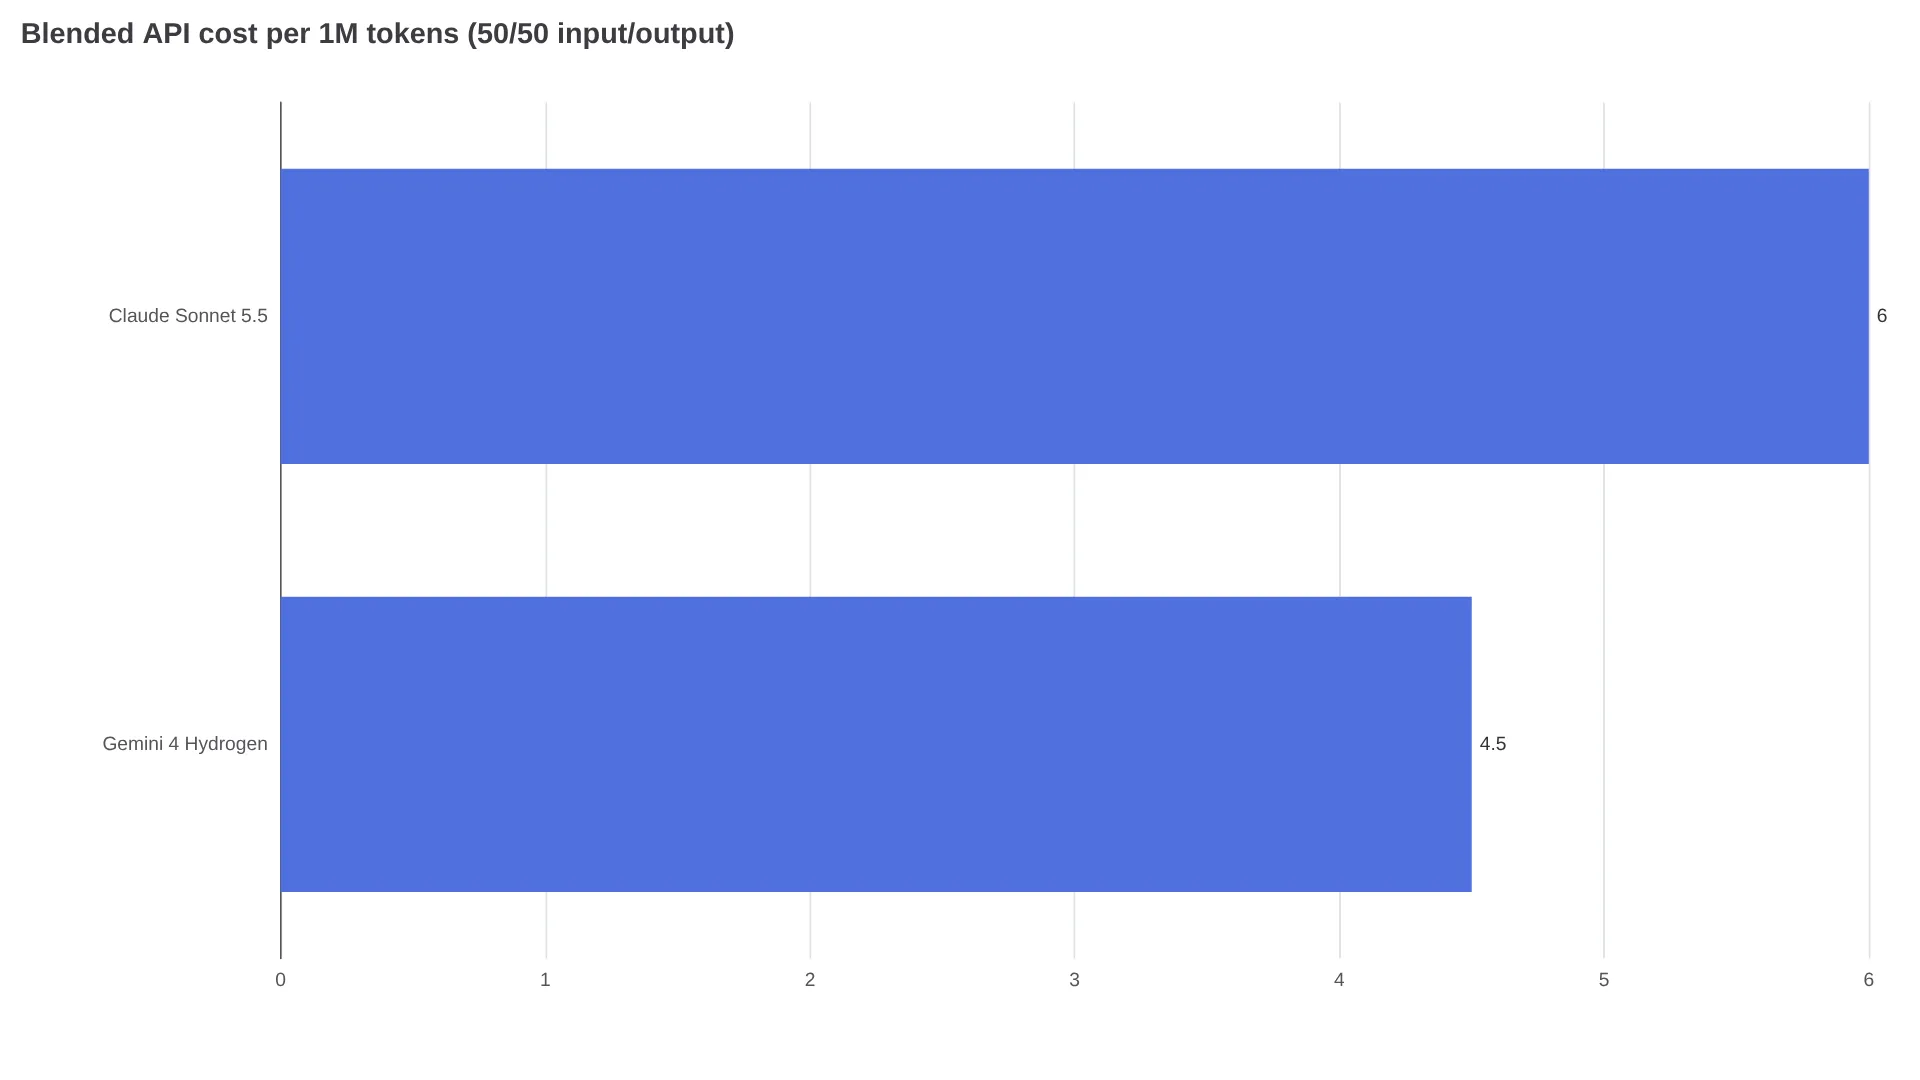
Bei einer 50/50-Rechnung – 500.000 Input- plus 500.000 Output-Tokens – landet Hydrogen bei 4,50 US-Dollar pro Million, Sonnet 5.5 bei 6,00 US-Dollar. Der Abstand von 25 % ist real. Ob er in der Praxis bleibt, hängt aber von drei Punkten ab:
- Output-lastige Agenten vergrößern den Abstand. Agentische Schleifen mit langen Reasoning-Traces erzeugen überproportional viel Output. Dann wirkt Hydrogens Preisvorteil von 2,50 US-Dollar pro Million Output-Tokens am stärksten.
- Cache- und Batch-Tarife sind nicht eingerechnet. Prompt-Cache-Lesezugriffe und Batch-API-Rabatte von Anthropic können die tatsächliche Rechnung um mehrere Prozent verschieben. LLM Leaderboard weist darauf hin, dass explizites Caching in seiner Hydrogen-Geschwindigkeitsstichprobe nicht unterstützt wurde.
- Ein Rechenbeispiel macht die Größenordnung greifbar. Bei 1.000 Agenten-Turns am Tag mit durchschnittlich 10.000 Input- und 3.000 Output-Tokens fallen 10 Mio. Input- plus 3 Mio. Output-Tokens an: zu Listenpreisen ungefähr 37,50 US-Dollar pro Tag mit Hydrogen und 50,00 US-Dollar mit Sonnet 5.5. Über 22 Arbeitstage ergibt das vor Wiederholungsversuchen rund 275 US-Dollar Unterschied pro gleichzeitig laufendem Agenten.
Wiederholungsversuche bestimmen den tatsächlichen Sieger. Die Kosten pro erledigtem Task ergeben sich aus den Tokenkosten pro Versuch geteilt durch die Erfolgsquote – zuzüglich menschlicher Nacharbeit. Rein als Illustration: Ein Hydrogen-Tag für 37,50 US-Dollar bei einer First-Pass-Rate von 80 % kostet bei 1.000 abgeschlossenen Tasks allein an Tokens etwa 46,90 US-Dollar; ein Sonnet-Tag für 50,00 US-Dollar bei 95 % liegt bei rund 52,60 US-Dollar. Sobald sich die Erfolgsquoten unterscheiden, schrumpft der Abstand schnell. Sinnvoller als jede Hersteller-Tabelle ist daher, zwei Wochen lang die First-Pass-Merge-Rate zu messen.
Die Benchmarks trennen nach Aufgaben, nicht nach Gesamtsieger
Die Launch-Tabelle von Google, die auch in der DeepMind Model Card steht, vergleicht Hydrogen, Sonnet 5.5 und GPT-6.1 Terra in zehn Evaluierungen. Gegen Sonnet 5.5 führt Hydrogen in sieben davon, Sonnet 5.5 in den übrigen drei. Die Herstellerzeilen nutzen jeweils den eigenen Harness; die unabhängigen Zeilen stammen aus Wiederholungsläufen von LLM Leaderboard.
| Aufgabenbereich | Benchmark | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|---|
| Repository-Coding | SWE-sweep (Hersteller) | 13.5% | 3.1% |
| Repository-Coding | Terminal-Bench 4.1, cheating-adjusted (Hersteller) | 57.0% | 63.9% |
| Wissensautomatisierung | Agents' Last Exam v1.1 (Hersteller, harness-sensitiv) | 71.6% | 60.4% |
| Wissensautomatisierung | AutomationBench-AA (Hersteller) | 76.1% | 71.8% |
| Wissensautomatisierung | Vending-Bench 2 final balance (Hersteller) | $14,549 | $11,165 |
| Computer Use | OSWorld 2.1 Offline-Teilmenge (Hersteller) | 77.6% | 83.9% |
| Multimodal | MKA Climb WSR (Hersteller; unabhängig 49.52%) | 53.4% | 52.0% |
| Multimodal | Chartography (gemischte Herkunft) | 66.6% | 61.6% |
| Wissenschaft | Terminal-Bench-Science 0.1 (Hersteller; unabhängig 49.52%) | 51.4% | 59.9% |
| Reasoning | HLE-Diamond (unabhängig xhigh) | 58.8% | 53.3% |
Bei Tool-Calls entscheidet sich, ob ein Agent funktioniert
Benchmarks bewerten Antworten. Agenten stehen und fallen aber mit Tool-Calls: Dateien gebündelt lesen, die passende Funktion aufrufen und sich fangen, wenn eine Suche nichts liefert oder ein Befehl fehlschlägt.
Google zufolge bündelt Hydrogen Datei-Lesevorgänge und Suchen parallel, statt Dateien nacheinander zu prüfen. Außerdem soll das Modell gezielte Änderungen in Repositories vornehmen, ohne unbeteiligte Dateien umzuschreiben. Partnerberichte im Launch-Beitrag nennen für Graph- und SQL-Aufgaben eine 2- bis 2,8-mal schnellere Bearbeitung bei 12 % bis 23 % weniger Tokens als Gemini 3.8 Flash sowie eine 2,5-mal schnellere Fertigstellung bei standardmäßig hohem Reasoning. Das sind von Google ausgewählte Partnerzahlen: ein Hinweis auf die Richtung, keine Garantie.
Die Gegenseite ist die Reife des Harnesses. Im Thread zu Claude Code vs. Antigravity berichten Nutzer von Uptime-Problemen bei Antigravity und fehlenden Workflow-Bausteinen wie SSH, wiederverwendbaren Hooks, Skills und Subagents. Das sind Eindrücke aus der Launch-Woche, keine kontrollierte Messung; zudem betreffen sie den Harness, nicht die Modellgewichte.
Vor dem Umzug eines Produktivagenten sollten drei Dinge geprüft werden: die Zuverlässigkeit paralleler Tool-Calls bei der eigenen Anzahl an MCP-Servern, die Recovery-Rate nach einem fehlgeschlagenen Bash- oder Browser-Schritt sowie das Verhalten an Berechtigungsgrenzen. Googles interne Prüfungen sprechen von bis zu 81 % weniger agentischer Grenzüberschreitung, 79 % weniger Untererfüllung und 96.7% Ehrlichkeit in der eigenen Agent-Honesty-Evaluierung. Das sollte mit einem eigenen Canary-Test aus 50 Tasks mit blockierten Aktionen und Sackgassen bei der Suche überprüft werden.
Thinking-Stufen: High als Standard, xhigh gezielt einsetzen
Hydrogen bietet die Stufen low, medium, high und xhigh; standardmäßig ist high aktiv. Laut Googles Tabelle zu den Thinking-Stufen steigt der Artificial Analysis Intelligence Index v5.0.1 von 27 über 41 und 51 auf 54, wenn es von low zu xhigh geht. Das Standardniveau high mit 51 liegt knapp vor Argon mit 50. In derselben Tabelle erreicht high bei Terminal-Bench 4.0 54.0% und übertrifft damit xhigh mit 53.5%; bei AutomationBench-AA (60.5% bis 76.1%) und HLE-Diamond (32.2% bis 58.8%) steigen die Werte dagegen kontinuierlich.
Für Agenten-Schleifen gilt daher: mit high starten und einzelne Tasks nur dann auf xhigh anheben, wenn Reasoning den Engpass darstellt – etwa bei Analyse, Synthese oder Recherche über mehrere Dokumente. Danach sollte der zusätzliche Tokenverbrauch kontrolliert werden. Laut DeepMind Model Card kann Hydrogen auf höheren Thinking-Stufen mehr Tokens verbrauchen. Der Wissensstand endet zudem im März 2026; bei aktualitätssensiblen Aufgaben braucht es daher in jedem Fall Retrieval.
Vor der Migration zählt der Harness-Test
Laut DeepMind Model Card bietet Hydrogen 1.048.576 Tokens Kontext und bis zu 64K synchronen Output; über Background Long Decode sind bis zu 1 Mio. möglich. Nach Anthropics Dokumentation bietet Sonnet 5.5 1 Mio. Input-Tokens und bis zu 128K Output-Tokens. Die Fenster wirken auf dem Papier gleich groß, doch für große Codebasen entscheidet die Kompaktierung: Relevant ist, wie viel nach 50 Turns noch erhalten bleibt, nicht allein die Datenblattangabe.
| Gemini 4 Hydrogen | Claude Sonnet 5.5 | |
|---|---|---|
| Kontext / Output-Limit | 1,048,576 Tokens Input; 64K synchroner Output (1M Background Decode) | 1,000,000 Tokens Input; 128K Output |
| Verfügbare Plattformen | Gemini API, AI Studio, Antigravity, Gemini app, laut Google | Claude API, Bedrock, Vertex AI, Microsoft Foundry, laut Anthropic |
Der Thread zu Antigravity vs. Claude Code legt nahe, dass die Stabilität des Harnesses für eine Migration wichtiger sein kann als die reine Modellqualität: Nutzer hinterfragen die Haltbarkeit der Kompaktierung, die Persistenz von Quoten und die Uptime. Deshalb sollten in beiden Harnesses dasselbe Repository, derselbe Commit, derselbe Prompt und dieselben Acceptance-Tests laufen. Anschließend zählen abgeschlossene Tasks pro Subscription-Fenster und die First-Pass-Merge-Rate.
Entscheidung in 60 Sekunden: drei Agentenprofile
Es gibt keinen Gesamtsieger für jeden Agenten. Als redaktionelle Einordnung aus der oben gezeigten Benchmark-Aufteilung – nicht als gemessener Praxistest – gilt: Parallele, repetitive Ausführung passt besser zu Hydrogen; recovery-sensitive Aufgaben mit langem Horizont eher zu Sonnet 5.5. Planner-Executor-Paare eines Anbieters halten Authentifizierung und Kompaktierung konsistent. Einen Claude-Planer mit einem Hydrogen-Worker zu kombinieren, lohnt sich erst nach einer Messung der Single-Vendor-Basislinie.
| Ihr Agent | Empfehlung | Warum (Evidenzniveau) |
|---|---|---|
| Executor mit hohem Durchsatz: Massenreparaturen, Boilerplate, Datenaufbereitung, multimodale Triage | Hydrogen auf high | Vorsprung in Hersteller-Benchmarks bei AutomationBench, Agents' Last Exam und Vending-Bench; unabhängige Geschwindigkeitsstichprobe mit ca. 198 statt ca. 144 Tok./s |
| Fertigsteller für lange Abläufe: terminalintensives Debugging, OS-/Browser-Automatisierung, wissenschaftliche Tools | Sonnet 5.5 | Vorsprung in Hersteller-Benchmarks bei Terminal-Bench 4.1, OSWorld 2.1 und Terminal-Bench-Science; Einschätzung des Ökosystems zu Claude-Code-Hooks und Subagents |
| Research-Synthesizer: lange Dokumente, Charts, Audio/Video, Sheets-intensive Analyse | Hydrogen auf high, xhigh für die schwierigsten Durchläufe | Hersteller-Vorsprung bei HLE-Diamond, Chartography und MKA; mit dem Vorbehalt, dass der unabhängige MKA-Wiederholungslauf mit 49.52% niedriger ausfiel |
Ist Hydrogen tatsächlich schneller als Sonnet 5.5?
Beim Durchsatz liegt Hydrogen in der Stichprobe von LLM Leaderboard vorn, mit etwa 198 gegenüber 144 Tokens pro Sekunde. Der Live-p50-Feed von OpenRouter sieht Sonnet 5.5 bei der Latenz dagegen vorne: 2.08s gegenüber 6.92s im Median. Da sich Provider, Region und Auslastung unterscheiden, sollten beide Modelle beim eigenen Provider gemessen werden.
Kann Hydrogen Sonnet 5.5 innerhalb von Claude Code ersetzen?
Nicht durch den bloßen Austausch einer Model-ID. Sonnet 5.5 läuft nativ in Claude Code, wo Teams auf Hooks, Skills und Subagents setzen. Hydrogen läuft über die Gemini API, AI Studio, Antigravity und die Gemini app. Ein Ersatz bedeutet daher eine Migration des Harnesses.