 AIREITER
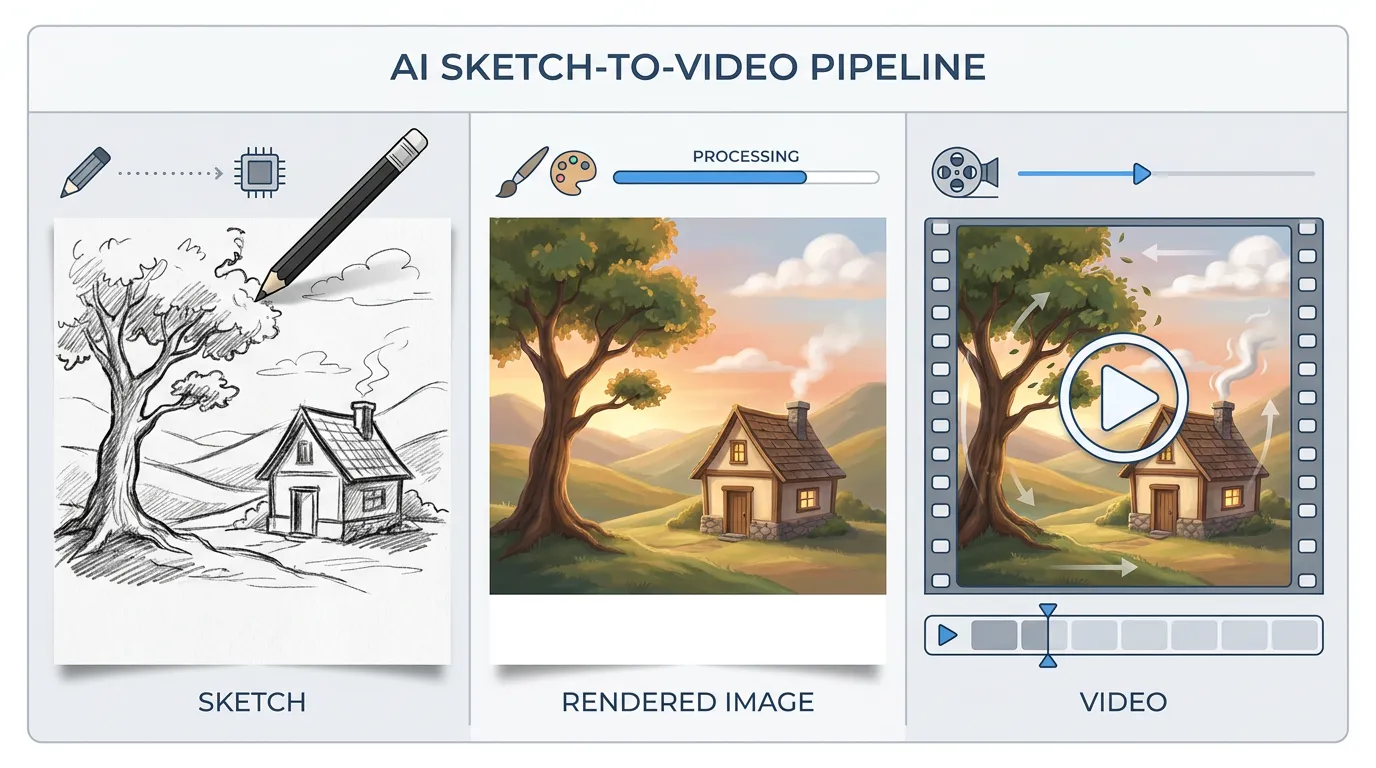
大多数草图转视频工具,内部其实都在做同一件事:先把你的草图渲染成一张完整的静态图,再让这张图动起来。与其把草图直接丢进一个看不见过程的黑箱,不如自己掌控这两步。这样你才能决定,最终画面究竟是忠实于原稿,还是变成了 AI 自行发挥后的版本。
Sketch to Video AI 到底是什么
Sketch to Video AI 可以把手绘草图、线框图或分镜稿转换成动画片段,甚至是完整渲染的视频。草图负责构图和空间布局,AI 则补上纹理、光照、色彩与运动。只要物体在画面中的位置关系足够清楚,即使只是粗略的火柴人,也不一定比精致插画效果差。因为 AI 读取的是结构——画面里各个元素分别在哪里——而不是绘画水平。
所谓“草图转视频”,并不存在一个单独的万能模型。Adobe Firefly 的教程明确展示了三个阶段:上传草图,Firefly 根据草图生成一张渲染后的静态图,再把这张图制作成 5 秒视频。Higgsfield 的 Sketch-to-Video 功能由 Sora 2 驱动,把这套流程隐藏在 Realistic、Cinematic、Anime、Commercial、Horror 五个预设按钮后面。虽然用户看不到中间步骤,但内部依然是先渲染、后动画。自己拆开这两步——先把草图调整成干净的静态图,再交给视频模型——就能在中间环节检查画面、修改内容并重新提示词。大多数质量问题,其实都应该在这里解决。
两种做法:一键工具,还是自己搭流程
实际选择很简单:要么使用打包好的一键工具,要么自己搭建图像到视频的生成链路。
一键工具——Higgsfield Sketch-to-Video、Dreamina 的 sketch-to-video 工具、sketchtovideoai.com,以及 Seedance 的 storyboard-to-video 页面——可以直接读取你的草图,通常连文字提示词都不要求,最后输出成片。它们速度快,对使用者的专业要求也最低。Higgsfield 支持 1080p 输出,可选 16:9 或 9:16,底层使用 Sora 2,还能仅凭线稿推断运动。代价是,你无法查看或修改中间的渲染图,能调整的内容也基本限于工具提供的预设。
自己搭流程,则是先选择一个图像模型,把草图渲染出来并检查结果,再用另一个视频模型为静态图添加动画。Reddit 上的社区工作流经常采用这种方式:创作者先画草图,用 AI 完成风格化渲染和初始网格,最后再手动收尾。
“AI 帮我加快了把这张草图变成生动画面的过程。”——u/Snoo-73452,r/2D3DAI
可以按这个规则判断:如果你需要在动画生成前确认渲染后的构图,就选分步流程;如果速度比精细控制更重要,就用一键工具。
完整流程:从纸上草图到动画片段
先把草图准备好
AI 识别的是空间结构,而不是画得好不好。下面三点,决定了草图输出是否可控:
- 拉开空间层次。处于不同景深的物体,最好在视觉上彼此区分。位置相同、互相重叠的线条很容易被理解成一个扁平形状,最终产生不可信的空间感。
- 明确主体。主体应当通过线条粗细或密度,与背景拉开差异。如果焦点和周围环境混在一起,模型就很难判断究竟该让什么动起来。
- 线条干净、对比度高。数字草图通常比纸上草图的照片更适合上传,因为前者包含的视觉噪声更少。如果只能拍摄纸上草图,应将纸张平放,在光线均匀的环境下拍摄,尽量紧凑裁剪,并在上传前提高对比度。
第 1 步:把草图变成渲染图
第一步生成的是一张完整的静态图。你需要把草图和文字提示词一起交给模型,说明线条代表什么,以及最终画面应该呈现怎样的风格。一个实用的提示词公式是:
“[主体],[视觉风格],[光照],[草图无法表达的具体细节]”
比如,一张粗略的房间草图可以写成:“一间中世纪现代风格的客厅,温暖的自然光,照片级真实感,左侧有一张木桌,桌上放着笔记本电脑和咖啡杯。”
支持同时接收参考图和文字的图像模型——包括 Nano Banana Pro、Seedream 5 Pro 和 GPT Image 2——可以参考草图构图,同时完成细节渲染。Adobe Firefly 的图像模型也能在其集成流程中完成同样的工作。这里最重要的一点是:动画之前,先检查渲染图。如果构图发生偏移、光照不对,或者模型凭空添加了你不需要的细节,应当在这一阶段修改提示词。相比重新生成整段视频,这样快得多。
第 2 步:让渲染图动起来
拿到干净的渲染图后,把它交给图生视频模型,并配上运动提示词。此时要明确描述画面怎么动:比如镜头运动可以写“从左侧缓慢推进”,主体运动可以写“女人转头并露出微笑”,环境运动则可以写“窗帘被微风吹动,光束中有尘埃颗粒飘浮”。
这一步值得尝试的图生视频模型包括 Kling 3.0、Seedance 2.5、Veo 3.1 和 Runway Gen-4。VidAU 的指南认为,这是最容易被忽视的技巧之一:很多人完全跳过文字提示词,直接让模型猜测该怎么运动。具体的运动提示词应写清镜头移动方式、速度,以及哪些元素保持静止、哪些元素需要运动。这样得到的才是有意图的导演调度,而不是随机生成的瑕疵。
第 3 步:检查、修正,再串联镜头
每段生成的视频,都应该检查以下四点:
- 运动是否自然。动作是否符合场景类型?建筑漫游应当缓慢平滑;社交媒体短片则需要在第一秒就有足够的动感。
- 构图是否保持一致。视频的取景是否偏离了渲染图?模型有时会意外裁剪或重新构图。
- 结构是否稳定。重点留意闪烁、几何形变、四肢在不同帧之间变形,以及线条粗细在片段中途发生变化。这些都是草图生成视频的典型失败模式,通常源于输入草图含义不够明确。解决方法在上游:输入更干净、空间区分更清楚,下游就会少很多瑕疵。如果变形仍然存在,可以降低运动强度,或缩短片段时长。运动越多、片段越长,模型出错的空间就越大。
- 速度是否合适。竖屏社交视频如果慢得拖沓,电影感的建立镜头如果快得失控,通常说明提示词与目标平台的观看场景不匹配。
制作多镜头序列时,最好为每个镜头分别生成一张渲染图,不要试图一次生成一段很长的视频。Seedance 和 Higgsfield 都支持控制转场使用的起始帧与结束帧,有助于保持不同分镜之间的连续性。
各工具的价格
价格会根据模型、分辨率和片段时长而变化。以下数据来自官方定价页面和已核实的指南,统计截至 2026 年 8 月。
| 工具 | 入门方案 | 每段 5 秒视频 | 适合场景 |
|---|---|---|---|
| Runway Gen-4 | $12/月,625 积分 | 60 积分(Gen-4)或 25 积分(Turbo) | 电影感 B-roll、建立镜头 |
| Adobe Firefly | $9.99/月,2,000 积分 | 100 积分(540p)至 500 积分(1080p) | 集成式草图到图像再到视频工作流 |
| Kling AI | $6.99/月,660 积分 | 每段 5 秒约 10–25 积分 | 动态动作场景 |
| Higgsfield | 每月 $9 起(取决于地区) | 按积分计费,因模型而异 | 无需提示词的一键草图动画 |
| Seedance 2.5 | 通过 API 平台按片段付费 | 720p、5 秒约 $0.48 | 依靠参考图保持不同片段的一致性 |
从各家的费率表来看,有两个数字值得特别留意。Runway 的 API 价格是每积分 $0.01,因此生成一段 5 秒的 Gen-4 Turbo 视频约需 $0.25。Firefly 标准方案可以生成 20 段 540p 的 5 秒视频,但 1080p 下只有 4 段。Kling 的免费方案每 24 小时提供 66 积分(带水印、不可商用);Standard 方案则根据画质设置,大约可以覆盖 26 到 66 段视频。
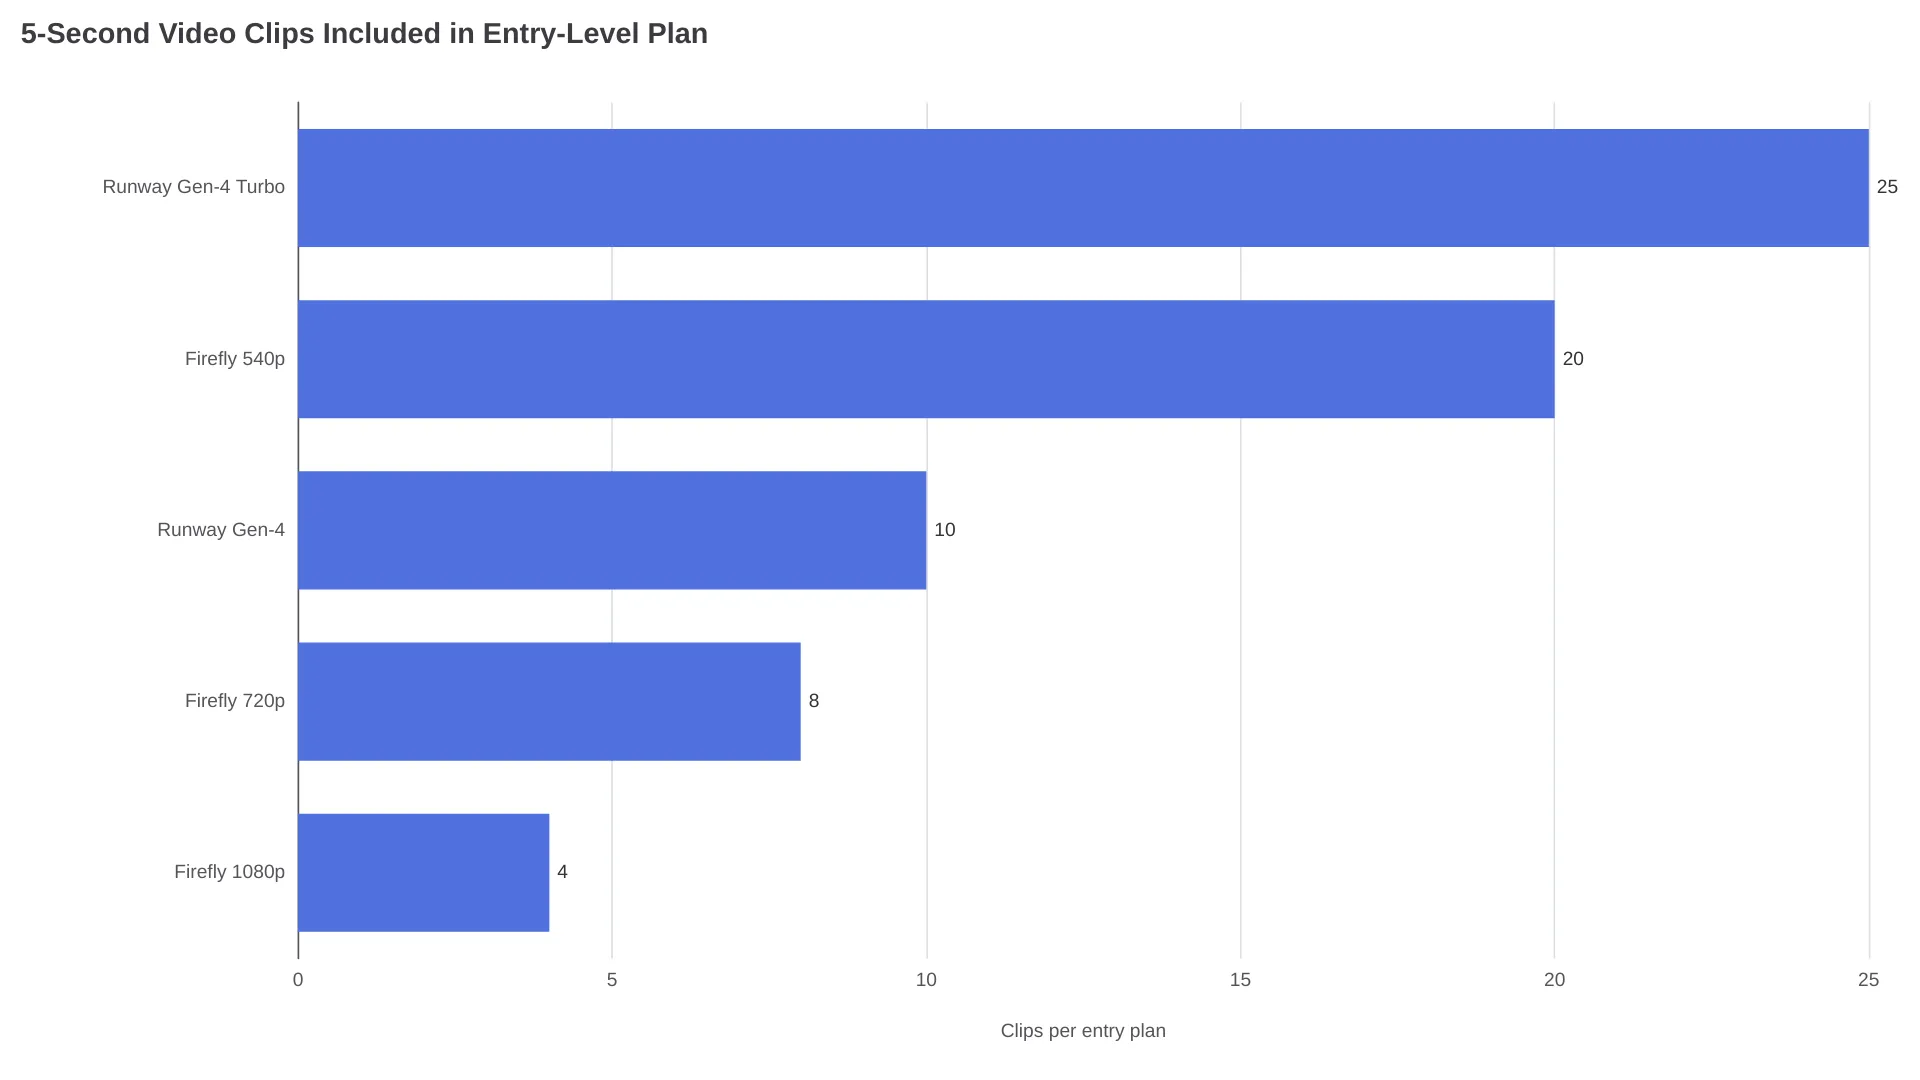
如果需要围绕同一张草图反复迭代,Runway Gen-4 Turbo 或 540p 的 Firefly 更节省积分。如果只制作少量高质量 1080p 视频,Firefly 1080p 或 Runway Gen-4(非 Turbo)每段的成片质量更精致。
如何保留原始画风
草图转视频最常见的抱怨,就是成片看起来不像原来的画。模型往往是在重新诠释,而不是单纯渲染:铅笔草图可能变成照片级真实场景,线稿角色也可能被加上作者从未设想过的阴影和色彩。究竟这是优点还是问题,取决于你的目标。
如果想保留手绘感或线稿风格,要在图像模型的提示词里明确写出来。例如加入“保留原始线稿风格、少量阴影、扁平插画”等描述,可以让渲染结果更贴近原稿。如果你在本地使用 ControlNet,那么 lineart 或 scribble ControlNet 模块就是更精确的选择:它会将模型限制在原有边缘图上,避免模型自行发明新的结构。
如果要让多个片段中的角色保持一致,应把第 1 步生成的渲染图作为参考图,用于之后的每一次生成。Seedance 2.5 的 reference-first architecture 就是为此设计的:它把输入图像当作角色锚点,在此基础上生成运动,而不是每次都重新想象主体。没有参考帧时,模型每次运行都会重新解释角色,脸部、服装和身体比例都可能逐渐漂移。
免费方案:用 ComfyUI 搭配 ControlNet
如果你有性能足够的 GPU,又不想支付订阅费用,整套流程可以在本地免费运行。r/StableDiffusion 社区测试过的一套 ComfyUI 工作流,就把多个开源模型串联了起来:
- ControlNet(lineart 或 scribble 模块)将生成结果锁定在草图边缘上,避免结构发生漂移。
- Flux 或 Stable Diffusion checkpoint结合文字提示词指定的风格,把草图渲染成完整图像。
- Wan 或 AnimateDiff将渲染后的静态图制作成短视频。
代价是配置时间和硬件要求。ControlNet、Flux 加上视频扩散模型,通常需要约 16 GB 显存才能较舒适地跑完整流程,但具体需求会随模型、分辨率和量化方式变化。在消费级硬件上,生成一段 5 秒视频可能需要几分钟,而云端基础设施只需几秒。这个方案可以避开平台水印;至于能否商用,则取决于你安装的具体模型和 checkpoint 的许可证,而不是某个平台的服务条款。
你的草图适合哪条路线
| 你的情况 | 推荐路线 | 原因 |
|---|---|---|
| 快速构思、社交媒体短片、一次性尝试 | 一键工具(Higgsfield、Dreamina) | 无需提示词,预设会自动完成整套流程 |
| 客户提案或预演,必须保持构图一致 | 云端流程(图像模型 → 视频模型) | 可以先检查并修正渲染图,再生成动画 |
| 预算有限、需要大量迭代,并且熟悉本地工具 | ComfyUI + ControlNet + Wan/AnimateDiff | 免费、控制力最大,也没有平台水印 |
| 需要让角色在多个片段中保持一致 | 搭配参考帧模型的流程(Seedance) | reference-first 架构可以避免身份漂移 |
| 包含多个镜头的粗略分镜 | 支持起始帧/结束帧控制的流程 | 分别管理每个镜头,转场更干净 |
常见问题
有没有免费的 sketch to video AI?
Kling AI 每 24 小时提供 66 积分(带水印、不可商用)。Higgsfield 和 Dreamina 也支持一定程度的免费创作。如果想不受限制地免费使用,可以在本地搭建包含 ControlNet 和 AnimateDiff 的 ComfyUI 流程;不过这需要性能足够的 GPU。
粗略的火柴人草图也能用吗?
可以,前提是元素之间的空间位置关系足够清楚。AI 读取的是构图而非绘画水平:物体彼此之间怎么摆放,比它们画得是否精细更重要。
草图转视频和图生视频有什么区别?
图生视频是让一张已经完成的照片动起来;草图转视频则从原始手绘输入开始,同时生成画面和运动。实际使用中,大多数工具仍然会先渲染草图,再为渲染图添加动画。因此,两者使用的动画引擎可能相同,区别主要在于起点不同。
哪个模型最能保留我的原始画稿?
如果在本地运行,ControlNet 的 lineart 或 scribble 模块能提供最严格的结构锁定。在云端工具中,Seedance 2.5 这类 reference-first 视频模型会以输入图为动画锚点,最大限度减少重新诠释。
生成的视频最长能有多长?
大多数图生视频模型每次生成的片段时长为 5 到 10 秒。需要更长的序列时,应该准备好生成并剪辑多个短片段,而不是依赖一次长时生成。起始帧和结束帧控制有助于维持片段之间的连续性。