 AIREITER
到了 2026 年 8 月,Qwen 3.8 和 Kimi K3 已经不是简单的“谁更强”问题:两家都开放了权重下载,旗舰模型也都已正式可用,但适合的部署路径截然不同。Kimi K3 保持着目前最强的已验证智能体编程成绩;Qwen 3.8 Max 在 Token 价格上更有优势;而 Qwen 的 Apache-2.0 27B 模型,一张消费级 GPU 就能运行。Kimi 的关键限制在于:其“开放”旗舰据称是一个 1.56 TB 的检查点,开放权重不等于能轻松自行部署。
两家这次究竟发布了什么
Kimi K3(Moonshot AI)于 2026 年 7 月 16 日推出,产品线只有一款旗舰:总参数量 2.8 万亿的 MoE 模型,每个 Token 激活 104B 参数,采用 Kimi Delta Attention 和 Gated MLA,支持 1,048,576 Token 上下文及原生视觉能力。权重和技术报告随后在 7 月 27 日发布,使用定制的 Kimi K3 License;Emergent 的对比汇总指出,该许可对大规模商业转售商以及月活超过 1 亿的产品附加了条件。
阿里的应对方式不是单一模型,而是一整个家族。Qwen 3.8 Max 于 7 月 19 日预览,8 月 3 日在 QwenCloud 正式上线,规格为 2.4T 总参数 / 约 95B 激活参数;约在 8 月 12 日,其权重以 Qwen/Qwen3.8-2.4T-A95B 的形式登陆 Hugging Face,采用定制的 qwen3.8-max 许可证。数日后,Qwen/Qwen3.8-27B 随之发布:这是一个采用 Apache-2.0 的 27B 稠密视觉语言模型,原生支持 262K 上下文,可借助 YaRN 扩展到 1M(Yotta Labs 将其日期标为 8 月 13 日至 14 日)。
| Kimi K3 | Qwen 3.8 Max | Qwen3.8-27B | |
|---|---|---|---|
| 总参数 / 激活参数 | 2.8T / 104B | 2.4T / ~95B | 27B 稠密模型 |
| 上下文 | 1,048,576 | 1M(最大输入 991.8K) | 原生 262K,通过 YaRN 达到 1M |
| 许可证 | Kimi K3 License(定制) | 定制 qwen3.8-max 许可证 | Apache-2.0 |
| 权重上线时间 | 2026 年 7 月 27 日 | 约 2026 年 8 月 12 日 | 约 2026 年 8 月 13 日至 14 日 |
| 视觉输入 | 文本 + 图片(正式支持) | 通过 API 支持文本、图片、视频 | 文本、图片、视频 |
另一个供应商层面的风险也值得关注:有报道指出,Moonshot 在 K3 发布后 48 小时内暂停接受新的消费者订阅,原因是需求超过了 GPU 容量。若要把产品押注在单一服务商上,这一点不能忽略。
看基准分数,先分清是谁测的
两家厂商都给出了亮眼的基准测试表,但测试框架并不统一。Kimi 自己的模型卡也明确标注:竞品分数来自不同的智能体测试框架,部分项目使用的是 H20 而非 H100 硬件。因此,下方共有项目的数据应视为厂商自报,而不是经过审计的结果。
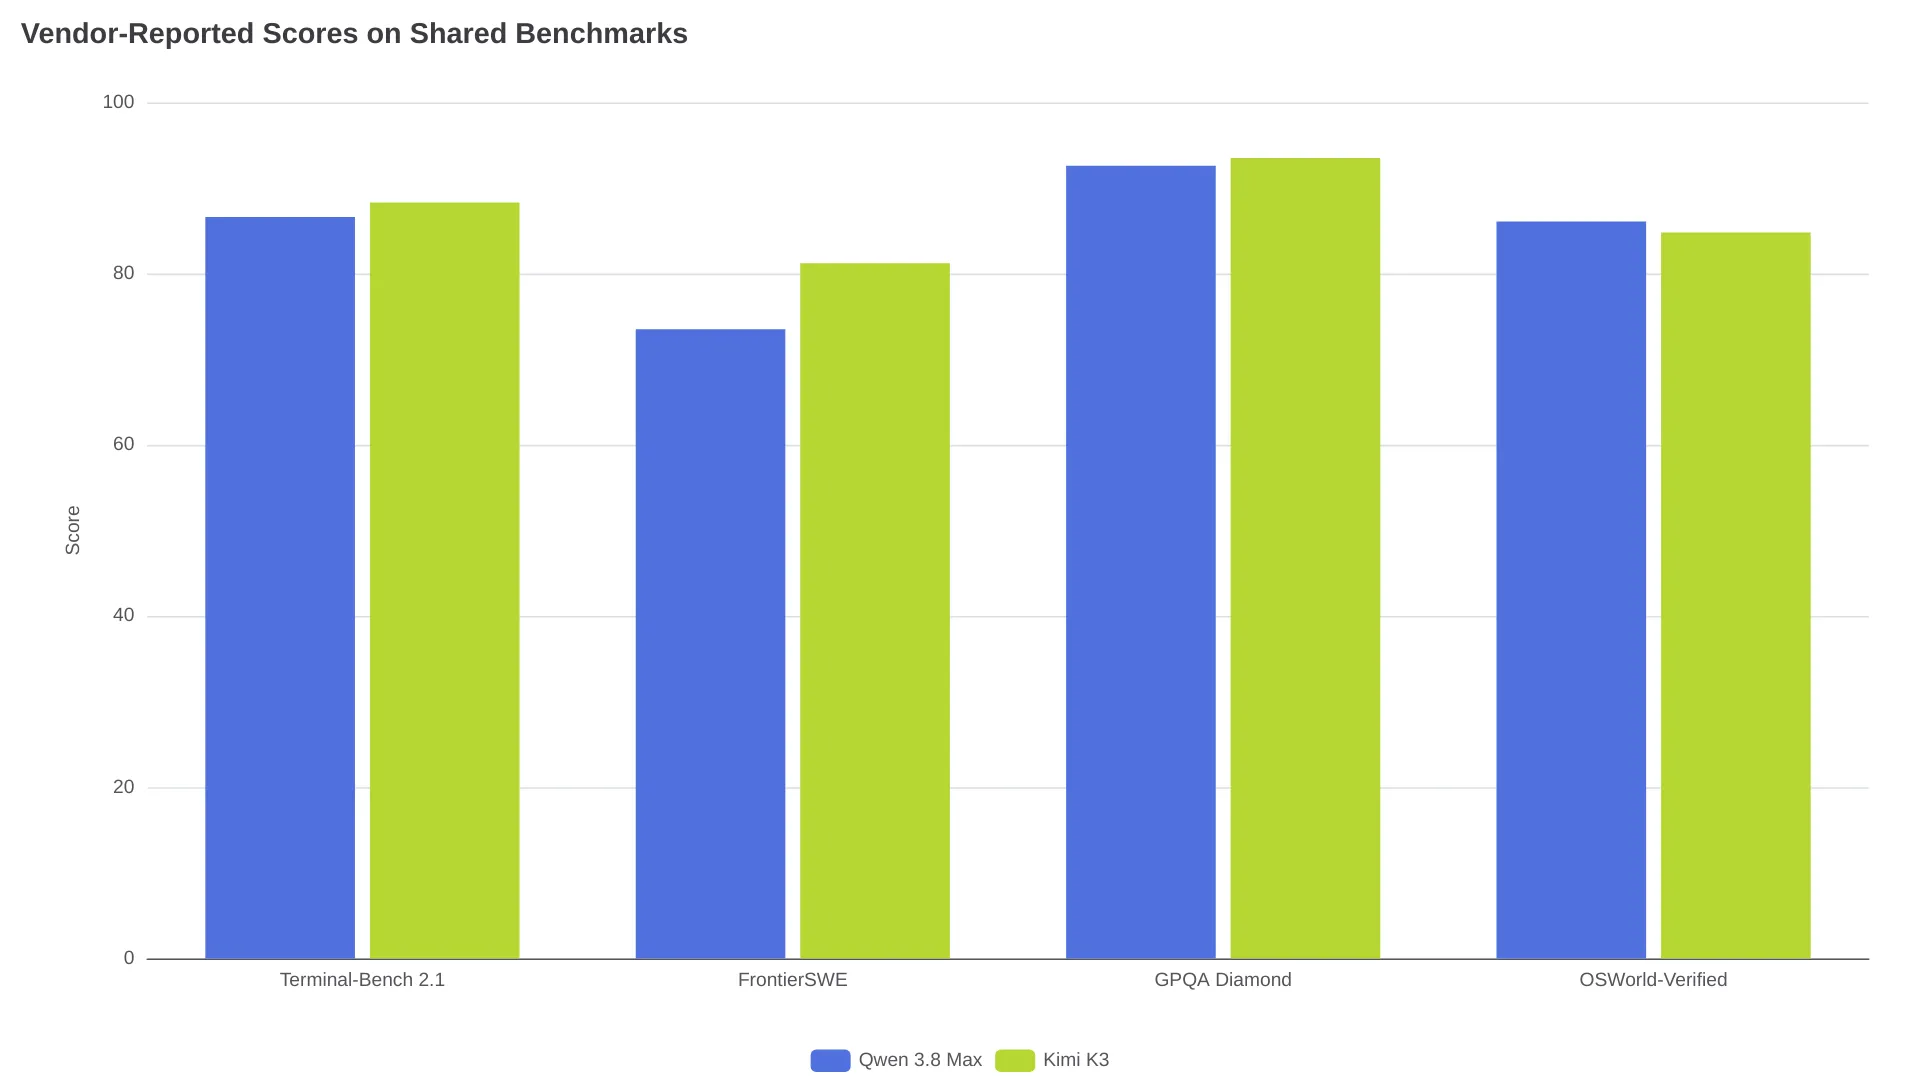
在双方都有报告的项目中,Kimi K3 在智能体编程相关指标上领先。根据其模型卡,FrontierSWE 为 81.2,对比 Qwen 的 73.5;Terminal-Bench 2.1 为 88.3,对比 86.6(Qwen 数据见2.4T 模型卡)。Qwen 的发布材料则宣称,其 OSWorld-Verified 达到 86.1,高于 K3 模型卡中的 84.8;Qwen 模型卡还列出了几项单方成绩,包括 PaperBench 93.0、IFBench 82.8、SWE-bench Pro 67.7。另一方面,K3 在 Qwen 未报告的项目上给出了 SWE-Marathon 42.0、BrowseComp 91.2 和 MCPMark-Verified 94.5。
目前独立记录明显更偏向 Kimi K3。Emergent 的跟踪数据显示,Kimi K3 发布时的 Artificial Analysis Intelligence Index 为 57,在当前版本指数中为 60,排在 Claude Fable 5 和 GPT-5.6 Sol 之后;Orcarouter 的对比还补充了其在 Frontend Code Arena 以 1,679 Elo 位列第 1 的成绩。Qwen 3.8 Max 发布时没有被独立纳入指数;cheapestinference.com 的追踪页给出 53 这一 Artificial Analysis 指数数值,社区中关于其更新至 56 的说法尚未得到验证。
唯一的同任务正面对比来自 TrilogyAI 的 StackPerf 架构分析(由Orcarouter 记录):在预览端点上,K3 得分 83/100,Qwen 为 80/100。Qwen 记录到 354 次代码仓库引用,Kimi 为 274 次;Qwen 发出 22 次网关请求,Kimi 为 53 次;Qwen 的工具调用失败次数为 0,Kimi 为 2。
还有一项共有表格往往忽略的数据:根据Qwen 自己的模型卡,27B 在 OSWorld-Verified 上拿到 84.3,距离K3 的 84.8 只差半分。一个 27B 稠密模型在计算机操作任务上几乎追平了 2.8T 旗舰模型。它不属于 K3 的编程能力级别——Terminal-Bench 为 73.0,对比 88.3——但 LiveCodeBench v6 的 90.3 和 SWE-bench Pro 的 61.7,足以让它成为真正能干活的主力模型。r/AISEOInsider 上一篇实测对比帖也呈现了同样的趋势:Qwen 在一次性构建任务中赢得更多,Kimi 则会在上下文变长、迭代修改加深后反超。
API 成本:$15 输出价格线与推理费用
按标价计算,结论很明确;看实际账单时,差距通常会更大。因为两款模型默认都会深度推理——K3 使用 reasoning_effort: max,Qwen 使用 xhigh——而推理 Token 按输出 Token 计费。
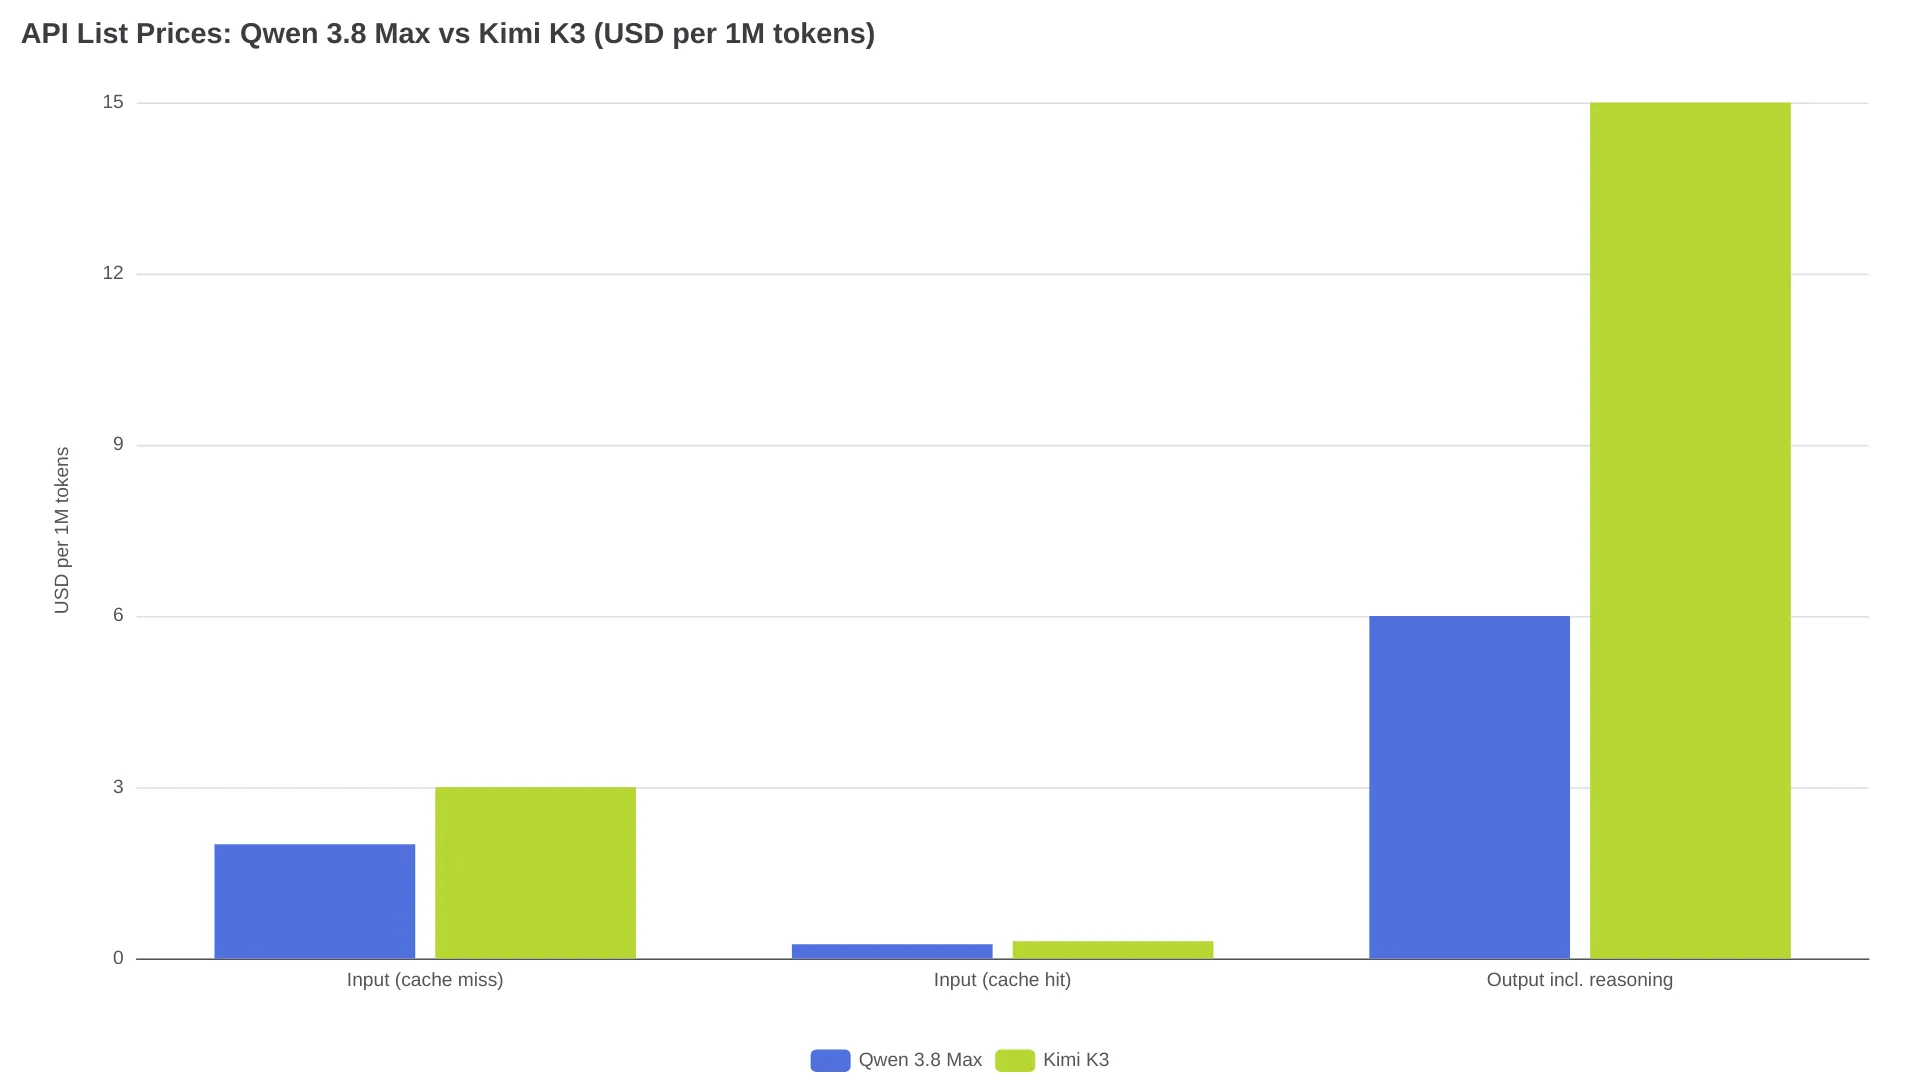
| 每 100 万 Token | Qwen 3.8 Max(QwenCloud) | Kimi K3(Moonshot) |
|---|---|---|
| 输入(缓存未命中) | $2.00 | $3.00 |
| 输入(缓存命中) | $0.25 | $0.30 |
| 输出,含推理 | $6.00 | $15.00 |
| 显式缓存创建 / 读取 | $2.50 / $0.17 | — |
按 2026 年 8 月标价计算,下面是两个会话示例:
| 会话 | Qwen 3.8 Max | Kimi K3 | 差距 |
|---|---|---|---|
| 智能体编程:500K 输入(60% 已缓存)、40K 输出 | $0.72 | $1.29 | 1.8× |
| 全新上下文的文档处理流程:2M 输入、100K 输出 | $4.60 | $7.50 | 1.6× |
据此可以得出一条路由规则:只有当 K3 在你的实际工作负载上的任务验收率,比 Qwen 高出超过约 1.8× 的 Token 成本差距时,才值得把任务交给 K3。Moonshot 自己也提供了更省预算的选择——Kimi K2.7 Code,在 256K 上下文下的价格为输入 $0.95 / 输出 $4.00。因此,Kimi 家族中最便宜的编程路线并不是 K3。如果你现在要接入 K3,这里列出了它的 API 端点,价格采用 Moonshot 公布的费率;两边更细的价格机制,可参见 Qwen3.8-Max 定价分析和Kimi K3 定价指南。
自行部署:1.56 TB 对上一张 RTX 4090
在开放权重这件事上,两者的现实门槛相差大约两个数量级。
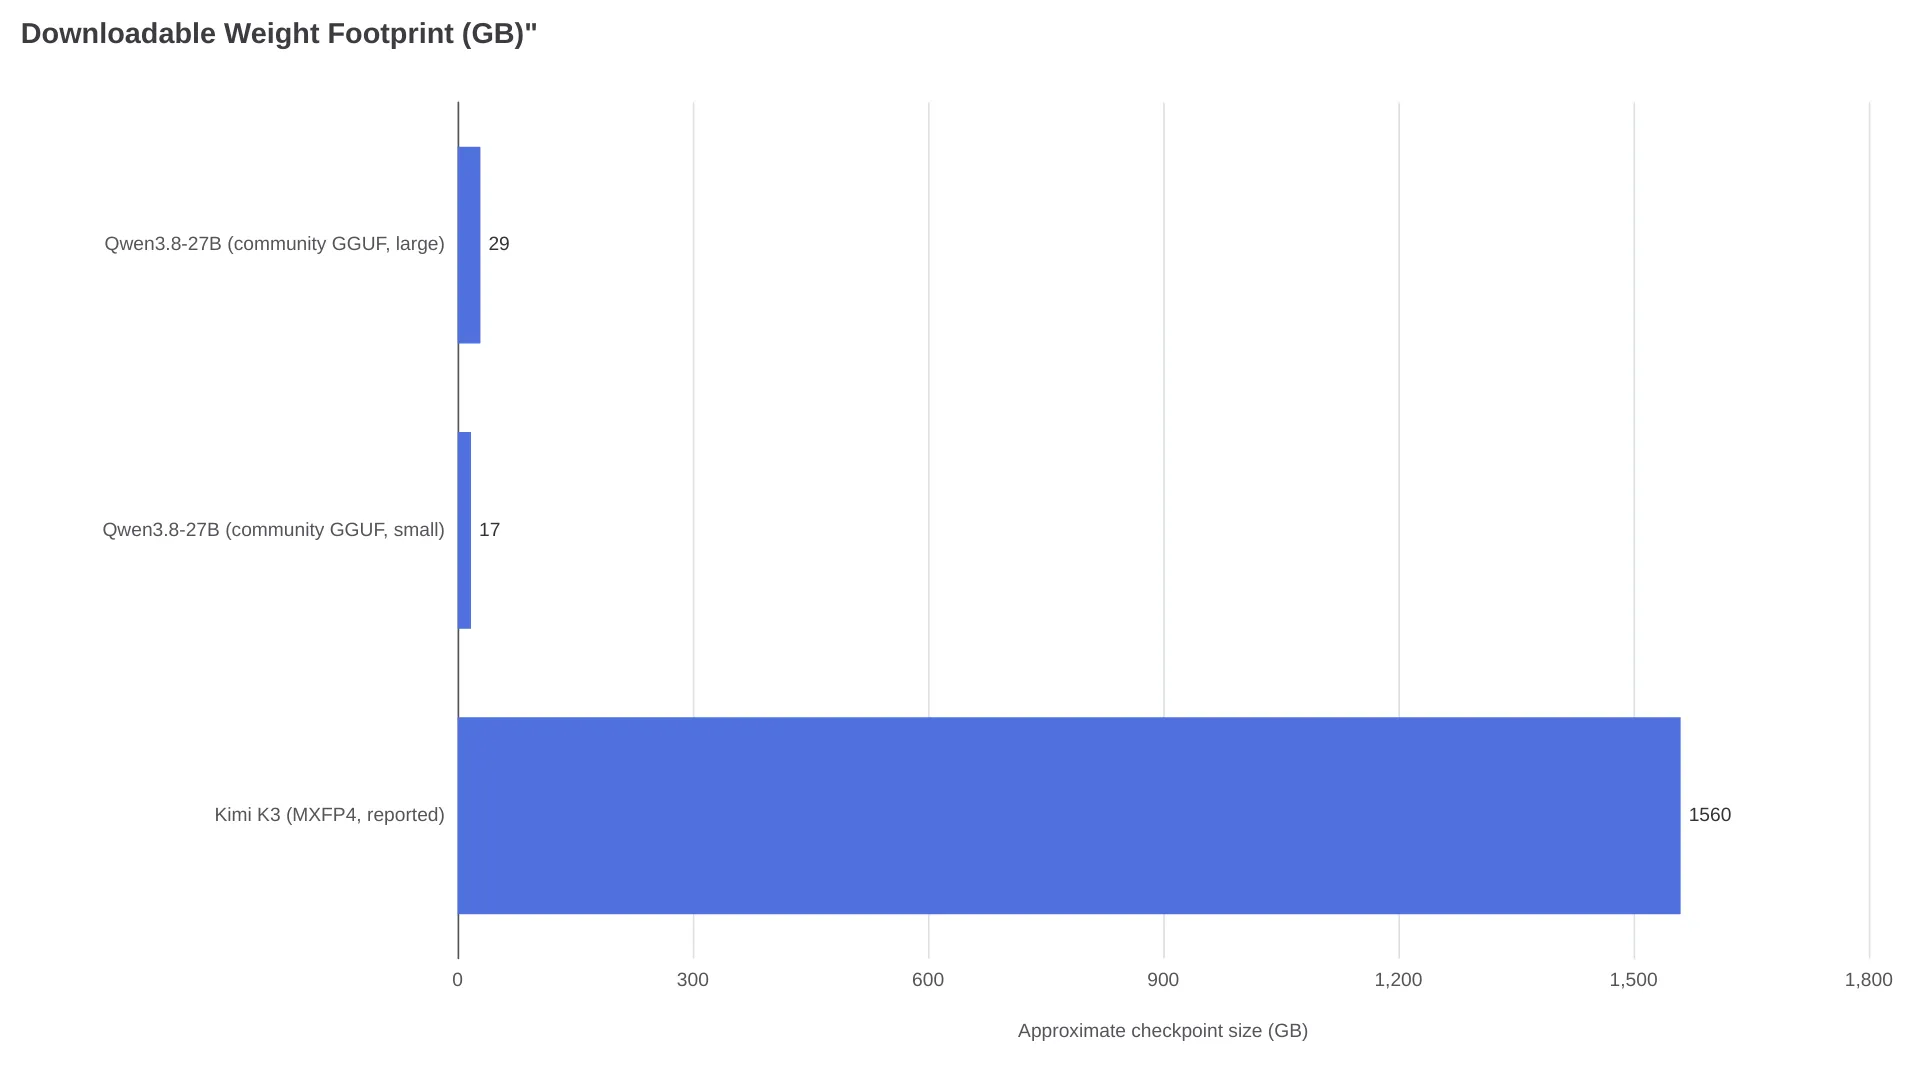
K3 提供量化感知的 MXFP4 权重(模型卡),但据报道,检查点体积达到 1.56 TB,已是集群部署项目——同一来源建议通过 vLLM 在 64 张或更多加速卡上运行。在还没服务一个 Token 前,这就是一笔可以租用、但绝对真实存在的成本;此外还要遵守许可证中针对大规模使用的条件。
27B 的情况恰好相反。社区 GGUF 构建版本的体积约在 8.5 GB 到 28.9 GB 之间;Unsloth 的动态 GGUF 和 NVFP4 构建最低约需 17 GB;官方也提供了面向服务器部署的 FP8 版本。它可以运行在许多人已经拥有的硬件上:
“Qwen3.8-27B 在单张 RTX 4090 上以 160K 上下文运行,47–57 tok/s,完整 GPU 卸载”——r/Qwen_AI 部署帖子
Max 权重则介于两者之间:Qwen3.8-2.4T-A95B 及其 FP8 版本可在定制 qwen3.8-max 许可证下下载,但公开制品仅支持文本,且无法关闭思考模式;视觉输入、非思考模式和默认 1M 上下文属于 QwenCloud API 层,而不是检查点能力。关于 27B 在不同量化下能做什么、不能做什么,Qwen3.8-27B 实战指南整理了运行时和显存表;K3 的权重发布细节则见Kimi K3 开放权重解读。
决定智能体项目成败的集成细节
以下三个模型卡层面的行为,如果等到生产环境里才遇到,很可能让你多花一天排查问题。
| 模型 | 行为 / 限制 | 实施影响 |
|---|---|---|
| Kimi K3 | 思考始终开启;多轮和工具调用客户端必须重新发送完整的历史助手消息,包括 reasoning_content 和 tool_calls(模型卡) | 丢掉推理轨迹,智能体循环会退化;保留它,成本会随循环长度增加 |
| Qwen3.8-27B | preserve_thinking 默认开启;reasoning_effort 可降至 medium/low;超过 262K 的 YaRN 属于静态缩放(模型卡) | 支持按请求关闭;模型卡警告,降低推理强度不一定缩短端到端时间,因为重试会吃掉节省下来的时间;仅在长任务中启用 YaRN |
| Qwen 3.8 Max 与 K3 的上限 | Max:991.8K 输入 / 131.07K 输出(QwenCloud);K3:1,048,576 输入 / 默认 131K 输出,逐步升至 1M | 两者的“1M 上下文”都不代表可获得 1M 有效输出;一项第三方针测测试在 248K 时找回 18/18 条事实,且未测试更长上下文 |
常见问题
Qwen 3.8 做编程比 Kimi K3 更好吗?
基于当前可用证据,不是。Kimi K3 在关键的智能体编程项目上领先,FrontierSWE 为 81.2 对 73.5,Terminal-Bench 2.1 为 88.3 对 86.6,并且拥有唯一的独立指数成绩。Qwen 3.8 Max 在终端类工作上很接近,单 Token 和上述模拟会话的成本也更低;27B 则完全是不同的参数量级。
Qwen 3.8 和 Kimi K3,哪个更便宜?
Qwen 3.8 Max 在每一项标价上都更低:输入 $2 对 $3,输出 $6 对 $15。由于两款模型默认开启的推理都按输出计费,任务越难,Kimi 的成本劣势越明显——按上文计算,在带缓存的智能体会话中约为 1.8×。
它们能自行部署吗,分别是什么许可证?
可以,三个检查点都可下载。Qwen3.8-27B 使用 Apache-2.0,量化后可放进单张 24 GB GPU;Kimi K3 的约 1.56 TB MXFP4 检查点需要集群级硬件,采用定制 Kimi K3 License;Qwen3.8-Max 权重则以 Qwen3.8-2.4T-A95B 公开,采用定制 qwen3.8-max 许可证。
两者的 1M 上下文窗口都是真的吗?
大致如此。Kimi K3 标称 1,048,576 Token;Qwen 3.8 Max 标称 1M,最大输入为 991.8K;27B 原生上限是 262,144,仅能通过会牺牲短上下文质量的 YaRN 缩放达到 1M。独立验证目前只到 248K 级别。
怎么选,以及哪些因素会改变结论
| 你的使用场景 | 推荐 | 原因 |
|---|---|---|
| API 编程智能体,质量优先 | Kimi K3 | FrontierSWE 81.2、Terminal-Bench 88.3、经 AA 验证的 60 |
| 重视 API 支出,文档 / 视觉任务为主 | Qwen 3.8 Max | 输出 $6 对 $15、OSWorld 86.1、显式缓存读取仅 $0.17 |
| 在自有硬件上自行部署 | Qwen3.8-27B | Apache-2.0、约 17–29 GB 量化版本、单张 RTX 4090 可跑 160K 上下文 |
| 自行部署前沿旗舰模型 | Kimi K3 | 这里唯一拥有独立前沿级别成绩的开放检查点——请按集群预算准备 |
有两件事可能改变上表的部分结论:Qwen 3.8 Max 获得独立评分,以及定制 qwen3.8-max 许可证发布正式条款。前者目前只有追踪器报告的 53,对比 K3 经验证的 60,证据仍然有限;在这两项信息出现之前,想深入了解纯 API 路线,可阅读Qwen 3.8 Max vs Kimi K3 API 正面对比。
延伸阅读:Qwen3.8-27B:已确认的信息,以及 17GB 实际能跑什么 · Kimi K3 开放权重 · Qwen 3.8 Max vs Kimi K3:API 版