 AIREITER
一张 RTX 3090,能否跑下带完整 262K 上下文的 30B 多模态模型?Meta 于 2026 年 8 月 10 日发布 Muse Glimmer 后,本地 AI 社区很快开始对它进行压力测试。结果是:借助 DFlash,它能在 RTX 5090 上跑到 236 tok/s,也能装进单张 RTX 3090;但在 TerminalBench 2.1 上,它比 Qwen 3.6 27B 低 9 分,而且面对操作系统级自动化任务时,常会直接拒绝执行。
Muse Glimmer 30B 到底是什么模型?
Muse Glimmer 是 Meta Superintelligence Labs 发布的一款 30B 参数稠密多模态模型,采用 Apache 2.0 许可证。它的定位不是冲击编程排行榜,而是面向可本地常驻运行的智能体工作流。模型由 27.9B 文本解码器、1.9B ViT 视觉编码器和基于 GELU 的多模态投影器组成,因此同时具备文本与图像理解能力。以下架构信息来自 SGLang 的 Day-0 支持博客。
核心架构参数一览
| 规格 | 详情 |
|---|---|
| 总参数量 | 30B |
| 文本解码器 | 27.9B 稠密模型 |
| 视觉编码器 | 1.9B ViT |
| Transformer 层数 | 52 |
| 注意力机制 | 分组查询注意力(32 个 Query Head、2 个 KV Head,16:1 GQA) |
| 前馈网络 | SwiGLU |
| 上下文窗口 | 128K+(已测试至 262K) |
| 许可证 | Apache 2.0 |
它采用混合注意力架构:每 4 层中,前 3 层使用 2,048 token 的滑动窗口注意力,第 4 层使用全序列注意力。局部窗口层配合 RoPE,全注意力层采用 NoPE,使上下文能够扩展至超出训练上限的长度。16:1 的分组查询注意力也显著压缩了 KV 缓存:一项社区实测显示,131K token 在 F16 下的 KV 缓存仅约 1.8 GiB。因此,在同样配备 24 GB 显存的 GPU 上,它能容纳完整长度上下文;而 Qwen 3.6 27B 在相同 F16 配置下最多只能达到 70K token。
你的硬件能跑 Muse Glimmer 吗?
关键取决于量化方案。SGLang 提供 BF16、NVFP4+MXFP8、GGUF Q4_K_M、GGUF Q4K-Dynamic 和 MLX 4-bit 格式的官方检查点。针对极低显存设备,社区也已经将模型压到 2-bit GGUF。
不同配置需要多少显存
| 配置 | 大致显存需求 | 目标硬件 |
|---|---|---|
| BF16 | ~60 GB | 单张 H100 |
| NVFP4 + MXFP8 | ~19.5 GB | RTX 5090 / DGX Spark |
| NVFP4 + BF16 DFlash | 18 GB + 5 GB 推测器 | RTX 5090 |
| Q4_K_XL + DFlash + mmproj + 262K 上下文 | ~22-23 GB | RTX 3090(24 GB) |
| 2-bit GGUF | ~14 GB | RTX 4060 Ti / 更低端设备 |
| MLX Q4(Apple Silicon) | 统一内存 | Mac mini / MacBook Pro |
一位 Reddit 用户演示了:在单张 RTX 3090 上,Q4_K_XL 版 Muse Glimmer 加上 DFlash 推测解码、多模态投影文件和 F16 KV 缓存后,显存占用稳定在 22-23 GB,同时可开启完整的 262,144 token 上下文。他们首次测试便从约 150K token 的“干草堆”中找回了两根“针”。
作为对比,同一张 RTX 3090 上的 Qwen 3.6 27B 使用 F16 KV 缓存时只能达到 70K token,换成 Q8 KV 缓存则可到 125K;Gemma 4 31B 在 F16 下为 52K,Q8 下为 81K。Muse Glimmer 能在相同硬件上容纳更多上下文,主要归功于其 16:1 GQA 带来的 KV 缓存效率。
部署路线:NVIDIA 平台可通过 SGLang 或 llama.cpp 加载 NVFP4 或 GGUF 检查点,并启用 --speculative-algorithm DFLASH。Apple Silicon 则使用 MLX 后端,暂不支持 DFlash。一位配备 96 GB 统一内存的 M3 Max 用户报告速度为 17 tokens/s,并称 Muse Glimmer 在该系统上比 Qwen 和 Gemma 都快。
Muse Glimmer 实际有多快?
SGLang 公布了覆盖 7 种硬件配置的测试表,批量大小从 1 测至 8。通过 --speculative-algorithm DFLASH 启用 DFlash 推测解码后,NVIDIA 平台在 batch-1 交互吞吐上可获得 1.9 倍至 4.3 倍加速。
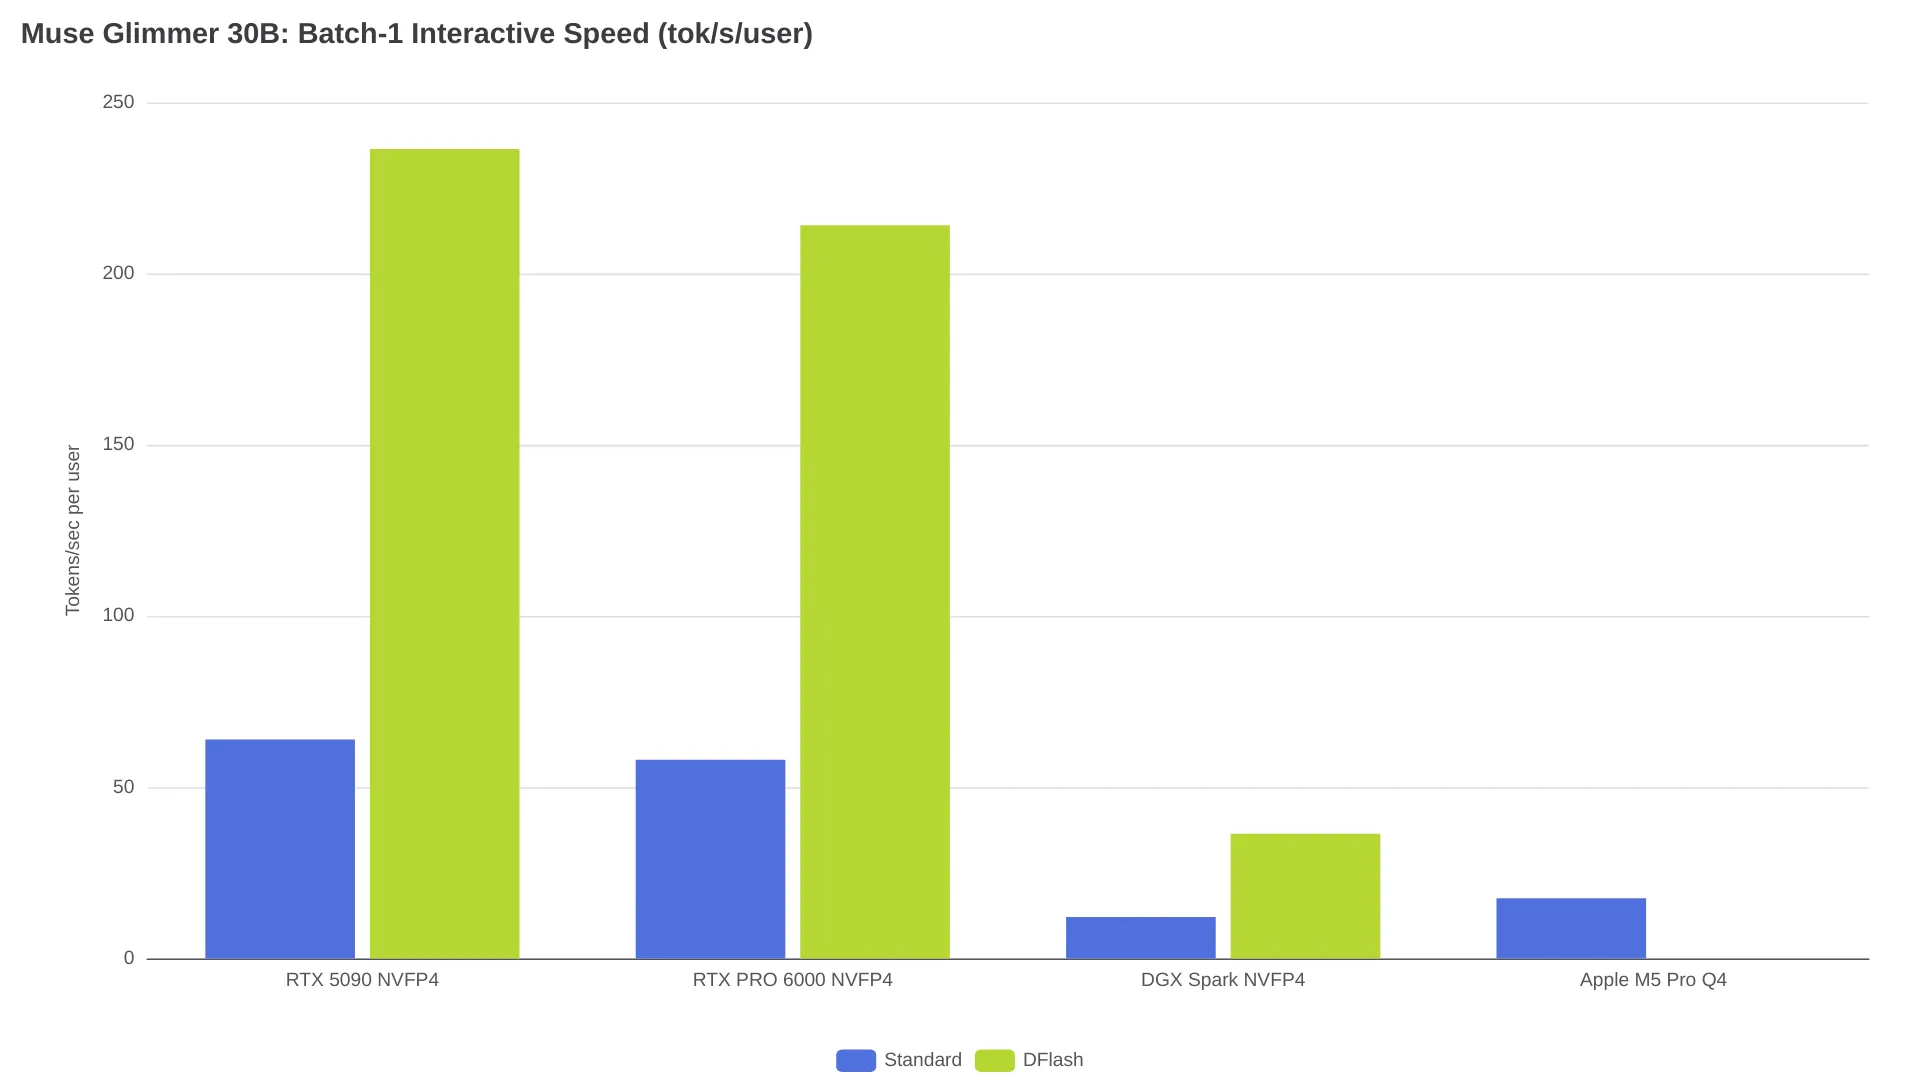
SGLang 基准测试重点数据
| 平台 | 精度 | 解码方式 | Batch-1 tok/s/用户 | Batch-8 tok/s |
|---|---|---|---|---|
| NVIDIA B300 | BF16 | DFlash | 308.51 | 261 |
| RTX 5090 | NVFP4 | DFlash | 236.4 | 1,452 |
| RTX 5090 | Q4_K_M | DFlash | 140.7 | 332 |
| RTX PRO 6000 | NVFP4 | DFlash | 214.11 | 403 |
| DGX Spark | NVFP4 | DFlash | 36.4 | 301 |
| Apple M5 Pro | Q4 | Standard | 17.6 | 56.9 |
RTX 5090 在 batch 8 下的 1,452 输出 tokens/s 是总吞吐量;对于单用户本地推理,更有参考意义的是 NVFP4 + DFlash 下的 236 tok/s。关闭 DFlash 后,同一配置会降至 63.9 tok/s。社区实测也基本吻合:一位使用 Unsloth Q5_K_M 量化和 RTX 5090 的用户报告速度为 220-253 tokens/s。
DFlash 的实际效果取决于草稿接受率。使用 Vulkan/RX 7900 XTX 及 SYCL/B70 的用户均反馈草稿接受率偏低,整体吞吐反而较慢。
Muse Glimmer 对比 Qwen 3.6 27B:该选谁?
TerminalBench 2.1 成绩对比
| 模型 | TerminalBench 2.1 | RTX 3090 上下文容量(F16 KV) |
|---|---|---|
| Qwen 3.6 27B | 60.7 | ~70K tokens |
| Muse Glimmer 30B | 51.7 | ~262K tokens |
| Gemma 4 31B | 43.4 | ~52K tokens |
TerminalBench 2.1 分数引自社区讨论。上下文数据来自RTX 3090 测试。
在社区普遍视为衡量模型能否长程可靠执行终端命令的重要基准 TerminalBench 2.1 上,Qwen 3.6 27B 领先 9 分。直接编程测试中的差距也较稳定:一位用户的私有评测集给出了 Qwen 12/13、Glimmer 11/13 的结果;Qwen 首次尝试就正确生成了一个 953 行的东京旅游页面,而 Glimmer 输出不足 200 行(完整讨论帖)。
“和 Qwen 3.6 27B 根本没法比。”—— Reddit 用户 BarberIcy366 表示,Glimmer 为一款 8 球台球游戏生成 HTML 时消耗了 21,000 token,却只输出 220 行(r/LocalLLaMA)。同一讨论中还有报告称,启用 MTP 后,Qwen 3.6 27B 完成俄罗斯方块实现的速度快 1.7 倍。
不过,Glimmer 在几个方面确实有自己的优势:
- 上下文容量:同样采用 F16 KV 设置时,单张 RTX 3090 可容纳 262K token,而 Qwen 只能达到 70K。对于大型代码库任务,这是 3.7 倍的优势。
- KV 缓存效率:16:1 GQA 比例让 Glimmer 的 KV 缓存大幅缩小,为上下文留出了更多显存。
- 视觉能力:Glimmer 原生就是多模态模型;基础版 Qwen 3.6 27B 则仅支持文本。
- MCP 与工具问答:有用户称,虽然 Glimmer 的终端编程能力不及 Qwen,但在 MCP 辅助的代码库检索和问答工作流中颇具潜力。
- 写作质量:多位用户更喜欢 Glimmer 的自然语言输出,认为它比 Qwen 更自然。
一位评论者这样概括两者取舍:Glimmer 相当于“Qwen 3.6 27B,写作风格加 5%,智能体能力减 5%”。
结论:按工作负载来选
如果你的核心需求是一次性编程任务或自主终端智能体,Qwen 3.6 27B 仍是更强的选择:它在 TerminalBench 2.1 上高出 9 分,也没有 Glimmer 在操作系统级自动化中频繁出现的安全拒答问题。若你需要在单张消费级 GPU 上处理长上下文检索、多模态输入或 MCP 辅助工作流,Muse Glimmer 值得一试。若要可靠执行终端自动化,建议等待社区微调版本。
已知问题与避坑要点
别把 max_tokens 设得太低
Muse Glimmer 在生成最终输出前,会将相当一部分 token 预算用于内部推理。如果 max_tokens 设得太小,模型可能在思考中途耗尽预算,最终返回空响应。一位用户最初在其评测集上仅测得 Glimmer 6/13;提高输出 token 预算后,成绩升至 11/13(来源讨论帖)。请将 max_tokens 设得足够高以覆盖推理开销,否则响应可能在思考途中终止。
会拒绝操作系统级自动化
多位用户反馈,涉及鼠标控制、键盘自动化或其他操作系统级工具调用的任务,Muse Glimmer 往往会拒绝。即使请求只是使用常规 Python 库,模型也可能将其判定为潜在安全风险。
“以编程方式移动鼠标可能被滥用于自动化、点击劫持或绕过安全提示。”—— 据 Reddit 用户 Cold_Tree190 报告,这是 Muse Glimmer 的拒答内容(r/LocalLLaMA)
新开一个会话并补充更多用途背景,有时可以解除拒答;但如果模型已在当前会话中拒绝过,通常会坚持原有立场。
工具调用稳定性不一
社区对于工具调用可靠性的反馈差异很大:有人在 C 代码库中使用时“从没失败过”,也有人在其他配置下遇到无限循环和空 API 响应。部分配置中的 Unsloth Q4 和 Q5 量化版本,据称在工具调用时循环问题严重;而面向 24 GB 和 32 GB 显存的官方 GGUF 版本可能更可靠(来源讨论帖)。
部分地区无法从官方下载
据称,官方 Hugging Face 页面已对香港、澳门和中国禁用下载。作为替代方案,Unsloth 提供的第三方 GGUF 分发版本仍可获取。