 AIREITER
同样是 Muse Spark 1.2,Standard 与 Contributor 的输入单价相差 12.5 倍。Standard 每百万输入 token 收费 $1.25、每百万输出 token 收费 $4.25;Contributor 则降至 $0.10 和 $0.20,但 Meta 可以将你的提示词和模型输出用于训练。更关键的是,Contributor 不只是便宜:它的吞吐量限制为每分钟 60 次请求,每日 token 上限约为 25 万。因此,实际能省多少钱,取决于你的工作负载规模,而不只是每 token 标价。
同一模型,两种套餐
根据 Meta 开发者文档,Muse Spark 1.2(模型 ID:muse-spark-1.2)是 Meta 推出的、面向推理和编程任务的模型,上下文窗口为 1,048,576 token。两个 API 套餐使用的是同一个模型,差别主要在价格、数据处理方式和吞吐能力。
| 维度 | Standard | Contributor |
|---|---|---|
| 模型 ID | muse-spark-1.2 | muse-spark-1.2-contributor |
| 输入(每 1M token) | $1.25 | $0.10 |
| 缓存输入(每 1M token) | $0.15 | $0.002 |
| 输出(每 1M token) | $4.25 | $0.20 |
| 上下文窗口 | 1,048,576 token | 1,048,576 token |
| 长上下文加价 | 无 | 无 |
| 数据隐私 | Meta 不会使用你的数据训练 | Meta 可能使用提示词和输出进行训练 |
根据 Meta 的文档,两个套餐都不会因长上下文而额外加价。
Standard 的缓存输入价格是 $0.15/M,比新输入便宜 8.3 倍。Contributor 的缓存输入则低至 $0.002/M,对于需要反复携带代码库上下文的场景,成本会显著下降。
“Muse Spark 1.2 很棒……价格简直离谱。”
— r/opencode 用户
速率限制决定实际可用额度
看 token 单价只能了解一半成本。另一半在于吞吐量,而两个套餐在这方面差距很大:
| 限制项 | Standard | Contributor |
|---|---|---|
| 每分钟请求数 | 3,000 | 60 |
| 每分钟 token 数 | 4,000,000 | 低得多(受每日上限约束) |
| 每日 token 上限 | 无限制 | 约 250,000 token/天 |
| 限制维度 | 按团队 | 按团队 |
根据 Meta 的定价与速率限制文档,限额是按团队而非按 API key执行的。多创建几个 key 不会提高吞吐量。
每天 25 万 token,编程时够用多久?
可以沿用下文的会话模型来理解 Contributor 每天约 250,000 token 的上限:每轮发送 8,000 token 输入,并生成 2,000 token 输出,合计 10,000 token。照此计算,达到每日上限前大约只能完成 25 轮,基本相当于一次专注的编程会话,而不是一整天持续迭代开发的用量。
一次真实编程会话要花多少钱
假设一次典型的编程会话中,智能体载入 8,000 token 上下文,包括代码库和系统提示词;随后生成 2,000 token 输出,包括代码修改和推理过程;这样的模式在一次会话中重复 20 次。
| 套餐/模型 | 每轮成本 | 20 轮会话成本 |
|---|---|---|
| Muse Spark Standard | $0.0185 | $0.37 |
| Muse Spark Contributor | $0.0012 | $0.024 |
| GPT-5.6 Terra ($2/$12) | $0.0400 | $0.80 |
| Claude Opus 5 ($5/$25) | $0.0900 | $1.80 |
完成 20 轮会话,Standard 的成本是 $0.37,Contributor 仅为 $0.024;后者会消耗约 20 万 token,接近每日 25 万 token 上限。
若计入缓存输入,并采用 Artificial Analysis 给出的 7:2:1 缓存命中率,Muse Spark 1.2 Standard 的综合成本可降至每百万 token $0.78。
Muse Spark 1.2 与竞品的价格差距
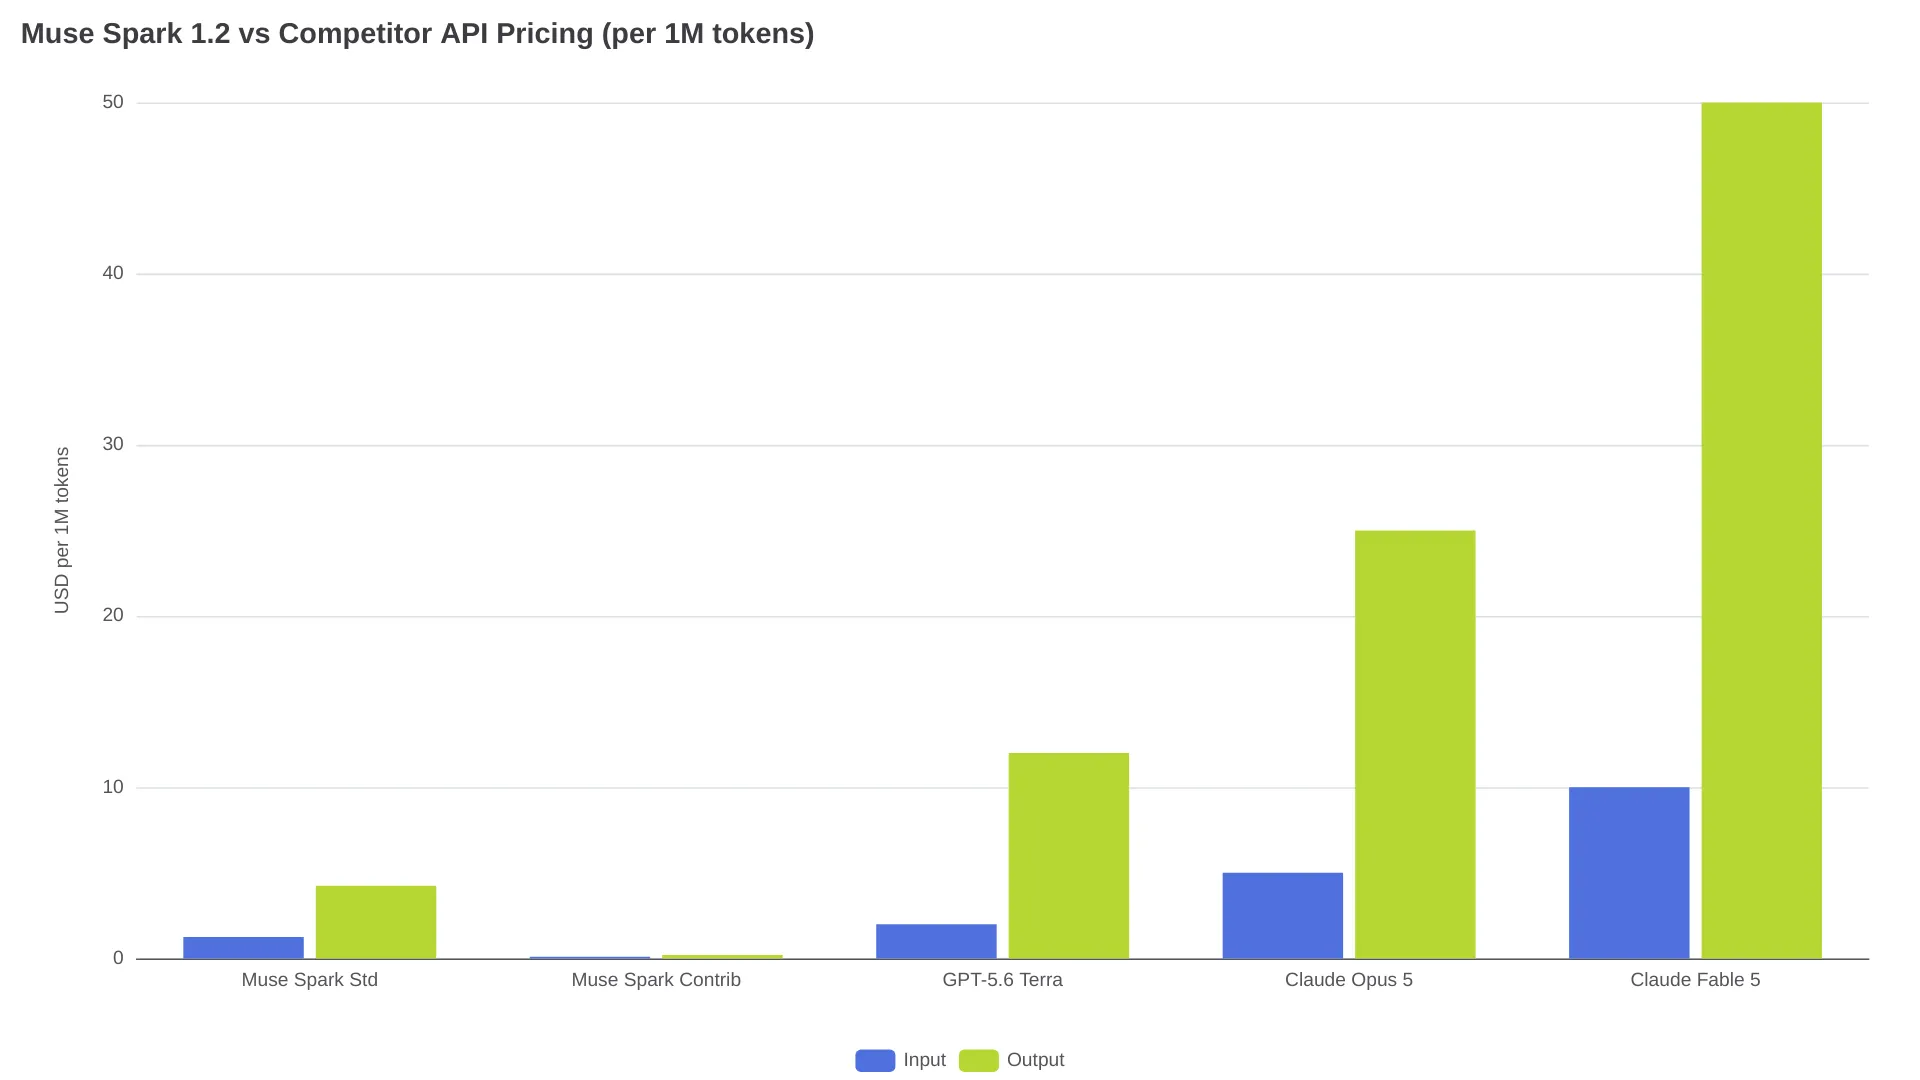
| 模型 | 输入(每 1M) | 输出(每 1M) | 综合成本* |
|---|---|---|---|
| Muse Spark 1.2 Standard | $1.25 | $4.25 | $0.78 |
| Muse Spark 1.2 Contributor | $0.10 | $0.20 | $0.04 |
| GPT-5.6 Terra | $2.00 | $12.00 | $3.00 |
| GPT-5.6 Sol | $5.00 | $30.00 | $7.50 |
| Claude Opus 5 | $5.00 | $25.00 | $7.00 |
| Claude Fable 5 | $10.00 | $50.00 | $14.00 |
\*Muse Spark 行的综合成本采用 7:2:1 的缓存命中:新输入:输出比例计算,即 0.7 × 缓存输入 + 0.2 × 输入 + 0.1 × 输出。为便于比较,竞品行采用 90/10 的新输入/输出场景。比例计算方法来自 Artificial Analysis;竞品价格来自 OpenAI 和 OpenRouter。
Artificial Analysis 将 Muse Spark 1.2 列入成本性能 Pareto 前沿:它的智能水平可与 Claude Opus 4.8 相比,每项任务的成本约为后者五分之一。上面的综合成本只是特定场景下的估算,并非直接的标价对比;若要在相同工作负载下横向比较,20 轮会话表格更直观。
基准测试方面,据 VentureBeat 报道,Muse Code 中的 Muse Spark 1.2 在 Terminal-Bench 2.1 上取得 82.9%,略低于 Claude Opus 5 的 86.7%。
不同项目该选哪个套餐
套餐选择不只是价格问题,更要看项目的数据敏感度、所需吞吐量和可接受的延迟。
以下情况选 Standard:
- 要处理不能脱离控制范围的专有代码或客户代码
- 需要持续超过 60 RPM 的吞吐量
- 每天的 token 用量超过 250K
- 要接入负载可预期的生产流程
以下情况选 Contributor:
- 开发开源项目或个人项目
- 主要用于探索和原型开发
- 希望以最低 token 成本完成低用量的探索性工作,且能控制在 60 RPM 和约 250K token/天以内
- 团队可以接受 Meta 使用提示词进行训练
延迟也是一个值得注意的维度。Orca Router 报告称,Spark 1.2 的首 token 时间为 26.12 秒,而 1.1 为 2.90 秒,出现了9 倍退化。对于要求流式响应几乎立即返回首 token 的工作流,这并不合适。
还有一点需要留意:Reddit 上多位用户表示,Contributor 套餐在部分地区受到区域限制。如果你在 API 控制台中找不到它,先确认所在地区是否支持,而不要直接认定该套餐不可用。
你也可以通过 OpenRouter 等第三方路由服务使用 Muse Spark 1.2。它们以同样的 $1.25/$4.25 价格提供 Standard 套餐,但速率限制结构可能不同。
常见问题
Muse Spark 1.2 有免费套餐吗?
根据 Meta 的定价页面,API 本身没有免费套餐,Standard 和 Contributor 都采用按量付费模式。不过,运行 Muse Spark 1.2 的 Meta 编程智能体 Muse Code 在 Beta 期间免费提供,但设有每日 token 限制。
可以在会话进行中切换 Standard 和 Contributor 吗?
可以。根据 Meta 的文档,只需调用不同的模型 ID 即可切换:muse-spark-1.2 或 muse-spark-1.2-contributor。但你的地区必须先开通 Contributor 访问权限。
Contributor 套餐适合用于生产环境吗?
前提是你的数据政策允许 Meta 将提示词和模型输出用于训练。若涉及专有代码或客户代码,请参考上文的套餐选择标准。
Muse Spark 1.2 相比前代,价格有什么变化?
根据 Meta 的文档,价格与 Muse Spark 1.1 相同:两个版本的 Standard 套餐均为每百万 token $1.25/$4.25。Contributor 套餐则是 1.2 新增的。