 AIREITER
一张咖啡菜单,只有四个价格,看起来并不难生成;真正麻烦的是模型把其中一个价格悄悄改掉。MOSS Image 在这类精确文字任务上的表现,远超其参数量给人的预期——前提是你愿意提供结构化描述,并像设计师一样逐字校对成图。
这也是本文要验证的取舍:这是一款采用 Apache 2.0 许可、拥有 50 亿参数的文生图模型,支持最长 4,096 token 的提示词,也可选用 JSON 边界框定义文字和对象位置。OpenMOSS 团队于 2026 年 10 月 16 日发布 Base 与 SFT 两个检查点,MOSI 平台的托管 API 则在 10 月 20 日上线。若你的工作是制作海报、菜单、标签或需要精确文案的信息图,值得一试;如果更看重角色一致性或照片编辑,闭源模型依然更合适。
首轮出图已经说明问题:文字稳,审美不一定稳赢
MOSS Image 的核心卖点不是泛用视觉美感,而是长文本和精确文案。厂商自己的 LongLongTextBench 数据显示:在平均约 1,340 个字符、共 240 个任务中,它的整体 Mean-6 文本覆盖率为 96.3,长英文为 97.1,长中文为 92.4;GPT Image 2 为 99.0,Nano Banana Pro 为 96.6。这些数据来自厂商设计并执行的基准测试,更适合视为待验证的主张,而不是结果保证。
第二个关键指标是布局服从度。这篇评测所引述的技术报告称,在其 7Bench 边界框跟随测试中,MOSS Image 达到 0.88 mIoU 和 0.70 Layout AUC;同一报告中,Ideogram 4 为 0.44 和 0.20,GPT Image 2 为 0.30 和 0.16,MOSS Image 的成绩大致翻倍。在 RealLayoutArena 的 61 个盲评任务中,涵盖海报、信息图和 UI,启用提示词增强的完整 MOSS 系统获得 1,698.70 Elo,仅次于 GPT Image 2 的 1,844.35;若所有生成器统一使用同一份增强提示词,则 MOSS 的骨干模型排名第一。仍然要强调:这些是厂商测试结果,尚待独立复现。
一组小规模受控测试更能说明差异。mossimage.run 团队以相同 1024x1024 画布、相同种子,为每条提示词各生成一次,比较 MOSS Image SFT 与 FLUX.1 dev;没有挑图,失败结果也保留在样本中。本文未重新测试 MOSI 托管服务的延迟;下表汇总的是该团队通过 fal 端点取得的首张输出,MOSI API 本身则依据文档及其免费期计费状态评估:
| 测试 | 提示词要求 | MOSS Image SFT 首张输出 | FLUX.1 dev 首张输出 |
|---|---|---|---|
| 咖啡菜单 | MORNING MENU,以及右对齐的 Espresso 3.50、Flat White 4.20、Butter Croissant 3.80、Avocado Toast 8.50 | 四项商品与价格均按原文呈现 | 布局清楚,但 3.80 变成了 3.60 |
| 蜂蜜标签 | 沿标签曲线排布的 WILDFLOWER HONEY、Raw & Unfiltered、Net Wt. 12 oz (340 g) | 三行文字均按原文呈现 | 标题和重量正确,中间一行变成 Raw & Unfilterelrd |
| 双语海报 | 周末市集 / WEEKEND MARKET、Sat 10:00–18:00、Riverside Park、Free entry / 免费入场 | 中文、英文及细节均按原文呈现 | 构图出色,但中文乱码,且 10.00–178.00 |
测试通过 fal-ai/moss-image 和 fal-ai/flux/dev 进行:MOSS 使用 50 步、CFG 3,FLUX 使用 28 步、guidance 3.5。正如该页面所说,三个案例不足以判定胜负;但这里真正重要的是失败模式:一张看起来很可信、却篡改了价格或时间的图,往往比明显损坏的图更危险。
“对于一款 5B 模型,MOSS Image 对结构化布局和英文文字的处理相当不错。虽然每个微小细节都不完美,但整个工作流终于有了可控感。”—— @Olaemmy1200,发布了完整海报工作流视频
API 背后的架构:5B 生成器,9B 文本理解器
MOSS Image 是一款从头训练的单流扩散 Transformer,共 42 层。50 亿参数只计算生成器本身;外围还有一个被冻结的 Qwen3.5-9B 文本编码器负责读取提示词,以及一个 FLUX.2 small-decoder VAE 负责输出像素。这种拆分也解释了它的优势与硬件开销:长文本和双语理解能力来自 9B 的文本读取器,而不是 5B 去噪器。
实际使用中,最大的优势是上下文窗口。自然语言、标签序列和 JSON 布局共用最多 4,096 token,足以把海报上的每一行字完整写清,而非压缩成一句简短说明。MOSI API 文档对托管服务的描述是:支持最长 4,000 字符的长文本,并支持文字渲染、负面提示词和布局生成。建议输出尺寸在 100 万至 200 万像素之间,可从 512x512 外推至 2K,且尺寸需能被 16 整除。
实际效果主要取决于两个检查点:
- MOSS-Image-SFT:在 Base 基础上用精选数据进行监督微调。OpenMOSS 团队建议直接生成时使用它,文字分组和布局更整洁。托管 API 默认提供
moss-image-sft-1.0,也提供固定快照moss-image-sft-1.0-2026-10-09以便复现。 - MOSS-Image-Base:跳过后训练和 CFG 蒸馏,以保留原始训练信号。官方指南建议微调者从此版本开始,并冻结文本编码器。它适合训练 LoRA 或追求不同的风格分布,不适合今天就要做出一张海报的场景。
根据 Hugging Face 模型卡和官方项目页,两个权重及附带推理代码均采用 Apache License 2.0 发布。这意味着可以商用和微调,但不代表你自动获得用于营销活动的角色、商标或肖像权。所有商业项目都应保存许可证文件和精确版本号。代码位于 OpenMOSS GitHub 仓库。
JSON 布局,才是值得忍受这套工作流的理由
自然语言提示词当然也能用,但真正让设计人员愿意测试这款模型的是布局语法。结构化提示词会先描述整体画面,再为每个文字或对象分别定义说明和边界框。边界框只是生成引导,不是矢量图层,也无法保证像素级精准。
坐标约定是第一次使用时最容易踩坑的地方。当 bbox_coord_space: "abs_centralized" 且 bbox_format: "yxyx" 时,每个框采用相对于画布中心的像素坐标,顺序是 [y_min, x_min, y_max, x_max]。在 1024x1024 图像中,每条轴的取值范围均为 -512 到 +512。不要未经转换,就把普通左上角坐标或社区常用的 0–1000 布局直接套进这个 schema。
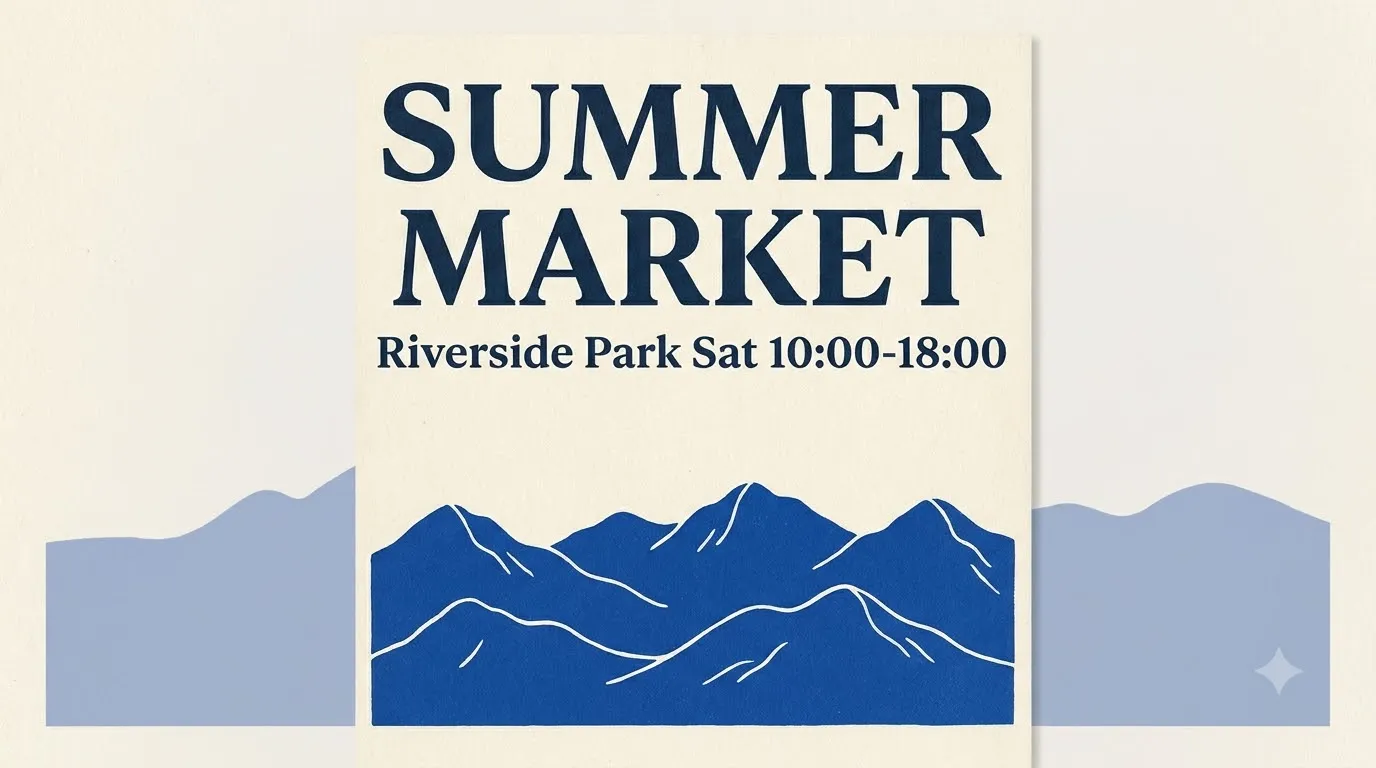
最小结构大致如下:标题在上,插画在下:
{
  "summary": {"meta": ["poster"], "canvas": "single",
    "caption": "A minimalist travel poster with cream background, blue mountain illustration below, and exact title SUMMER MARKET at top."},
  "items": [
    {"label": "text", "caption": "Large dark-blue title centered at top.",
     "text": "SUMMER MARKET", "bbox": [-416, -384, -288, 384]},
    {"label": "object", "caption": "A flat blue mountain illustration in lower center.",
     "bbox": [-192, -288, 384, 288]}
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
面对一张包含 20 个元素的信息图,没人会手写这些边界框。早期用户常用的做法是:让支持视觉能力的 LLM 根据需求或草图起草 JSON,再手动调整坐标后生成。日本测试者 @chimolog7 说得很直接:bbox 格式对人类太难,因此他让 Opus 来生成;随后他发现 MOSS 的日文渲染中,主观感知的错字率仅约 1%,而 Krea 2 仍经常拼错(原帖)。
另一个实用技巧是可控重生成。由于模型仅支持文生图,没有参考图输入,无法对一张照片做 img2img 并保留原图特征。不过,你可以只修改一个框的文字或位置、保持同一种子并重新生成,其他布局通常会大体维持不变。用户 @li9292 曾用一张包含数千个中文字符、20 个边界框的周报封面演示过:在保持同一种子的前提下,只修改一个框,其余布局依旧稳定(原帖)。对要求文案准确的工作而言,这种“单框修改 + 固定种子”的循环,比任何风格预设都更重要。
如果想了解更广泛的文字渲染背景,可参考我们的2026 年最佳文字渲染图像模型测试,它也说明了为何这个领域需要一款以布局为先的产品。
如何调用,以及“免费”实际意味着什么
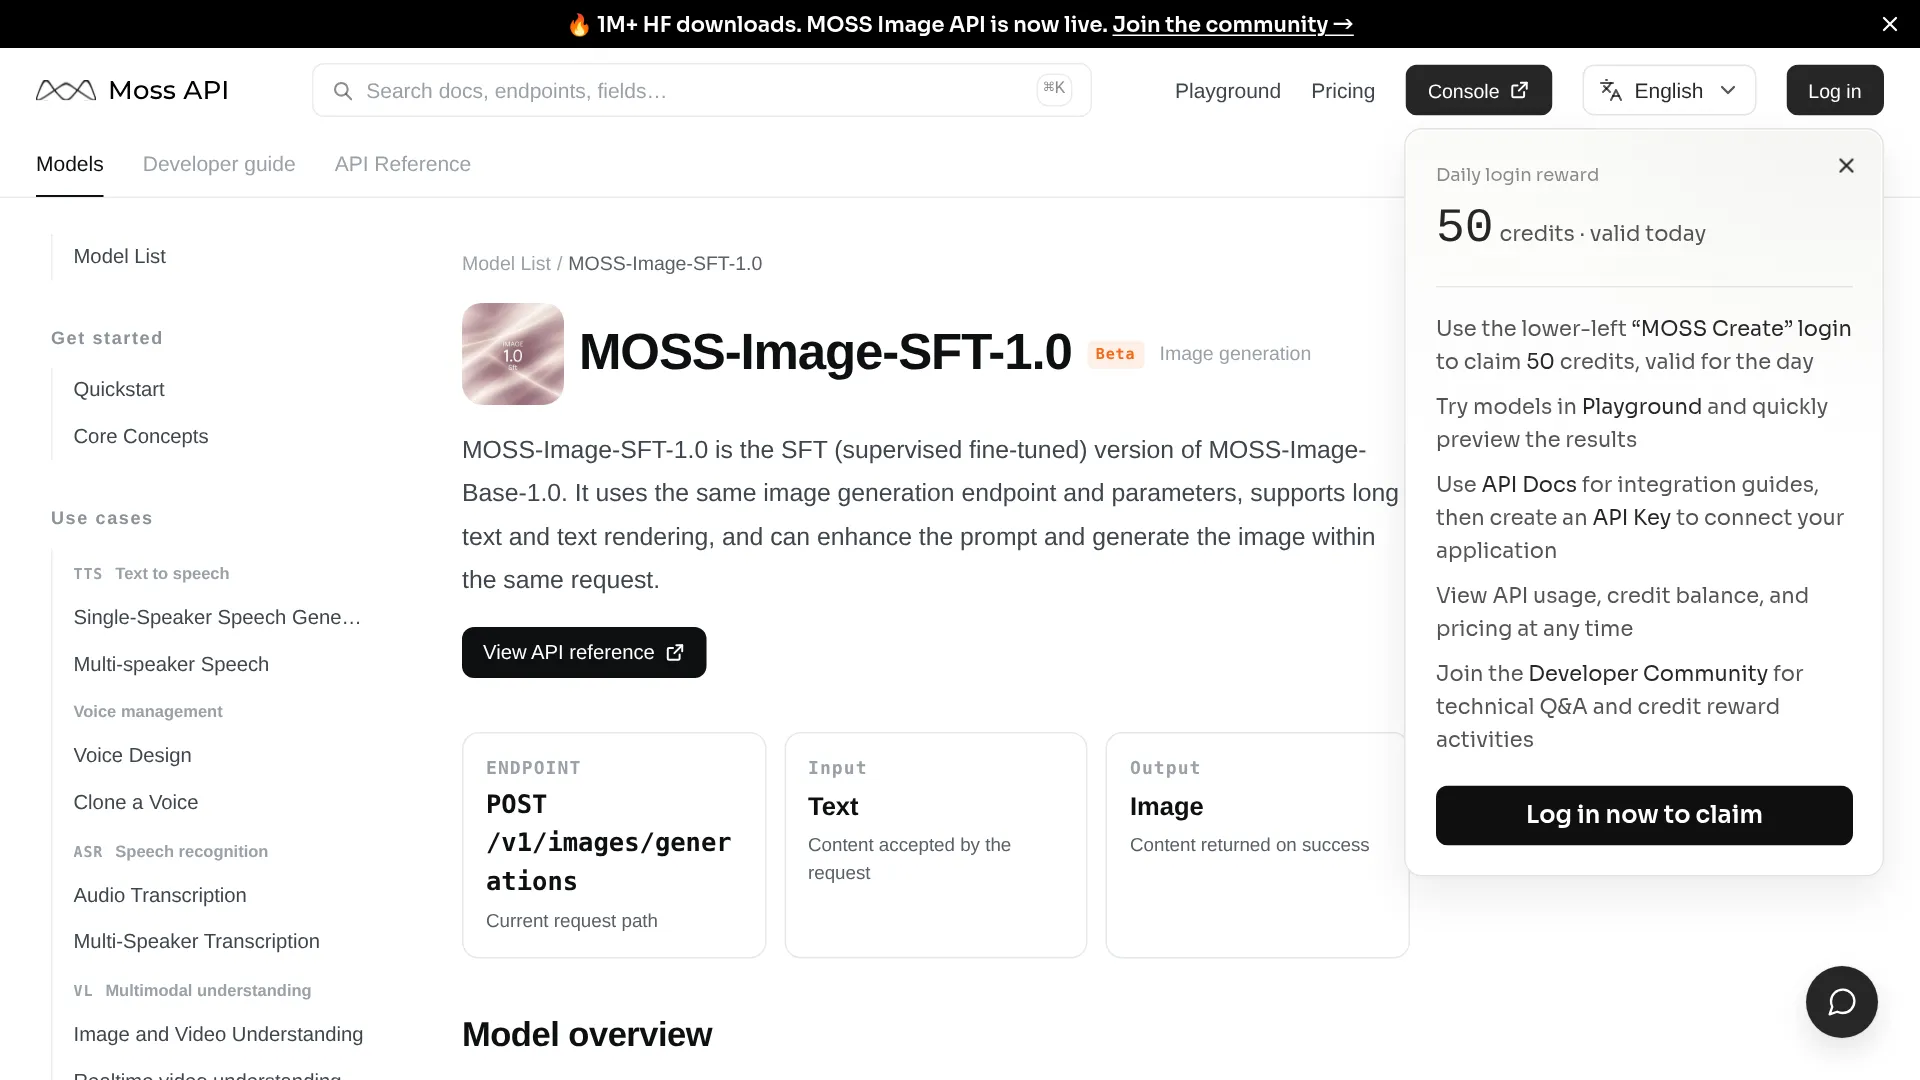
托管服务只有一个端点。MOSI API 文档列出 moss-image-sft-1.0 使用 POST /v1/images/generations:输入为文本,输出为图像;不支持图像输入、音频、视频、流式返回或异步任务 API。提示词增强已内置但默认关闭,可通过 prompt_enhance: true 开启,增强器版本由服务端选择。
curl https://platform.mosi.cn/v1/images/generations \
  -H "Authorization: Bearer $MOSI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moss-image-sft-1.0",
    "prompt": "A cafe menu card on a light oak table, exact heading MORNING MENU",
    "size": "1024x1024",
    "prompt_enhance": false
  }'
需要框级控制时,将完整 JSON 布局字符串作为 prompt 传入即可;上面的简短自然语言示例则是最容易直接复制调用的形式。
在本文核查时,计费状态显示为 Free for a limited time,价格是 0 credits,并附有后续完整定价链接。Base 与 SFT 对比指南也提到同一问题:Playground 自 10 月 20 日上线,但尚未公布长期单张价格。因此应据此规划预算:免费窗口可用于原型验证,之后则要计算服务商费率,以及因错字废图造成的拒绝率。
本地推理没有单张费用,但硬件成本并不低。10 月 20 日核查的 Comfy-Org 文件列表显示,BF16 权重总计约 29.72 GB,尚未包含环境和缓存:骨干模型约 10.16 GB,文本编码器约 19.31 GB,small VAE 约 0.25 GB。INT8 ConvRot 可将 Transformer 占用大致减半,骨干约 5.41 GB、编码器约 9.75 GB;另有 W4A8 GPTQ 编码器方案,容量约 7.34 GB。
| 配置 | 需要下载的内容 | 实际使用提示 |
|---|---|---|
| 完整 BF16 | 29.72 GB 权重 + 运行内存 | 即使 32 GB 显存、不开启卸载也很紧张;系统内存和提示词长度都会影响运行 |
| INT8 量化 | 约 15 GB 级别 + 卸载 | 已有记录显示,约 100 万像素、每批 1 张时可走 12 GB 路径(本文引用的社区测试中峰值约 9.7 GB);8–12 GB 显卡建议从这里开始 |
| 社区 8 步 DMD / 4 步方案 | 适配器 + 匹配工作流 | 同一份 100 万像素 RTX 3060 报告中约为 24 秒,对比约 137 秒;但早期适配器会损失细节表现,先建立 50 步基线 |
官方采样基线是:1024x1024 下使用 Euler、50 步、CFG 3.0、shift 5.0,并在第 22 层启用跳层引导。原生 ComfyUI 支持于 10 月 16 日合并(公告在此);更新 ComfyUI 后,搜索 MOSS-Image 模板,并使用与 Base 或 SFT 对应的工作流及 Comfy-Org 文件,不要把插件图与原生加载器混搭。
如果你还在比较不同服务商的总体成本,我们的最便宜图像生成 API拆解可作为估算 GPU 时间和废图成本的参考。
闭源模型仍然领先的地方
在把成品设计完全押注到这套技术栈前,必须正视它公开列出的限制。当前版本仅支持文生图,不支持图像编辑,也没有参考图输入;基于参考图的生成被列为未来工作。如果必须保留上传照片的特征,或让角色在多张图中保持一致,应改用原生支持编辑的模型,例如适合生产编辑流程的 Qwen Image 2.1。
人物表现和视觉品味是第二个差距。50 亿参数的规模下,人脸可能显得泛化,人物比例容易漂移,手部也会出现常见问题。
“它的人物比例也做不好,常见的‘坏手’和类似问题同样不擅长。”—— @SlipperyGem
已有的实测也支持在交付前逐项检查:短提示词、具名角色、艺术家标签和精确约束的表现仍不稳定;小字号文字需要校对;英文和中文基准之外的语言也要人工检查。官方 50 步配置对中等硬件负担不轻,而快速适配器则以光照细节和约束跟随能力换取速度。每一张保留图都应记录检查点、编码器、VAE、精度、提示词、种子,以及包含编码过程在内的耗时。
追求速度的本地服务也从硬件角度说明了同样的问题。Lucebox 测得,在使用其自有内核的 Radeon AI PRO R9700 上,1024x1024、8 步、CFG 1 的生成耗时为 2.7 秒;在相同设定下,端到端速度比 DGX Spark 上的 ComfyUI 快 1.8 倍。但其人工检查发现,CFG 1 时 8 张输出中有 4 张形状失真;CFG 2.5 时为 8 张中 1 张,不过耗时升至 5.2 秒。更快,不代表一定更实用。
MOSS Image API 常见问题
MOSS Image 可以免费商用吗?
权重和附带代码以 Apache 2.0 发布,允许商用和微调,无需支付许可证费用。托管端点有各自的定价和内容规则,第三方量化版本或 LoRA 也各自适用不同条款。
Base 和 SFT,API 应该用哪个?
托管 API 提供的是 SFT,即团队推荐用于生成的微调检查点 moss-image-sft-1.0。现在要制作海报和信息图,下载 SFT;要进行微调或训练 LoRA,则下载 Base。
12 GB 显存能运行吗?
可以。已有文档记录了 12 GB 配置:使用量化工作流和 CPU 卸载,约 100 万像素、每批一张图。
能编辑照片,或让角色始终保持同一形象吗?
不能。已发布的骨干模型不以参考图为条件输入。复用种子并修改 JSON 可以引导重生成,但不能保留上传照片,也无法保证身份一致性。
哪些人适合接下来调用 MOSS Image
| 你的工作 | 适合调用 MOSS Image 的情况 | 适合换用其他模型的情况 |
|---|---|---|
| 带精确文案的海报、菜单、幻灯片或 UI 模型图 | 长双语文字和框级定位比写实人物更重要 | 只有一句标语——闭源模型的提示词写法更快 |
| 电商或编辑生产流程 | 可以加入 LLM 转 JSON 与校对环节,并希望获得可自托管、可微调的 Apache 2.0 权重 | 现在就需要 img2img、局部重绘或参考图锁定角色 |
| 预算有限的本地开发者 | 可以接受 12 GB 显存加量化,或 MOSI 免费窗口足以覆盖原型需求 | 需要有保障的吞吐量、流式响应或异步任务——托管 API 目前均不提供 |
对于能明确指定布局的重文字设计工作,MOSS Image 是少见的开源模型:它的约束系统本身就是产品价值所在。至于任何需要“这张脸始终还是这张脸”的任务,应把它视为闭源图像模型身边的排版引擎,而不是替代品。