 AIREITER
OpenRouter 在 2026 年 10 月 28 日重做了默认路由:首 token 延迟降低 16.9%,整体 429 事件减少 67%,请求成本则上升约 6%。自动路由可能在你没有察觉的情况下把请求转到更贵的 Provider,因此真正需要关注的不是某个单项指标,而是这笔性能与成本之间的交换。
OpenRouter 的新路由器不再只挑输入 token 单价最低的 Provider。它会估算一次成功得到答案的实际代价——价格、等待时间和重试成本都会算进去——然后把请求交给 Routing Cost 最低的 Provider。
30 秒看懂结论:数据证明了什么
OpenRouter Provider Routing 现在优化的是 Routing Cost,而不是 prompt token 价格。只要请求没有显式设置 provider.sort、provider.order、provider.only 或 provider.ignore,就会自动采用这套逻辑。根据 OpenRouter 的公告,这项改动覆盖了约 77% 的流量,也就是那些由多个 Provider 同时提供服务的模型。
结果来自为期一周的 switchback 测试:共覆盖 2400 万次请求和 1030 亿个输入 token,新旧路由器各分配一半流量。
| 指标 | 旧路由器 | 新路由器 | 变化* |
|---|---|---|---|
| TTFT p50 | 1,007 ms | 837 ms | 降低 16.9% |
| 吞吐量 p50 | 62.4 tok/s | 72.6 tok/s | 提高 16.3% |
| 至少遇到一次 429 的请求 | 7.1% | 3.8% | 降低 3.3 个百分点;429 事件整体减少 67% |
| 需要重试的请求 | 10.4% | 6.9% | 降低 3.5 个百分点;重试整体减少 47% |
| 每 1,000 次请求成本 | $1.25 | $1.32 | 提高 6.0% |
| 每百万 token 成本 | $0.301 | $0.324 | 提高 7.3% |
\*请求占比和事件数量变化均来自官方公告:67% 和 47% 分别指全部 429 事件与全部重试次数的降幅,而不是命中率的比例,因为一次请求可能触发多次错误。
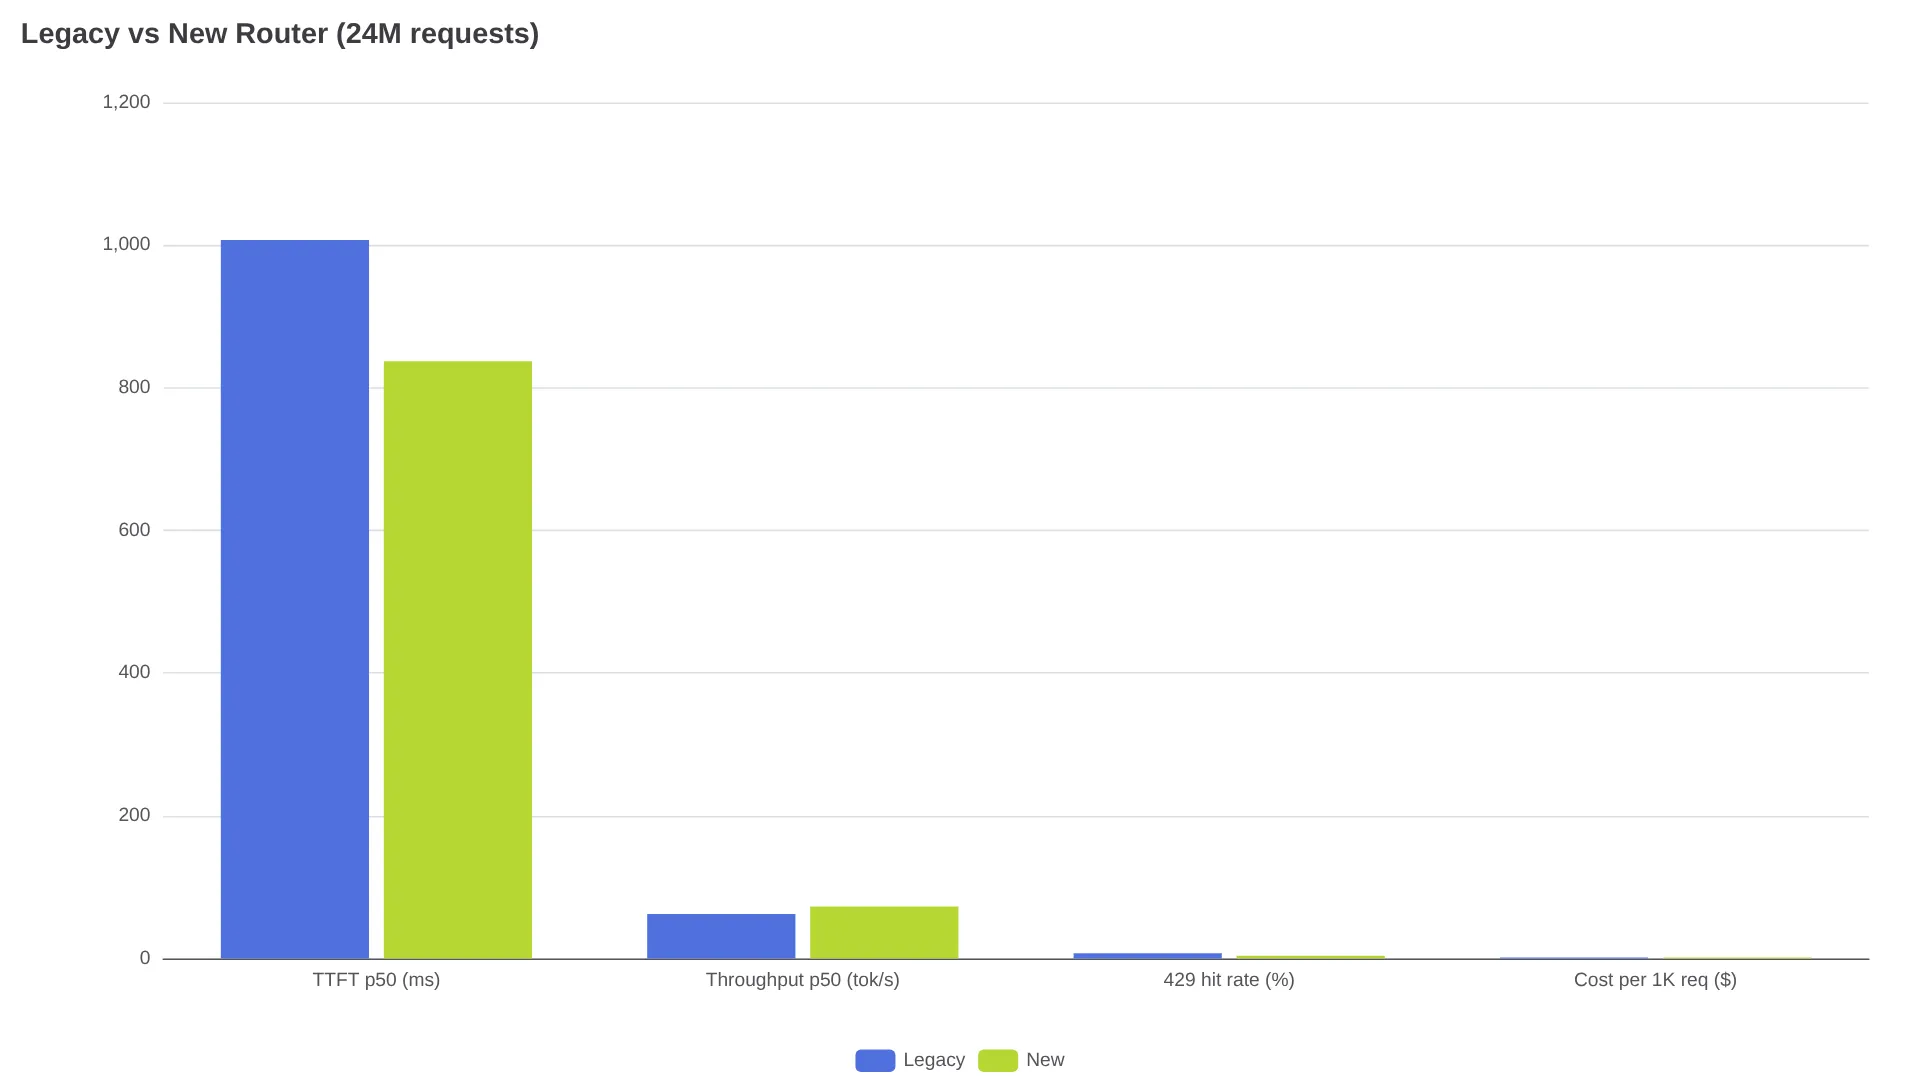
根据公告,调用方测得的 TTFT p95 从 6,032 ms 降至 4,504 ms,完整请求的 p50 从 4.00 秒降至 3.24 秒,而失败尝试浪费的时间则从每次请求 349 ms 降至 242 ms。
结论很简单:如果能接受约 6% 的成本上涨,交互式聊天和 Agent 可以继续使用新的默认路由;对于每一分钱都要精打细算的大型批处理任务,则建议切回仅按价格路由。
用大白话理解 Routing Cost
Routing Cost 实际上在回答两个问题:一次尝试要花多少钱,以及这次尝试成功的概率有多高。OpenRouter 给出的例子是:一次尝试成本 $0.40,加上等待成本 $0.60,总计 $1.00;再除以 80% 的成功率,得到每次成功回答 $1.25 的成本。成本最低的 Provider 会获得更多流量。
这个数字由三部分组成:
- 看实际价格,不看标价。 OpenRouter 会根据近期流量估算输入和输出 token,再结合每个 Provider 的真实缓存命中率和 token 价格。公告中的计算示例是:4 万个未缓存输入 token,按 $2.00/M 计算为 $0.080;6 万个已缓存输入 token,按 $0.50/M 计算为 $0.030;约 4,000 个输出 token,按 $8.00/M 计算为 $0.032,合计 $0.142。某个 Provider 即使输入价格很低,只要缓存 token 或输出 token 更贵,也会在这里失去优势。
- 把等待时间折算成钱。 吞吐量按端到端输出 token/秒计算,并包含首 token 延迟(例如:等待首 token 5 秒,之后在 5 秒内输出 500 个 token,吞吐量就是 50 tok/s)。路由器会根据各模型常见的 Provider 费用与速度,为等待时间换算出相应成本。首 token 延迟的权重更高,因为 Agent 的工具调用链每一步都要等它返回。
- 计算失败成本。 429 意味着 Provider 拒绝了请求,因此你不仅要等待拒绝结果,还要把请求重新发送到别处(例如等待 2.50,再乘以 0.4% 的发生率,增加 0.01 的成本)。可靠性错误的惩罚更重,约为普通错误的 8 倍:1% 的错误率会让成本上升约 8%;如果某个 Provider 的表现远差于同类 Provider,它会在恢复前停止获得流量。目前质量评估还会检查工具调用格式是否正确(95% 格式正确会让成本增加约 5%);被标记的 Provider 会被降至测试流量,具体以公告为准。
为了避免流量全部涌向一个赢家,系统设置了两道保护机制,公告对此有说明:每个 Provider 都会保留少量流量,以便及时发现恢复情况;同时,路由器会降低故障 Provider 的流量,学习每个 Provider 的容量上限,并把超出的请求分流到其他地方。
为什么默认路由仍可能让生产应用出问题
用户反馈显示,有四类反复出现的问题,是单看每 token 价格完全无法捕捉的。
工具调用链中途切换,Schema 可能失效
真正让我工具调用出问题的是请求中途的 Provider 切换,而不是某个 Provider 的标价。
— u/Michael_Jeffords,r/openrouter 关于应避免哪些 Provider 的讨论
目前的质量评分主要看工具调用格式是否正确,以及基准测试准确率标记,公告对此有说明。但在一段对话进行到一半时切换 Provider,仍可能改变量化方式或拒答行为,因为不同 Provider 的质量并不一致,有些还会提供量化程度更高的模型变体。
缓存失效,账单随之暴涨
有一篇讨论记录了约 70 万 token 的上下文:原本预计每次请求只需 $0.20,Provider 切换后却接近 $2.00。这正是用户所说的“缓存坏了之后,费用贵了 10 到 32 倍”。根据 OpenRouter 的缓存感知路由说明,新路由器会在缓存仍热时将会话固定到原始 Provider,并且只对第一次请求进行算法选择;但一旦故障转移到另一个 Provider,这种黏性就会失效。解决问题的用户通常会通过黏性会话固定一个 Provider。
我觉得这暴露了 OR 一个很根本的问题:你必须提前手动配置这些东西。
— u/welcome_to_milliways,r/openrouter 关于缓存失效导致费用暴涨的讨论
无提示的高价故障转移
一份生产环境报告指出,部分流量在服务状态仍显示正常的情况下,从 Sonnet 悄悄切换到了价格约为其 5 倍的 Opus,整体消耗也从每小时 $184 飙升至 $412,详见 @CarbonOnX。新路由器把这种取舍摆到了明面上:一个更快、更可靠的 Provider,完全可能排在最便宜的 Provider 前面。
付费账户也会遇到 429
正如这篇 429 讨论中的用户指出的那样,OpenRouter 账户有余额,并不会增加上游 Provider 的容量。429 反映的是该 Provider 为这个模型提供的共享资源池状态。重做后的路由在测试中将 429 事件减少了 67%,但在生产环境中,固定或忽略受到限流的 Provider 仍然是解决问题的办法。可以先阅读如何修复 OpenRouter 429 错误,再参考OpenRouter Auto Router 指南,了解旧版按价格加权的默认路由。
三种真正适合生产环境的路由方案
选择哪种方案,取决于你更看重免维护的速度、严格的成本上限,还是确定性行为。三种方案都使用同一个 provider 对象:provider.order 会绕过新逻辑,严格按指定顺序尝试 Provider;provider.only 和 provider.ignore 会先筛选候选者,再由新算法在剩余 Provider 中选择;而任何显式设置的 provider.sort(price、throughput、latency)都会替代新算法。
1. 继续使用新默认路由(交互式聊天和 Agent)
不需要修改代码。对于面向用户的聊天应用和多步骤 Agent,这种方案尤其合适,因为每次工具调用都要等待首 token——接受约 6% 的额外成本,换取更低的延迟和更少的重试。连续记录一周实际提供服务的 Provider(信息会返回在 API 响应和 activity 页面中),同时观察 TTFT p50 与 429 比率:如果你的 429 占比仍接近约 4% 的新基线,且缓存命中率保持稳定,就可以继续使用;如果某个 Provider 占据了大多数故障,或者缓存命中率明显下滑,就切换到方案 3。
2. 锁定最低成本路径(批处理任务和成本受限场景)
如果成本比速度更重要,可以通过以下三种方式优先采用按价格路由:
{ "provider": { "sort": "price" } }也可以在模型 slug 后追加 :floor(meta-llama/llama-4-maverick:floor),或者在账户设置中将默认排序方式设为价格,详见公告 FAQ。需要注意的是,根据 OpenRouter 路由指南,:floor 还会纳入 flex-tier endpoint,而单独使用 sort 不会。
再配合价格上限:
{ "provider": { "sort": "price", "max_price": { "prompt": 1.0, "completion": 2.0 } } }适合大输入、短输出,以及成本敏感的重试场景。
3. 固定稳定的 Provider(带缓存或工具调用的生产应用)
当正确性、缓存命中率或合规要求比每次请求的动态优化更重要时,就应该固定 Provider:
{
  "provider": {
    "order": ["deepinfra", "together"],
    "allow_fallbacks": true,
    "require_parameters": true
  }
}
require_parameters 只能排除缺少必要请求参数的 endpoint,并不能保证不同 Provider 的工具调用或 Schema 行为完全一致。只有在合规或 BYOK 场景下,才建议使用 allow_fallbacks: false 的 order,因为这类场景宁可服务中断,也不能切换到未经批准的 Provider。对大多数应用而言,应允许故障转移,使用 only/ignore 缩小范围,并传入稳定的 session_id 以复用热缓存(黏性路由)。如果某个 Provider 经常出问题,可以在防护规则中屏蔽它,并比较直接调用 Provider API 的效果——有几位用户表示,在模型确定之后,改为直接调用就解决了速度慢和缓存问题(讨论示例)。
| 如果你的场景是…… | 建议使用 | 原因 |
|---|---|---|
| 原型开发、混合流量 | 新默认路由,不做配置 | 测试中的重试更少 |
| 面向用户的 Agent | 新默认路由 + require_parameters | 保留 TTFT 优势,同时避开不兼容的 endpoint |
| 每晚批处理、1 亿 token 以上 | sort: price 或 :floor + max_price | 收回 6%–7% 的额外成本 |
| 带缓存的长上下文 | 固定 order + session_id | 避免缓存未命中导致重新计价 |
自动路由确实比以前更好,但当一次糟糕的 Provider 切换所造成的损失,超过一周略高的 token 单价时,它仍然无法替代固定 Provider。
常见问题
使用新路由需要修改代码吗?
不需要。没有显式设置 provider sort、order、only 或 ignore 的请求,会自动使用新路由器。
如何继续使用仅按价格路由?
将 provider.sort 设置为 "price",追加 :floor,或者把账户默认排序方式设为价格。
新路由会覆盖我的 Provider order 吗?
不会。order 会绕过新路由;only/ignore 会先筛选候选者,然后再由新算法进行选择。
新路由会让成本增加吗?
请看上面的结论表:测试中每 1,000 次请求成本增加 6.0%,每百万 token 成本增加 7.3%。
如何查看实际处理请求的 Provider?
根据 OpenRouter 文档,查看 API 响应中的 provider 字段和 activity 页面。
为什么付费账户仍然会遇到 429?
原因是上游共享资源池的限制,而不是账户余额。请固定或忽略受到限流的 Provider。