 AIREITER
GLM-5.3 于 2026 年 8 月 14 日发布。Z.ai 表示,它的编程能力较 GLM-5.2 提升 50%,并新增网络安全能力,在 CyberGym 上获得了 84.5% 的成绩。另一边,DeepSeek V4 Pro 已开放完整 API,提供 MIT 许可证开源权重,模型卡标注的 SWE-Bench Verified 成绩为 80.6%,NIST 独立测得 81%。不过,真正改变这场对比格局的是接入方式:GLM-5.3 目前没有公开 API,只能通过 Z.ai 托管产品 ZCode 和 GLM Coding Plan 使用。
关键差异在于接入方式,而不是 API 对 API
DeepSeek V4 Pro 发布时便在 Hugging Face 上提供了 MIT 许可证权重,同时拥有写明文档的 api-docs.deepseek.com API,也能通过 SiliconFlow 等第三方平台托管。你现在就可以自行部署,通过任意兼容 OpenAI 的客户端接入,或者从 Claude Code、Cline 及自有脚本中调用。
GLM-5.3 则走了一条相反的路线。Z.ai 在其发布公告中称,模型已可通过 GLM Coding Plan 与 ZCode(Z.ai 自家的编程 IDE)立即使用;但 API 和开源权重要等到完成“严格的安全评估”后才会陆续推出。这意味着目前没有 model: glm-5.3 端点、无法从 Hugging Face 下载,也没有第三方推理服务。Z.ai 尚未给出时间表。
编程基准:厂商说法与已验证成绩
GLM-5.3 与 DeepSeek V4 Pro 都是面向 Agent 编程的大型中国 MoE 模型,但两者的证据成熟度并不处于同一阶段。
根据 Z.ai 的发布材料,GLM-5.3 基于其 743B 基座模型进行后训练,并非采用全新架构;其“顶级的编程与 Agent 能力”主要来自后训练。中文版公告还给出了更具体的说法:编程性能较 GLM-5.2 提升约 50%,在 Terminal-Bench 3.0 的开源模型中排名第一,白盒代码审查能力与 Mythos 5 相当。作为参考,Z.ai 的发布说明显示,GLM-5.2 在 Terminal-Bench 2.1 上取得 81.0 分,当时是开源权重模型中的最高分,但仍低于 Claude Opus 4.8 的 85.0 分。
DeepSeek V4 Pro 的数据则有独立验证支撑。其 Hugging Face 模型卡给出的成绩是 SWE-Bench Verified 80.6%、HumanEval Pass@1 76.8%。NIST 的 CAISI 评测独立测得其 SWE-Bench Verified 成绩为 81%。该模型采用 1.6T 参数 MoE 架构,激活参数为 49B,支持 1M token 上下文和最高 384K token 输出。
| 指标 | GLM-5.3 | DeepSeek V4 Pro |
|---|---|---|
| 架构 | 743B 基座,后训练 | 1.6T 总参数 / 49B 激活参数 MoE |
| 上下文窗口 | 未说明(GLM-5.2:1M) | 1M token |
| 最大输出 | 未说明(GLM-5.2:128K) | 384K token |
| 编程基准 | Terminal-Bench 3.0 开源模型第一(厂商说法) | SWE-Bench Verified 80.6%(模型卡 + NIST) |
| 网络安全 | CyberGym 84.5%;白盒审查能力与 Mythos 5 相当 | 没有对应定位 |
| 开源权重 | 承诺在安全评估后发布 | MIT 许可证,现已提供 |
| API | 尚未开放 | 已可用(官方 + SiliconFlow) |
Terminal-Bench 与 SWE-Bench 衡量的并不是同一种能力。前者测试 Agent 执行终端任务的表现,后者评估自动生成 pull request 修复补丁的能力。因此,不能把 Terminal-Bench 3.0 的排名直接与 SWE-Bench Verified 的百分比分数相比较。
GLM-5.3 还带来了 DeepSeek V4 Pro 未覆盖的网络安全方向。Z.ai 将它定位为“可用于网络防御”,并公布了 84.5% 的 CyberGym 成绩。不过,这些数据均由厂商报告,尚未得到独立验证,更适合作为趋势信号而非定论。Z.ai 还称,GLM-5.3 比 GLM-5.2 能以更少的输出 token 获得更好结果;如果这一效率能经受独立测试,那么单任务成本也会随之降低。
订阅制还是按 token 付费:成本该怎么算
DeepSeek V4 Pro 官方 API 按每百万 token 计费:
| Token 类型 | DeepSeek 官方 API |
|---|---|
| 未缓存输入 | $0.435 / M tokens |
| 缓存输入 | $0.003625 / M tokens |
| 输出 | $0.87 / M tokens |
GLM-5.3 目前只能通过 GLM Coding Plan 订阅使用:
| 套餐 | 月费 | 额度 |
|---|---|---|
| Lite | $18 | 10,000 credits/week |
| Pro | $80 | Lite 使用量的 6× |
| Max | $168 | Lite 使用量的 14× |
GLM Coding Plan 没有说明一个“credit”对应多少 token,因此无法进行精确的直接成本对比。DeepSeek 按 token 计费,几乎没有最低承诺;GLM Coding Plan 则无论实际使用量多少,均按固定月费收费。
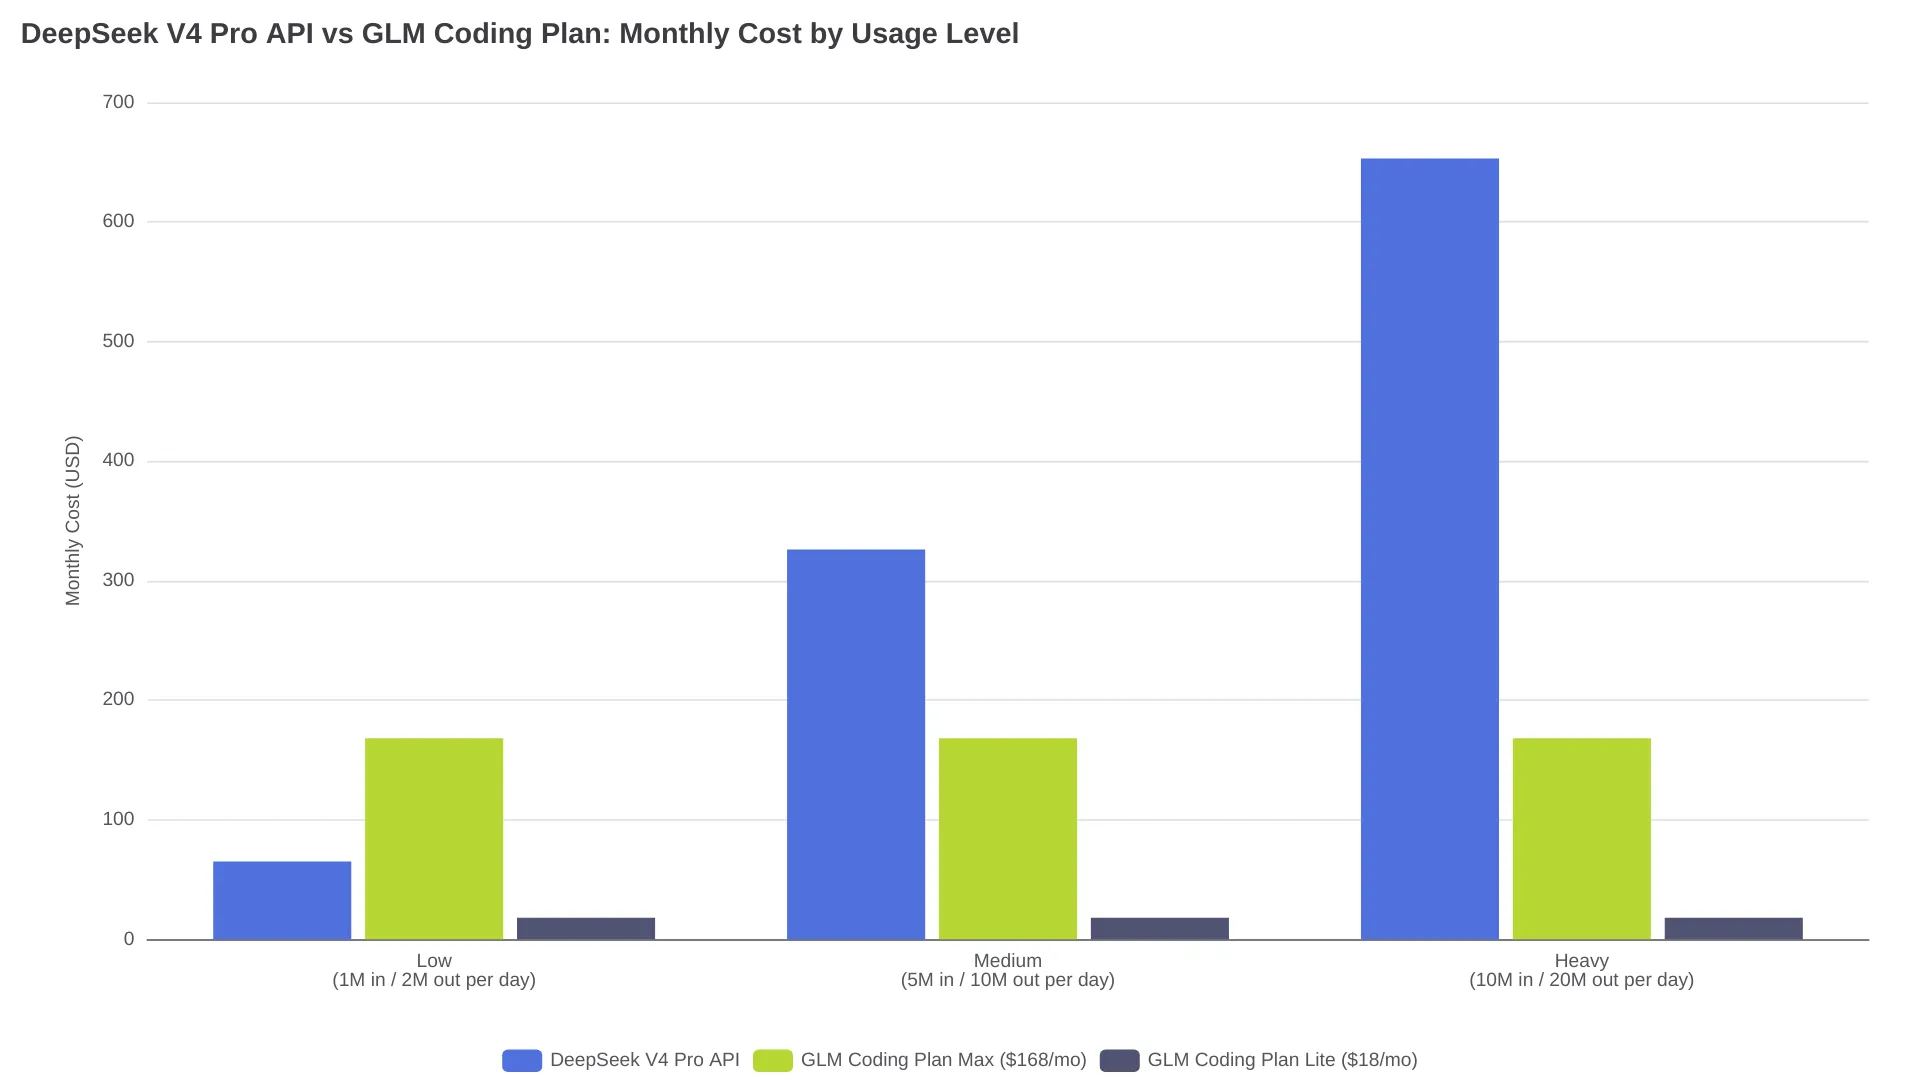
以 DeepSeek 为例:若每天使用 1M 未缓存输入和 2M 输出 token,相当于一次中等强度的编程会话,API 月成本约为 $65。若规模增加到每天 5M 输入和 10M 输出,月账单将达到 $326。对于重复使用的代码库,$0.003625/M 的缓存输入价格可以显著压低成本。GLM 的 Max 套餐固定为 $168/月,避免了按量计费的意外支出;但它能否覆盖相同工作量,仍取决于尚未公开的 credit 与 token 换算关系。
Reddit 开发者的实际反馈
在近期一则 r/ZaiGLM 讨论帖中,一位同时使用过两款模型的用户表示:
“这个任务比 GLM 完成得更快,但需要更多大量的人工引导。”
同一讨论中,也有用户采用多模型工作流:用 GLM 写代码和浏览仓库,用 DeepSeek V4 Flash 做代码审查。另一位用户则提醒,DeepSeek V4 Pro 当时只上线了约 24 小时,不应过早下结论。这些只是单一社区帖子中的个人经验,并非受控基准测试。
按你的使用场景来选
| 你的情况 | 建议 |
|---|---|
| 现在就需要 API 或 CI/CD 集成 | DeepSeek V4 Pro —— GLM-5.3 尚无公开 API |
| 希望为数据驻留要求自行部署 | DeepSeek V4 Pro —— Hugging Face 上现已提供 MIT 权重 |
| 主要在 IDE 中编码,希望使用托管式助手 | 通过 GLM Coding Plan 或 ZCode 使用 GLM-5.3 |
| 预算有限的个人开发者 | 低用量下,DeepSeek V4 Pro 的按 token 成本更低;GLM Lite($18/月)则可固定支出上限 |
| 安全审计或漏洞研究 | 优先测试 GLM-5.3 —— CyberGym 84.5% 很有特色,但尚无独立验证 |
| 长时间、高规模的 Agent 编程 | GLM Coding Plan Max($168/月固定)可限制成本;先确认 credit 额度能覆盖你的工作量 |
| 现有代码很少的新项目原型 | 两者皆可 —— 都能处理新代码,按你偏好的接入模式选择即可 |
如果你已经在使用 GLM-5.2 Coding Plan,那么在同一订阅内升级到 GLM-5.3 是阻力最小的选择。如果你需要 DeepSeek V4 Pro 的 API,可以参考我们的 DeepSeek V4 Pro GA API 指南,其中涵盖端点配置和价格优化。若想把上一代 GLM 也纳入比较,请查看我们的 GLM-5.2 vs DeepSeek V4 Pro 对比分析。
常见问题
GLM-5.3 会开放公开 API 吗?
会。Z.ai 表示,API 和开源权重将在完成安全评估后分阶段发布,但尚未公布具体日期。
这两个模型能自行部署吗?
DeepSeek V4 Pro:可以。MIT 许可证权重已发布在 Hugging Face。这款 1.6T 参数 MoE 模型在未量化的 FP16 状态下大约需要 3.2TB VRAM,使用 4-bit 量化时约需 800GB,因此需要由 H100 或 H200 组成的多 GPU 集群。GLM-5.3:暂时不行。其开源权重承诺将在安全评估后发布,许可证尚未披露。
每天重度编程时,哪个更便宜?
取决于用量。每天使用 1M 输入和 2M 输出 token 时,DeepSeek V4 Pro 月成本约为 $65;增至每天 5M 输入和 10M 输出时,成本会达到 $326。GLM Coding Plan Max 的月费为 $168,在这一高用量下低于 DeepSeek,但前提是未公开的 credit 额度足以覆盖该工作量。正式投入前,最好先用真实工作负载测试两者。
GLM-5.3 支持视觉或图片输入吗?
不支持。Z.ai 将视觉能力放在独立的 GLM-V 产品线中,包括 GLM-5V-Turbo、GLM-4.6V 和 GLM-OCR。GLM-5.3 是文本与代码模型。DeepSeek V4 Pro 同样仅支持文本。
现在比的不是能力,而是上线时机
从纸面信息看,GLM-5.3 更具吸引力:编程能力提升 50%、拥有独特的网络安全定位,并宣称 token 效率更高。但这些数字都来自刚发布数小时的厂商公告,尚无 API、开源权重或独立基准验证。DeepSeek V4 Pro 则提供了 GLM-5.3 目前无法匹敌的东西:可用性、经过验证的基准成绩,以及可部署的模型权重。若你现在需要 API 或自部署,应选择 DeepSeek;同时可以关注 GLM-5.3 的 API 发布,并在自己的代码库上进行正面对比测试。