 AIREITER
Gemini 3.6 Flash 上线仅三周后,Google 就推出了Gemini 3.7 Flash。最直观的变化出现在软件工程能力上:DeepSWE v1.1 从 48.6% 提升至 65.3%。两款模型在 2026 年 12 月前均采用每百万 token 输入 $0.75、输出 $3.75 的优惠定价,因此切换不会增加单 token 成本。不过,这次升级对不同类型工作负载的实际价值并不完全一样。
18 项基准测试对比:Gemini 3.7 Flash 全面对阵 3.6 Flash
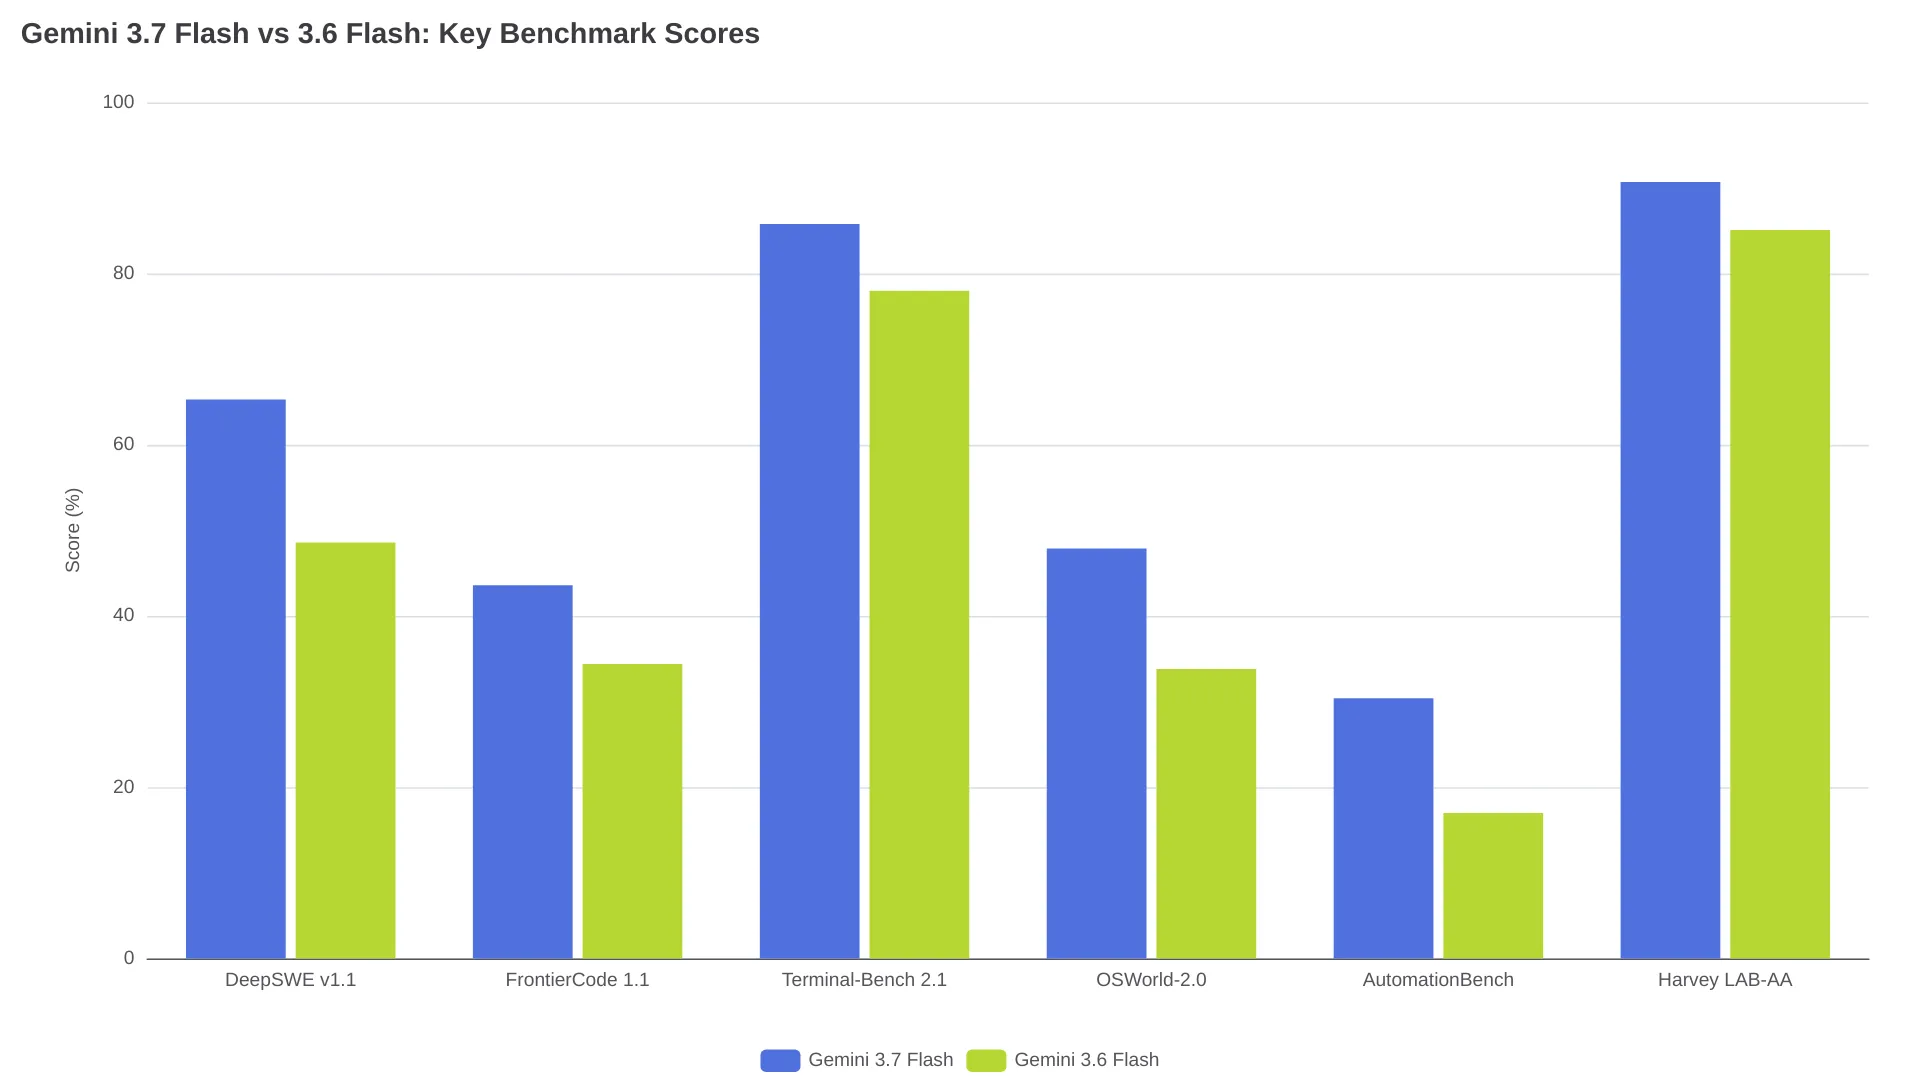
Google DeepMind 的官方模型页面显示,Gemini 3.7 Flash 在整体能力上普遍领先,其中代码智能体和企业自动化相关项目的提升最为明显。下表汇总了 Google 同时公布两款模型成绩的全部 18 项指标,并列出 Claude Sonnet 5 与 GPT-5.6 Terra 作为参考。
| 基准测试 | Gemini 3.7 Flash | Gemini 3.6 Flash | 差值 |
|---|---|---|---|
| Artificial Analysis Intelligence Index(综合指标) | 56 | 52 | +4 |
| FrontierCode 1.1(生产级代码质量) | 43.6% | 34.4% | +9.2 |
| DeepSWE v1.1(长周期软件工程) | 65.3% | 48.6% | +16.7 |
| Code Arena(Web 开发 Elo) | 1588 | 1538 | +50 |
| Terminal-Bench 2.1(智能体终端编程) | 85.8% | 78.0% | +7.8 |
| Terminal-Bench 3.0(通用智能体能力) | 14.9% | 5.4% | +9.5 |
| AutomationBench(企业工作流自动化) | 30.4% | 17.0% | +13.4 |
| GDPVal-AA v2(知识工作 Elo) | 1525 | 1422 | +103 |
| Harvey LAB-AA(复杂法律工作流) | 90.7% | 85.1% | +5.6 |
| GDP.pdf(专家级 PDF 理解) | 34.0% | 22.0% | +12.0 |
| CharXiv,不使用工具(图表推理) | 84.5% | 85.2% | −0.7 |
| CharXiv,使用工具 | 88.7% | 89.4% | −0.7 |
| LVBench(长视频理解) | 85.4% | 84.2% | +1.2 |
| GDM-MRCR v2,128k(长上下文检索) | 97.0% | 91.8% | +5.2 |
| OSWorld-2.0(智能体计算机操作) | 47.9% | 33.8% | +14.1 |
| Agent's Last Exam(桌面智能体任务) | 26.3% | 24.2% | +2.1 |
| HLE-Verified(跨学科专家推理) | 53.6% | 51.2% | +2.4 |
| LABBench2(生物学研究任务) | 82.1% | 76.1% | +6.0 |
以上数据均由 Google DeepMind 在3.7 Flash 模型页面发布。目前多数基准测试尚未有独立复现结果,因此更适合将这些差值理解为能力方向,而非对特定工作负载的确定性承诺。
代码与智能体任务:3.7 Flash 拉开差距的主战场
两款模型间最明显的差距集中在代码和智能体基准测试。衡量真实代码库长周期软件工程任务的 DeepSWE v1.1,成绩从 48.6% 大幅升至 65.3%,提高 16.7 个百分点。按同一项指标计算,这一成绩已超过 Claude Sonnet 5 的 53.8%,介于其与 GPT-5.6 Terra 的 69.6% 之间;所有对比数据均来自DeepMind 基准测试表。
其他面向智能体的测试也呈现出类似的跃升:
- Terminal-Bench 3.0:衡量多工具智能体能力,5.4% → 14.9%,接近三倍
- AutomationBench:企业工作流自动化,17.0% → 30.4%
- FrontierCode 1.1:生产级代码质量,提高 9.2 分
- OSWorld-2.0:智能体计算机操作,33.8% → 47.9%
Reddit 早期用户的看法,也反映出跑分优势与日常开发体验之间仍可能存在差距:
实现任务很有效,但在规划、代码审查和复杂问题拆解上可能较弱。
— 来自 r/google_antigravity 的用户讨论
Google 在DeepMind 模型页面公布的客户案例也支持这一结论。Browser Use 表示,“Gemini 3.7 Flash 智能体比 3.6 Flash 便宜 35%,观察到的 prompt cache 命中率提高了 8%,工具调用错误也更少。”Harvey 在 Legal Agent Bench 上测得全通过率提升 2.6 分。Nunu.ai 则认为,其表现与 GPT-5.6-Terra 相当,“成本约为后者的一半”。三家都将节省归因于智能体循环步骤减少,而非 token 单价下调。
知识工作与多模态:提升较小,但并非无感
离开代码场景后,提升幅度有所收窄。Artificial Analysis Intelligence Index 从 52 提高到 56;根据DeepMind 对比表,Gemini 3.7 Flash 位于 Claude Sonnet 5(55)和 GPT-5.6 Terra(57)之间。非代码项目中最突出的进步来自文档理解:GDP.pdf 从 22.0% 跳升至 34.0%,对处理复杂文档、财报或法律文件的流水线而言是 12 分提升。衡量 128K token 长上下文检索的 GDM-MRCR v2,也从 91.8% 升至 97.0%。
评估复杂法律工作流的 Harvey LAB-AA 从 85.1% 提升到 90.7%。长视频理解(LVBench)和生物学研究任务(LABBench2)也都有约 6 分的进步。这些改进对于专业场景确实有价值,但通常不足以单独成为升级决策的决定因素。
价格不变:两款模型仍适用相同优惠费率
| 模型 | 输入($/100 万 token) | 输出($/100 万 token) | 标准价格(自 2027 年 1 月 1 日起) |
|---|---|---|---|
| Gemini 3.7 Flash | $0.75\* | $3.75\* | $1.50 / $7.50 |
| Gemini 3.6 Flash | $0.75\* | $3.75\* | $1.50 / $7.50 |
| Claude Sonnet 5 | $2.00 | $10.00 | — |
| GPT-5.6 Terra | $2.00 | $12.00 | — |
\*优惠价格于 2026 年 12 月 31 日到期。所有价格均来自DeepMind 模型页面。
Google 于 2026 年 8 月 13 日发布 3.7 Flash 时,将 $0.75/$3.75 的促销价格同时应用于两款 Flash 模型。在此之前,3.6 Flash 的标准价格为 $1.50/$7.50。除非 Google 延长促销,否则从 2027 年 1 月 1 日开始,两款模型都将恢复至 $1.50/$7.50。既然每 token 定价一致,成本差异就取决于完成任务的效率:Browser Use 报告的 35% 智能体成本降低,是在相同工作负载下测得,原因是工具调用更少、缓存命中率更高,并非模型价格不同。
如需了解 3.7 Flash API 成本的详细构成,包括缓存、Batch API 和 grounding 费用,可查看我们的 Gemini 3.7 Flash API 定价指南。
Gemini 3.6 Flash 仍有优势的场景
在图表推理上,3.6 Flash 保有微弱领先。不使用工具时,CharXiv 上 3.6 的成绩为 85.2%,略高于 3.7 的 84.5%;启用工具后,差距同样为 0.7 分:89.4% 对 88.7%。不足 1 分的差距非常小,具体图表任务中两者的表现可能相近。在确定默认模型前,建议先用自己的图表工作负载验证。
在 Google 的对比表中,除图表推理外,没有其他基准项目显示 3.6 领先于 3.7。整体智能指数的差距从 52 到 56,是图表推理之外最接近的竞争区域,但 3.7 依然占优。
迁移不只是改模型名称:还要留意 API 行为
从操作层面看,迁移只需将模型 ID 从 gemini-3.6-flash 替换为 gemini-3.7-flash。根据DeepMind 模型页面,两款模型拥有相同的上下文窗口(输入 1M、输出 64K)、相同的输入模态(文本、图像、视频、音频、PDF),以及相同的工具调用能力(function calling、search grounding、computer use)。模型页面将 3.7 Flash 标为正式可用。
不过有一点需要注意:3.5 升级到 3.6 时,曾出现未明确说明的 API 行为变化,令不少开发者措手不及。根据独立测试记录,temperature、top_p 和 top_k 会被静默忽略,thinking_budget 改为字符串枚举型 thinking_level,响应预填充功能也被移除。Google 尚未说明 3.7 Flash 是否带来了类似变化。在相关文档发布前,生产流量迁移前应让评估套件同时测试两个模型 ID,并保留 3.6 作为回退选项。
该不该切换到 3.7 Flash?
可以按工作负载类型来判断:
- 运行代码智能体:建议立即切换。DeepSWE v1.1 提升 16.7 分,Terminal-Bench 3.0 接近三倍。在每 token 价格相同的前提下,代码智能体工作负载没有财务理由继续停留在 3.6。
- 处理复杂文档:建议立即切换。GDP.pdf 理解能力提升 12 分(22.0% → 34.0%),128K token 长上下文检索则达到接近满分的 97.0%。
- 以图表推理为核心任务:先测试再决定。CharXiv 的成绩中,3.6 仅领先不到 1 分。投入使用前,应进行并排评估。
- 流水线已验证且运行稳定:可以暂留在 3.6。DeepMind 模型页面未列出 3.6 Flash 的停用日期。若工作流已通过回归测试,且暂时不需要代码能力提升,排查行为变化的成本可能高于收益。建议一次只迁移一个工作流。
- 把发布节奏纳入考虑。Google 在 3.6 发布三周后就推出了 3.7。当前可优先迁移 3.7 增益最明显的工作流,将 3.6 固定为回退版本;把每次 Flash 发布视为需要评估的渐进式升级,而不是一次平台级迁移。
你也可以通过 Gemini 3.7 Flash 和 Gemini 3.6 Flash 聊天界面并排体验两款模型。
Gemini 3.7 Flash 是新架构,还是后训练更新?
Google 尚未公开将 3.7 Flash 定义为新架构或后训练补丁。Artificial Analysis Intelligence Index 从 52 升至 56,而独立测试已确认,3.5 Flash 和 3.6 Flash 在同一指数上均为 50。3.7 的提升究竟来自架构变化还是训练数据改进,目前没有公开文档说明。
Gemini 3.7 Flash 比 3.6 Flash 更贵吗?
不会。两款模型在 2026 年 12 月 31 日前,输入均为每百万 token $0.75,输出均为每百万 token $3.75。此后两者都会调整为 $1.50/$7.50。升级所带来的节省,来自每项任务所需的工具调用和推理步骤减少,而不是更低的每 token 价格。
Gemini 3.7 Flash 在哪些地方可用?
根据DeepMind 模型页面,3.7 Flash 已通过 Gemini API、Google AI Studio、Google Antigravity、Vertex AI、Gemini Enterprise 和 Gemini App 提供,并处于正式可用状态。
要不要等下一个 Flash 版本,而不是现在迁移?
3.7 Flash 已是正式可用模型,拥有公开基准测试和客户采用案例。如果你的工作负载能受益于代码与智能体能力提升,现在就迁移这些工作流,并在下一版本发布时重新评估。等待意味着放弃当前已经可以获得的能力收益。