 AIREITER
Google 于 2026 年 8 月 13 日推出 Gemini 3.7 Flash,定位是目前 Flash 系列中最适合编码代理和多步工具调用的模型。它在 DeepSWE v1.1 上拿到 65.3%,相比 3.6 Flash 的 49.0% 有明显提升;同时,限时价格只有输入 $0.75/百万 Token、输出 $3.75/百万 Token,正好是 3.6 Flash 标准价格的一半。需要注意的是,据报道,这个价格将在 2027 年 1 月翻倍至 $1.50/$7.50。也就是说,按当前低价进行评估的窗口大约只有四个月。
API 价格:输入 $0.75、输出 $3.75,2026 年 12 月后翻倍
根据 Google DeepMind 的发布公告,以及社区报告和搜索索引结果的交叉确认,Gemini 3.7 Flash 的起步价格为输入每百万 Token $0.75、输出每百万 Token $3.75。作为参考,Gemini 3.6 Flash 的标准价格是输入 $1.50/百万 Token、输出 $7.50/百万 Token(AgentPedia)。3.7 Flash 的限时价格与 3.6 Flash 的 Batch/Flex 价格一致,但适用于标准吞吐量。
社区报告特别提到了一条容易被忽略的细则:限时价格持续到 2026 年 12 月 31 日,之后恢复为输入 $1.50/百万 Token、输出 $7.50/百万 Token。一位 Reddit 用户指出,“页面上显示的价格细则意味着四个月后价格会翻倍”(r/GeminiAI)。
| 价格层级 | 输入($/百万 Token) | 输出($/百万 Token) | 备注 |
|---|---|---|---|
| 3.7 Flash 限时价格(2026 年 8 月至 12 月) | $0.75 | $3.75 | 社区报告;2027 年 1 月翻倍 |
| 3.7 Flash 标准价格(2027 年 1 月起) | $1.50 | $7.50 | 与 3.6 Flash 标准价格相同 |
| 3.6 Flash 标准价格 | $1.50 | $7.50 | 当前 GA 价格 |
| 3.6 Flash Batch/Flex | $0.75 | $3.75 | 低吞吐量层级 |
| 3.5 Flash-Lite 标准价格 | $0.30 | $2.50 | 价格最低的 Gemini Flash 层级 |
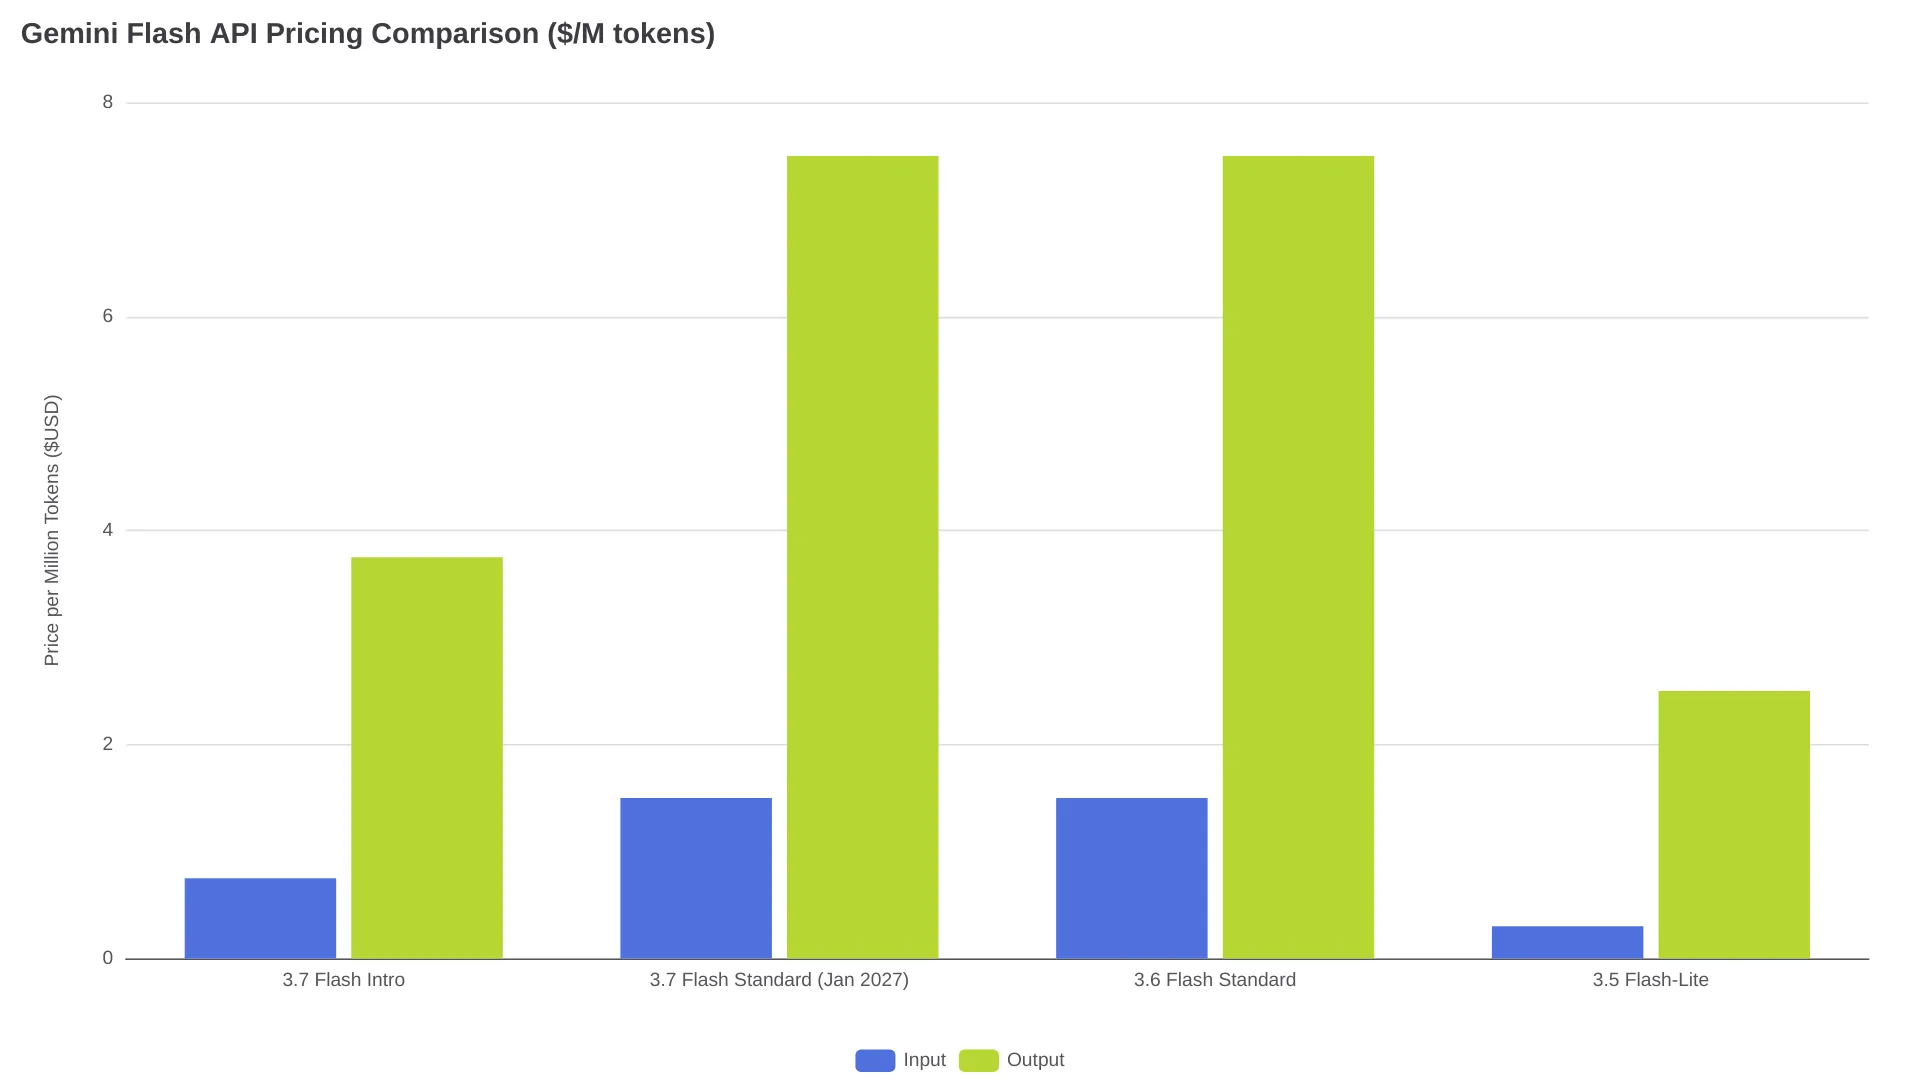
输出价格已经包含思考 Token。按照 AgentPedia 引述的 3.6 Flash 已公布价格,标准层级的上下文缓存费用为 $0.15/百万 Token。Google Search grounding 和 Maps grounding 需要另行付费。该模型保留了 3.6 Flash 的 1M Token 上下文窗口和 64K 最大输出长度,因此不会因为上下文限制变化而破坏现有 API 调用。
基准测试提升有多大?
Google 公布的测试结果显示,提升主要集中在软件工程、编码和文档处理领域。以下数据来自 Google 的发布公告,由 2026 年 8 月 13 日的社区帖子整理披露。
| 基准测试 | Gemini 3.7 Flash | Gemini 3.6 Flash | 变化 |
|---|---|---|---|
| DeepSWE v1.1 | 65.3% | 49.0% | +16.3 个百分点 |
| FrontierCode 1.1 Main | 43.6% | 34.4% | +9.2 个百分点 |
| WebDev Arena(Elo) | 1,588 | 1,538 | +50 Elo |
| GDP.pdf 文档处理 | 34.0% | 22.0% | +12.0 个百分点 |
| AutomationBench | 30.4% | ~17% | +13 个百分点 |
| 长上下文检索 | 97% | — | — |
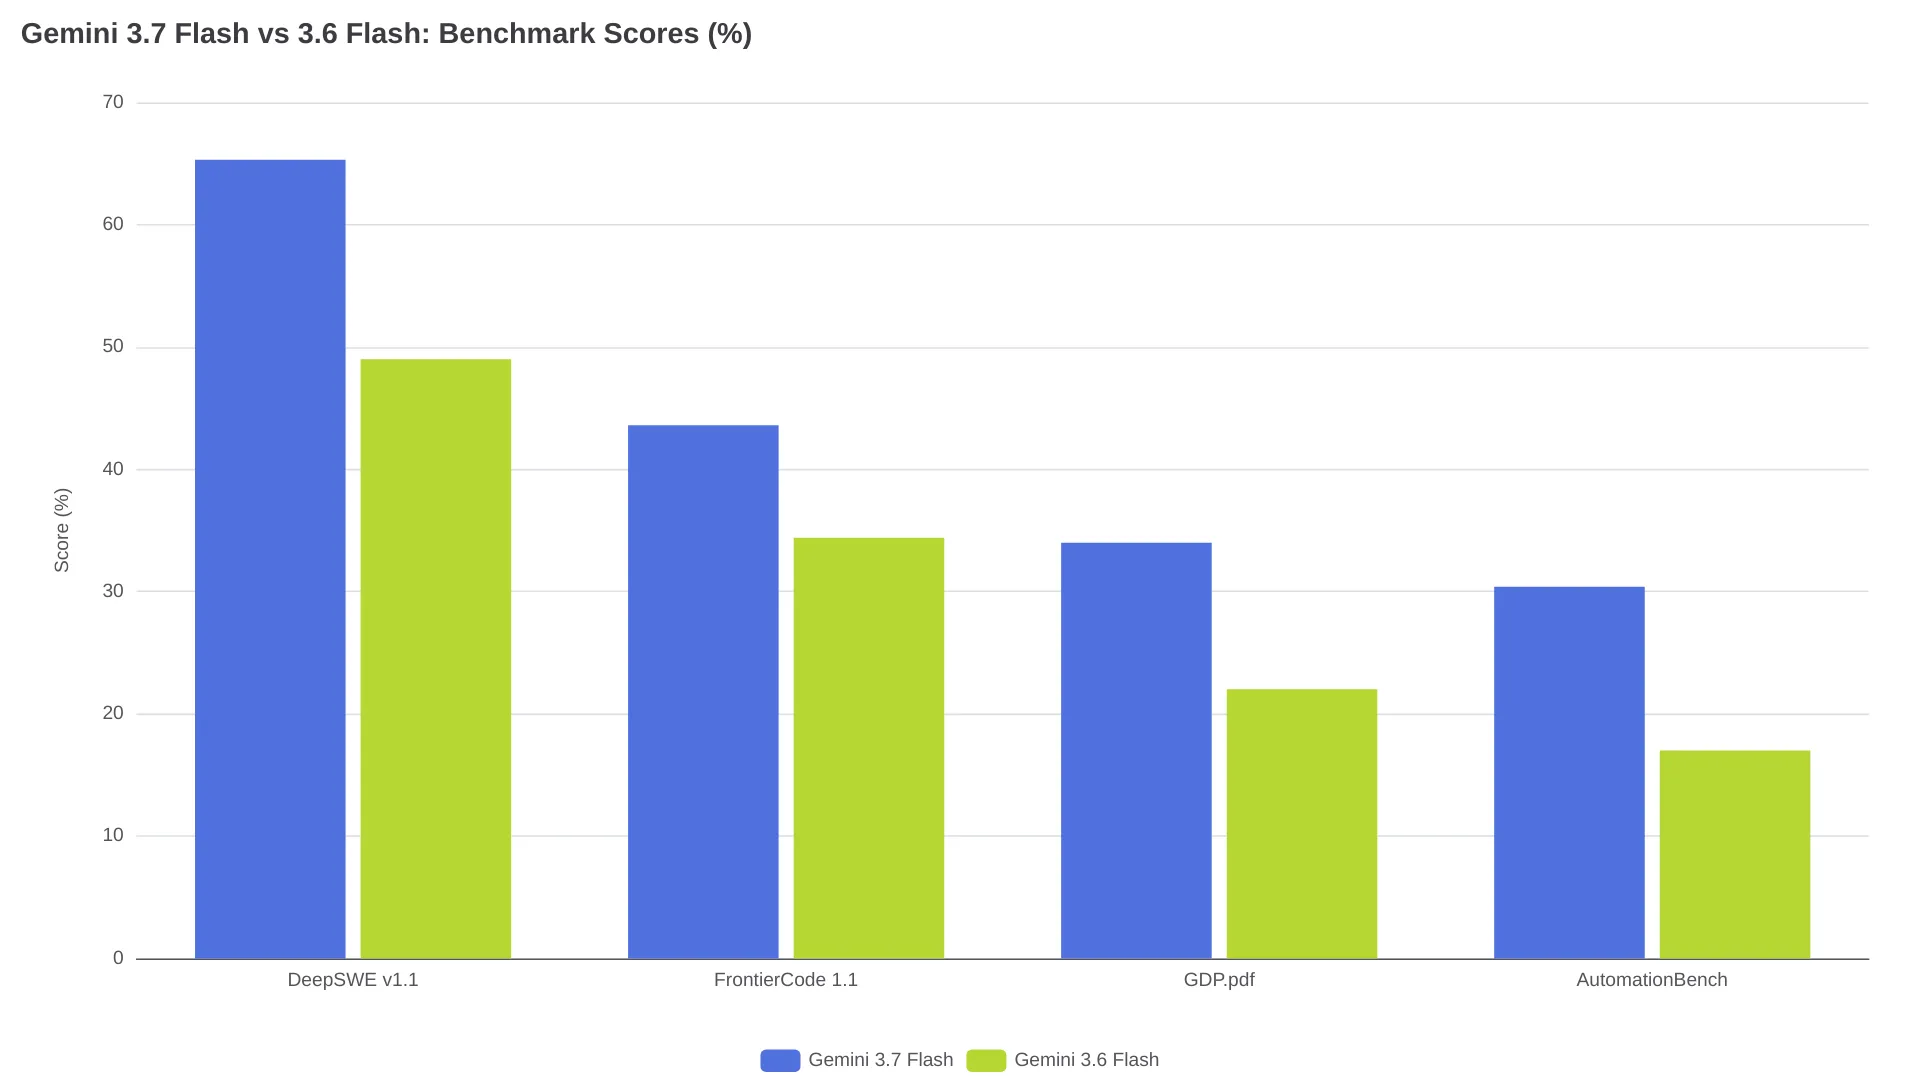
最亮眼的结果是 DeepSWE 从 49% 跃升至 65.3%,相对涨幅为 33%。DeepSWE 测试的是仓库级软件工程能力,包括跨多个文件修改、运行测试以及在代码库中导航。不过,Reddit 社区对这些成绩能否在生产环境中复现仍有分歧。一位用户表示:“在证实之前,先假设这些成绩是刷榜得来的。”(r/GeminiAI)还有用户指出,对比测试中 3.6 Flash 使用了 high 思考级别,而部分竞品使用的是 medium,这会抬高测试分数。97% 的长上下文检索成绩则确实让编码用户感到兴奋,尤其适合在大型代码库中定位相关代码。
与其他编码模型相比,成本表现如何?
Reddit 上的早期用户很快开始比较 3.7 Flash 与更便宜替代方案的价格性能比。结论并不单一:3.7 Flash 的成绩不错,但完成单个任务的成本明显高于预算型编码模型。
基准测试讨论帖中的一位评论者估算,按照 Artificial Analysis 的单任务成本计算,Gemini 3.7 Flash 的费用大约是 GPT-5.6 Luna 的 8 倍,但 Luna 的基准成绩几乎相同。另一位用户表示,Gemini 3.7 Flash 此前的价格大约是 DeepSeek V4 Flash 的 13 倍,不过 DeepSeek 的价格后来已经上涨。同一位评论者直言,与 Luna 相比,Gemini 3.7 Flash 的成本高出“超过 300%”,但结果“几乎一样”(r/GeminiAI)。
支持 3.7 Flash 的理由是,Luna 据称更容易产生幻觉,而 DeepSeek V4 Flash 的推理“会犯很多错误”,但这些说法目前都只是用户层面的经验反馈。
3.7 Flash 真正获得好评的地方是速度。用户反馈称,大多数响应耗时在 3 到 6 秒之间;目前观察到的最长响应来自一次创意写作测试,耗时约一分钟。多位评论者都称其“快得惊人”。
规格、可用性与 API 接入方式
根据社区讨论中披露的规格,以及 3.6 Flash 文档,Gemini 3.7 Flash 延续了 3.6 Flash 的上下文限制和功能配置。
| 规格 | 数值 |
|---|---|
| 上下文窗口 | 1,048,576 Token(1M) |
| 最大输出 | 65,536 Token(64K) |
| 思考级别 | Low、Medium、High |
| 模态 | 文本、图像、视频、音频、PDF(输入);文本(输出) |
| 知识截止时间 | 2026 年 3 月(3.6 Flash;3.7 Flash 尚未确认) |
| 缓存输入价格 | $0.15/百万 Token(标准价格,根据 3.6 Flash 推断) |
接入渠道:
- Gemini API / Google AI Studio —— 面向开发者
- Gemini app —— 面向消费者推出
- Gemini Spark —— Google AI Pro 和 Google AI Ultra 订阅用户可用
- Vertex AI —— 预计沿用 3.6 Flash 的可用性模式
按照 Google 对 3.6 Flash 的命名方式,预计 API 模型 ID 为 gemini-3.7-flash。正式部署前,请在 Google AI for Developers 文档中确认确切字符串,并固定使用该 ID,不要依赖 gemini-flash-latest 这类别名。
要不要从 3.6 Flash 迁移?
关键取决于你的工作负载类型,以及 2027 年 1 月的涨价会对成本造成多大影响。
适合迁移:如果你的应用运行编码代理、多步工具调用链,或处理大量文档,3.7 Flash 值得测试。DeepSWE 从 49% 提升到 65.3%,幅度足以改变代理循环首次成功的概率;而限时价格减半,也能降低评估成本。已经使用 3.6 Flash 的团队可以把模型 ID 放在功能开关后进行替换,无需重写上下文窗口相关逻辑。
可以等待:如果你的任务主要是高并发分类、路由或提取,而 Flash-Lite 已经能以 $0.30/$2.50 的价格完成工作,那么 3.7 Flash 未必划算。它的限时输入价格已经是 Flash-Lite 的 2.5 倍,2027 年 1 月涨价后差距还会进一步扩大。
提前按涨价后的成本规划。预算应按照 2027 年 1 月起的 $1.50/$7.50 计算,而不是当前限时价格。如果你的单位经济模型只有在 $0.75/$3.75 下才能成立,那么四个月后模型成本将变为现在的 2 倍。
常见问题
Gemini 3.7 Flash 的 $0.75/$3.75 价格是永久的吗?
不是。社区报告显示,这是一项持续到 2026 年 12 月 31 日的限时价格。从 2027 年 1 月开始,价格据报道将翻倍至输入 $1.50/百万 Token、输出 $7.50/百万 Token,与 3.6 Flash 的标准价格一致。
Gemini 3.7 Flash 能在 Vertex AI 上使用吗?
截至发布时,Vertex AI 的可用性尚未得到独立确认。Gemini 3.6 Flash 在 GA 阶段可以通过 Vertex AI 使用,因此预计 3.7 Flash 也会沿用这一安排。请以 Google Cloud 控制台当前显示的模型列表为准。
3.7 Flash 与 Gemini 3.1 Pro 相比怎么样?
Reddit 用户反馈称,在特定代理和编码基准测试中,尤其是代理式文档分析场景,3.7 Flash 的表现可以与 Pro 系列模型竞争,甚至更好。若关注限时价格下的纯编码代理循环,3.7 Flash 的成本表现更好;如果任务需要复杂推理和规划,Pro 仍然是更强的选择。
思考 Token 会单独计费吗?
不会。思考 Token 会按照输出 Token 计费,在限时价格期间采用 $3.75/百万 Token 的标准输出价格。使用 high 思考级别会按比例增加输出成本,因此对于不需要额外推理的高并发任务,建议使用 medium 或 low。