 AIREITER
1450 亿参数、笔记本本地运行、每秒 80 个 token——Edge0-145B 的宣传确实很吸引人。不过真正下载并运行时,你面对的是 NVIDIA 显卡、CUDA 13,以及大约 105GB 的 SSD 空间。
这篇 Edge0-145B 评测将发布时的宣传与官方博客、模型文档、Q3_K 模型卡以及首批社区实测放在一起对照,帮助你在下载前判断:是值得本地部署,还是直接调用 API。
11 月 12 日发布了什么:模型权重、推理引擎与限制
Edge0 于 2026 年 11 月 12 日发布了 Edge0-145B 和 Edge0-120B。模型权重分别位于 Edge0-145B-q3k 和 Edge0-145B-NVFP4,配套的 edge0-strata 引擎则位于 Edge0-AI/Edge0。Edge0-145B 是纯文本、潜在混合专家模型,支持 256K 上下文,基于 Qwen3.8-Flash-Next 衍生,并从训练阶段起就采用 4-bit 精度。每个 token 实际激活约 10.12B 参数,所以 145B 的总参数量并不意味着需要 145B 显存。
模型总量大致由 84.6B 专家参数、通过内存映射从 SSD 读取的 51.2B PLE n-gram 表、用于推测解码的 1.26B 草稿头,以及一个 6GB 骨架组成。Q3_K 版本包含 40.81 GiB 模型权重,但整个仓库大小为 105.4GB;NVFP4 版本的权重为 47.79 GiB,仓库大小为 112.9GB。路由专家被打包在自定义的 experts.bin 中,而不是通用的 GGUF 文件。
所谓 29GB,并不等于准备 29GB 就够了
官方博客一处写的是 29GB 峰值内存,另一处则写成 28GB,同时给出了 1,100+ token/秒的预填充速度、80+ token/秒的生成速度和 120W 功耗。Q3_K 模型卡记录的 RTX 5090 D 实测占用是 23.14 GiB 显存加 31.28 GiB 主机内存;NVFP4 则是 23.25 GiB 显存加 38.27 GiB 内存。专家库本身约占 40GB 内存,另外还要从 SSD 流式读取约 48GB 的词表数据。
常用专家会留在显存中,温热专家放在内存里,51.2GB 的 PLE 表则按需从 SSD 读取。若只看运行时的活跃驻留量,确实可能接近 29GB;但完整模型仍然需要足够的存储空间和持续的数据流式读取。
| 这个数字实际代表什么 | 大小 | 存放位置 |
|---|---|---|
| 博客公布的峰值内存 | 28-29GB | 活跃驻留量,未说明测量方法 |
| Q3_K 仓库下载量 | 105.4GB | NVMe SSD,包含 51.2GB PLE 和 40.1GB experts.bin |
| NVFP4 仓库下载量 | 112.9GB | NVMe SSD,包含 51.2GB PLE 和 47.6GB experts.bin |
| 5090 D 实测 Q3_K 驻留 | 23.14 GiB 显存 + 31.28 GiB 内存 | 推理过程中的显存与系统内存 |
| 5090 D 实测 NVFP4 驻留 | 23.25 GiB 显存 + 38.27 GiB 内存 | 推理过程中的显存与系统内存 |
实际运行 Edge0-145B 需要什么配置
Edge0-145B 通过 edge0-infer 运行,需要 Linux 或 Windows、NVIDIA GPU 和 CUDA 13。发布的模型文件没有提供原生 llama.cpp、Ollama 或 LM Studio 加载路径:骨架 GGUF 不包含路由专家权重,而 Edge0 文档只支持 edge0-infer(参见仓库说明),因此llama.cpp v1.0 指南中的流程并不适用。官方博客提到 macOS 和 MacBook Pro 首发支持,但平台表格针对 145B 和 120B 实际只列出了配合 CUDA 13 的 Linux 和 Windows。
最低测试配置是 16 GiB 显存加 20 GiB 内存,在 Q3_K 上进行智能体解码时速度为每秒 44.9 个 token。更推荐使用 24GB NVIDIA 显卡、32GB 系统内存(48GB 会更宽裕)、120GB 可用 NVMe 空间,以及 CUDA 13、CMake、Ninja 和 uv。根据仓库说明完成构建和启动:
git clone https://github.com/Edge0-AI/Edge0.git edge0
hf download Edge0/Edge0-145B-q3k --local-dir ./Edge0-145B-q3k   # ~105 GB
export EDGE0_145B=$PWD/Edge0-145B-q3k
build/cpu/bin/edge0-infer serve --model "$EDGE0_145B"  # :8000
Windows 用户也可以从 GitHub Releases 下载 Edge0 Chat app v0.2.0。AMD 平台则需要手动修改:u/UghrUghr 在r/LocalLLaMA 帖子中表示,在 Windows 11 和 RX 7900 XTX 上需要修改约 35 行构建及运行时代码,同时 CUDA 融合内核会退回到速度更慢的路径。
Q3_K 还是 NVFP4:该下载哪个版本
105.4GB 的 Q3_K 是默认选择。根据 Edge0 的表格,它在 5090 D 上的智能体解码速度为每秒 121.2 个 token。112.9GB 的 NVFP4 面向 Blackwell 加速,在同一张显卡上的速度为 98.3。没有 Blackwell 硬件的话,优先从 Q3_K 开始。
换成真实显卡,速度到底怎么样
下面的数据均由 Edge0 提供,测试模型为 Q3_K,除非特别注明,否则预填充长度为 16K。M2 Ultra 一行使用的是 Metal 测试结果,不能据此证明已经有 macOS 发布版本。
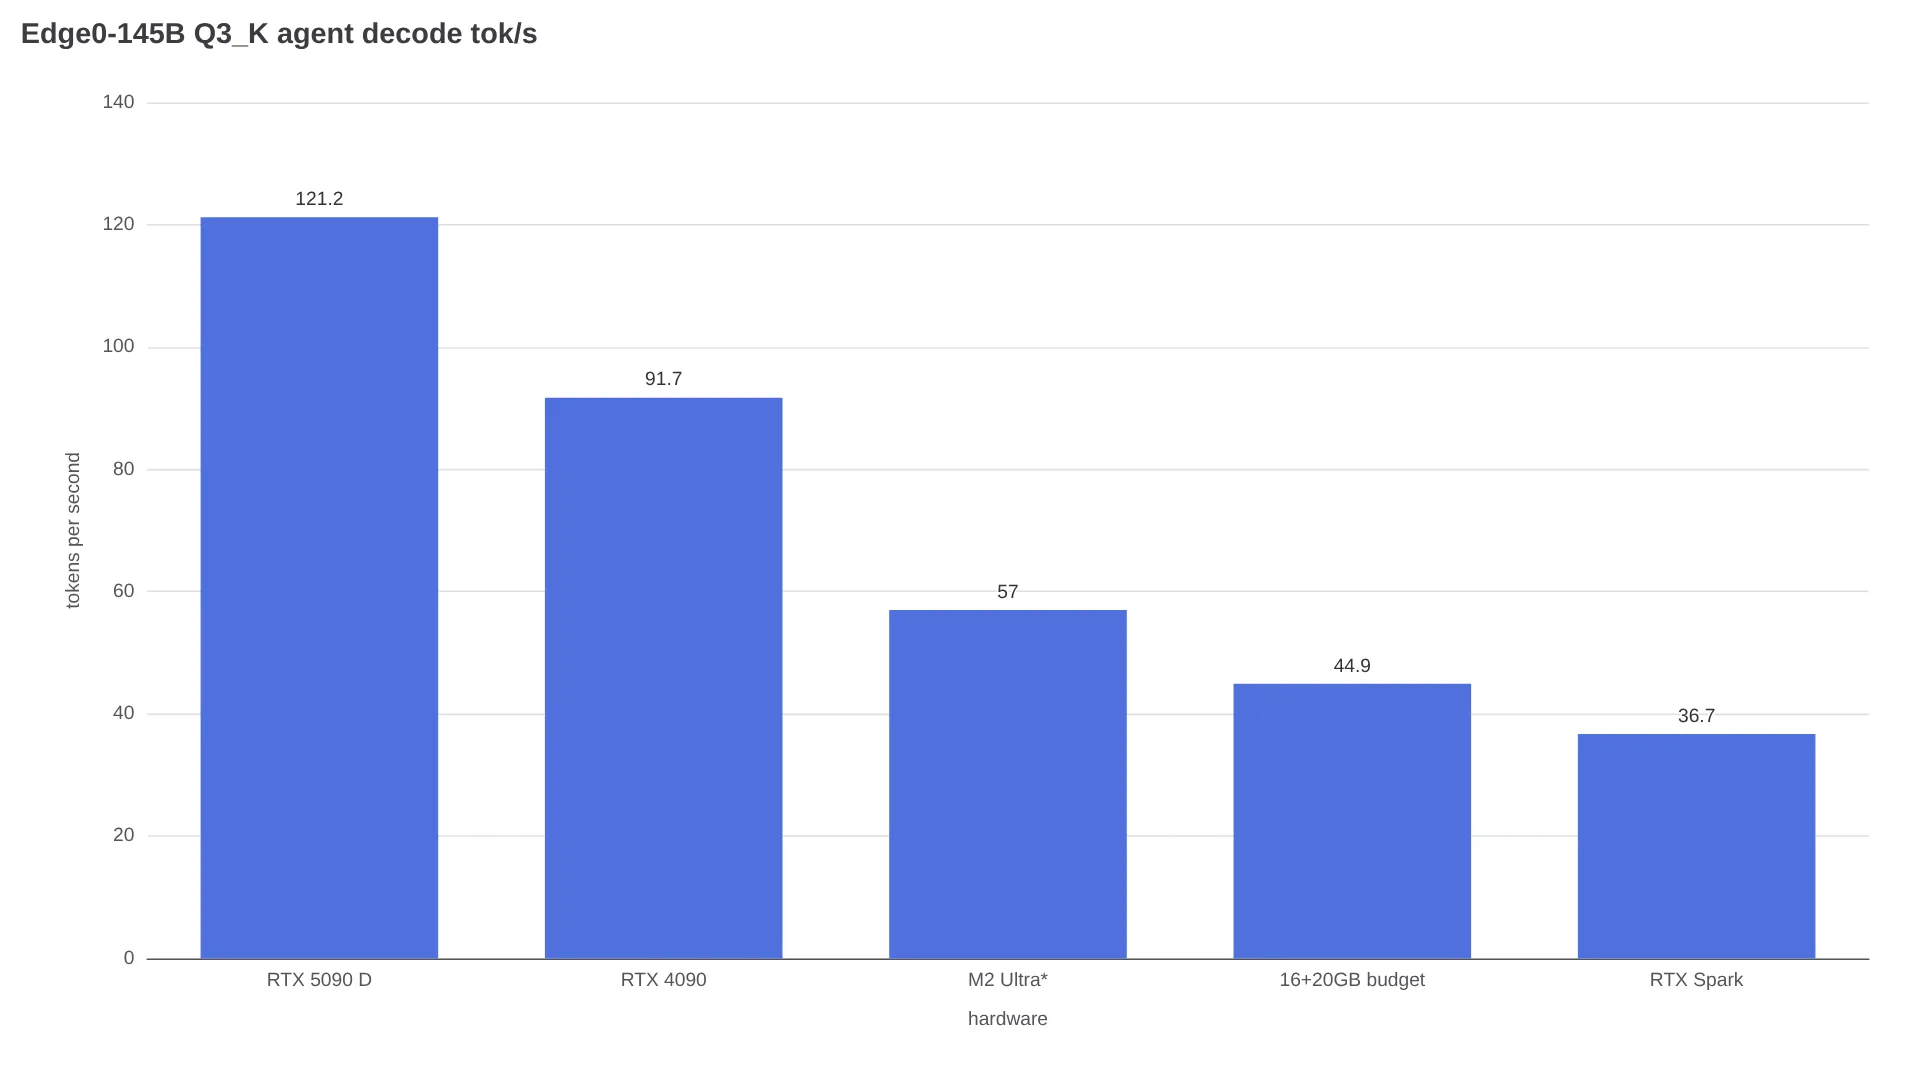
| 硬件 | 聊天解码 | 智能体解码 | 16K 预填充 |
|---|---|---|---|
| RTX 5090 D 24GB Q3_K | 99.7 | 121.2 | 3,554.9 |
| RTX 4090 24GB Q3_K | 69.9 | 91.7 | 3,179.4 |
| Apple M2 Ultra Metal Q3_K | 60.9 | 57.0 | 800.3 |
| 16 GiB 显存 + 20 GiB 内存配置 Q3_K | 36.8 | 44.9 | 335.0 |
| RTX Spark 60GiB Q3_K | 37.7 | 36.7 | 770.3 |
一位 RTX 3090 用户报告的首 token 延迟为 20.1 秒,预填充速度为 1,583,解码速度为 56.2,说明它的实际速度低于旗舰显卡:
刚在我的 3090 机器上试了一下——Edge0-145B Q3_K 的 TTFT 为 20.1 秒,预填充 1583 token/秒,解码 56.2 token/秒。
— u/LightBrightLeftRight,r/LocalLLM 帖子
在前面提到的 AMD 配置上,u/UghrUghr 报告的解码速度约为 40;加入 ROUTE_TAIL_SKIP=7 和 ROUTE_PRIOR=1.5 后约为 54,提示词处理速度约为 320。这些只是单用户快照,并非严格可复现的对照测试,速度大约只有 5090 D 的一半到三分之二。
基准测试:两项领先,但别忽略四个前提
根据模型文档,Edge0 的表格混合了 Edge0、Qwen、DeepSeek 和 Claude 的内部测试,以及其他模型的第三方数据。Edge0-145B 在两项代码智能体测试中领先,但在知识和指令测试中落后于它的 Qwen 基础模型。截至 2026 年 11 月 13 日,我没有找到相关的独立复现;此外,表中的分数对应完整模型,并不是这些量化下载版本的成绩。
| 基准测试 | Edge0-145B | Qwen3.8-Flash-Next | DeepSeek V4 Flash | Claude Opus 4.6 Max |
|---|---|---|---|---|
| DeepSWE 1.1 | 64.6 | 58.7 | 54.4 | — |
| Terminal-Bench 2.1 | 86.52 | 83.3 | 82.7 | 78.2 |
| HLE | 35.4 | 35.9 | 33.8 | 40.0 |
| GPQA-Diamond | 90.4 | 91.7 | 90.8 | 91.3 |
| IFBench | 80.6 | 81.3 | 79.2 | 62.5 |
| AA-LCR | 79.3 | 79.1 | 79.7 | 78.0 |
按 Edge0 的计算,Edge0-145B 平均分为 72.8,Qwen3.8-Flash-Next 为 71.7,DeepSeek-V4-Flash 为 70.1,120B 则是 68.9。我的判断是:两个尺寸的峰值配置宣传相近,如果硬盘空间不是问题,优先选 145B。
许可证:开放权重不等于开源
框架采用 Apache 2.0 许可证,Strata 基础组件采用 MIT 许可证;但模型权重使用的是Edge0 Community Model License 1.0,同时还适用 Qwen 的相关条款。个人、研究、内部业务以及商业化使用模型输出都被允许。但如果要销售或捆绑模型、运营付费服务,或将其用于商业代码助手、办公助手,则需要另行取得书面许可。
该下载模型,还是直接调用 API
如果你有合适的硬件,并且必须让代码留在本地,可以下载。只是想体验一次的话,建议先比较托管 API 的价格,再决定是否购买硬件。正在比较托管推理方案的开发者,也可以先看看DeepSeek V4.1 Flash API 页面,不必一开始就为模型腾出 105GB 磁盘空间。
| 你的情况 | 建议 |
|---|---|
| 24GB NVIDIA 显卡 + 32-48GB 内存 + 120GB NVMe,使用 Linux/Windows | 下载 Q3_K,通过 edge0-infer 提供服务 |
| 拥有 Blackwell 显卡,希望使用 NVFP4 路径 | 下载 NVFP4 版本 |
| 只有 Mac、8-16GB 笔记本,或需要 Ollama/LM Studio | 暂时不要下载,改用托管 API |
| 准备基于模型权重提供付费 API 或助手 | 先暂停并取得书面许可;或者使用 API |
| 只想获得类似测试成绩,不想处理部署运维 | 使用 Qwen 同级模型或前沿模型 API,等独立复现后再考虑 |
Edge0-145B 的取舍在于“来源可信度”和“实际可用性”:专家流式加载确实降低了百亿级以上模型的显存门槛,但笔记本、macOS 和 29GB 这些宣传表述都跑在已发布代码的实际支持范围之前,而且 Edge0 公布的表格没有单独给出 Q3_K 的质量分数。
常见问题
Edge0-145B 能在笔记本上运行吗?
只有高端 NVIDIA 笔记本才有可能,配置大约需要 24GB 显存、32GB 以上内存和 120GB NVMe,并且运行 Linux 或 Windows、使用 CUDA 13。8GB 或 16GB 的轻薄本无法运行 145B 版本;该版本需要下载 105.4GB 文件,并占用 23 GiB 以上显存。
Edge0-145B 能在 Mac 上运行吗?
截至 2026 年 11 月 13 日,平台表中没有出现受支持的 macOS 发布版本。M2 Ultra 的数据仅代表 Metal 测试结果。
它支持 Ollama、llama.cpp 或 LM Studio 吗?
不支持。标准版本无法加载自定义的 experts.bin 专家包,骨架 GGUF 也缺少路由专家权重。请使用 edge0-infer serve,或使用 Windows Chat app。
Edge0-145B 比 Qwen3.8-Flash-Next 更好吗?
在 Edge0 的测试中,DeepSWE 得分为 64.6,对比 58.7;Terminal-Bench 得分为 86.52,对比 83.3,Edge0-145B 领先。但在 HLE 上是 35.4 对 35.9,在 GPQA-Diamond 上是 90.4 对 91.7,反而落后。独立测试仍在等待中。
我可以将 Edge0-145B 用于商业用途吗?
可以商业化使用模型输出,但如果要销售模型、运营付费服务,或推出商业代码助手、办公助手,则需要根据社区许可证另行取得书面许可;同时还需遵守 Qwen 的相关条款。