 AIREITER
DeepSeek 在 2026 年 11 月 13 日把 App 的部分能力搬到了 API 参数之后。内置搜索由模型决定是否调用,并按返回结果的查询次数计费;独立的 Search/Fetch 则完全由代码控制,按成功请求计费;文件上传则通过独立的 Files API 完成,后续使用 file_id 引用。
开启思考后,一次调用可能展开为约 20 次工具调用,这些调用会按查询和抓取分别计费。下面会介绍如何启用这些能力、文件上传限制、单次任务的成本计算,以及不同场景下该选哪条路径。
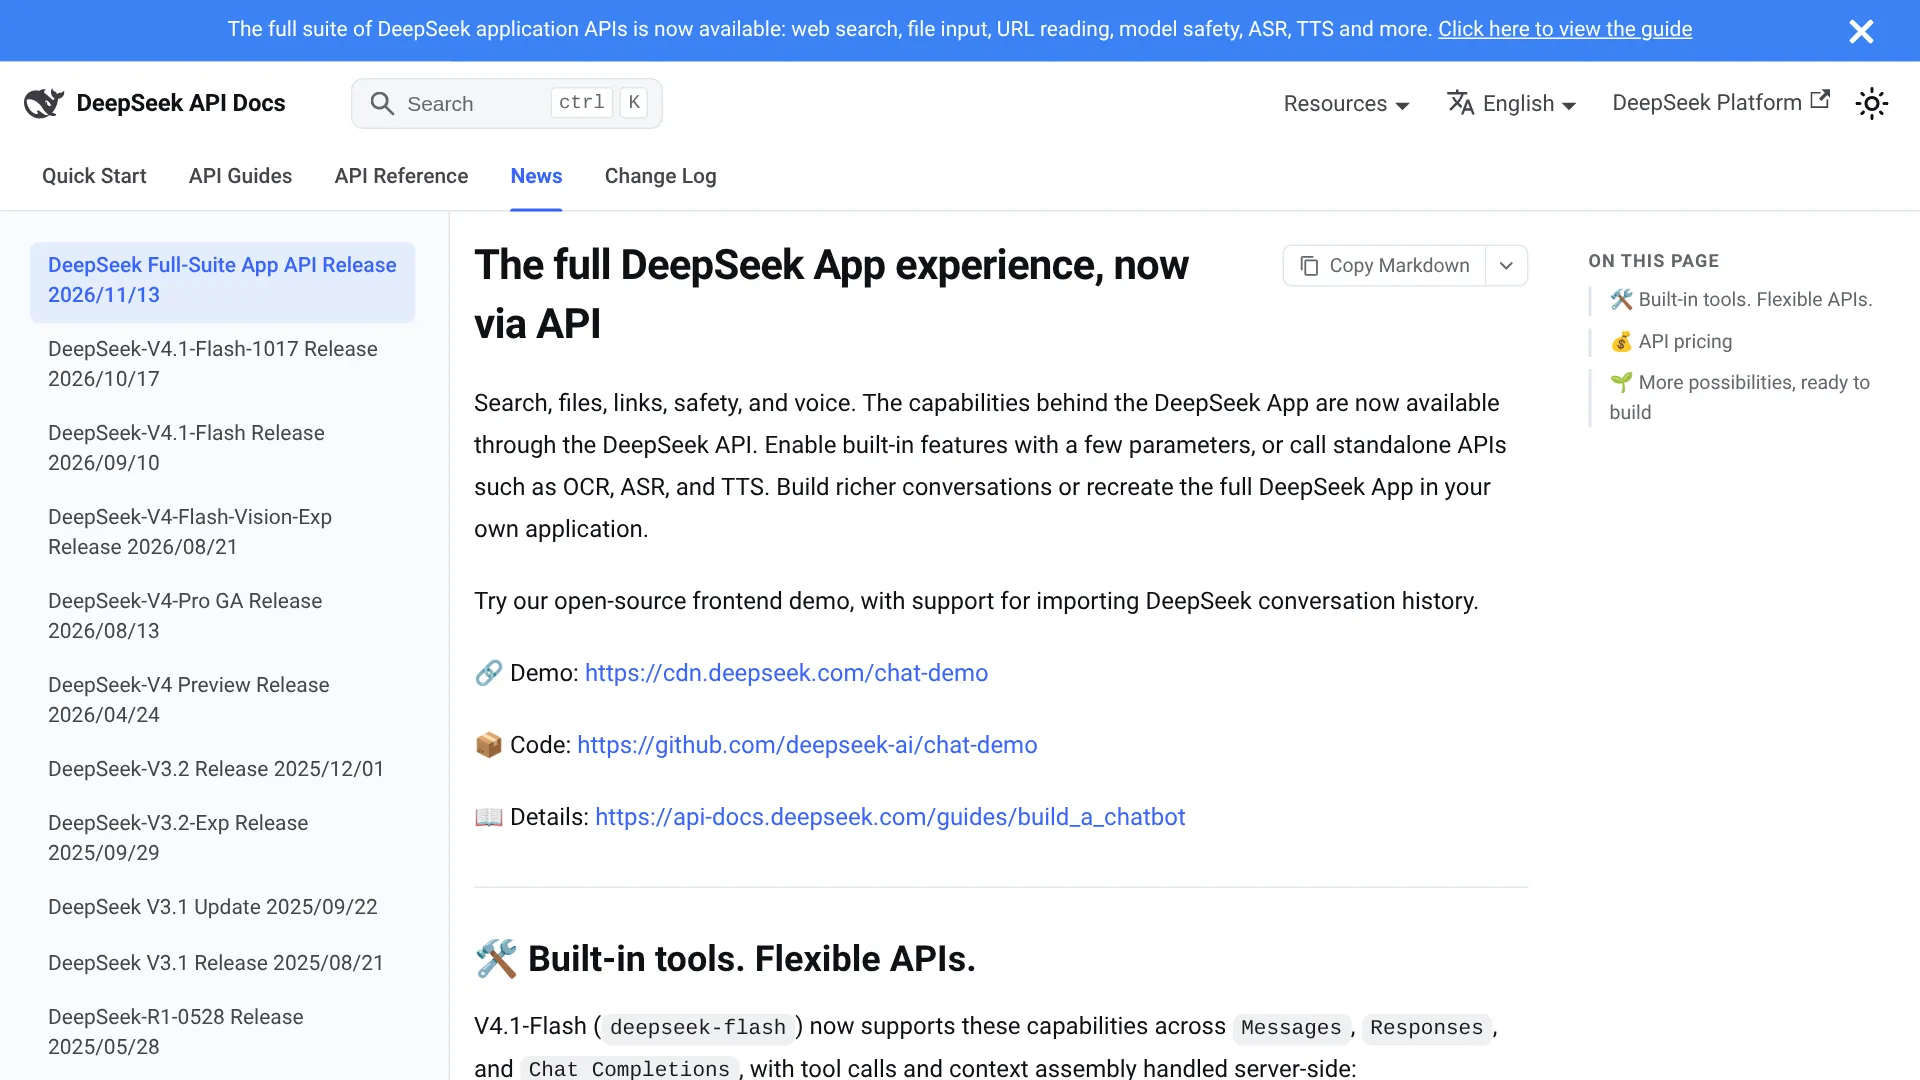
DeepSeek App API 在 11 月 13 日新增了什么
DeepSeek 在公告The full DeepSeek App experience, now via API中宣布,deepseek-flash 模型(DeepSeek-V4.1-Flash)现在可以通过 API 使用网页搜索、文件输入和 URL 读取。
根据Build a Chatbot guide,Messages API、Responses API 和 Chat Completions API 都提供这套能力。工具调用和上下文组装在服务端完成,客户端只需要渲染结构化内容,并在后续请求中原样传回。DeepSeek 还提供了一个开源浏览器演示来展示接入方式,但明确标注为仅供演示。
启用网页搜索和 URL 读取
按照Web Tools guide的说明,在针对 deepseek-flash 的请求中,将以下两个工具声明在 tools 数组里:
"tools": [{"type": "deepseek_web_search"}, {"type": "deepseek_read_url"}]关闭思考时,deepseek_web_search 的行为类似聊天搜索:模型自行判断是否搜索,一次调用可以携带多个查询,并在回答中返回引用。开启思考后,同一个工具会变成深度思考搜索,模型可以在多个推理步骤之间交替执行搜索、open_page 和 find_in_page,然后再给出答案,最多约进行 20 次工具调用。
同一份Web Tools guide还列出了四项限制:
- 只有最新一条用户消息中的 URL 会被处理,最多取前 10 个不重复的 URL,最终由模型决定读取哪些链接。
- 不能通过
tool_choice强制调用工具:指定某个工具会返回 HTTP 400,设置为"none"也会同时关闭 URL 读取。 - 启用网页工具、高安全级别或标题生成后,
temperature、top_p以及多个工具控制字段会被静默忽略。 - 使用过网页工具的回复不能继续对话,必须重新发送请求。
“每 1000 次请求收费 0.75 美元,但我想知道一个代理在后台到底会发起多少次调用。有人算过典型研究任务的成本吗?”——r/DeepSeek 的 u/Glum-Guitar-5083
两条路径的计费方式不同。内置网页搜索按返回结果的查询次数计费,一次调用中包含三个查询就算三次;内置抓取则按实际抓取的页面计费,包括后续因安全审查被替换为 url_not_allowed 或 unavailable 的页面;无法抓取的链接不收费。独立 Search/Fetch 只有在 HTTP 200 且返回非空结果或内容时才计费。两种路径下,失败或空结果的搜索都不收费。
不用自己写解析器也能上传文件
Files API负责上传文件,之后通过 file_id 重复引用。最小流程如下:
curl https://api.deepseek.com/files \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -F purpose="rich_layout_recognition" \
  -F file="@report.pdf"
# -> {"id": "file-api-xxxxxxxxxxxxxxxx", ...}

# then reference it in chat (Chat Completions shape):
# {"model": "deepseek-flash", "messages": [{"role": "user",
#   "content": [{"type": "text", "text": "Compare this with today's numbers"},
#   {"type": "file", "file_id": "file-api-xxxxxxxxxxxxxxxx"}]}]}
purpose 决定文件的处理方式。对于文档,必须先传 purpose,再传 file 字段。user_data 支持图片(JPEG、PNG、GIF、WebP)、纯文本、电子表格和电子书;text_recognition 会解析 PDF、Word、PowerPoint 以及图片,但只输出文本;rich_layout_recognition 则会在文本之外,为表格和分栏内容返回图形信息。用 user_data 上传 PDF 会返回 HTTP 400,解析后的文档也不能再作为图片使用或下载。
| 类别 | 上限 |
|---|---|
通过 file_id 上传的图片 | 64 MiB(内联 Base64 为 32 MiB) |
| PDF / Word / PowerPoint | 100 MiB,上传解析时间 120 秒 |
| 文本 / 电子表格 / 电子书 | 32 MiB,上传窗口 10 分钟 |
| 账户配额 | 25 GiB、10,000 个文件;有效期为 1 小时至 30 天,或永久保存 |
文件归账户所有,而不是归 API key 所有。同一个 ID 可以在 OpenAI 兼容和 Anthropic 兼容系列中使用,后者需要添加 anthropic-beta: files-api-2025-04-14 请求头。文件解析发生在上传阶段,因此只有解析成功后才会返回 file_id。
内置工具和独立 Search、Fetch 怎么选
如果希望模型在对话过程中自行决定是否搜索或读取页面,就使用内置工具。如果要让代码完全掌控流程,则使用Search & Fetch guide中的独立 API:POST https://api.deepseek.com/v1/tools/search用于排序后的搜索结果,最多返回 50 条;其中 rerank_score 范围为 0–3,1.5 以上代表高质量,authority 范围为 0–4。POST https://api.deepseek.com/v1/tools/fetch则负责把单个 URL 抓取为 Markdown。独立搜索目前还不支持图片搜索,而网页工具支持。
| 路径 | 控制方式 | 计费单位 | 适合场景 |
|---|---|---|---|
内置 deepseek_web_search / deepseek_read_url | 由模型在服务端决定 | 按返回结果的查询次数 / 按抓取页面数 | 带引用的聊天、深度研究 |
| 独立 Search + Fetch | 由你的代码决定 | 每种工具每 1,000 次成功请求收费 0.75 美元 | 代理、RAG 流水线 |
速率限制按账户计算,并且彼此独立:Search 为 100 QPS,Fetch 为 25 QPS,Fetch 还设有按域名计算的上限。超过配额会返回 HTTP 429。对于 408、429 和 5xx,应进行重试;其他 4xx 则需要修正请求。独立 Search 支持查询操作符,包括 site:、-site:、"exact phrase"、lang:、after:/before:。
实际成本怎么算
工具费用会叠加在 Token 费用之上:Search 和 Fetch 都是每 1,000 次成功请求收费 0.75 美元;OCR、ASR 和 TTS 也有单独的工具价格,限时优惠详见公告。调整 count 只会改变结果数量,不会改变价格。
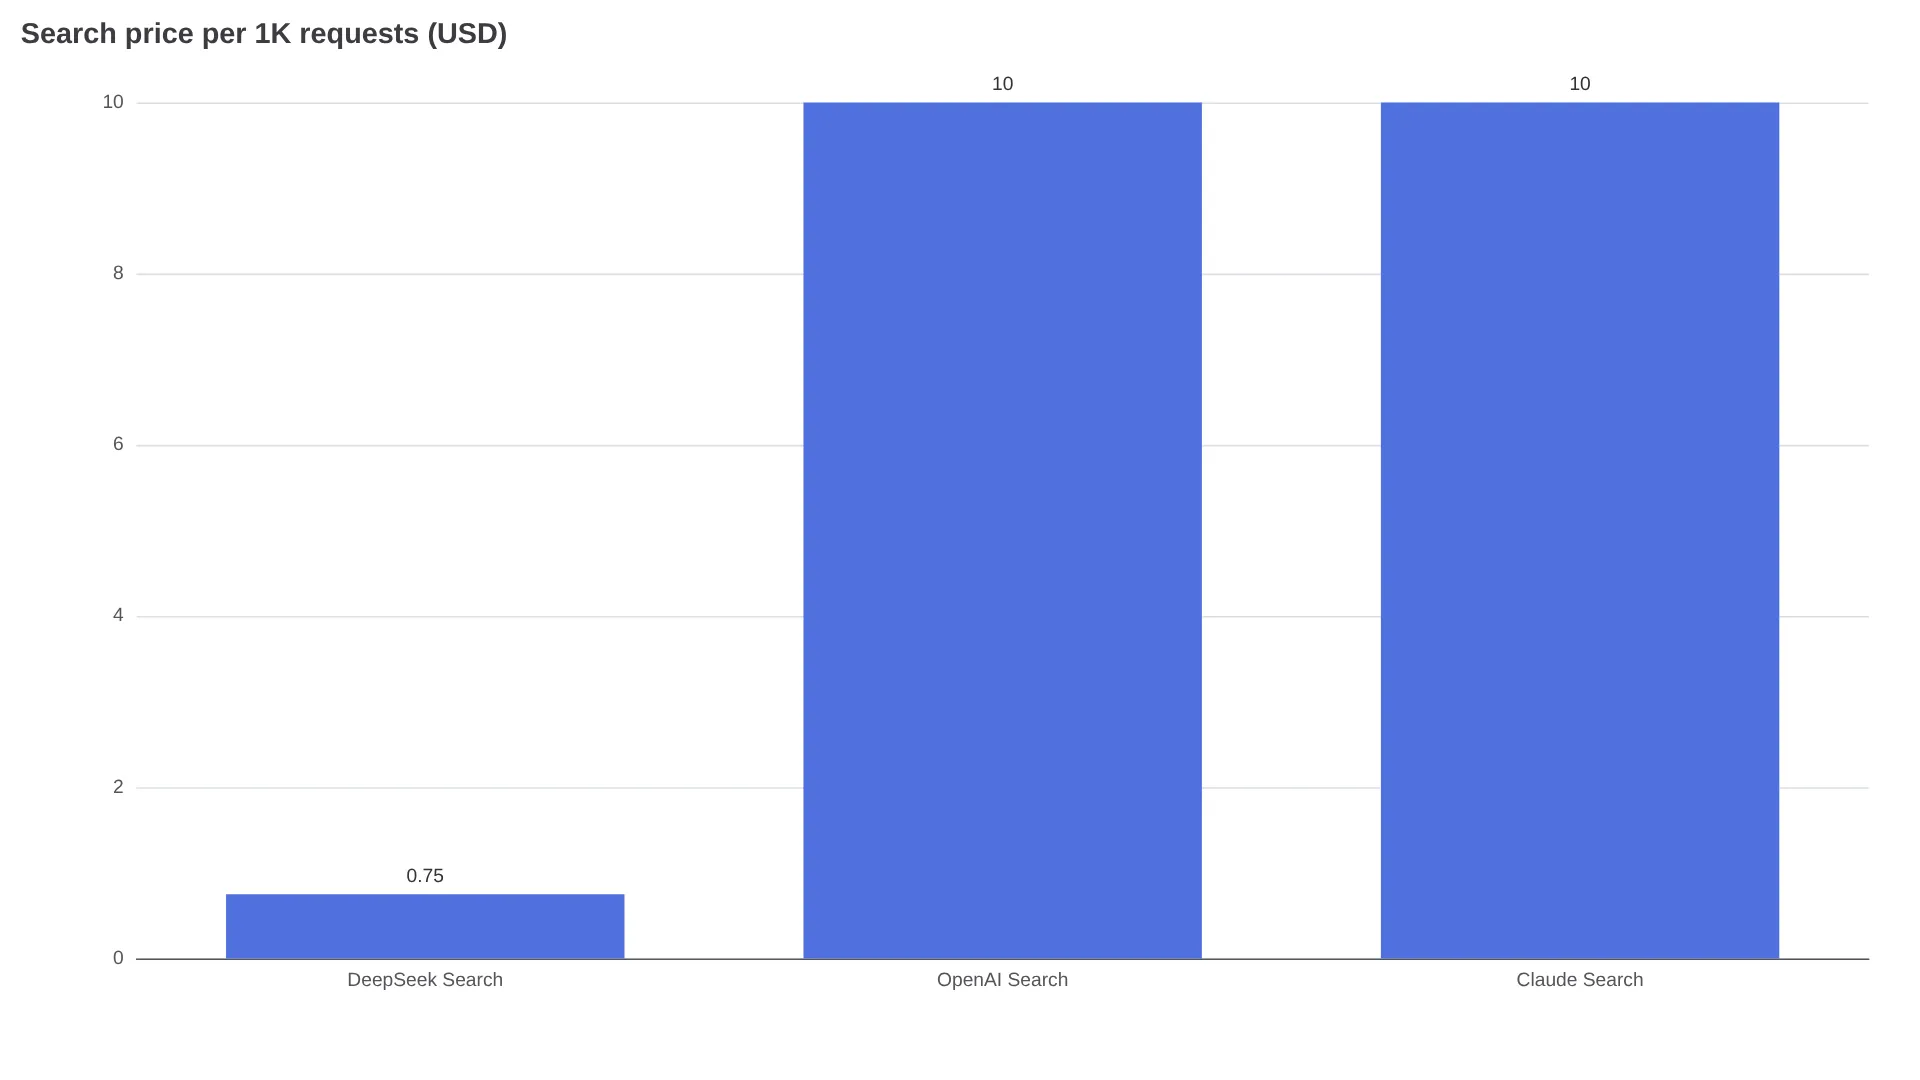
开发者的价格对比显示,DeepSeek 搜索的价格约为每 1,000 次 0.75 美元,而 OpenAI 和 Claude 搜索约为每 1,000 次 10 美元(@berryxia),仅看工具费用,两者相差约 13 倍。
一次只包含一个查询的回答,工具费用不到 0.1 美分。一次深度思考任务如果执行 8 次查询并打开 6 个页面,费用大约是 8 次搜索加 6 次抓取,在 Token 费用之外仍低于 2 美分。真正需要注意的是调用量:代理如果循环执行几十次搜索,0.75 美元这个计费单位会很快累积。应按成功调用次数做预算,限制深度搜索层数,并从最终的usage 对象中记录 tool_search 与 tool_fetch(其中的 web_search_requests 仅用于展示,不是实际计费数量)。
上线前检查:引用、安全与演示代码
根据Web Tools guide,引用会以 web_search_result_location 块返回,其中包含 URL、标题和被引用的文本。流式响应中,它们会作为 citations_delta 事件出现,每个文本块最多包含一个 URL;如果在后续请求中原样传回,这些引用会被忽略。跨轮次传递时,必须完整保留 signature 字段和工具块:读取页面会根据 signature 恢复;即使 signature 无效或缺失,请求仍会成功,但页面内容会被丢弃。聊天机器人指南中的示例轨迹显示,工具调用会让上下文从 40 个输入 Token 增长到 9,078 个,其中 4,096 个来自缓存,因此需要为搜索带来的历史上下文膨胀预留空间。
对于公共应用,DeepSeek 要求执行安全检查,并将审核、模型注册和 AI 内容标注交给开发者负责。内置审查应当只被视为第一道筛选;需要明确处理 refusal 停止原因,并准备应对页面审查失败时出现的 url_not_allowed。这些被拦截的抓取仍然会计费。聊天演示展示了接线方式,但所有内容都在浏览器中运行,正式上线前应自行搭建后端。
常见问题
能不能强制模型每次请求都搜索?
不能。是否调用工具由模型决定;在 tool_choice 中指定网页工具会返回 400。
哪些模型和端点支持网页搜索与文件上传?
deepseek-flash 支持 Messages、Responses 和 Chat Completions。文件 file_id 引用同时适用于 OpenAI 兼容和 Anthropic 兼容系列。
上传的文件能和网页搜索一起使用吗?
可以。这正是官方聊天机器人示例采用的模式:将文件上下文与服务端搜索结合,并返回引用。
一个典型的代理任务会触发多少次搜索?
简单问题可能只需要一次包含几个查询的调用;开启思考的研究任务则最多约触发 20 次工具调用。应按任务统计 tool_search 和 tool_fetch:内置工具按查询或页面计费,独立 API 按成功请求计费,两者价格都是每 1,000 次 0.75 美元。
可以先在演示环境中完成一次内置搜索请求和一次文件上传,查看最终 usage 对象中的 tool_search 与 tool_fetch 计数器,再决定按任务支付工具费用是否比自己搭建 Tavily 或 SearXNG 层更划算。