 AIREITER
把一个 270 亿参数级别的模型塞进手机,如今已经不只是概念演示。PrismML 推出的 Bonsai 27B 是 Qwen3.6 27B 的三元量化版本:1-bit 版仅 3.9GB,在 iPhone 17 Pro 上可跑到约 11 tokens/s;三元版则保留了完整精度模型超过 95% 的基准测试成绩。模型权重采用免费的 Apache 2.0 许可证。不过,压缩后的能力并不均衡:数学和编程表现接近原模型,工具调用与视觉能力的下滑则更明显。因此,Bonsai 27B 适合本地推理和代码任务,却不太适合高度依赖工具的 Agent 工作流。下面会拆解它如何压缩、跑分该怎么看、目前有哪些运行方式,以及哪些人值得尝试。
27B 模型为何能压缩到手机可运行
常规的 27B FP16 模型大约需要 54GB 内存,远超任何手机的容量。Bonsai 27B 能把体积压到 6GB 以下,关键就在于用极小的离散值取代全精度权重。
三元版本将每个权重限定为 -1、0、+1 三种取值,理论上每个权重只需约 1.58 bit 信息。PrismML 还加入了 FP16 分组缩放:每组权重保存一个全精度缩放因子,让离散后的数值仍能落在合适的量级。这样算下来,实际成本约为每个权重 1.71 个有效 bit。更激进的 1-bit 二元版本去掉了 0,只保留 -1 和 +1,降至约 1.125 个有效 bit。
这里有两点尤其值得注意。第一,它是端到端量化:嵌入层、注意力层、MLP 模块和语言模型输出头全部经过量化,没有保留任何全精度组件充当“拐杖”。第二,它的底座是 Qwen3.6 27B——一个拥有 278 亿参数、采用混合注意力机制的因果模型——因此 Bonsai 也继承了 262K token 上下文窗口和多模态输入能力。
三元版还是 1-bit 版:该下载哪个
PrismML 提供了两个版本,选错意味着要么浪费内存,要么牺牲不必要的质量。取舍很直接:文件越小,准确率越低。
| 版本 | 每权重有效 bit | 体积 | 保留质量 | 适用场景 |
|---|---|---|---|---|
| 三元(-1、0、+1) | 约 1.71 | 5.9GB | 超过 FP16 的 95% | 桌面设备、重视输出质量的任务 |
| 1-bit 二元(-1、+1) | 约 1.125 | 3.9GB | 超过 FP16 的 90% | 手机、内存紧张的设备 |
手机用户应选 1-bit 版,它能落在 iPhone 17 Pro 可用的内存余量内。如果笔记本或台式机还有空间,三元版多占用 2GB,却能换回几个百分点的准确率;只要输出质量比体积更重要,这笔交换就值得。
跑分不只看平均分:能力短板在哪里
官方公布的数据针对三元版。它在 15 项思考模式基准测试中的平均分为 80.49,其中几项表现相当突出:
| 基准测试 | 分数 | 衡量能力 |
|---|---|---|
| MATH-500 | 99.20 | 从学校到竞赛级别的数学能力 |
| AIME 2025 | 90.84 | 高难度竞赛数学 |
| HumanEval+ | 93.90 | 代码生成 |
| BFCL v3 | 74.41 | 函数/工具调用 |
把这些成绩放在一起看,Bonsai 27B 的能力轮廓就很清楚了:数学和代码都在 90 分以上,工具调用却只有 70 多分。这是使用前最需要理解的一点:量化对推理和编程能力的保留远好于对结构化、多步骤行为的保留,而后者恰恰是 Agent 工作流所依赖的能力。
这些数字来自 PrismML 自己,因此在独立测试逐渐增多前,更适合作为起点,而非最终结论。不要只看 80.49 的均分,更应关注各项任务的单项成绩和实际失败模式。早期测试者反馈,三元版偶尔会陷入推理循环;而极端量化对长上下文稳定性的侵蚀,往往也比单项跑分呈现得更明显。在真正依赖它之前,最好先用自己的提示词快速验证一遍。
实际速度如何,哪些硬件能跑
如此激进的压缩,前提是推理速度还得能用。在性能足够的硬件上,它确实做到了。以下为 PrismML 公布的数据:
| 设备 | 1-bit | 三元版 |
|---|---|---|
| iPhone 17 Pro | 11 tok/s | — |
| Apple M5 Max | 87 tok/s | 58 tok/s |
| NVIDIA RTX 5090 | 163 tok/s | 134 tok/s |
手机上的 11 tokens/s 足够用于聊天和短推理,虽然谈不上飞快。M5 Max 上的 87 tokens/s 已经足够快,若把网络往返时间算进去,本地推理处理短提示词甚至可能快过云端 API。PrismML 还用“智能密度”来描述这一成果,即每 GB 对应的基准测试分数:Bonsai 约为 0.53,大约是全精度基线的十倍。
现在运行 Bonsai 27B 的四种方式
由于权重是开放的,它并没有唯一的“安装”路径。下面四种方式目前都可用,从零配置体验到完全自主控制都有覆盖。
在 iPhone 上运行
Locally AI 的 iOS 应用可直接在设备端运行 3.9GB 的 1-bit 版本,无需账号,也无需服务器。这才是真正实现“27B 跑在手机上”的路径;权重下载完成后,即可完全离线运行。
直接在浏览器里试用
PrismML 发布了可在浏览器标签页中运行 1-bit 模型的 WebGPU 内核,完全不用安装。它是尝试 Bonsai 27B、又不想先腾出磁盘空间的最快方式,不过设备需要配备支持 WebGPU 的 GPU。
部署到自己的设备
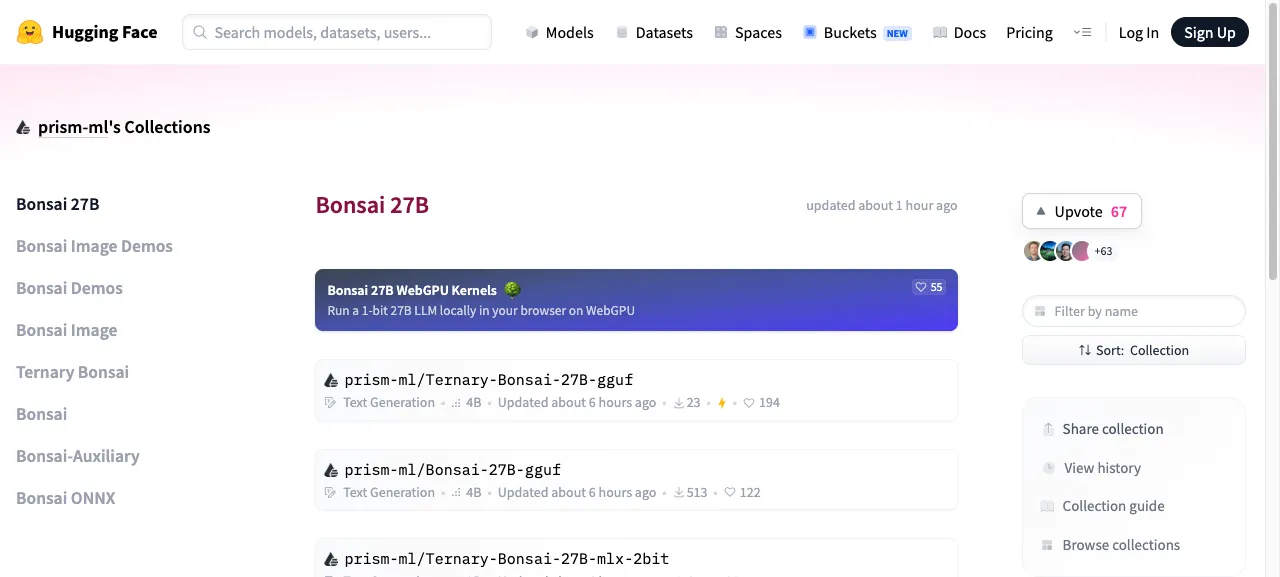
GGUF、MLX 和 ONNX 权重均已在 Hugging Face 和 GitHub 上发布,并采用 Apache 2.0 许可证。主要仓库包括 prism-ml/Bonsai-27B-gguf(1-bit)和 prism-ml/Ternary-Bonsai-27B-gguf(三元版),另有 MLX 2-bit 与 ONNX 版本。1-bit 版大致需要预留 4GB 存储空间和内存,三元版则约为 6GB。需要注意的是,工具链成熟度还没完全跟上发布节奏:这些权重可以载入多个运行时,但发布时 LM Studio 等热门本地应用尚未提供完整支持,因此可能需要手动配置。
通过托管 API 调用
如果不想自行管理权重,Together.ai 已通过标准 API 托管三元版,支持完整的 262K 上下文窗口、视觉输入和 JSON 模式。发布促销期间,输入价格标为每百万 token $0.00;促销价格可能变化,在据此规划预算前请确认当前费率。
Bonsai 27B 对比 Gemma 4 12B QAT
最常被拿来比较的是 Gemma 4 12B QAT。这款由 Google 进行量化感知训练的模型约为 7GB,只比 Bonsai 的三元版稍大一些。
两者的优势并不相同。凭借 27B 的底座,Bonsai 27B 在数学和编程基准测试上明显优于 Gemma。Gemma 在视觉和工具调用方面通常更稳定,其权重略大、压缩程度也没那么激进,因此作为手机上的通用模型会是更稳妥的选择。若设备端任务以推理和代码为主,Bonsai 更值得选;若更依赖图像或函数调用,Gemma 4 12B QAT 更安全。
到底哪些人适合用 Bonsai 27B
如果你需要离线、私密的设备端推理或编程助手,并且拥有 iPhone 17 Pro 级别的设备或性能足够的笔记本电脑,Bonsai 27B 值得尝试。对于研究极端量化的人来说,它同样很有吸引力:能让一个 27B 模型跑进浏览器标签页,本身就是一个重要节点;开放的 Apache 2.0 许可证也让实验门槛更低。若你需要本地方案,它也可以和其他值得用于编程的开放免费模型搭配使用。
不过,暂时不要把它用于依赖可靠工具调用的生产级 Agent 系统、对视觉结果要求极高的任务,或任何无法承受推理循环问题的场景。在这些情况下,压缩程度更低的模型,或通过 API 使用全精度模型,仍然是更稳妥的选择。
常见问题
Bonsai 27B 可以免费使用吗?
权重采用 Apache 2.0 许可证,可免费下载和运行。Together.ai 的托管访问则按其 API 价格收费;发布期间输入价格标为每百万 token $0.00,使用前请确认最新费率。
Bonsai 27B 真的能在手机上运行吗?
可以。1-bit 版体积为 3.9GB,通过 Locally AI 应用可在 iPhone 17 Pro 上以约 11 tokens/s 的速度运行;下载完成后可完全离线使用。
Bonsai 27B 和完整的 Qwen3.6 27B 一样好吗?
很接近,但并不完全相同。三元版保留了全精度模型超过 95% 的基准测试表现,1-bit 版则保留超过 90%;其中数学和代码的保留效果最好,工具调用最弱。
应该下载哪个 Bonsai 27B 文件?
手机或内存紧张的设备请选择 1-bit 版(prism-ml/Bonsai-27B-gguf,约 3.9GB)。如果使用空间更充裕的台式机或 GPU,建议选三元版(prism-ml/Ternary-Bonsai-27B-gguf,约 5.9GB),以换取额外几个百分点的准确率。针对 Apple Silicon 和跨平台运行时,另有 MLX 2-bit 和 ONNX 版本。
什么是三元量化?
三元量化不再将每个模型权重存为全精度数字,而是只保存为 -1、0、+1 三个值之一,因此模型体积能大幅缩小。FP16 缩放因子则用于让这些离散化权重保持大致正确的数值量级。
Bonsai 27B 支持图片吗?
支持。它继承了 Qwen3.6 27B 底座的多模态能力,可同时接受图像和文本输入,并输出文本。不过在这种压缩强度下,视觉能力的保留不如数学和代码能力。