 AIREITER
一台 Mac mini 在本機用 2.81 秒生成了 38.5 秒音訊,沒有雲端帳單。這正是 Zyphra 為 ZONOS3-Mini 打出的成績:這款於 2026 年 11 月 9 日推出、總計 8 億參數的 MoE 文字轉語音模型,每一步實際只啟用約 1 億參數。不過,早期測試者反覆提醒,這些展示是在高階硬體上以英文完成;換成你的文稿、語言與 GPU,表現未必能接近這個數字。
ZONOS3-Mini 是什麼?有哪些執行方式?
Zyphra 的 ZONOS3-Mini 是一款零樣本聲音複製 TTS 模型。提供文字與一段短參考音檔後,它就能以該聲音說話;也可以從 27 種內建聲線中挑選,再調整年齡、口音與音色質感。模型權重採 Apache 2.0 授權,執行程式碼則採 MIT 授權,因此允許本機及商業重複使用。但請只複製你本人擁有、或已取得使用許可的聲音。
模型核心是稀疏 MoE 架構,具備 64 個專家與 top-2 路由;11 個層級以 3:1 的比例混合 Gated DeltaNet 與全域注意力。它也導入新版 Zyphra Audio Codec 1(ZAC-1),以每秒 15 幀運作,取代 ZONOS2 採用的 86 Hz DAC。Zyphra 表示,這項改動讓每秒語音 token 從 774 降至 150,且在相同資料條件下,詞錯誤率約比 DAC 低 10 倍。
主要規格包括:44.1 kHz 輸出、單次最長可生成 10 分鐘、原始音檔複製的參考音訊上限為 60 秒、嵌入式聲音複製上限為 120 秒;訓練使用 112 張 NVIDIA H100 GPU,歷時 2.5 天。
目前有五種執行途徑:
- 免安裝的瀏覽器 WebGPU playground
- 支援 CPU、CUDA、Metal 或 Vulkan 的原生 C++/ggml
- Apple MLX server
- 適用 NVIDIA 伺服器的 SGLang 或 vLLM
- 透過 OpenAI 相容
/v1/audio/speech端點呼叫的 Zyphra 託管 API,模型名稱為zyphra/zonos3-mini
廠商公布的延遲數據為:Pixel 9 瀏覽器首次出音低於 570 ms、M3 MacBook Air 低於 150 ms;單張 H100 搭配 SGLang 時,中位數為 57–80 ms,峰值吞吐量最高可達每秒 457 音訊秒。手機與筆電數字應視為最佳情況。Zyphra 自己的發布討論串,對相同裝置則給出較保守的低於 800 ms 與低於 450 ms,因此在對外承諾效能前,還是應先在自己的硬體上測試。
發布資料仍有兩處未說明清楚:技術文章稱模型總參數為 800M,但模型頁面寫的是 886M;此外,兩處皆未交代浮水印、濫用防護機制,或上傳參考聲音的資料保留政策。
先用瀏覽器試玩,再考慮安裝本機版
瀏覽器 playground 透過 WebGPU 在你的 GPU 上進行推論,無須伺服器,也不用安裝。未被特別強調的是首次載入成本:一位早期測試者表示,頁面在第一次生成前會下載約 920 MB 的模型與編碼器,之後才會由瀏覽器快取。
這個 playground 很適合作為免費的第一輪測試:先試聲音複製與片段級控制,再在效能最弱的目標裝置上比較延遲。WebGPU 的實際表現會隨瀏覽器、驅動程式與 GPU 而變化。
「每次看到小模型能在瀏覽器跑,就別急著喊『雲端 TTS 已死』!WebGPU 在不同瀏覽器與驅動程式上的相容性,坑非常多!英文展示做得好,也不代表你的正式文稿能順利通過!」 — @GKev1n,提醒不要只憑展示結果就取代託管 TTS 的使用者
如果使用者採用舊手機、內顯,或非 Chromium 瀏覽器,不要在未實測前就將 Pixel 9 的數據套用過去。
免逐字稿複製聲音,還能逐詞調整表達
- 零樣本聲音複製:最多使用 60 秒參考音訊,無須逐字稿;原始音檔模式以自然度為主,也可建立可重複使用、日後再調整的說話者嵌入向量。
- 聲線設計:可設定目標年齡、偏陽剛至偏陰柔的聲音表現,以及美式、英式與澳洲口音;也能疊加柔和、沙啞、明亮、低沉等音色質感。
- 表達方式控制:可調整語速、情緒、發聲強度、活力、喚醒度與耳語,甚至精確到特定詞句片段——例如只讓「I didn't say」以耳語說出,其餘句子仍維持中性語氣。
- 生成後編輯:透過類似 VoiceCraft 的模型,可在生成後替換詞語,同時保留原有聲音與設定;讀錯一個人名時,不必整段重新生成。
Zyphra 對這些功能也提出了應有的提醒:情緒與表達參數只是目標,而非保證;調整語速也可能改變音量與音高,調整活力則可能影響音高與時長。
已公開的硬體實測:速度、VRAM 與兩個 Windows 問題
| 測試配置 | 實測結果 | 來源 |
|---|---|---|
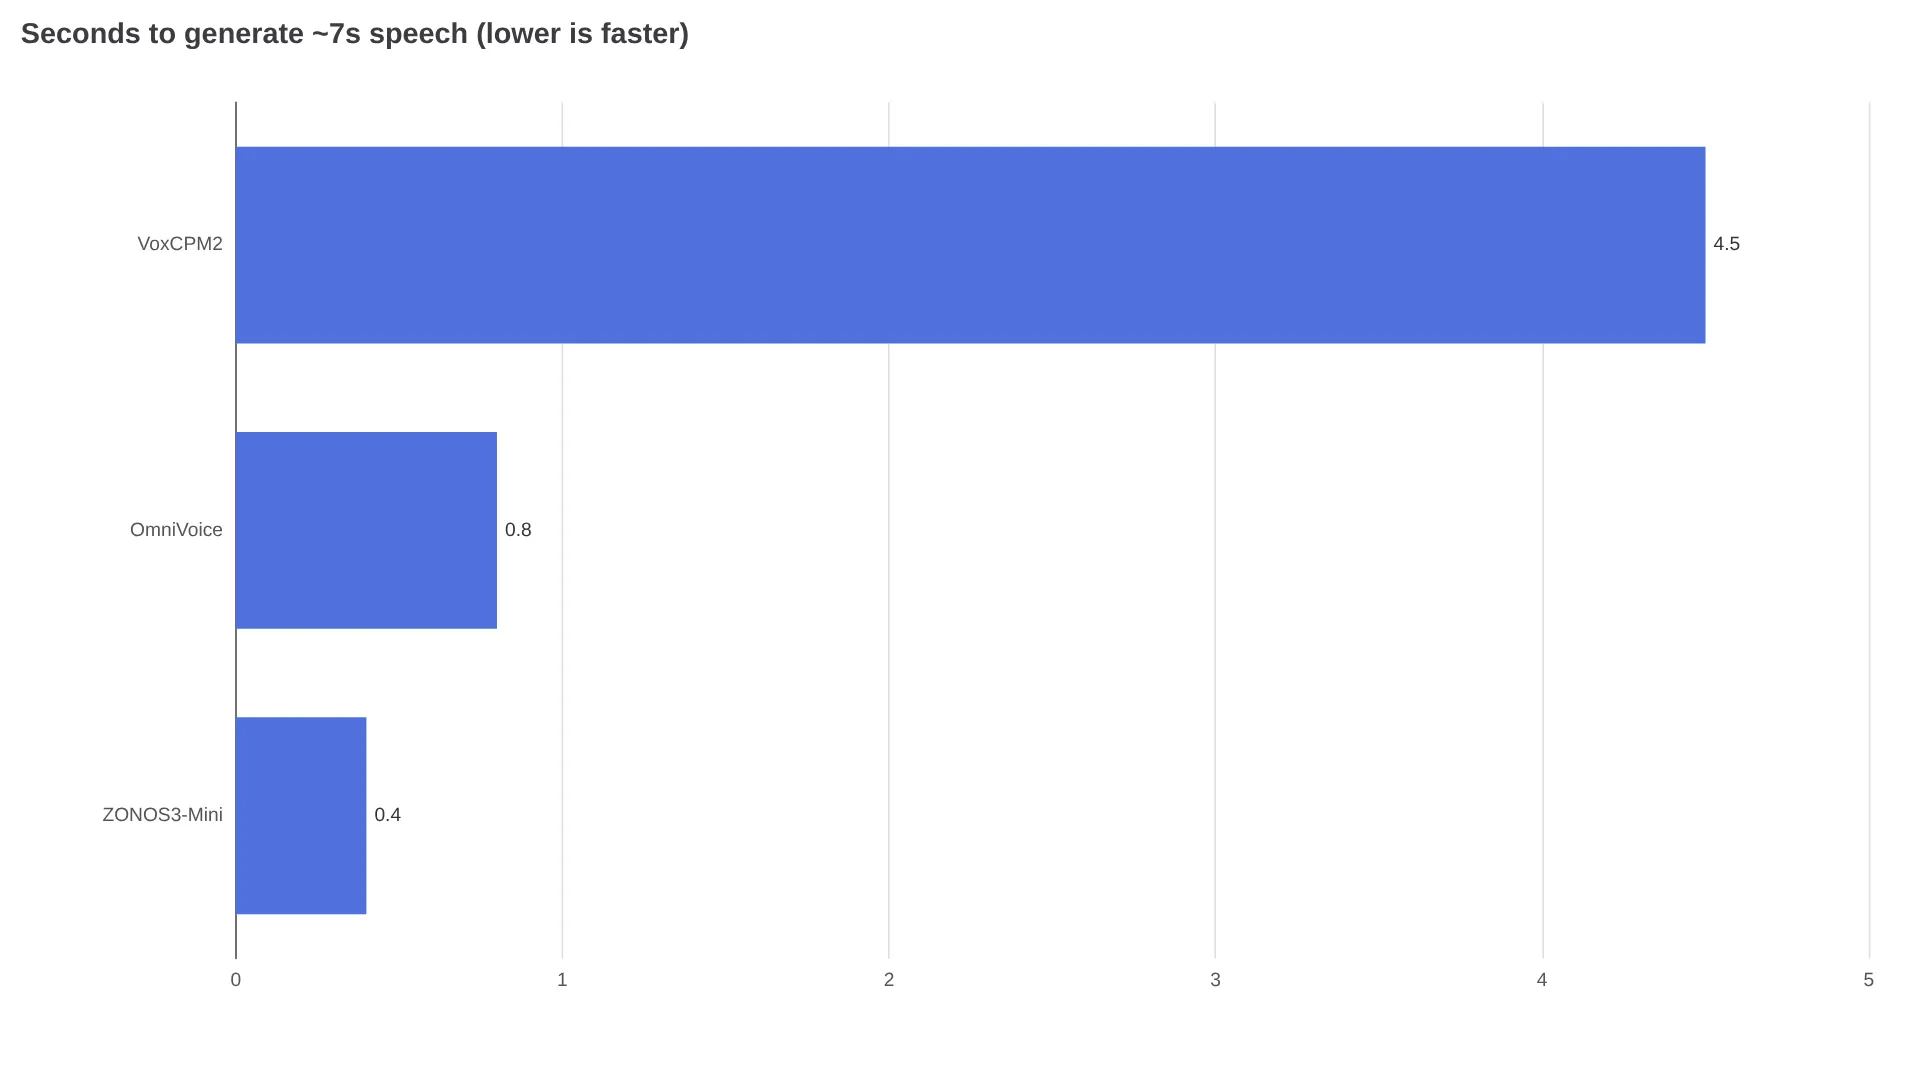
| RTX 5080、量化 ggml(0.66 GB 主模型 + 0.45 GB 解碼器) | 約 7.1 秒日文語音僅需 0.40 秒;總 VRAM 為 2.4 GB——即時倍率 0.056,約為即時速度的 18 倍 | VRAM16 benchmark |
| 同一設備:31 秒段落;CPU-only 7.2 秒片段 | GPU 以 2.5 GB 在 1.50 秒完成;CPU 計算耗時 1.45 秒,從啟動到完成則為 2.38 秒 | VRAM16 benchmark |
| 64 GB M5 Pro Mac mini、MLX server | 38.5 秒音訊在 2.81 秒完成;首次出音 75–100 ms;首次複製聲音時峰值約 16 GB | @pratikg |
GPU 的結果約比同一基準測試先前量到的 OmniVoice 快一倍,也明顯領先該測試中 VoxCPM2 的 0.63x 表現。
完整 2.2 GB 解碼器會將使用量推升至 4.2 GB,但測試者未能確認是否有可聽出的品質差異。以 Whisper large-v3 轉錄後,結果與預期的日文及英文文字相符;這只能證明可懂度,無法證明自然度或與參考聲音的相似程度。
目前最快的本機測試報告來自一名 Apple Silicon 使用者,他在 64 GB M5 Pro Mac mini 上透過 MLX server 測得:
「實測完成:……最高可達即時速度的 13.7 倍。這是在我的 64GB M5 Pro Mac mini 上完成(完全本機執行,使用他們的 MLX server):使用內建聲線時,首次出音時間約 75–100 ms。38.5 秒音訊片段在 2.81 秒生成。從一段 11–13 秒音檔複製新聲音後,約 1.3 秒便能開始說話。……WER 為 0–4%。只用了幾 GB 記憶體(初次聲音複製的峰值約 16 GB)。」 — @pratikg,公開資料集與測試筆記的使用者
這份結果有一項容易被忽略的前提:初次複製時的記憶體峰值接近 16 GB,但快取過的複製聲音速度可與內建聲線相同。若打算批次複製大量說話者,容量規劃應以峰值而不是穩態用量為準。
Windows 原始碼編譯者遇到兩個問題,VRAM16 測試者已提供修補程式。第一個是 Microsoft 編譯器拒絕一個成員同樣命名為 head 的 struct,而 GCC 與 Clang 可以接受;因此應套用提供的重新命名修補,只編譯 zonos3-cli、zonos3-server 與 spk-encoder-cli。另一個問題是日文 Windows 將 CLI 文字以 CP932 而非 UTF-8 傳入,導致音訊內容錯亂;程式改以 GetCommandLineW 重新讀取命令列後才可解決。傳送至 zonos3-server 的 JSON 請求理應已是 UTF-8,但尚未驗證。
實務上的安裝建議是使用不含空格與非 ASCII 字元的路徑,例如 C:\zonos3;安裝含 C++ 工具的 Visual Studio 2022,以及 Git 與 FFmpeg。全新的 CUDA 環境預計需約五分鐘,預設權重約 1.2 GB,另外本機 CUDA 約需 2 GB(安裝說明)。
託管 API 怎麼計費:每百萬 UTF-8 位元組 $10 的意義
託管版本提供 OpenAI 相容的語音端點 https://api.zyphracloud.com/api/v1/audio/speech,以模型 zyphra/zonos3-mini 搭配 bearer ZYPHRA_API_KEY 呼叫。以下範例會啟動本機 SGLang-Omni 伺服器(SGLang cookbook),請求格式與雲端 API 相同。這正是重點:先在 localhost 原型開發,之後只需將 base URL 改成 Zyphra Cloud。
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
定價按位元組計算,不是按字元數或音訊分鐘數:每 100 萬 UTF-8 位元組 $10.00;限制為 1 個並行請求、每日 100 次生成、輸入字元數不限,聲音複製上限則如前述為 60/120 秒。一般英文每個字元約 1 個位元組,若以每分鐘口語約 800–900 個字元估算,$10 約可買到 1,100–1,250 分鐘,亦即每分鐘不到 1 美分。CJK 文字的成本則明顯較高,因為每個字元約需 3 個位元組——單字元成本約為 3 倍;中文、日文或韓文輸入的每分鐘成本,仍應以自己的腳本實際計算。
本機或瀏覽器推論在硬體到位後,邊際成本近乎為零;託管方案較適合原型開發與短期尖峰需求,但在僅 1 個並行請求、每日 100 次生成的限制下,無法支撐正式規模。需要吞吐量的團隊,應評估自架 SGLang 或 vLLM,而不是從 $10 的標價直接推估。
對比 ElevenLabs、Fish、Qwen 與「第一名」標籤
Zyphra 的頁面將 ZONOS3-Mini 與 Fish Audio、Qwen、Cartesia、ElevenLabs 及 OmniVoice 比較,測試素材包括三種腳本:戲劇化的預告片獨白、用來測試一致性的長篇喜劇「straight to jail」段落,以及對話式 Podcast 風格段落。頁面也提供延遲與吞吐量的 Pareto 圖。建議自行聆聽這些樣本,因為頁面雖有播放器,卻沒有文字說明的勝者、競品模型版本、隨機種子,或一致設定的聲明。
數值排名也應以同樣標準看待。Zyphra 的 ZTTS2-Eval 涵蓋 35 種乾淨語言資料與 20 種真實場景語言資料,共有 420 個依指標、資料集與語言區分的項目;其中 Capability Index 將 ZONOS3-Mini 排為開源模型第一,領先 Fish S2 Pro 與 MOSS TTS v1.5。但這是廠商以自己設計的新測試為自己評分。方法雖已公開,截至本文發布時仍未找到獨立重現;與閉源模型的比較也只有音訊,沒有共用分數。
由於 Zyphra 沒有提供逐語言分數,也沒有獨立聆聽測試的勝率,普通話聲調準確性、日文高低音、破音字與長篇情緒表現都尚待證實。投入前請先測試。較誠實的結論是:ZONOS3-Mini 在效率與部署彈性上領先,但其品質領先地位仍未獲證明。
哪些團隊適合現在切換?
| 團隊類型 | 建議 | 原因 |
|---|---|---|
| 離線、裝置端或重視隱私的應用(遊戲、閱讀器、資訊亭) | 立即測試 | Apache 2.0、預設下載 1.2 GB、VRAM 2.4 GB、可使用 CPU,且沒有按分鐘計費 |
| 需要大量聲線的有聲書或 NPC 製作流程 | 先做試點 | 詞級控制與生成後編輯可降低重生成成本,但各說話者的複製相似度仍須驗證 |
| 非英文,尤其是中文正式產品 | 等待自行評測結果 | 廠商未提供逐語言分數;在測試破音字與聲調前,詞錯誤率和韻律表現的主張仍偏向英文 |
| 高並發託管 TTS | 自架或維持現況 | 雲端方案限制為 1 個並行請求、每日 100 次生成;真正的正式環境路徑是 SGLang/vLLM |
| 需要浮水印或稽核軌跡的團隊 | 暫緩 | 發布資料未說明浮水印,亦未交代參考音檔的資料保留政策 |
建議依序測試:瀏覽器 playground、效能最弱裝置上的本機建置,再到託管 API。只有當你的硬體滿足 2.4 GB VRAM 與 WebGPU 條件,且目標語言通過盲聽測試時才切換;否則保留現有閉源 API,等待獨立多語言基準測試出現後再重新評估。
常見問題
ZONOS3-Mini 需要多少 VRAM?
測試中的 RTX 5080 配置總共約需 2.4–2.5 GB(完整解碼器為 4.2 GB;Mac 初次複製聲音的峰值約為 16 GB)。
能在瀏覽器或 CPU 上執行嗎?
可以:WebGPU 首次造訪約需下載 920 MB;在唯一公開的 CPU 測試中,包含啟動時間的合成耗時約為即時長度的三分之一。
聲音複製效果如何?
可用最多 60 秒、無須逐字稿的音訊進行零樣本複製;一項獨立測試報告 0–4% 詞錯誤率,但每位說話者的相似度仍要靠自己的聆聽測試判斷。
可以商業使用嗎?
模型權重採 Apache 2.0,程式碼採 MIT;但複製任何聲音前,你都必須擁有相關權利或取得當事人同意。
API 端點與價格是什麼?
使用 OpenAI 相容的 POST https://api.zyphracloud.com/api/v1/audio/speech,模型為 zyphra/zonos3-mini;價格是每 100 萬 UTF-8 位元組 $10,限制為 1 個並行請求、每日 100 次。
延伸閱讀:Best Text-to-Speech API、Best Voice Cloning API 2026、Kokoro 82M TTS Local Guide