 AIREITER
Muse Spark 1.2 值不值得用?先講結論
Meta 在 2026 年 8 月 5 日推出 Muse Spark 1.2,同步帶來專為它打造、可在終端機執行的 Muse Code agent。相較 1.1,這次在程式開發基準的進步確實看得到;不過面對 Claude Opus 5,它在三項程式測試中仍全數落敗。這正是 Muse Spark 1.2 的核心定位:升級不是假的。Meta 擴大了程式訓練運算資源,也讓模型與 Muse Code agent 共同訓練,成績因此上升;但版本間的躍進有一部分來自新的測試 harness,而不完全是模型本身。無論是 Terminal-Bench、DeepSWE,還是 Meta 自家的內部程式評測,Anthropic 的模型仍領先 4 到 9 分。
但它的價格依然很有吸引力。標準方案維持每百萬 token $1.25/$4.25,貢獻者方案則再便宜約 12 倍。代價也很明確:預設路徑會將你的程式碼送入 Meta 的訓練資料;而在最高推理強度下,首個 token 的等待時間約惡化為原本的九倍。若你正評估是否把 Muse Spark 1.2 用於正式的程式開發流程,這兩點比排行榜名次更值得在意。
相較 1.1,這次到底升級了什麼?
Muse Spark 1.2 是 Meta 前沿推理模型的程式開發導向更新版,於 8 月 5 日推出,並搭配目前處於 beta 的終端機程式 agent:Muse Code。Meta 對它的說法很克制,稱其為相較 Muse Spark 1.1 的「中度改進」。這個措辭看似保守,但這次升級確實集中在程式 agent 最吃力的情境:跨多檔案重構、長時間除錯,以及遠超過單一 prompt 範圍的任務。
帶動進步的訓練設計主要有兩項。第一,Muse Code 從一開始就被納入訓練迴圈。Meta 使用經拒絕採樣的 harness 軌跡,讓模型與這個 agent 共同訓練,使其在自家 agent 中能有最佳表現。公司也表示訓練橫跨多種 harness,因此模型依然能泛化到其他程式工具。第二,Meta 建立了自我改進迴圈:由 Muse Spark 1.1 產生高難度程式環境與指令遵循範本,再對候選解答進行評分,進而形成 1.2 的訓練資料。Meta 認為,正是這套迴圈讓 1.2 在遵循複雜指令方面有可量化的提升。
這次更新直接補強了 Muse 系列最弱的一環。Muse Spark 在 2026 年 4 月首次亮相時,agentic coding 表現落後,SWE-Bench Verified 得分為 77.4,而 Claude Opus 4.6 是 80.8。如今透過程式專用 checkpoint 搭配量身打造的 harness,Meta 直接回應了這項弱點,同時維持通用 agent 能力。
看懂基準成績:有競爭力,但還不是第一
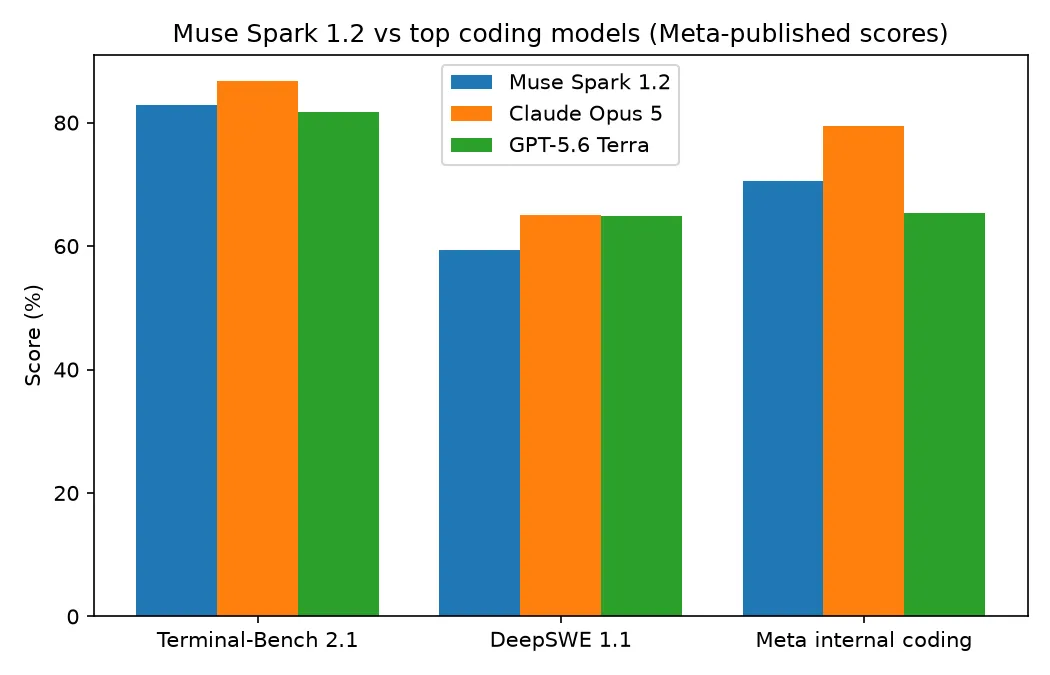
在 Terminal-Bench 2.1 上,於 Muse Code 中執行的 Muse Spark 1.2 拿到 82.9%,略勝 Codex 中的 GPT-5.6 Terra(81.8%)及 Grok Build 中的 Grok 4.5(81.6%);但 Claude Code 裡以最大 effort 執行的 Claude Opus 5 取得 86.7%,仍居第一。DeepSWE 1.1 的成績為 59.3%,排名第三,落後 Opus 5 的 65.0% 與 GPT-5.6 Terra 的 64.8%。Meta 自家的內部程式基準則是三者中最坦率的一項:Muse Spark 1.2 的 70.6% 高於 GPT-5.6 Terra(65.4%)與 Gemini 3.6 Flash(63.9%),但與 Opus 5 的 79.4% 相比仍差近九分。三張榜單的第一名都是 Claude。
跨代進步的幅度並不小:Muse Spark 1.2 在 Terminal-Bench 比 1.1 高出 6.7 分,在 DeepSWE 高出 6.3 分。不過,若要比較版本,圖表標示中的一項細節很重要:1.1 是在通用的 mini-swe-agent harness 中測得,1.2 則是在 Muse Code 中執行。因此,這段成長有一部分應歸功於新 harness,而不只是新模型。在 Artificial Analysis 的綜合 Intelligence Index 上,1.2 得分為 54,在 186 個模型中排名第 14,高於同級中位數 32;相較 1.1 的 51,這項提升就比程式榜單呈現的幅度更溫和。
使用者最常問的,正是它與 Claude、GPT 的正面比較。在 1.2 尚未有資料前,一位 Reddit 開發者便直接問道:
「有人用過 Meta 的 MUSE Spark 1.1 嗎?我很好奇它在推理、程式開發、速度、準確度與 context 處理方面,和 Claude、GPT 相比如何。」
1.2 的基準成績是這個問題第一個足夠嚴謹的答案:它有競爭力,在程式開發上明確居於第二,且在多數圖表中領先 GPT-5.6 與 Gemini 的選項。
正式導入前,先看兩個關鍵限制
Muse Spark 1.2 能否真正融入工作流程,取決於兩個排行榜看不出來的實務細節。
xhigh 模式的延遲明顯退步
Muse Spark 是推理模型,回答前一定會先思考,這個行為無法關閉。/effort 可從 minimal 調整至 xhigh,共有五個等級,而思考 token 也會按輸出 token 計費。最高強度的代價不只一種。OrcaRouter 公布的獨立測量顯示,在 xhigh 下,首個 token 時間從 1.1 的 2.90 秒升至 26.12 秒,約增加九倍;輸出速度則從每秒 213.5 token 降至 165.0 token。使用 1.2 跑 Artificial Analysis Intelligence Index 評測的成本為 $637.85,比 1.1 的 $548.07 高出 16%,純粹是因為模型思考得更多。若是開發者正在等回覆的互動式程式工作,最大 effort 所換來的準確度,往往不值得付出這樣的延遲。
貢獻者方案:用程式碼換取折扣
Meta 為 Muse Spark 1.2 提供兩種定價方案,而它引導新用戶使用的那一種附帶條件。貢獻者方案的輸入/輸出價格為每百萬 token $0.10/$0.20,標準方案則為 $1.25/$4.25;前者輸入約便宜 12 倍、輸出約便宜 21 倍,快取輸入更接近免費,只要 $0.002。交換條件是你明確授權 Meta 使用 prompts 與 completions 訓練未來模型。這是上述比較中最便宜的費率,但你是用自己的資料支付差額。
Muse Code 預設的新手導入流程,會讓開發者進入這個方案。VentureBeat 報導的測試指出,一行安裝指令可在 Mac mini 上順利運作,需要下載 97 MB 並登入;不過 agent 並未實際執行任何內容,反而顯示沒有可見模型,而且即使使用折扣方案仍需提供付款方式。它確實低價,但不是免費。速率限制也更嚴格:每分鐘 60 次請求,標準方案則是 3,000 次。這清楚說明該方案鎖定的是個人與原型開發,而非正式生產環境。擁有專有程式碼庫的團隊,應主動改用標準方案,或透過 Meta 業務窗口申請零資料保留。
放進市場比價:Muse Spark 的位置在哪裡?
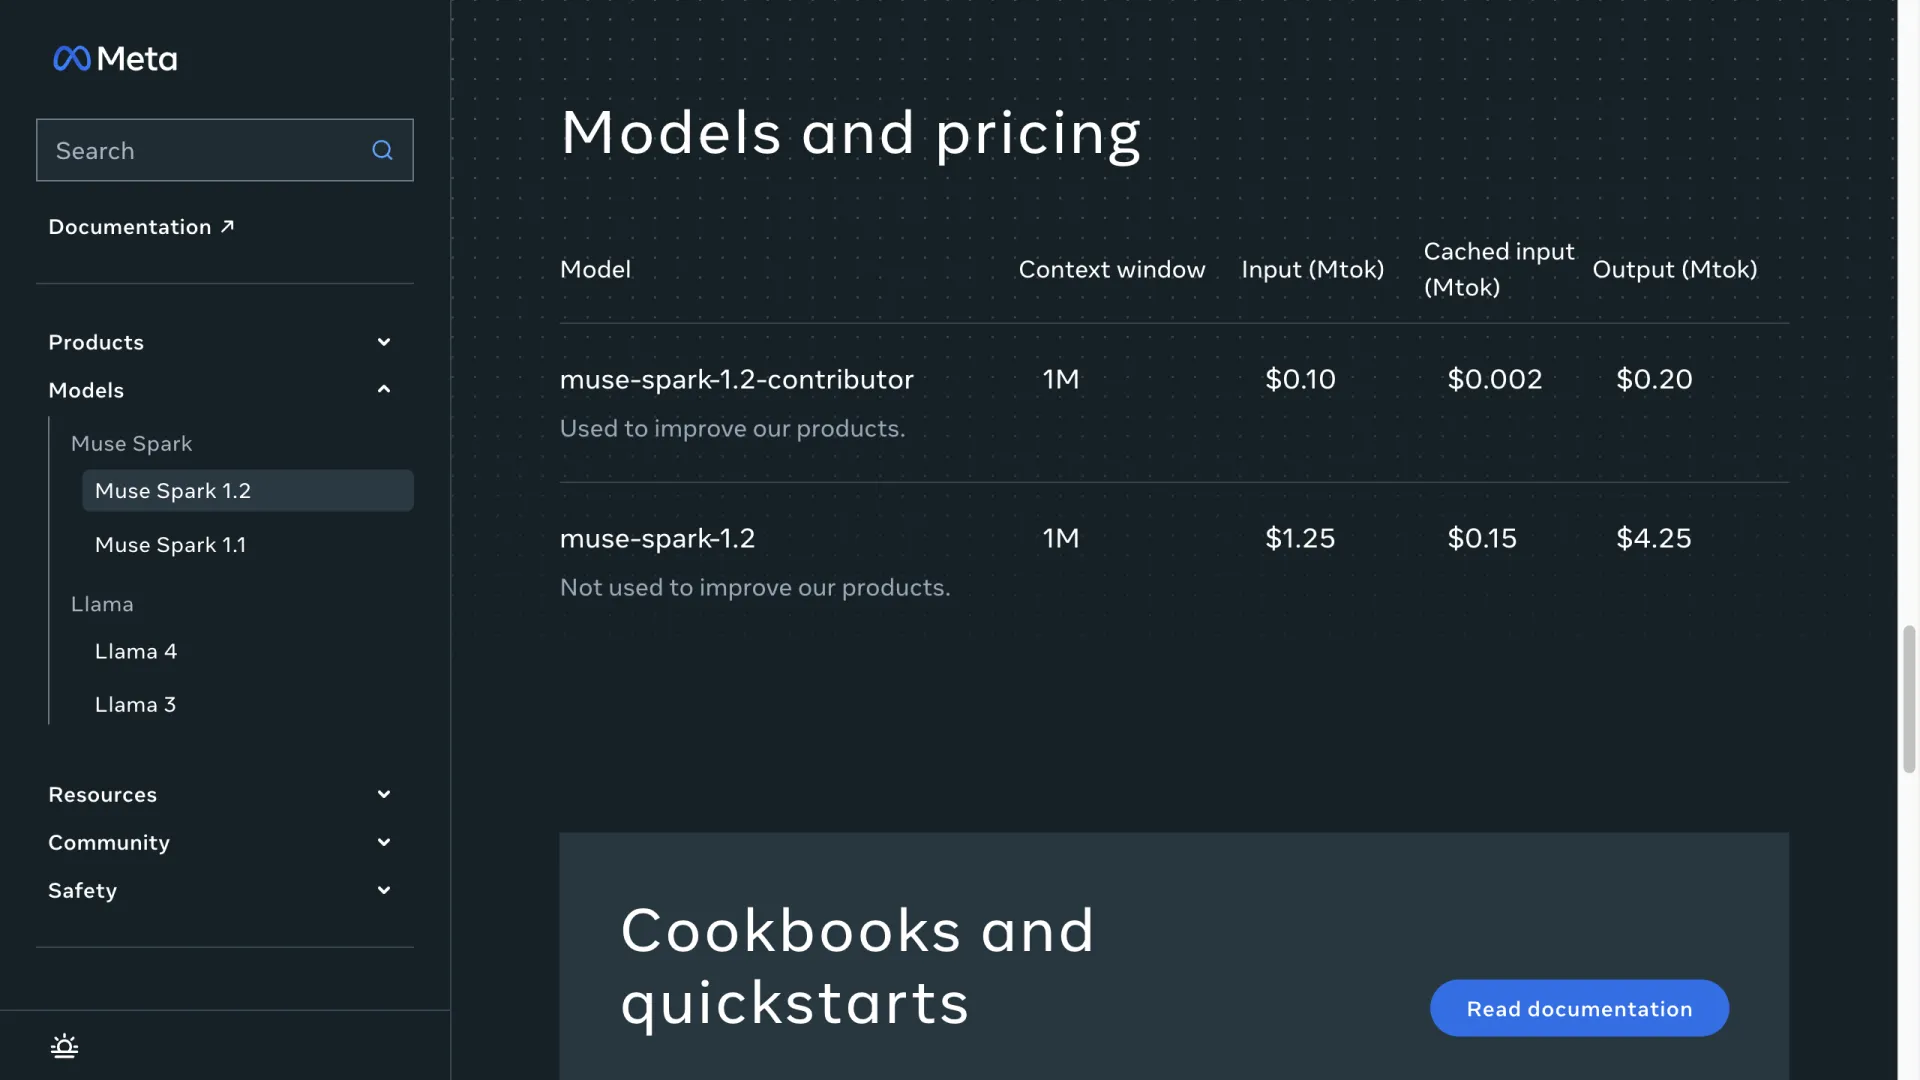
Muse Spark 1.2 的標準方案為每百萬輸入 token $1.25、快取 $0.15、輸出 $4.25,context window 為 1M token,且不收長 context 加價;在程式模型市場屬於中低價位。它明顯比頂尖程式模型便宜:Claude Opus 5 的價格是 $5/$25,GPT-5.5 是 $5/$30,輸出價格約為它的 4 到 7 倍。它與 Z.ai 的 GLM-5.2 幾乎是同價位產品,後者為 $1.40/$4.40;也比 Grok 4.5 的 $2/$6 更低。至於低價市場,DeepSeek V4 Pro 的 $0.435/$0.87 便宜了好幾倍,Muse Spark 的貢獻者方案也是如此。
| 模型 | 輸入 $/M | 輸出 $/M | 快取 $/M | Context |
|---|---|---|---|---|
| Muse Spark 1.2(標準) | 1.25 | 4.25 | 0.15 | 1M |
| Muse Spark 1.2(貢獻者)* | 0.10 | 0.20 | 0.002 | 1M |
| Claude Opus 5 | 5.00 | 25.00 | — | — |
| GPT-5.5 | 5.00 | 30.00 | — | — |
| GLM-5.2 | 1.40 | 4.40 | — | — |
| Grok 4.5 | 2.00 | 6.00 | — | — |
| DeepSeek V4 Pro | 0.435 | 0.87 | — | — |
\*貢獻者方案授予 Meta 使用你的資料訓練模型的權利;上限為每分鐘 60 次請求。
目前在哪裡可用?今天能選什麼替代方案?
Muse Spark 1.2 目前可透過三個管道取得:Meta Model API、Muse Code 終端機 agent,以及 OpenRouter。它尚未登上所有聚合平台;截至 2026 年 8 月 6 日查詢,AIReiter 的目錄尚未列出它。若你的技術堆疊依賴統一 API,又希望今天就使用程式模型,只能從現有已接入的選項中挑選。
目前最接近其價位帶的選項是 GLM-5.2,價格為 $1.40/$4.40。2026 年 8 月 6 日,我透過平台 API 路由的 glm-5.2,執行了一項單次程式推理任務,看看「今天就能用」的模型表現如何:題目是一個缺少透支檢查的 Python 提款函式。GLM-5.2 在 3.2 秒內回覆,使用 85 個 prompt token 與 128 個 completion token;它正確指出缺少餘額保護條件,給出修正程式碼(if amount > 0 and account_balance >= amount:),並寫出一個修正前會失敗、修正後能通過的測試。這只是一項任務,不是基準測試;但它證明同價位已有可立即呼叫、能正常工作的程式模型。AIReiter 目錄中另有 DeepSeek V4 Pro、Kimi K3、Claude Sonnet 5 與 GPT-5.6 系列等具備程式能力的選項。
該不該用 Muse Spark 1.2?
答案取決於你最在意的是什麼,大致可分成三種情境。
選 Muse Spark 1.2,如果你需要大規模、重視成本的程式開發能力,例如大型多檔案重構、長時間除錯與長跨度 agentic 任務,且願意直接使用 Meta、Muse Code 或 OpenRouter。以 $1.25/$4.25 的價格,它提供前沿級程式能力與中階定價;1M context window 加上 context compaction,也適合超出單一 prompt 範圍的工作。除非任務可接受 26 秒才收到首個 token,否則推理強度不要調到 xhigh。
選 Claude Opus 5,如果你需要程式基準榜上的最佳成績。它在 Muse Spark 1.2 出現的三項基準中全數領先;不過,你得為這份準確度優勢付出每 token 高出 4 到 6 倍的費用。
選擇已在你的聚合平台上的模型,如果你今天就得上線,而 Muse Spark 尚未在你的平台提供。GLM-5.2 能立即提供相同價位帶的選擇;若原始成本才是絕對優先,DeepSeek V4 Pro 還會更便宜。
常見問題
Muse Spark 1.2 的程式能力比 Claude Opus 5 好嗎?
不是。Claude Opus 5 在 Meta 公布的三項程式基準中全部領先,包括 Terminal-Bench 2.1、DeepSWE 1.1 與 Meta 內部程式評測,領先幅度為 3.8 到 9 分。Muse Spark 1.2 明確居於第二,且在多數圖表中優於 GPT-5.6 Terra 與 Gemini 3.6 Flash。
Muse Spark 1.2 是開源模型嗎?
不是。不同於 Meta 的 Llama 系列,Muse Spark 是專有模型:僅限雲端使用、不提供可下載權重,也無法自行部署。Mark Zuckerberg 曾表示,對於可能的開源發布「將有更多消息可分享」,但 1.2 推出時沒有提供權重或授權條款。