 AIREITER
Modal 多節點工作負載的費用,是按照完整資源配置計算,而不是另外收取叢集訂閱費。Modal Clusters 已正式提供一般可用版本,但最終帳單仍取決於每個容器實際消耗的 GPU、CPU、記憶體、儲存空間與網路流量。
一分鐘看懂 Modal Clusters 定價
官方的 Modal 定價頁面與正式可用公告說明,Modal 採用按用量計費,並透過 @modal.clustered 這個入口點,同時啟動多個容器。選用 RDMA 會改變節點間的通訊路徑,但不會改變基本的計價公式。
GPU 數量 × GPU 秒數 × GPU 費率 + CPU 秒數 + 記憶體 GiB-秒數 + 儲存空間 + 適用的輸出流量
這個公式之所以重要,是因為叢集會把完整的節點配置一起放大計算。假設工作負載要求四個節點、每個節點配置八張 H100,計費對象就是 32 張 H100,而不是一個協調節點,外加幾個「免費」工作節點。
Modal Clusters 如何套用到現有費率
Modal 在 2026 年 10 月 1 日推出 GA 版本,將多節點執行變成由平台管理的原生功能。size 用來設定容器數量,而在支援的環境中,rdma=True 則會啟用高速通訊路徑(Modal 公告)。
文件將這套機制描述為 gang scheduling:Modal 會嘗試把整組請求的容器安排在一起,而不是先啟動一部分、最後因資源不完整而無法工作的任務。支援的場景包括分散式訓練、微調、模型平行推論,以及需要同步 GPU 通訊的 prefill/decode 架構。
叢集文件也列出幾項實務限制:GPU 必須以完整節點為單位配置,不支援純 CPU 叢集,而且只要有容器失敗或被搶佔,整個 clustered call 都可能失敗。系統只會回傳 rank 0 的輸出,因此長時間執行的工作需要把 checkpoint 儲存在容器之外。
Modal Clusters 帳單背後的 GPU 費率
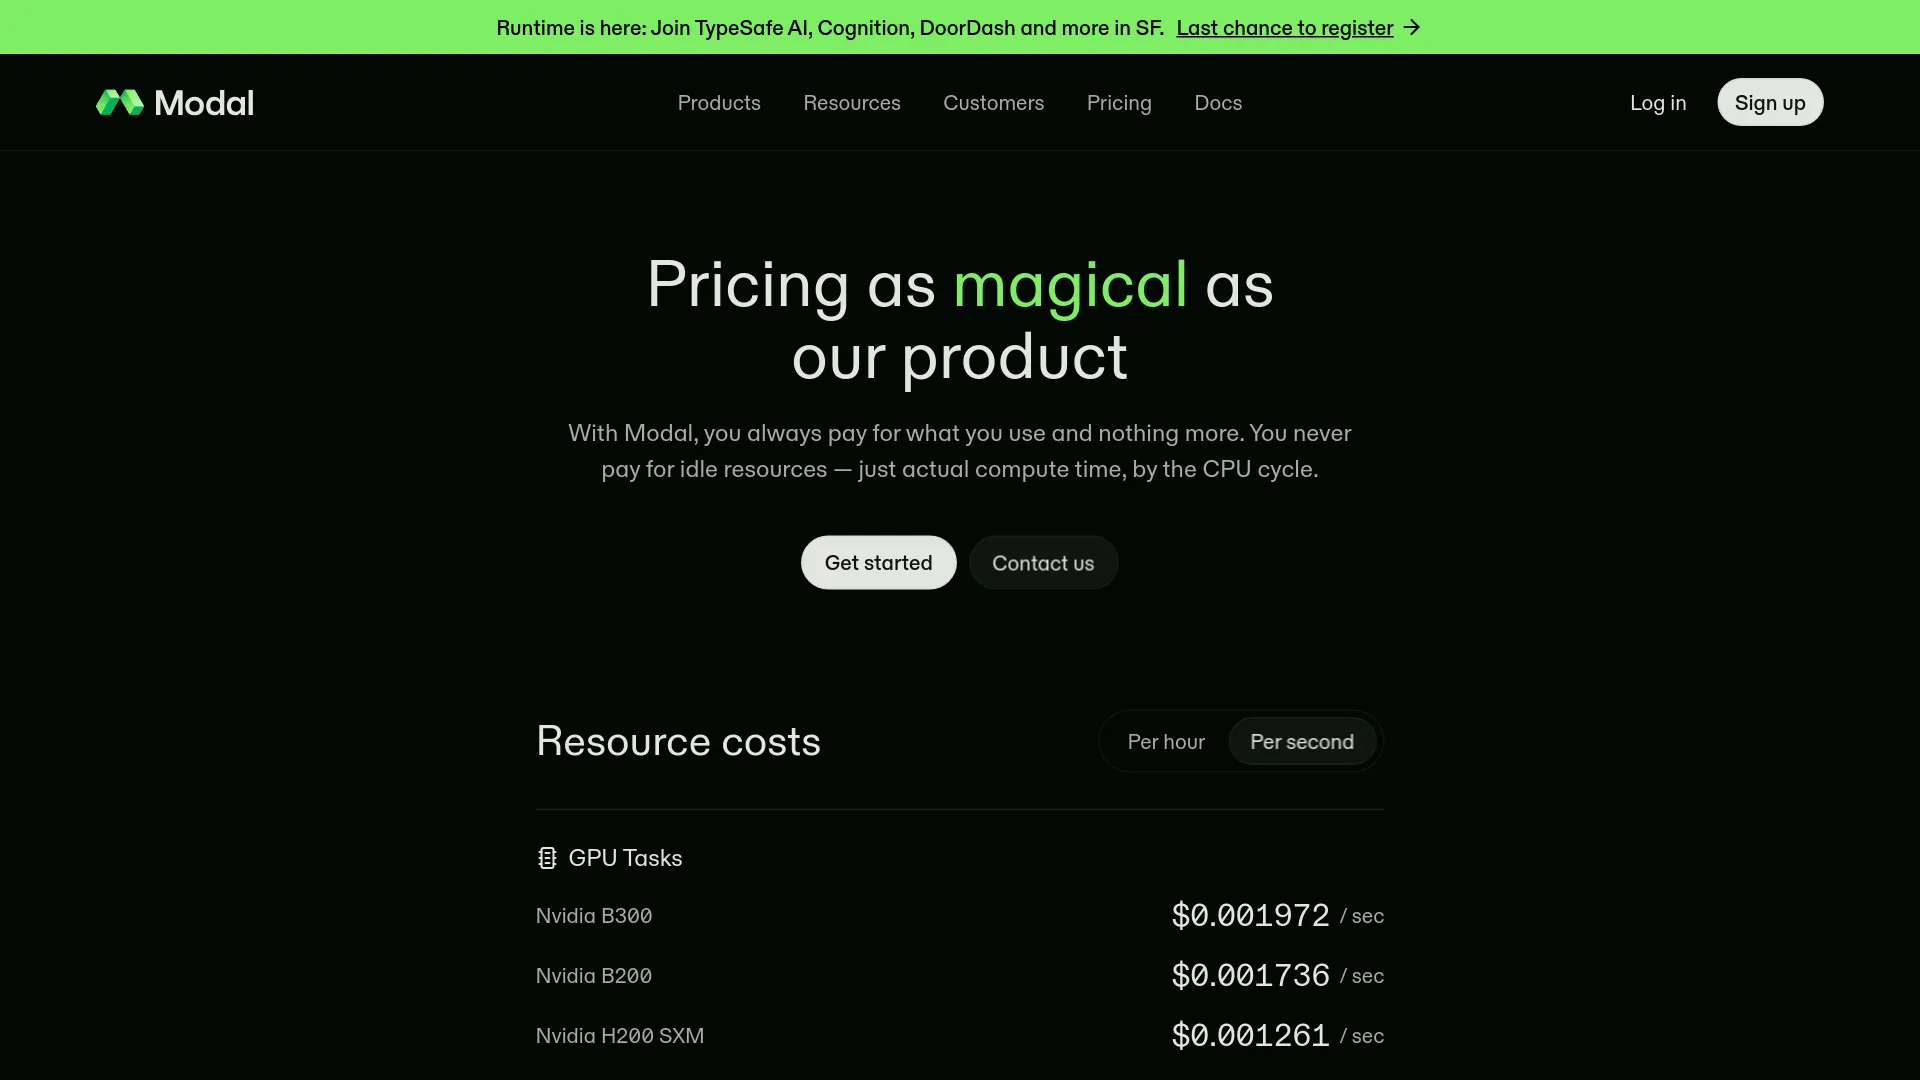
以下公開費率可以作為估算的起點。每 GPU 小時的數字是從每秒費率換算而來,尚未包含 CPU、記憶體、儲存空間,以及可能適用的區域乘數。
| GPU | 每秒 | 約每 GPU 小時 |
|---|---|---|
| B300 | $0.001972 | $7.10 |
| B200 | $0.001736 | $6.25 |
| H200 SXM | $0.001261 | $4.54 |
| H100 SXM5 | $0.001097 | $3.95 |
| A100 80 GB | $0.000694 | $2.50 |
| L4 | $0.000222 | $0.80 |
Modal 另外列出的 CPU 費率是每個實體核心每秒 $0.0000131,記憶體則是每 GiB-秒 $0.00000222。Volume 儲存空間為每 GiB 每月 $0.09,前 1 TiB 免費。超過包含額度後,網路輸出流量為每 GiB $0.04。大型工作負載啟動前,請先在官方費率表確認最新數字。
實際算一次:四個節點、每節點八張 H100
假設一個分散式訓練工作要求 size=4,而每個節點配置 H100:8。
- 四個節點 × 每節點八張 GPU = 32 張 H100 GPU。
- 32 × 每小時 $3.95 = GPU 成本約為每小時 $126.40。
- 把 $126.40 視為只有 GPU 的最低成本;CPU、記憶體、儲存空間與輸出流量都要另外計算。
這就是拿來和預留容量或專用容量比較的基準。無伺服器架構的優勢,在於工作高峰結束後可以縮減叢集;但叢集全速運作時,並不會因此變得便宜。
方案限制可能比費率更早成為瓶頸
功能正式 GA,並不代表容量無上限。Modal 的公開工作區方案包含並行數與平台限制,大型叢集可能在價格成為問題之前,就先被這些條件擋下來。
| 方案 | 平台費用 | 包含的運算額度 | 公開 GPU 並行上限 |
|---|---|---|---|
| Starter | $0/月 | $30/月 | 10 張 GPU |
| Team | $250/月 | $100/月 | 50 張 GPU |
| Enterprise | 客製 | 客製 | 客製/更高限制 |
一個使用 32 張 H100 的實驗,已經會占用 32 張 GPU,因此 Starter 方案的 10 張 GPU 並行上限無法支援上述範例。Team 方案從 GPU 數量來看可以容納,但實際排程仍會受到可用容量、區域選擇與指定硬體影響。
不要把 Starter 的 $30 額度理解成 30 個免費 GPU 小時。以列出的 H100 費率計算,這筆額度約等於 7.6 個 H100 GPU 小時,而且還沒扣除工作所需的其他資源。
什麼情況下 Modal Clusters 比較划算?
Modal Clusters 最適合大型、間歇性,而且若要自行維持基礎設施會相當麻煩的工作負載。訓練高峰只持續幾個小時、之後就能完全關閉的工作,比起連續運作數週的叢集,更能發揮自動縮減到零的優勢。
適合採用的情境包括:
- 需要所有節點同時啟動的分散式微調。
- 使用昂貴 GPU、但只會短時間出現的訓練高峰。
- 需要 RDMA 或模型平行化的多節點推論。
- 原本必須自行維護 Kubernetes、SLURM 或手動設定 RDMA 的 Python 團隊。
如果模型放得進單一機器,使用單節點的 Modal function 會更合適。當使用率可預測、工作負載需要固定 SLA,或主要目標是壓低長期 GPU 小時成本時,也應認真比較專用或預留基礎設施。
一段真實使用者的討論,也指出了適用邊界。在一則電腦視覺討論中,u/Substantial_Camel735 建議把向量搜尋留在 VPS 上,而不是讓 Modal worker 負責這部分工作(Reddit 討論)。這只能視為一位實作者的架構偏好,不能當成整個平台的基準測試結果。
「我們正準備離開 modal,不過那個設計方向聽起來是對的;我不會用 modal worker 來做搜尋,而是讓它在 VPS 上直接查詢你的向量資料庫。」— u/Substantial_Camel735,r/computervision
大型工作啟動前,先檢查這些運作細節
- 先乘出完整資源配置。 計算
size × 每節點 GPU 數量,再拿總數和工作區的並行上限比較。 - 從最小但有意義的叢集開始。 先用兩個節點測試,可以在 32 張 GPU 的啟動把帳單放大之前,找出映像檔、NCCL、rank 與 rendezvous 問題。
- 把 RDMA 與應用程式除錯分開。 如果工作負載允許,先在不使用 RDMA 的情況下驗證分散式工作,再啟用
rdma=True,測量對通訊敏感的路徑。 - 把 checkpoint 寫入持久儲存。 任一 rank 失敗或被搶佔,都可能導致整個 call 失敗;沒有 checkpoint 的重試,可能會把整個昂貴工作重新跑一次。
- 把 CPU、記憶體與輸出流量算進預算。 GPU 計算只是帳單的第一行,尤其當資料集或輸出需要跨區域傳輸時更是如此。
- 確認是否真的需要固定區域。 限定部署位置可能改變可用的排程池與價格乘數;應把區域性視為需要實測的需求,並對照最新的區域定價文件確認。
Modal 的官方定價沒有把 RDMA 列為獨立收費項目。RDMA 的價值在於效能:同步訓練與大型 KV cache 傳輸,使用一般 TCP 時可能受到網路頻寬限制。代價是,支援 RDMA 的硬體與部署位置可能會讓可用容量變少。
Modal Clusters 常見問題
Modal Clusters API 會另外收費嗎?
目前沒有公開的獨立叢集附加費。Modal 會按照每個容器使用的資源計費,包括 GPU、CPU、記憶體、儲存空間,以及適用的網路用量。
叢集的最大規模是多少?
GA 資料指出,公開叢集最多可達 32 個節點或 256 張 GPU;更大的需求則需要透過 Modal 處理(GA 公告)。工作區並行上限與實際容量仍然適用。
Modal Clusters 可以執行推論嗎?
可以,但工作負載必須符合叢集執行模型。需要多節點或模型平行化的推論,比一般 HTTP endpoint 更適合使用這項功能;叢集式 web function 也有一些限制,例如流量會送到 rank 0(叢集文件)。
實際該怎麼選
| 你的工作負載 | 建議起點 |
|---|---|
| 模型放得進單一 GPU 或節點 | 一般 Modal function |
| 短時間、需要同步的多節點訓練高峰 | Modal Clusters,先做小規模測試 |
| 長時間且使用率穩定的滿載工作 | 比較專用或預留 GPU 容量 |
| GPU 推論旁邊還需要搜尋或資料庫服務 | 將資料服務分開,除非實測證明共置更合理 |
| 嚴格要求私有網路或自建環境 | 評估其他部署模式 |
Modal Clusters 讓多節點 GPU 編排更容易開始,但不代表它天生比較便宜。無伺服器排程與 Python 開發體驗可以節省工程時間;另一方面,長期使用率、區域限制,以及整個叢集重試的成本,都可能主導最終帳單。先算清楚完整節點數,再比較這份便利性溢價是否值得,並與專用容量放在一起評估。