 AIREITER
MiniMax 在 H3 模型卡中直接把前處理層稱為「最終輸出品質的關鍵」;但 Reddit 一篇獲得 220 個讚的 H3 提示詞討論串,核心卻是在抱怨對話變成亂碼。這篇 MiniMax H3 提示詞評測,將官方格式與創作者實測、失敗回報放在一起檢驗:從這些案例來看,鏡頭與參考素材控制的可靠度高於對話與音訊,而最好的結果有時恰恰來自刻意偏離官方語法。
MiniMax H3 的提示詞格式到底是什麼
官方的 MiniMax H3 提示詞是一份三欄式結構化文件,由 integrated_multimodal_description、overall_soundscape 與 non_diegetic_music 組成;其中可放入帶時間碼的分鏡、持續沿用的說話者 ID,以及 <d> 對話標籤。之所以需要這套格式,是因為 H3 預期接收一個結構化的中間表示,通常由 MiniMax 未隨開放權重釋出的託管前處理器 H3-Context-IR 產生。託管 API 會替你把自然語言需求改寫成這種格式;若是在本機執行 33B 開放權重模型(SGLang、vLLM、Diffusers、ComfyUI),就得自行把結構寫完整。
MiniMax 也在官方 GitHub repo提供可攜式的 h3-prompt-writing skill:兩份指南檔案 base-en.txt 與 ref-en.txt,任何程式代理都能直接讀取,不需呼叫外部 API。創作者會在 Claude 或 Cursor 裡使用它,將自然語言簡報轉成完整格式;@AI__TSUBAKI 就完整記錄了用這套流程製作電影感短片的做法。
寫提示詞前必須知道的規格限制
| 限制項目 | 數值 | 對提示詞的影響 |
|---|---|---|
| 片段長度 | 4–15 秒,24 FPS | 時間碼必須嚴格遞增,且不得超出片段時長 |
| 音訊 | 32 kHz 立體聲,同步生成 | 環境聲與配樂欄位必填,可填 N/A |
| 解析度 | 預設 768p;2K 透過 H3-Regenerate-2K 取得,僅限 API | 先以 768p 測試,提示詞定稿後再付費升到 2K |
| 任務類型 | T2VA(文字)、I2VA(0.00 秒首幀)、FL2VA(首幀+尾幀)、L2VA(尾幀)、Ref2VA(全向參考) | 每種類型都有專屬的對齊句 |
| 參考素材上限 | 9 張圖片+3 段影片+3 段音訊,合計 12 個檔案;每種媒體總長度 ≤15 秒 | 參考素材越多,代表需要處理的路由越多,不一定更好 |
| 提示詞長度 | 官方範例約 300–700 字;純文字轉影片上限約 7,000 個字元 | 官方手冊特別指出:沒有參考素材的短提示詞是常見失敗模式 |
一份可用的最低限度完整提示詞,只要三個欄位、一項鏡頭指令、一位畫面中可見且說出引號台詞的角色,以及不使用配樂,十行內就能完成:
integrated_multimodal_description: 電影感真人拍攝。[鏡頭 1] 一名二十多歲後段的女性坐在灑滿陽光的沙發上,手持一瓶霧面綠色保養品。鏡頭以小幅度、慢速推近。她出現在畫面中並說:
"這是我每年都會回購的唯一一款產品。" 於 00:05.500 時,她把瓶子放下。
overall_soundscape: 安靜的室內底噪、窗外隱約的車流聲、輕柔的布料摩擦聲、瓶子放到桌面時細微的接觸聲。
non_diegetic_music: N/A
完整的欄位語法、各種標籤、對齊句與範本,請見我們的 MiniMax H3 prompt guide;本文要探討的是,這整套語法究竟值不值得花力氣遵守。
官方格式的三個承諾,實測站得住腳嗎?
官方指引隱含了三項承諾。從引用的使用者報告來看,前兩項表現明顯優於音訊遵循度。
承諾一:結構化格式能讓結果更接近預期
這一點的證據最充分。X 創作者 @AIWarper 在改用官方結構後,貼出了前後對照:
「我強烈建議大家遵循 Minimax 發布的提示詞指南。它真的很有助於得到你預期的結果……我上一篇貼文沒有使用建議的提示詞結構。」— @AIWarper,306 個讚
第三方測試紀錄也在細節層面得到相同結果:測試指定在 00:05.000 精準切鏡,實際成功;腳本式見證台詞被逐字念出;首幀構圖在一段 6 秒的 I2VA 片段中也維持穩定。分鏡案例同樣吻合:@aimikoda 的分鏡會被視為連續鏡頭指引執行;@nanyuan0412 的分鏡也被照著執行,沒有自行加戲,唯一例外是他們漏寫音訊欄位,結果幾乎沒有聲音。
反覆出現的問題並非模型拒絕執行,而是節奏失控。u/Relevant_One_2261 表示:「最大的問題一直都是節奏。」台詞塞不進片段時長,以及時間碼間距過密,都是最常見的結構性失敗原因。
承諾二:鏡頭指令比描述最終畫面更有效
有一個失敗後修正成功的案例可作為佐證。r/StableDiffusion 一名使用者希望讓行走中的人物全身始終留在畫面內,只寫了「entire subject remains visible throughout」這類結果描述,卻一再失敗。後來把需求改成 H3 能理解的鏡頭語法後,問題就解決了:
「鏡頭以大幅度拉遠,速度與主體向前行走的速度一致,維持全身構圖。」— u/Powerful-Goal52,原發文者確認有效
這正好對應 H3 的三個鏡頭維度:運動類型、幅度與速度,以及每個鏡頭僅使用一項鏡頭指令的規則。以下是常見需求的轉換方式:
| 你想達成的畫面結果 | H3 較容易遵循的指令 |
|---|---|
| 人物行走時始終完整入鏡 | 以大幅度 Pull Out,速度配合主體行走速度 |
| 輕微強調主體,又不破壞構圖 | Push In,小幅度,慢速 |
| 揭示靜止主體周遭的環境 | Truck Left 或 Truck Right,中等幅度 |
| 改變鏡頭高度但不俯仰 | Pedestal Up / Pedestal Down,慢速 |
官方提示詞指引列出 13 個運鏡類型:Zoom、Push、Pull、Pan、Tilt、Truck、Pedestal、Arc、Tracking、Static、Shake、Roll、POV,每一類再搭配幅度與速度。實務上,Zoom 是焦距變化,Push 則是攝影機實體移動,兩者不能混為一談。
承諾三:把音訊分欄寫清楚,成品就會乾淨
這是最薄弱的一環。將畫內環境聲與畫外配樂分開,本身是合理設計,但模型的遵循度並不穩定:
「我會這樣寫,但大約有 20% 的時候它還是會加音樂,笑死。」— u/TheElectriking 談
non_diegetic_music: N/A
那篇獲得 220 個讚的討論串還整理了其他問題:片段邊界出現音訊雜訊、角色說出隨機亂碼、以及台詞由錯的人講出。u/krigeta1 表示,自己傳入三段自訂音訊參考後,得到的卻是「隨機的聲音,或不是我指定給角色的音訊」。另一篇討論串則透過明確將說話者 ID 綁定到畫面中可見角色,解決了原本畫面內台詞被念成畫外音的問題。
畫面文字也有類似脆弱性。社群 wiki稱其為「exact text is fragile」:如果品牌文字不能出錯,最好以圖片作為參考,或在後製階段合成。也有不同意見:@web4miko 表示,依其測試,H3 在文字與上下文理解上「甚至贏不了 Seedance 2.0」。在這些報告中,音訊路由、精準文字與高密度上下文,都是反覆出現的弱點。
哪些時候該打破官方語法
在引用的並列比較與第一手回報中,有三種偏離官方格式的做法特別值得注意。在投入完整結構前,先知道這三點會更實際。
有時直接用引號,比 <d> 標籤更好。 r/StableDiffusion 一篇並列比較貼文約有 105 個讚、81 則留言;原發文者發現,移除指南建議的 <d>[Language]...台词...</d> 標籤、改成普通引號台詞後,語音更乾淨,而加標籤的版本反而產生未要求的音訊。一名做過類似測試的留言者也認同:
「官方的對話提示詞寫法 bug 多得很……用引號的方式仍然沒那麼容易出問題,至少比
<d></d>標籤穩。」— u/networking_noob
實用做法是:先用 <d>,因為它是模型受訓時的標準路徑;但如果出現台詞亂碼或多生出不該有的語音,直接用引號重試同一句話,不必把整份提示詞全部重寫。
non_diegetic_music: N/A 單獨就有控制力。 u/Nextil 回報,即使忽略大部分結構,只要寫上它,仍能阻止配樂出現。如果你只願意做一件結構化的事,就做這件事:不必要的配樂是引用案例裡持續出現的抱怨。
參考素材越多,文字反而該越少。 當圖片已承擔角色身分、影片已提供動作節奏,提示詞的任務就只剩素材路由與新動作。@aimikoda 最常被分享的範本中,有一則超過 1,300 個收藏,正是採用這種極簡策略;@CharaspowerAI 也展示了 MiniMax 自家的 Design agent,如何把一句「act as an expert FPV director and turn this into something viral」自動擴展為完整結構化提示詞。參考素材路由區塊可以像這樣:
@Image 1 是角色參考:保留臉部、黑色短髮與紅色絲質外套。
@Video 1 提供拔劍動作的節奏。
@Audio 1 以安靜的傳統弦樂設定氛圍。
接下來,提示詞只需描述新鏡頭。這些回報反映出的實務流程是:先鎖定靜態畫面,讓參考素材負責大部分工作,文字只花在需要改變的內容上。
失敗排查:官方手冊沒教你的修正方式
官方提示詞指引止步於語法,沒有說明生成結果壞掉時該怎麼處理。下表根據前述失敗回報整理:
| 症狀 | 可能原因 | 修正方式 |
|---|---|---|
已寫 N/A 仍出現音樂 | 一名使用者觀察到約 20% 的生成仍會漏入配樂 | 重新生成;避免在提示詞任何位置要求音樂「氛圍」 |
| 錯誤角色講出台詞 | 說話者與音訊路由衝突 | 明確把說話者 ID 綁定到畫面中可見的角色 |
| 畫面內台詞被念成畫外音 | 缺少嘴型同步關聯 | 寫明說話者在畫面中可見;若真的是旁白,加上「嘴唇保持閉合」 |
| 音訊參考被忽略 | 超過 3 段/15 秒限制,或未指派用途 | 為每段音訊指定角色;縮短參考音訊總時長 |
| 本機模型忽略中文對話 | ComfyUI 重用了 Qwen tokenizer;Shell 編碼破壞文字 | 使用 repo tokenizer(官方要求)+支援 Unicode 的提交方式+<d>[Chinese] 台词</d>(社群回報的修正方式) |
| 長單鏡頭(>15 秒)崩壞 | 超出 4–15 秒的設計範圍;物件變平、連續性漂移 | 拆成 15 秒片段,並預先規劃片段間的連續性 |
本機部署那一列尤其值得再看一次:根據 @eternityspring 的回報,「H3 不會說中文」最終追查到的是 tokenizer 重用與編碼問題,而不是提示詞本身。
結構化提示詞的成本:Token、迭代與可攜性
結構並不是免費的。官方 repo 公開了三個可重現案例的 Context-IR token 用量,參考素材數量增加時,token 成長很快:
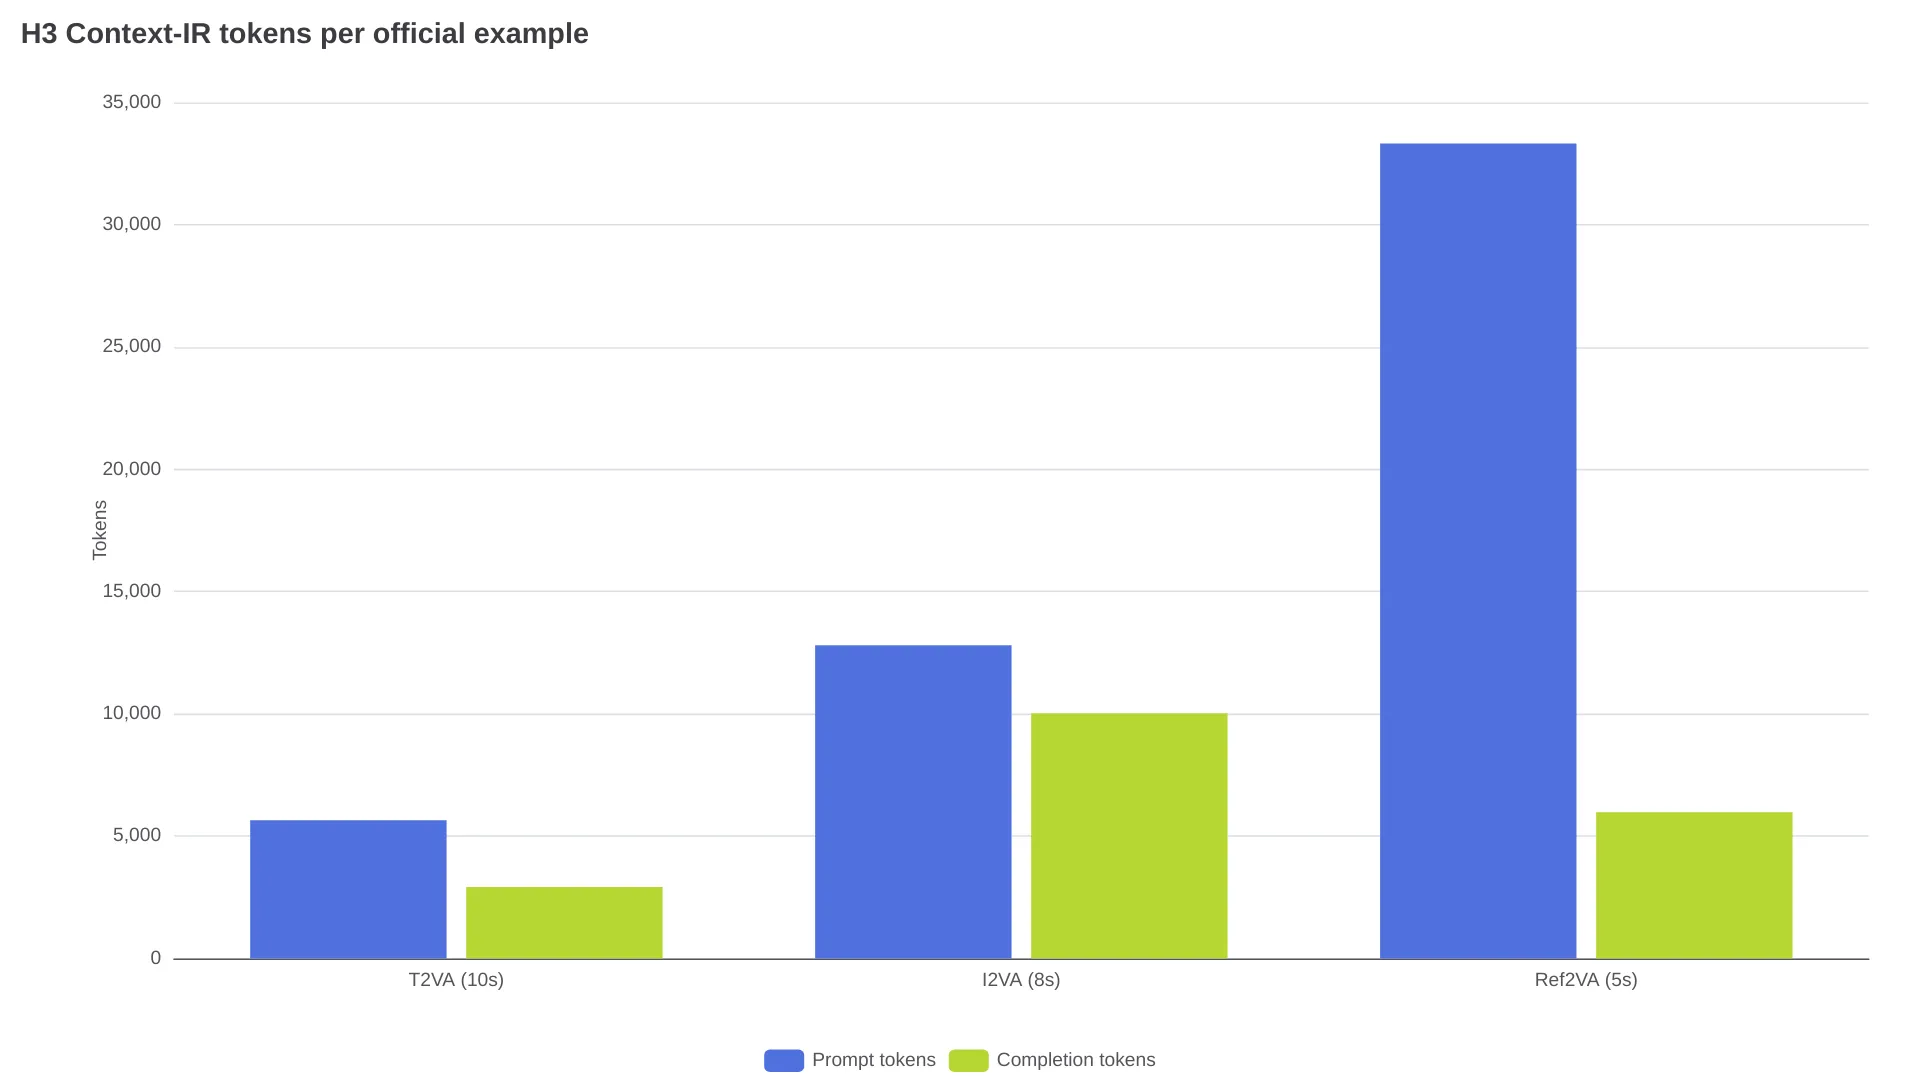
純文字生成會消耗 8,565 個前處理 token;多模態參考任務則達 39,299 個,其中提示詞端就佔了 33,323 個。本機執行時,這些 token 會增加前處理延遲;託管工作流程即使按生成秒數計費,仍會增加處理負擔。時間成本同樣不可忽視:一名 X 創作者記錄自己花了 48 小時,才把一段三人、環繞運鏡的提示詞修到成功(@LoveUolanda)。較省錢的迭代方式是先用 768p 打樣,6 秒測試約為 $0.68,提示詞定稿後才送 2K;relay 模型頁面列出的 MiniMax H3 價格為 768p 每秒 $0.1125、2K 每秒 $0.1825。
最後一項隱性成本是可攜性。H3 的欄位、說話者 ID 與標籤是一種方言,不是通用標準。一份跨模型實作指南指出,Veo 3.1 偏好帶有內嵌 SFX: 標記的普通段落;Seedance 2.0 使用六欄式描述;兩者都不接受 H3 的欄位、說話者 ID 或標籤。為 H3 建立的提示詞庫,帶到其他模型不是複製貼上,而是得重新改寫。
MiniMax H3 提示詞評測 FAQ
MiniMax H3 一定要使用結構化提示詞格式嗎?
不一定。託管 API 會透過 Context-IR,將寬鬆的自然語言需求改寫為內部表示;結構化格式最適合本機開放權重執行,以及需要精準切鏡、時間碼與說話者路由的場景。
怎麼阻止 MiniMax H3 自動加入背景音樂?
最後加上 non_diegetic_music: N/A,並且不要在提示詞其他地方要求音樂氛圍;仍可能發生漏入情況,因此重新生成是正常操作。
MiniMax H3 的提示詞應該寫多長?
MiniMax 自家的範例約為 300–700 字,純文字轉影片最多約 7,000 個字元;當參考素材已負責角色身分與動作時,提示詞應該縮短,而非越寫越長。
H3 提示詞可以直接拿去給 Seedance 或 Veo 用嗎?
不行。H3 的具名欄位、說話者 ID 與標籤都是模型專用語法;Seedance 使用六欄格式,Veo 接受普通段落,因此每個目標模型都需要各自改寫。
為什麼我的本機 H3 部署會忽略非英文對話?
通常是工具鏈問題,不是模型本身:重用 Qwen tokenizer 的設定,或會破壞 Unicode 的 Shell,都可能在生成前就讓對話失效。請使用 repo 提供的官方 tokenizer,以及 <d>[Language] 對話格式。
結論:哪些人值得學這套格式
| 你的工作需求 | 結論 |
|---|---|
| 含對話的多鏡頭影片 | 值得學完整格式;預留音訊重試次數,並準備引號寫法作為備案 |
| 產品/靜態圖片動畫(I2VA) | 學精簡版即可:對齊句+運鏡+音訊欄位 |
| 分鏡作品或角色一致性系列 | 值得;讓參考素材承擔主要工作,提示詞保持精簡且易於路由 |
| 一次性單支短片、休閒使用 | 可跳過大部分格式:普通描述+non_diegetic_music: N/A 已足夠 |
| 建立跨模型通用提示詞庫 | 不建議;各模型都有自己的方言,應為每個模型分別撰寫 |
若工作涉及多鏡頭、時間碼或參考素材驅動的內容,值得學這套格式,因為這正是它有文件佐證、也較可重現的強項。若只是一次性短片,則不必過度結構化;面對大量對話的音訊,也應預期會需要重試,而不是期待百分之百服從。
社群對這筆取捨本身也意見兩極:同一個月裡,既有人花 48 小時死磕一段鏡頭提示詞,也出現一篇獲得 880 個讚的貼文,其中一名留言者說「讀手冊居然讓人很興奮」。在模型對音訊欄位的遵循度追上鏡頭控制之前,最可行的策略是:讓代理先起草結構,自己確認音訊欄位,再以成本較低的 768p 測試,確定後才投入 2K。