 AIREITER
GLM-5.3 於 2026 年 8 月 14 日推出。Z.ai 宣稱,它相較 GLM-5.2 的程式能力提升了 50%,並新增資安能力,在 CyberGym 取得 84.5%。另一方面,DeepSeek V4 Pro 已提供完整 API 存取、採 MIT 授權的開放權重,模型卡上的 SWE-Bench Verified 成績為 80.6%,NIST 的獨立測量結果則為 81%。真正拉開差距的,是 GLM-5.3 至今尚無公開 API;目前只能透過 Z.ai 的代管產品 ZCode 與 GLM Coding Plan 使用。這一點,足以改變整場比較的結論。
關鍵不是模型 API,而是使用模式
DeepSeek V4 Pro 推出時即在 Hugging Face 釋出 MIT 授權的開放權重,也在 api-docs.deepseek.com 提供完整 API 文件,並可透過 SiliconFlow 等第三方服務代管。你現在就能自行部署、接入任何相容 OpenAI 的用戶端,或直接從 Claude Code、Cline 與自家腳本呼叫。
GLM-5.3 則走完全不同的路線。Z.ai 在發布公告中表示,模型已可透過 GLM Coding Plan 與 ZCode(Z.ai 自家的程式 IDE)立即使用;至於 API 與開放權重,則要等到完成「嚴格的安全評估」後才會釋出。換句話說,目前沒有 model: glm-5.3 端點、沒有 Hugging Face 下載,也沒有第三方推論服務。Z.ai 尚未公布時程。
程式基準怎麼看:廠商宣稱與可驗證成績
GLM-5.3 與 DeepSeek V4 Pro 都是主打 agentic coding 的大型中國 MoE 模型,但兩者目前的證據成熟度並不相同。
依 Z.ai 的發布資料,GLM-5.3 是以 743B 基礎模型進行後訓練而成的版本,透過後訓練而非全新架構,達到「頂尖的程式與 agentic 能力」。中文公告提供了更具體的說法:程式表現較 GLM-5.2 約提升 50%、在 Terminal-Bench 3.0 的開放模型中排名第一,以及白箱程式碼審查能力可與 Mythos 5 並列。作為參考,根據 Z.ai 的版本說明,GLM-5.2 在 Terminal-Bench 2.1 獲得 81.0,當時是開放權重模型中的最高分,但仍落後 Claude Opus 4.8 的 85.0。
DeepSeek V4 Pro 的數字則有獨立驗證支持。其 Hugging Face 模型卡列出 80.6% SWE-Bench Verified 與 76.8 HumanEval Pass@1;NIST 的 CAISI 評估也獨立測得 81% 的 SWE-Bench Verified 成績。架構方面,它是總參數 1.6T、活躍參數 49B 的 MoE 模型,支援 1M token 上下文與最高 384K token 輸出。
| 項目 | GLM-5.3 | DeepSeek V4 Pro |
|---|---|---|
| 架構 | 743B 基礎模型,經後訓練 | 1.6T 總參數 / 49B 活躍參數 MoE |
| 上下文長度 | 未公布(GLM-5.2:1M) | 1M tokens |
| 最高輸出長度 | 未公布(GLM-5.2:128K) | 384K tokens |
| 程式基準 | Terminal-Bench 3.0 開放模型第一(廠商宣稱) | 80.6% SWE-Bench Verified(模型卡 + NIST) |
| 資安能力 | CyberGym 84.5%;白箱審查能力可與 Mythos 5 並列 | 沒有相對應的定位 |
| 開放權重 | 承諾於安全評估後釋出 | MIT 授權,現已提供 |
| API | 尚未提供 | 已提供(官方 + SiliconFlow) |
Terminal-Bench 與 SWE-Bench 衡量的是不同能力。Terminal-Bench 評估 agent 執行終端機任務的表現;SWE-Bench Verified 評估自動產生 pull request 修補程式的能力。因此,不能把 Terminal-Bench 3.0 的排名直接與 SWE-Bench Verified 百分比相互比較。
GLM-5.3 也帶來 DeepSeek V4 Pro 未著墨的資安面向。Z.ai 將它定位為「可用於網路防禦」,並公布 CyberGym 成績為 84.5%。這些數據都由廠商自行報告,尚未經獨立驗證,較適合視為方向性訊號,而非定論。Z.ai 也表示,GLM-5.3 比 GLM-5.2 能以「更少的輸出 token 取得更好的結果」;若後續獨立測試證實這項效率,單一任務成本有機會下降。
訂閱制還是按 token 計費:成本該怎麼算
DeepSeek V4 Pro 的官方 API 按每百萬 token 計費:
| Token 類型 | DeepSeek 官方 API |
|---|---|
| 未快取輸入 | $0.435 / M tokens |
| 快取輸入 | $0.003625 / M tokens |
| 輸出 | $0.87 / M tokens |
GLM-5.3 目前僅能透過 GLM Coding Plan 訂閱使用:
| 方案 | 月費 | 額度 |
|---|---|---|
| Lite | $18 | 10,000 credits/week |
| Pro | $80 | Lite 用量的 6× |
| Max | $168 | Lite 用量的 14× |
GLM Coding Plan 沒有說明一個「credit」對應多少 token,因此無法精準直接比較成本。DeepSeek 依 token 用量計費,幾乎沒有最低承諾;GLM Coding Plan 則是無論實際用量多少,都收取固定月費。
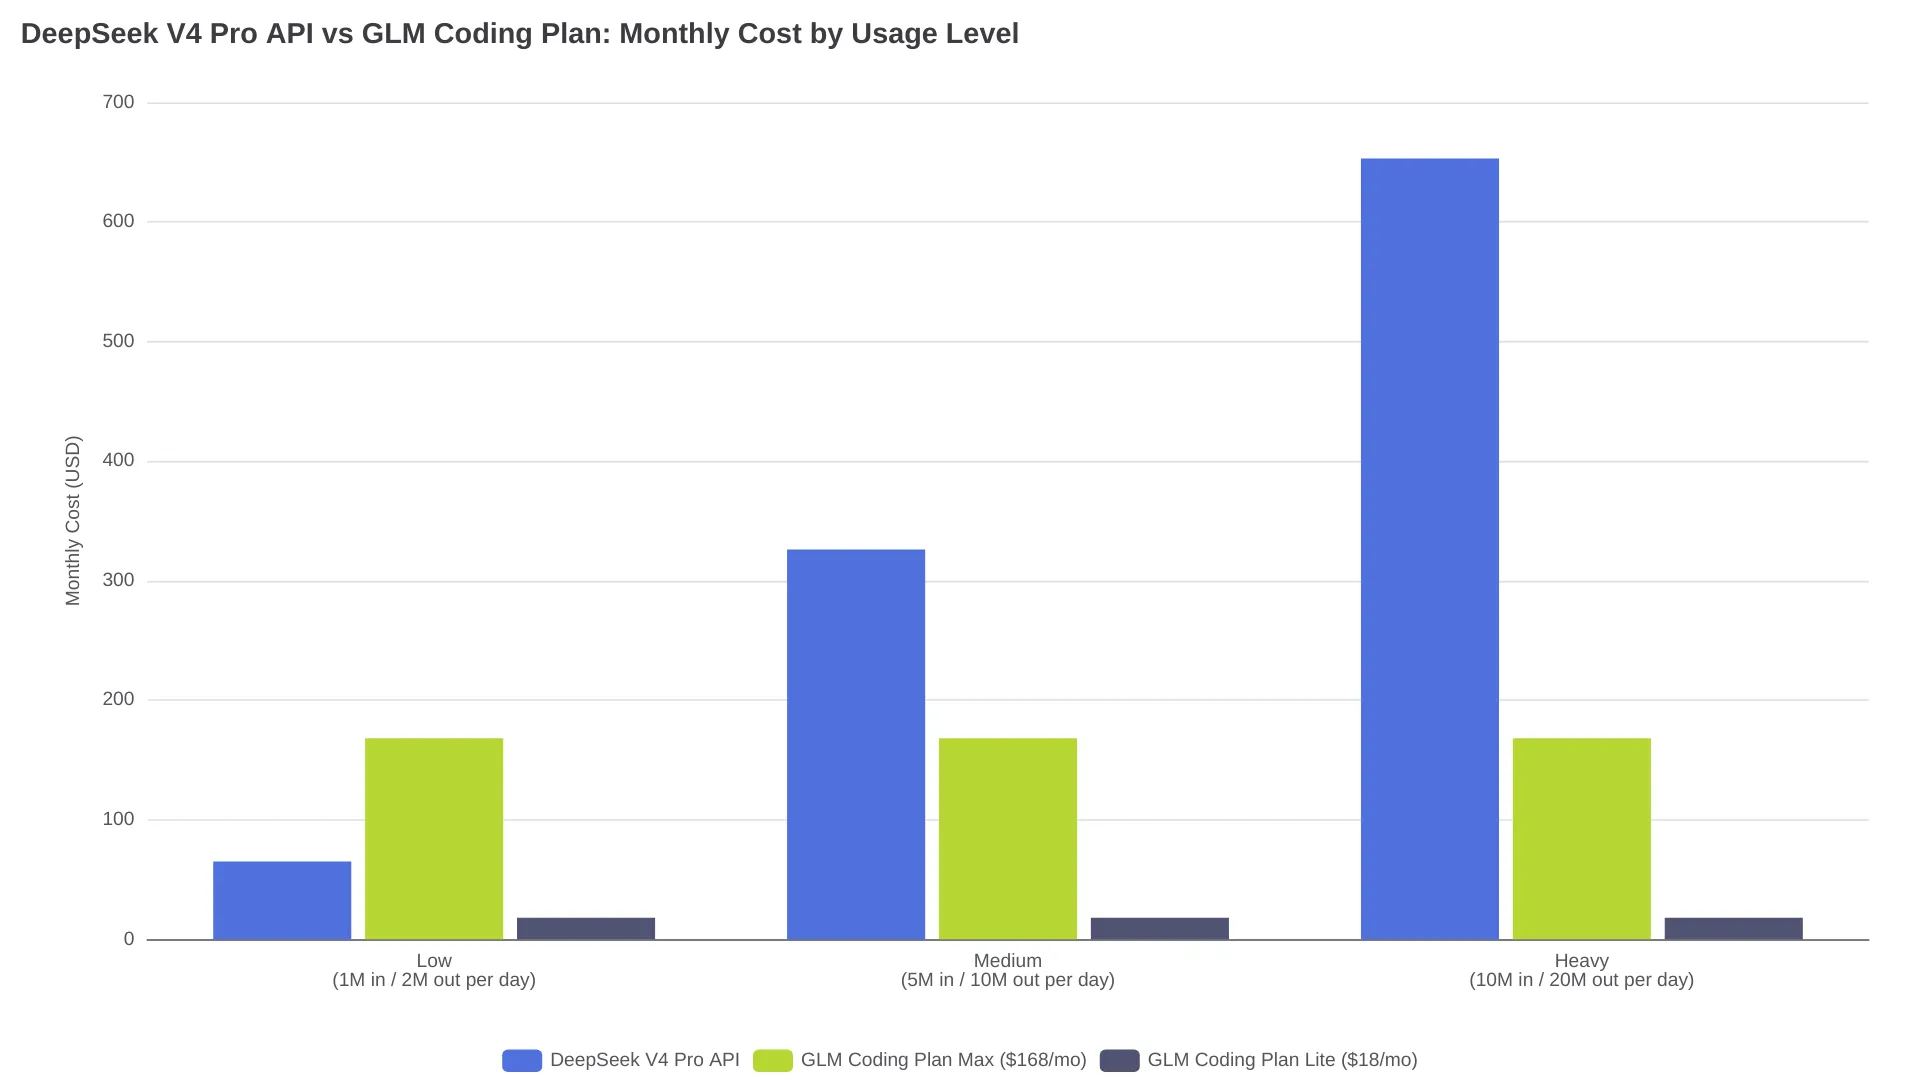
以 DeepSeek 為例:若每天使用 1M 未快取輸入加上 2M 輸出 token,相當於中等程度的程式工作階段,API 每月約為 $65。若擴大到每天 5M 輸入加上 10M 輸出,帳單將達 $326/月。對重複使用的程式碼庫,$0.003625/M 的快取輸入可大幅降低成本。GLM 方面,$168/月的 Max 方案能避免按量計費的不確定性;不過它能否涵蓋同等工作量,仍取決於未公開的 credit-to-token 換算方式。
Reddit 開發者實際使用後怎麼說
在近期一篇 r/ZaiGLM 討論串中,一名同時使用過兩個模型的用戶表示:
「這項任務比 GLM 更快完成,但需要明顯更多的手把手引導。」
同一串討論也有人採取多模型工作流:用 GLM 撰寫程式與瀏覽儲存庫,再用 DeepSeek V4 Flash 做程式碼審查。另有用戶指出,DeepSeek V4 Pro 當時僅推出約 24 小時,提醒大家不宜太早下結論。這些都是單一社群討論串中的個人經驗,並非受控基準測試。
依你的使用情境選模型
| 你的需求 | 建議 |
|---|---|
| 今天就需要 API 或 CI/CD 整合 | DeepSeek V4 Pro — GLM-5.3 尚無公開 API |
| 想自行部署以符合資料落地需求 | DeepSeek V4 Pro — MIT 權重已在 Hugging Face 提供 |
| 主要在 IDE 寫程式,想用代管式助理 | 透過 GLM Coding Plan 或 ZCode 使用 GLM-5.3 |
| 預算有限的個人開發者 | 低用量下,DeepSeek V4 Pro 的單 token 成本較低;GLM Lite($18/月)則可將支出固定 |
| 安全稽核或漏洞研究 | 先測試 GLM-5.3 — CyberGym 84.5% 是獨特優勢,但尚未獲獨立驗證 |
| 長時間、大規模的 agentic coding | GLM Coding Plan Max($168/月固定)可控制成本;但需確認 credit 額度足以涵蓋你的工作量 |
| 既有程式碼很少的全新原型 | 兩者皆可 — 都能處理從零開始的程式碼,依你偏好的存取模式選擇即可 |
如果你已經在使用 GLM-5.2 Coding Plan,在同一訂閱內升級至 GLM-5.3 是阻力最小的做法。若你需要 DeepSeek V4 Pro 的 API,可參考我們的 DeepSeek V4 Pro GA API guide,了解端點設定與價格最佳化方式。若想把前一代 GLM 一併納入比較,則可閱讀 GLM-5.2 vs DeepSeek V4 Pro 分析。
常見問題
GLM-5.3 會有公開 API 嗎?
會。Z.ai 表示,API 存取與開放權重將在完成安全評估後分階段釋出,但尚未提供具體日期。
兩個模型都能自行部署嗎?
DeepSeek V4 Pro 可以。採 MIT 授權的權重已上架 Hugging Face。這個 1.6T 參數 MoE 模型以未量化 FP16 執行時,約需 3.2TB VRAM;4-bit 量化後則約需 800GB,意味著需要由 H100 或 H200 組成的多 GPU 叢集。GLM-5.3 目前還不行。其開放權重承諾會在安全評估後釋出,授權條款尚未公布。
每天大量寫程式時,哪個比較便宜?
取決於用量。每天使用 1M 輸入加 2M 輸出 token 時,DeepSeek V4 Pro 每月約 $65;每天增至 5M 輸入加 10M 輸出時,則會達到 $326/月。在這個較高用量下,GLM Coding Plan Max 的 $168/月較便宜,但前提是其未公開的 credit 額度足以涵蓋你的工作量。正式投入前,建議以真實用量測試兩者。
GLM-5.3 支援視覺或圖片輸入嗎?
不支援。Z.ai 將視覺能力放在另一條 GLM-V 模型產品線中,包括 GLM-5V-Turbo、GLM-4.6V 與 GLM-OCR。GLM-5.3 是文字與程式碼模型;DeepSeek V4 Pro 同樣僅支援文字。
現在比的其實是時機,而非能力
從紙面規格來看,GLM-5.3 顯得更強:程式能力提升 50%、具備獨特的資安定位,且 token 效率更好。但這些數字全都來自發布僅數小時的廠商公告,目前尚無 API、沒有開放權重,也還沒有獨立基準驗證。DeepSeek V4 Pro 則提供了 GLM-5.3 現階段無法比擬的條件:可立即使用、已驗證的基準成績,以及可部署的權重。若你現在就需要 API 或自行部署,請使用 DeepSeek;至於 GLM-5.3,則可持續關注其 API 發布,屆時再以自己的程式碼庫進行正面對決測試。