 AIREITER
Gemini 3.6 Flash 推出僅三週後,Google 就發布了 Gemini 3.7 Flash。這次不是小幅調校:衡量長週期軟體工程能力的 DeepSWE v1.1,成績從 48.6% 跳升至 65.3%。更關鍵的是,兩者在 2026 年 12 月前都採每百萬 token 輸入 $0.75、輸出 $3.75 的優惠價格,單看 token 成本,升級沒有額外代價。不過,實際效益仍取決於你的工作負載。
18 項基準測試一次看:Gemini 3.7 Flash 對上 3.6 Flash
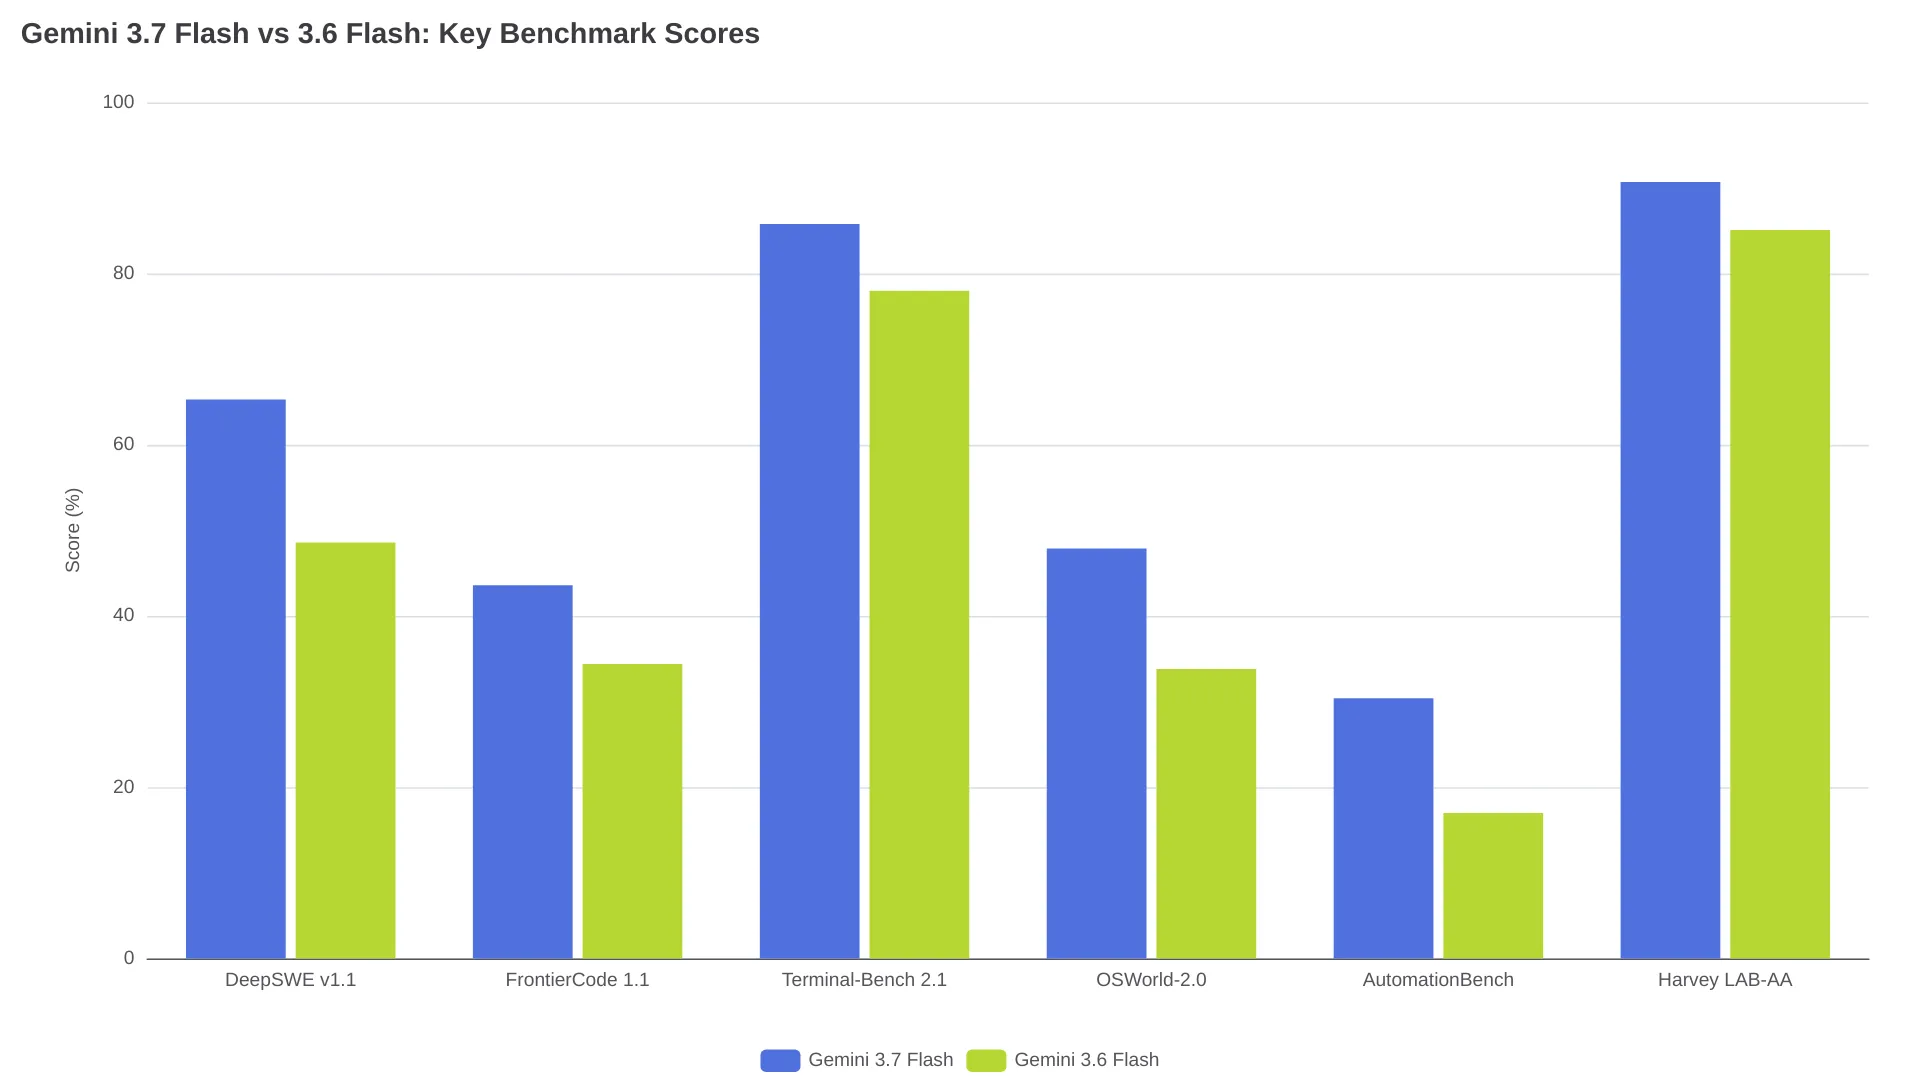
從 Google DeepMind 的官方模型頁面來看,Gemini 3.7 Flash 幾乎全面領先,尤其程式代理與企業自動化相關測試的差距最明顯。以下列出 Google 同時公布給兩款模型的全部 18 項指標;Claude Sonnet 5 與 GPT-5.6 Terra 的成績則作為比較參考。
| 基準測試 | Gemini 3.7 Flash | Gemini 3.6 Flash | 差異 |
|---|---|---|---|
| Artificial Analysis Intelligence Index(綜合指數) | 56 | 52 | +4 |
| FrontierCode 1.1(生產品質程式碼) | 43.6% | 34.4% | +9.2 |
| DeepSWE v1.1(長週期軟體工程) | 65.3% | 48.6% | +16.7 |
| Code Arena(網頁開發 Elo) | 1588 | 1538 | +50 |
| Terminal-Bench 2.1(代理式終端機程式開發) | 85.8% | 78.0% | +7.8 |
| Terminal-Bench 3.0(通用代理能力) | 14.9% | 5.4% | +9.5 |
| AutomationBench(企業工作流程自動化) | 30.4% | 17.0% | +13.4 |
| GDPVal-AA v2(知識工作 Elo) | 1525 | 1422 | +103 |
| Harvey LAB-AA(複雜法律工作流程) | 90.7% | 85.1% | +5.6 |
| GDP.pdf(專業 PDF 理解) | 34.0% | 22.0% | +12.0 |
| CharXiv,不使用工具(圖表推理) | 84.5% | 85.2% | −0.7 |
| CharXiv,使用工具 | 88.7% | 89.4% | −0.7 |
| LVBench(長影片理解) | 85.4% | 84.2% | +1.2 |
| GDM-MRCR v2,128k(長上下文檢索) | 97.0% | 91.8% | +5.2 |
| OSWorld-2.0(代理式電腦操作) | 47.9% | 33.8% | +14.1 |
| Agent's Last Exam(桌面代理任務) | 26.3% | 24.2% | +2.1 |
| HLE-Verified(跨領域專家推理) | 53.6% | 51.2% | +2.4 |
| LABBench2(生物學研究任務) | 82.1% | 76.1% | +6.0 |
以上數據皆由 Google DeepMind 在3.7 Flash 模型頁面公布。目前多數基準測試尚未有獨立重現結果,因此較適合將這些差距視為方向性參考,不能保證會完全反映在你的實際工作負載上。
程式開發與代理任務,3.7 Flash 拉開最大差距
兩款模型最顯著的差距集中在程式與代理型任務。DeepSWE v1.1 用真實程式碼儲存庫任務評估長週期軟體工程能力,Gemini 3.7 Flash 從 48.6% 大增 16.7 個百分點至 65.3%。依同一份DeepMind 基準測試表,這個分數已超越 Claude Sonnet 5 的 53.8%,介於它與 GPT-5.6 Terra 的 69.6% 之間。
其他偏向代理能力的測試,也出現相近趨勢:
- Terminal-Bench 3.0(多工具代理能力):5.4% → 14.9%,接近三倍
- AutomationBench(企業工作流程自動化):17.0% → 30.4%
- FrontierCode 1.1(生產品質程式碼):提升 9.2 個百分點
- OSWorld-2.0(代理式電腦操作):33.8% → 47.9%
Reddit 上的早期使用者討論,也點出了基準測試表現與開發者日常體驗之間可能存在的落差:
實作能力有效,但在規劃、程式碼審查,以及拆解困難問題方面可能較弱。
— r/google_antigravity 使用者討論
Google 在DeepMind 模型頁面公布的客戶案例,也支持這個方向。Browser Use 表示:「Gemini 3.7 Flash agent 比 3.6 Flash 便宜 35%,觀察到的 prompt-cache 命中率提高了 +8%,工具錯誤也更少。」Harvey 在 Legal Agent Bench 測得全數通過率提升 2.6 個百分點。Nunu.ai 則發現,它以「約一半成本」提供與 GPT-5.6-Terra 相當的表現。三者都將節省歸因於代理迴圈步驟變少,而非 token 單價折扣。
知識工作與多模態任務也有進步,但幅度較小
離開程式領域後,提升幅度較為收斂。根據DeepMind 比較表,Artificial Analysis Intelligence Index 從 52 升至 56,使 3.7 Flash 落在 Claude Sonnet 5 的 55 與 GPT-5.6 Terra 的 57 之間。非程式類最亮眼的進步是文件理解:GDP.pdf 從 22.0% 提升至 34.0%,增加 12 個百分點,對需要處理複雜文件、財報或法律申報文件的流程特別有意義。衡量 128K token 長上下文檢索的 GDM-MRCR v2,也從 91.8% 提升至 97.0%。
評估複雜法律工作流程的 Harvey LAB-AA,成績由 85.1% 升至 90.7%。長影片理解的 LVBench 與生物研究任務的 LABBench2,則都提高約 6 個百分點。這些進步對特定專業工作負載很有價值,但單憑這些項目,未必足以成為升級的決定性理由。
價格沒有差別:兩款模型都適用優惠費率
| 模型 | 輸入($/1M tokens) | 輸出($/1M tokens) | 標準費率(自 2027 年 1 月 1 日起) |
|---|---|---|---|
| Gemini 3.7 Flash | $0.75\* | $3.75\* | $1.50 / $7.50 |
| Gemini 3.6 Flash | $0.75\* | $3.75\* | $1.50 / $7.50 |
| Claude Sonnet 5 | $2.00 | $10.00 | — |
| GPT-5.6 Terra | $2.00 | $12.00 | — |
\*優惠價格於 2026 年 12 月 31 日到期。所有價格均來自DeepMind 模型頁面。
Google 在 2026 年 8 月 13 日推出 3.7 Flash 時,將 $0.75/$3.75 的促銷價格同時套用至兩款 Flash 模型。在此之前,3.6 Flash 採用 $1.50/$7.50 的標準費率。除非 Google 延長促銷,兩款模型都會在 2027 年 1 月 1 日起回復 $1.50/$7.50。既然每 token 價格一致,真正的成本差異來自任務效率:Browser Use 所述的 35% 代理成本降低,是在相同工作負載下測得,原因是工具呼叫更少、快取命中率更高,而不是模型定價不同。
若想進一步了解 3.7 Flash API 的成本結構,包括快取、Batch API 與 grounding 費用,可參考我們的 Gemini 3.7 Flash API pricing guide。
Gemini 3.6 Flash 仍有優勢的地方
在圖表推理上,3.6 Flash 仍以極小差距領先。CharXiv 不使用工具時,3.6 的成績是 85.2%,略高於 3.7 的 84.5%;開啟工具後,差距同樣是 0.7 個百分點:89.4% 對 88.7%。不到 1 個百分點的幅度很小,兩款模型在個別圖表任務上都可能有相近表現。在決定預設模型前,建議以自己的圖表工作負載驗證。
Google 的比較表中,沒有其他項目顯示 3.6 領先 3.7。若排除圖表推理,最接近的競爭區域是 intelligence index 的 52 對 56,但仍是 3.7 領先。
遷移不只換模型名稱:還要確認 API 行為
從技術操作來看,遷移只需把模型 ID 從 gemini-3.6-flash 改成 gemini-3.7-flash。根據DeepMind 模型頁面,兩者共用相同的上下文視窗(1M 輸入、64K 輸出)、相同輸入模態(文字、圖片、影片、音訊、PDF),以及相同工具使用能力(function calling、search grounding、computer use)。模型頁面將 3.7 Flash 標示為正式推出(general availability)。
不過有一項風險不能忽略:從 3.5 升至 3.6 時,曾出現讓開發者措手不及的隱性 API 行為變更。根據獨立測試的記錄,temperature、top_p 與 top_k 會被靜默忽略,thinking_budget 改成字串列舉型別的 thinking_level,而 response prefilling 也被移除。Google 尚未說明 3.7 Flash 是否帶來類似變更。在有正式文件之前,建議先讓兩個模型字串都跑過你的評估套件,再遷移正式流量,並保留 3.6 作為備援。
該不該改用 Gemini 3.7 Flash?依工作負載判斷
建議可依任務類型拆開判斷:
- 執行程式代理,現在就切換。 DeepSWE v1.1 增加 16.7 個百分點,Terminal-Bench 3.0 更接近三倍。在每 token 價格相同的前提下,程式代理工作負載沒有財務理由繼續停在 3.6。
- 處理複雜文件,現在就切換。 GDP.pdf 文件理解提升 12 個百分點(22.0% → 34.0%),128K token 的長上下文檢索更達到接近滿分的 97.0%。
- 以圖表推理為主,先測試再決定。 CharXiv 的成績讓 3.6 以不到 1 個百分點領先。承諾全面切換前,先進行並排評估。
- 流程已驗證且穩定,可暫留在 3.6。 DeepMind 模型頁面沒有列出 3.6 Flash 的退役日期。若工作流程已通過回歸測試、也沒有迫切需要程式能力提升,排查行為差異的成本可能高於收益。建議一次只遷移一個工作流程。
- 把發布節奏納入考量。 Google 在 3.6 後三週就推出 3.7。現在先遷移能明顯受益於 3.7 的工作流程,並固定保留 3.6 作為備援;將每次 Flash 發布視為值得評估的漸進式更新,而不是平台級的全面轉換。
你可以透過 Gemini 3.7 Flash 與 Gemini 3.6 Flash 聊天介面,並排比較兩款模型。
Gemini 3.7 Flash 是新架構,還是後訓練更新?
Google 尚未公開將 3.7 Flash 定義為新架構或後訓練修補版本。Artificial Analysis Intelligence Index 從 52 提升至 56;相對地,獨立測試已確認 3.5 與 3.6 Flash 在相同指數上皆為 50。3.7 的進步究竟反映架構變動,還是訓練資料改善,目前沒有文件說明。
Gemini 3.7 Flash 比 3.6 Flash 更貴嗎?
不會。兩款模型在 2026 年 12 月 31 日前,輸入皆為每百萬 token $0.75,輸出皆為每百萬 token $3.75。之後兩者都會調整為 $1.50/$7.50。升級帶來的節省,來自每項任務需要的工具呼叫與推理步驟更少,而非每 token 定價更低。
Gemini 3.7 Flash 可在哪些平台使用?
根據DeepMind 模型頁面,3.7 Flash 已正式推出,可透過 Gemini API、Google AI Studio、Google Antigravity、Vertex AI、Gemini Enterprise 及 Gemini App 使用。
我該等下一版 Flash,還是現在就遷移?
3.7 Flash 是已有公開基準測試與客戶採用案例的 GA 模型。若你的工作負載能受惠於程式與代理能力的提升,現在就遷移這些流程,等下一版本推出後再重新評估即可。等待的代價,是放棄當下已經可以取得的效益。