 AIREITER
Google 在 2026 年 8 月 13 日推出 Gemini 3.7 Flash,主打編碼代理與多步驟工具調用,定位為目前實力最強的 Flash 級模型。最值得注意的是 DeepSWE v1.1 拿下 65.3%,高於 3.6 Flash 的 49.0%;同時推出限時優惠價,每百萬輸入 token $0.75、每百萬輸出 token $3.75,剛好是 3.6 Flash 標準費率的一半。不過,根據報導,這個價格會在 2027 年 1 月調升至 $1.50/$7.50,因此能以低價評估的時間大約只有四個月。
Gemini 3.7 Flash API 怎麼收費?優惠價年底到期
根據 Google DeepMind 的發布公告,以及社群回報與搜尋索引資料,Gemini 3.7 Flash 的起始價格為每百萬輸入 token $0.75、每百萬輸出 token $3.75。作為比較,Gemini 3.6 Flash 的標準費率是輸入 $1.50/M、輸出 $7.50/M(AgentPedia)。3.7 Flash 的優惠費率與 3.6 Flash 的 Batch/Flex 級別相同,但可用於標準吞吐量。
社群也指出定價細則中有個關鍵條件:優惠費率只到 2026 年 12 月 31 日,之後價格會回到輸入 $1.50/M、輸出 $7.50/M。一名 Reddit 使用者提到:「顯示的定價細則讓價格在四個月後翻倍」(r/GeminiAI)。
| 定價級別 | 輸入($/M tokens) | 輸出($/M tokens) | 說明 |
|---|---|---|---|
| 3.7 Flash 優惠價(2026 年 8–12 月) | $0.75 | $3.75 | 社群回報價格;2027 年 1 月翻倍 |
| 3.7 Flash 標準價(2027 年 1 月起) | $1.50 | $7.50 | 與 3.6 Flash 標準費率相同 |
| 3.6 Flash 標準價 | $1.50 | $7.50 | 目前 GA 定價 |
| 3.6 Flash Batch/Flex | $0.75 | $3.75 | 較低吞吐量級別 |
| 3.5 Flash-Lite 標準價 | $0.30 | $2.50 | 價格最低的 Gemini Flash 級別 |
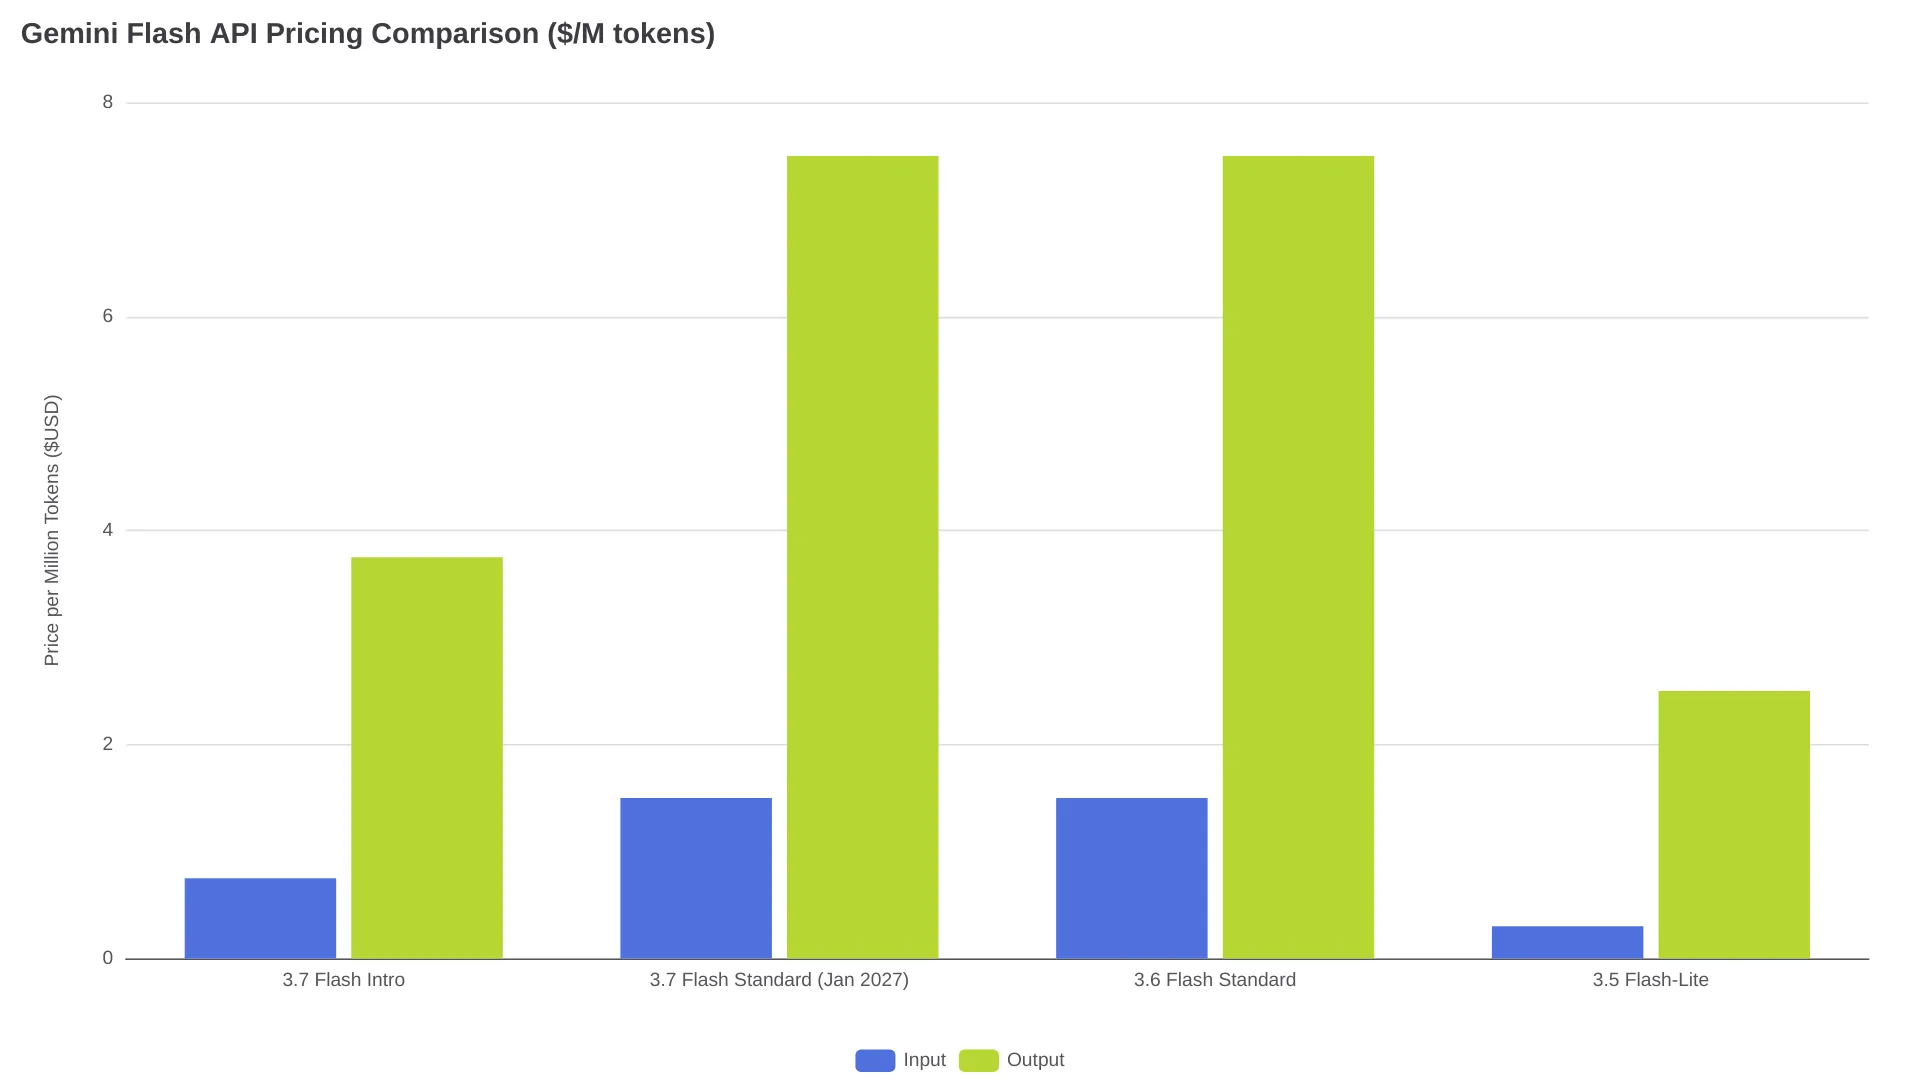
輸出價格已包含 thinking tokens。依據 AgentPedia 所列的 3.6 Flash 公開費率,標準級別的情境快取另收每百萬 token $0.15。Google Search grounding 與 Maps grounding 則有獨立費用。3.7 Flash 延續 3.6 Flash 的 100 萬 token 上下文視窗與 64K 最大輸出,因此既有 API 呼叫不會因上下文限制變動而失效。
基準測試進步有多少?
Google 公布的測試結果顯示,Gemini 3.7 Flash 的進步主要集中在軟體工程、程式撰寫與文件處理。以下數據來自 Google 的發布公告,並於 2026 年 8 月 13 日透過社群貼文流出。
| 基準測試 | Gemini 3.7 Flash | Gemini 3.6 Flash | 差距 |
|---|---|---|---|
| DeepSWE v1.1 | 65.3% | 49.0% | +16.3 個百分點 |
| FrontierCode 1.1 Main | 43.6% | 34.4% | +9.2 個百分點 |
| WebDev Arena(Elo) | 1,588 | 1,538 | +50 Elo |
| GDP.pdf 文件處理 | 34.0% | 22.0% | +12.0 個百分點 |
| AutomationBench | 30.4% | ~17% | +13 個百分點 |
| 長上下文檢索 | 97% | — | — |
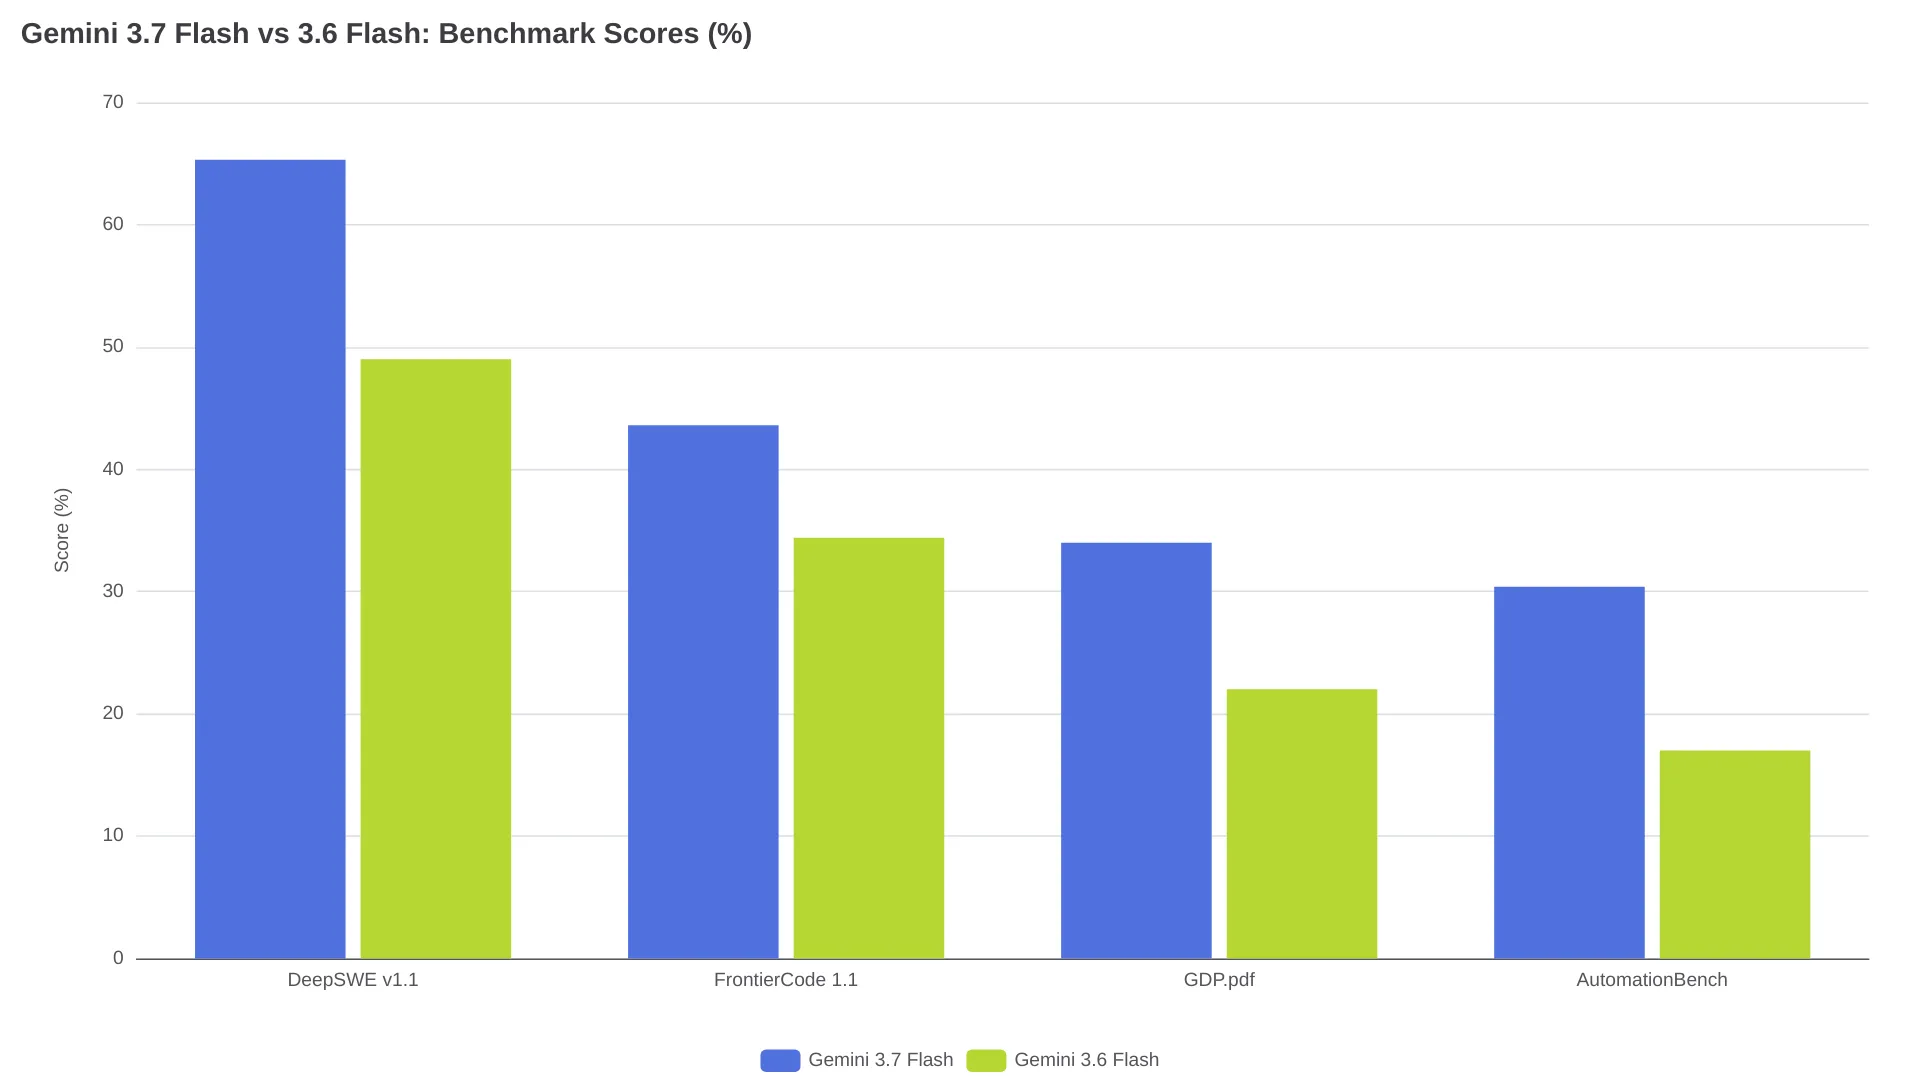
最亮眼的成績是 DeepSWE 從 49% 提升至 65.3%,相對成長 33%。DeepSWE 測試的是儲存庫層級的軟體工程能力,包括跨檔案修改、執行測試與在程式碼庫中定位內容。不過,Reddit 社群對這些數字能否反映實際生產環境仍有不同看法。有使用者寫道:「在證明不是刷榜之前,先假定它是刷榜結果」(r/GeminiAI)。也有人指出,對照中 3.6 Flash 使用了 high thinking,部分競爭模型卻使用 medium,可能拉高分數。至於 97% 的長上下文檢索成績,則確實引起不少關注,特別適合需要從大型程式碼庫找出相關程式碼的工作流程。
與其他程式模型相比,成本划算嗎?
Reddit 的早期使用者很快就拿 3.7 Flash 的性價比與更便宜的替代方案比較。結論並不單一:3.7 Flash 的分數表現不錯,但若以單一任務成本計算,它明顯比平價編碼模型更貴。
一名基準測試討論串的留言者依 Artificial Analysis 的單任務成本估算,認為 Gemini 3.7 Flash 的成本大約是 GPT-5.6 Luna 的 8 倍,儘管 Luna 的基準分數幾乎相同。另一名使用者表示,Gemini 3.7 Flash 先前的價格約為 DeepSeek V4 Flash 的 13 倍,但 DeepSeek 後來已調漲價格。同一名留言者直言,對於「幾乎相同」的結果,Gemini 3.7 Flash 相比 Luna 的成本「多出超過 300%」(r/GeminiAI)。
另一派看法則是,據稱 Luna 的幻覺問題較多,而 DeepSeek V4 Flash 的推理「常會犯很多錯」;但這些都只是軼事性經驗。
3.7 Flash 最受好評的部分是速度。使用者回報,多數回應可在 3 到 6 秒內完成;觀察到最久的一次回應是創意寫作測試,耗時約一分鐘。多位留言者形容它「快得驚人」。
規格、可用平台與 API 存取方式
依據社群討論與 3.6 Flash 文件中的規格,Gemini 3.7 Flash 維持與 3.6 Flash 相同的上下文限制與功能組合。
| 規格 | 數值 |
|---|---|
| 上下文視窗 | 1,048,576 tokens(1M) |
| 最大輸出 | 65,536 tokens(64K) |
| Thinking 等級 | Low、Medium、High |
| 模態 | 文字、圖片、影片、音訊、PDF(輸入);文字(輸出) |
| 知識截止日期 | 2026 年 3 月(3.6 Flash;3.7 Flash 截止日期尚未確認) |
| 快取輸入定價 | $0.15/M tokens(標準級別,依 3.6 Flash 推定) |
可從哪些平台使用:
- Gemini API / Google AI Studio — 開發者存取
- Gemini app — 面向消費者逐步推出
- Gemini Spark — Google AI Pro 與 Google AI Ultra 訂閱者可用
- Vertex AI — 預期將依循 3.6 Flash 的供應模式
依照 Google 從 3.6 Flash 延續的命名慣例,預期的 API 模型 ID 是 gemini-3.7-flash。部署前請先在 Google AI for Developers documentation 確認精確字串,並固定使用該 ID,而非依賴 gemini-flash-latest 這類別名。
該從 3.6 Flash 遷移嗎?
答案取決於你的工作負載類型,以及你對 2027 年 1 月價格調漲的敏感度。
適合遷移的情況:應用程式會運行編碼代理、多步驟工具調用鏈,或處理大量文件。DeepSWE 從 49% 跳升到 65.3%,幅度足以影響有多少代理迴圈能在首次嘗試就成功;而優惠期間價格減半,也能用較低成本完成評估。已採用 3.6 Flash 的團隊,可透過 feature flag 替換模型 ID,不必重寫任何上下文視窗假設。
適合觀望的情況:工作負載是高流量分類、路由或資料擷取,而 Flash-Lite 已能以 $0.30/$2.50 完成任務。3.7 Flash 的優惠輸入價格仍是 Flash-Lite 的 2.5 倍,到了 2027 年 1 月翻倍後,差距還會更大。
預算請把調價納入規劃。從 2027 年 1 月起,應以 $1.50/$7.50 而非目前優惠價來估算成本。如果你的單位經濟模型只在 $0.75/$3.75 時成立,四個月後這個模型的成本會變成 2 倍。
常見問題
Gemini 3.7 Flash 的 $0.75/$3.75 價格是永久的嗎?
不是。社群回報指出,這是截至 2026 年 12 月 31 日有效的優惠價格。從 2027 年 1 月起,價格據稱會翻倍為輸入 $1.50/M、輸出 $7.50/M,與 3.6 Flash 的標準費率一致。
Gemini 3.7 Flash 已在 Vertex AI 上提供嗎?
在推出當下,Vertex AI 是否可用尚未獲得獨立確認。Gemini 3.6 Flash 在 GA 時已可透過 Vertex AI 使用,因此預期 3.7 Flash 也會跟進。請在 Google Cloud console 查看目前的模型清單。
3.7 Flash 與 Gemini 3.1 Pro 相比如何?
Reddit 使用者回報,在特定代理與編碼基準測試中,3.7 Flash 可與 Pro 級模型競爭,甚至表現更好,尤其是在代理式文件分析上。若是純粹的編碼代理迴圈,搭配優惠價格時 3.7 Flash 有較佳性價比;但面對複雜推理與規劃,Pro 仍是更強的選擇。
thinking tokens 會另外計費嗎?
不會。thinking tokens 會按標準輸出費率計為輸出 token,在優惠期間為 $3.75/M。使用 high thinking 會按比例提高輸出成本,因此對於不需要額外推理的大量工作負載,建議使用 medium 或 low。