 AIREITER
12 月 2 日繼續呼叫 gemini-2.5-pro,請求不會直接失敗,只是回答你的會變成另一個模型。Google 已於 2026 年 11 月 2 日淘汰 gemini-2.5-pro 與 gemini-2.5-flash;從 2026 年 12 月 1 日起,Gemini Developer API 會將這兩個 ID 自動轉向 gemini-3.8-flash 與 gemini-3.5-flash-lite,並按照替代模型的價格計費。真正需要注意的是,這不只是換個模型名稱,而是連模型層級與請求參數都會變動;因此,想靠原本的字串撐到 12 月,反而是風險最高的做法。
Google 宣布 12 月 1 日將發生什麼事
Google 已在 Gemini Developer API 上淘汰 gemini-2.5-pro 與 gemini-2.5-flash。這兩個識別名稱已從 Google AI Studio 的模型選單消失,而且目前只有過去曾使用過相應模型的開發者,才能繼續透過 API 存取。到了 2026 年 12 月 1 日,請求仍會成功,但實際執行的模型與計費價格都會改變。
Google 在Gemini API 淘汰公告頁面列出的對應關係如下:
| 你呼叫的舊 ID | 2026 年 12 月 1 日起實際回應的模型 | 12 月 1 日起的計費方式 |
|---|---|---|
gemini-2.5-pro | gemini-3.8-flash | Gemini 3.8 Flash 價格 |
gemini-2.5-flash | gemini-3.5-flash-lite | Gemini 3.5 Flash-Lite 價格 |
gemini-2.5-flash-lite | 維持不變,不會自動轉向 | 維持不變 |
Google 將 2026 年 12 月 1 日列為這兩個穩定版 ID 的轉向日期,並以 2026 年 11 月 2 日的變更紀錄作為公告依據。Google DeepMind 員工 Patrick Loeber 也在 PSA 中附上相關連結,提醒使用進階整合功能的開發者需要按照遷移指南處理。
這項公告只適用於 Gemini Developer API 與 AI Studio。Vertex AI 的 Gemini 2.5 採用另一套淘汰時程,Google Cloud 為相同模型名稱列出的日期是 2026 年 10 月;Firebase AI Logic 也有自己的支援模型清單。Vertex 使用者應該查看Cloud Console,不要假設 12 月 1 日的安排適用於所有平台。
Google 曾在 9 月 18 日表示 2.5「尚未淘汰」,卻在 11 月 2 日宣布淘汰,因此應把 12 月 1 日視為確定的生效日期。這段反轉可在變更紀錄中查到。
12 月與明年 1 月,轉向後的請求要花多少錢
Gemini 2.5 Pro 的流量在 12 月會變便宜,但到了 1 月,輸入價格又會上升。Gemini 2.5 Flash 的文字流量在轉向後價格不變,音訊輸入則會大幅降價。以下數字都是 GoogleGemini API 定價頁面所列的付費方案價格,單位為每 1M tokens,資料擷取日期為 2026 年 11 月 3 日。若要了解個別模型的背景,可參考 Gemini 3.8 Flash 定價與 Gemini 3.5 Flash-Lite。
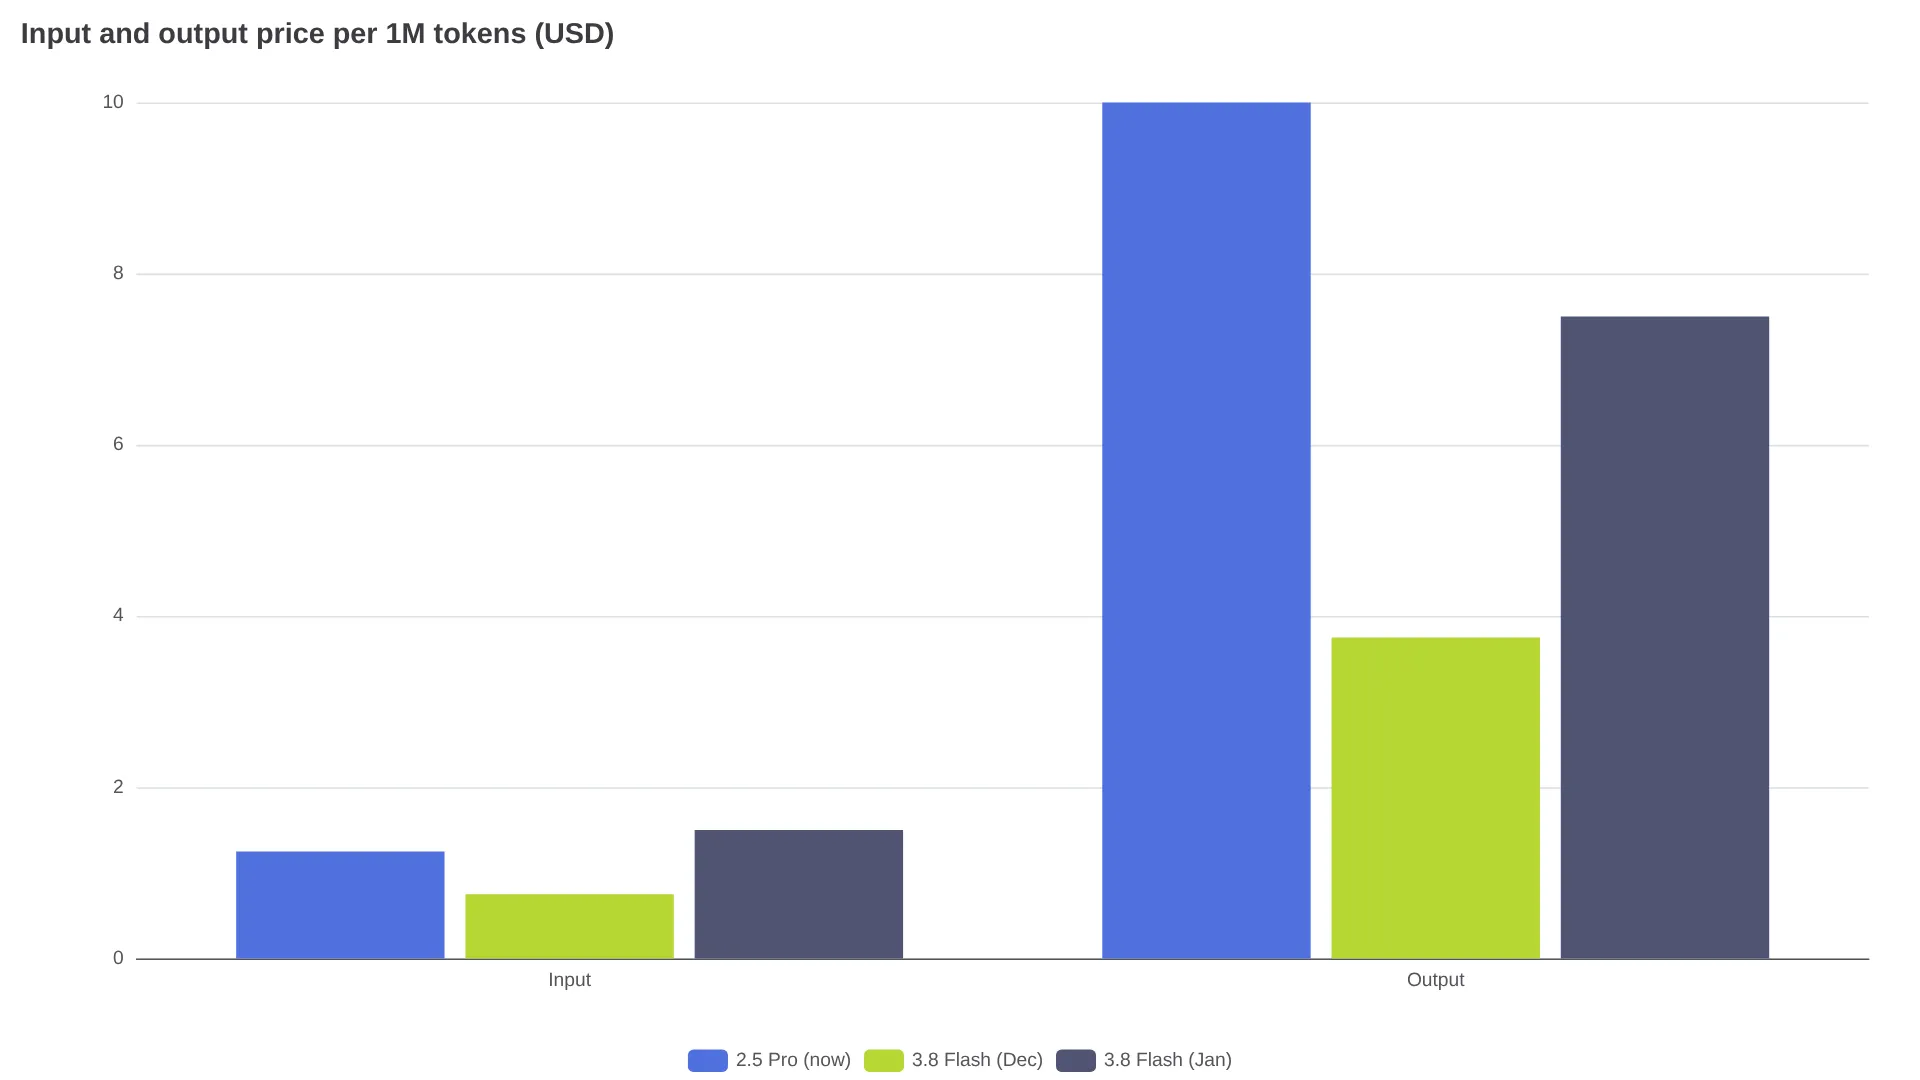
| 模型與期間 | 輸入/1M | 輸出(含思考)/1M |
|---|---|---|
gemini-2.5-pro,提示詞 ≤200k tokens,11 月 30 日以前 | $1.25 | $10.00 |
gemini-2.5-pro,提示詞 >200k tokens,11 月 30 日以前 | $2.50 | $15.00 |
gemini-3.8-flash,2026 年 12 月 1–31 日 | $0.75 | $3.75 |
gemini-3.8-flash,2027 年 1 月 1 日起 | $1.50 | $7.50 |
Gemini 3.8 Flash 不論提示詞長度,都採用單一價格級距,因此超過 200,000 tokens 的長上下文工作負載降幅最大。以 300k 輸入、4k 輸出的長文件提示詞為例,Gemini 2.5 Pro 按 $2.50/$15.00 計價時約需 $0.81;Gemini 3.8 Flash 在 12 月按 $0.75/$3.75 計價時約需 $0.24,1 月按 $1.50/$7.50 計價則約需 $0.48。只有短提示詞、輸入量較大的聊天工作負載,在 1 月的帳單才會接近原本的價格。
Flash 的轉向相對單純:
| 模型 | 文字/圖片/影片輸入 | 音訊輸入 | 輸出 |
|---|---|---|---|
gemini-2.5-flash,11 月 30 日以前 | $0.30 | $1.00 | $2.50 |
gemini-3.5-flash-lite,12 月 1 日起 | $0.30 | $0.30 | $2.50 |
上下文快取、批次處理與優先處理也遵循相同模式:文字價格延續原本的水準,音訊價格則下降。不過預算規劃還有一個細節不能忽略:思考 tokens 會按照輸出計費,而替代模型在長任務中可能產生不同數量的思考 tokens,因此不能假設輸出 token 數量會完全相同。正式鎖定預測數字前,應先比較實際流量中的 usage_metadata。
為什麼模型字串不變,程式仍可能壞掉
自動轉向會保留 HTTP 200 回應,卻把底層執行模型換掉。Gemini 3.x 對請求規則的要求比 Gemini 2.5 嚴格,因此即使程式完全沒有碰模型名稱,12 月 1 日後仍可能開始報錯,或在沒有明顯錯誤的情況下產生不同結果。
Gemini 3.x 以 thinking_level取代 thinking_budget。Gemini 3.8 Flash 支援 low、medium 與 high,但不接受 minimal;Gemini 3.5 Flash-Lite 的預設值則是 minimal。同時傳送兩個欄位會回傳 HTTP 400,而在兩個替代模型共用同一份 minimal 設定,也會讓 3.8 Flash 路徑失效。Google 建議在擷取、路由與分類任務使用 minimal;至於子代理程式、工具呼叫、程式碼執行與多步驟推理,則使用 medium 或 high,避免工具過早停止。
根據 Gemini 3 遷移指南,取樣與對話歷史控制項也有所變更。Gemini 3.x 目前會忽略 temperature、top_p 與 top_k,而未來世代預計會直接回傳 HTTP 400。candidate_count 不受支援。如果請求最後一個非空 turn 的角色是 model,也就是使用在結尾加上 Translation: 這類傳統預填技巧,請求會回傳 HTTP 400。Google 建議改用 system_instruction 與結構化輸出。
函式呼叫的規則也變得更嚴格。Gemini 3.x 會驗證 thought_signature,並要求每個 FunctionResponse 都帶有相符的呼叫 ID 與名稱。如果遺漏簽章,或重建模型 turn 時沒有保留簽章,可能得到空白的 STOP 回應或 MISSING_THOUGHT_SIGNATURE 結果,而不是清楚的錯誤訊息。回歸測試不能只確認沒有例外,也必須檢查回應文字。
公告發布後幾小時內,真實使用者就指出了完全相同的風險:
Google 剛替 Gemini 2.5 宣布了終止日期,而真正重要的不是淘汰本身,而是自動轉向。……所以你的程式不會拋出 404,而是悄悄改用另一個模型回答。— @VarunChopr17597
如果你的代理程式仍呼叫 gemini-2.5-flash,12 月 1 日起它就會改用 Gemini 3.5 Flash-Lite,而該模型的預設思考等級是 minimal。— @MarMarLabs
11 月完成遷移:7 步驟檢查清單
最穩妥的做法,是在 11 月直接更換模型 ID、同步調整參數,再與 12 月的替代模型進行並行評估。不要把自動轉向當成遷移策略。
- 找出所有引用與預覽別名。搜尋程式碼、設定檔、評估工具與文件中的兩個受影響 ID,但不要把未受影響的 Lite 模型算進來:
grep -rnE 'gemini-2\.5-(pro|flash)([^-]|$)' .
- 明確替換 ID。在分支中將
gemini-2.5-pro改為gemini-3.8-flash,將gemini-2.5-flash改為gemini-3.5-flash-lite,不要等到 12 月 1 日早上才處理。 - 修正思考設定。以
thinking_level取代thinking_budget,依模型分別設定(3.8 Flash 的代理程式使用medium或high;Flash-Lite 工作負載則明確選擇minimal、medium或high),不要讓 3.8 Flash 共用minimal。 - 移除舊參數。測試前先刪除
temperature、top_p、top_k、candidate_count,以及預填在結尾的 model turn。 - 更新 SDK 與工具串接。升級至目前版本的 SDK,保留包含
thoughtSignature在內的完整模型 turn,建立同時帶有呼叫 ID 與名稱的FunctionResponse,再從頭測試多輪工具呼叫。 - 在替代模型上重新跑基準測試。使用正式環境提示詞比較品質、延遲、輸出長度與
usage_metadata的 token 數量;Flash 模型不會在每項任務上都複製 Pro 模型的風格。 - 重新計算兩次成本。Pro 路徑的 12 月預算按 $0.75/$3.75 計算,1 月起按 $1.50/$7.50 計算;Flash 路徑則重新確認音訊與快取相關費用。
已經使用 Gemini 3.x 或 gemini-2.5-flash-lite 的團隊可以跳過這次遷移。其他團隊應在 11 月 30 日前完成第 6 步,因為 12 月 1 日測試全綠,可能只代表路由器仍能正常回應,並不代表模型行為還維持不變。
建立代理程式的團隊,也應先閱讀 Gemini 3.8 Flash 代理任務定價分析,再為大量工具呼叫的工作負載設定思考等級。
常見問題
Gemini 2.5 Pro 會在 2026 年 12 月 1 日關閉嗎?
不會。Google 將 2026 年 12 月 1 日列為 Gemini Developer API 的轉向日期:gemini-2.5-pro 請求會改送至 gemini-3.8-flash,而不是回傳錯誤。
自動轉向後,請求會按舊價格還是新價格計費?
按新價格計費。12 月 1 日後以 gemini-2.5-pro 發送的請求,會按照 Gemini 3.8 Flash 的價格計費;gemini-2.5-flash 請求則會按照 Gemini 3.5 Flash-Lite 的價格計費。
既然會自動轉向,還需要修改程式嗎?
需要。Gemini 3.x 的思考設定、取樣參數、預填 turn 與函式呼叫串接方式都不同。程式不修改,可能遇到被忽略的參數、HTTP 400,或推理行為在沒有明顯錯誤的情況下改變。
12 月 1 日的變更適用於 Vertex AI 嗎?
不適用。12 月 1 日是 Gemini Developer API 的日期。Google Cloud 為 Vertex AI 與 Enterprise Agent Platform 上的 Gemini 2.5 另行公布了 2026 年 10 月的淘汰日期。
Gemini 2.5 Flash-Lite 會受影響嗎?
不會。Google 表示 gemini-2.5-flash-lite 尚未淘汰,會繼續提供服務,直到另行通知。
不同工作負載應該選哪個替代模型?
先按任務類型匹配,再透過評估確認。不要假設 Flash 模型等同於原本的 Pro 模型。
| 目前工作負載 | 明確指定的目標 | 注意事項 |
|---|---|---|
| 一般 Pro 提示詞、程式撰寫、長文件 | gemini-3.8-flash,使用 medium+ | 這是 Pro 到 Flash 的層級變更;重新評估品質、輸出長度與 1 月輸入價格 |
| 使用工具的代理程式 | gemini-3.8-flash,使用 medium 或 high | 留意 thought_signature、回應 ID,以及使用 minimal 時過早出現 STOP |
| 分類、擷取、路由 | gemini-3.5-flash-lite,使用 minimal | 成本最划算;加入工具後若需要更深推理,再提高至 medium |
| 音訊轉錄流程 | gemini-3.5-flash-lite | 音訊輸入價格從 $1.00 降至 $0.30;重新確認快取相關費用 |
11 月 30 日前該做什麼
這週就先替換兩個模型字串,修正思考設定與工具串接,並趁 Gemini 2.5 還能正常回應時,在替代模型上建立新的基準。12 月的自動轉向能讓服務繼續運作,但只有在 11 月完成遷移,才能同時掌握行為與帳單。