 AIREITER
Tencent 的 Hyra 2.0 不是替你解完一道題就丟掉成果的聊天機器人,而是一套會持續打造可重複使用科學模型與工具的研究代理系統。不過,它的公開範圍有明確界線:代理系統本身仍在 Tencent 內部運作,目前對外公開的是部分產出。
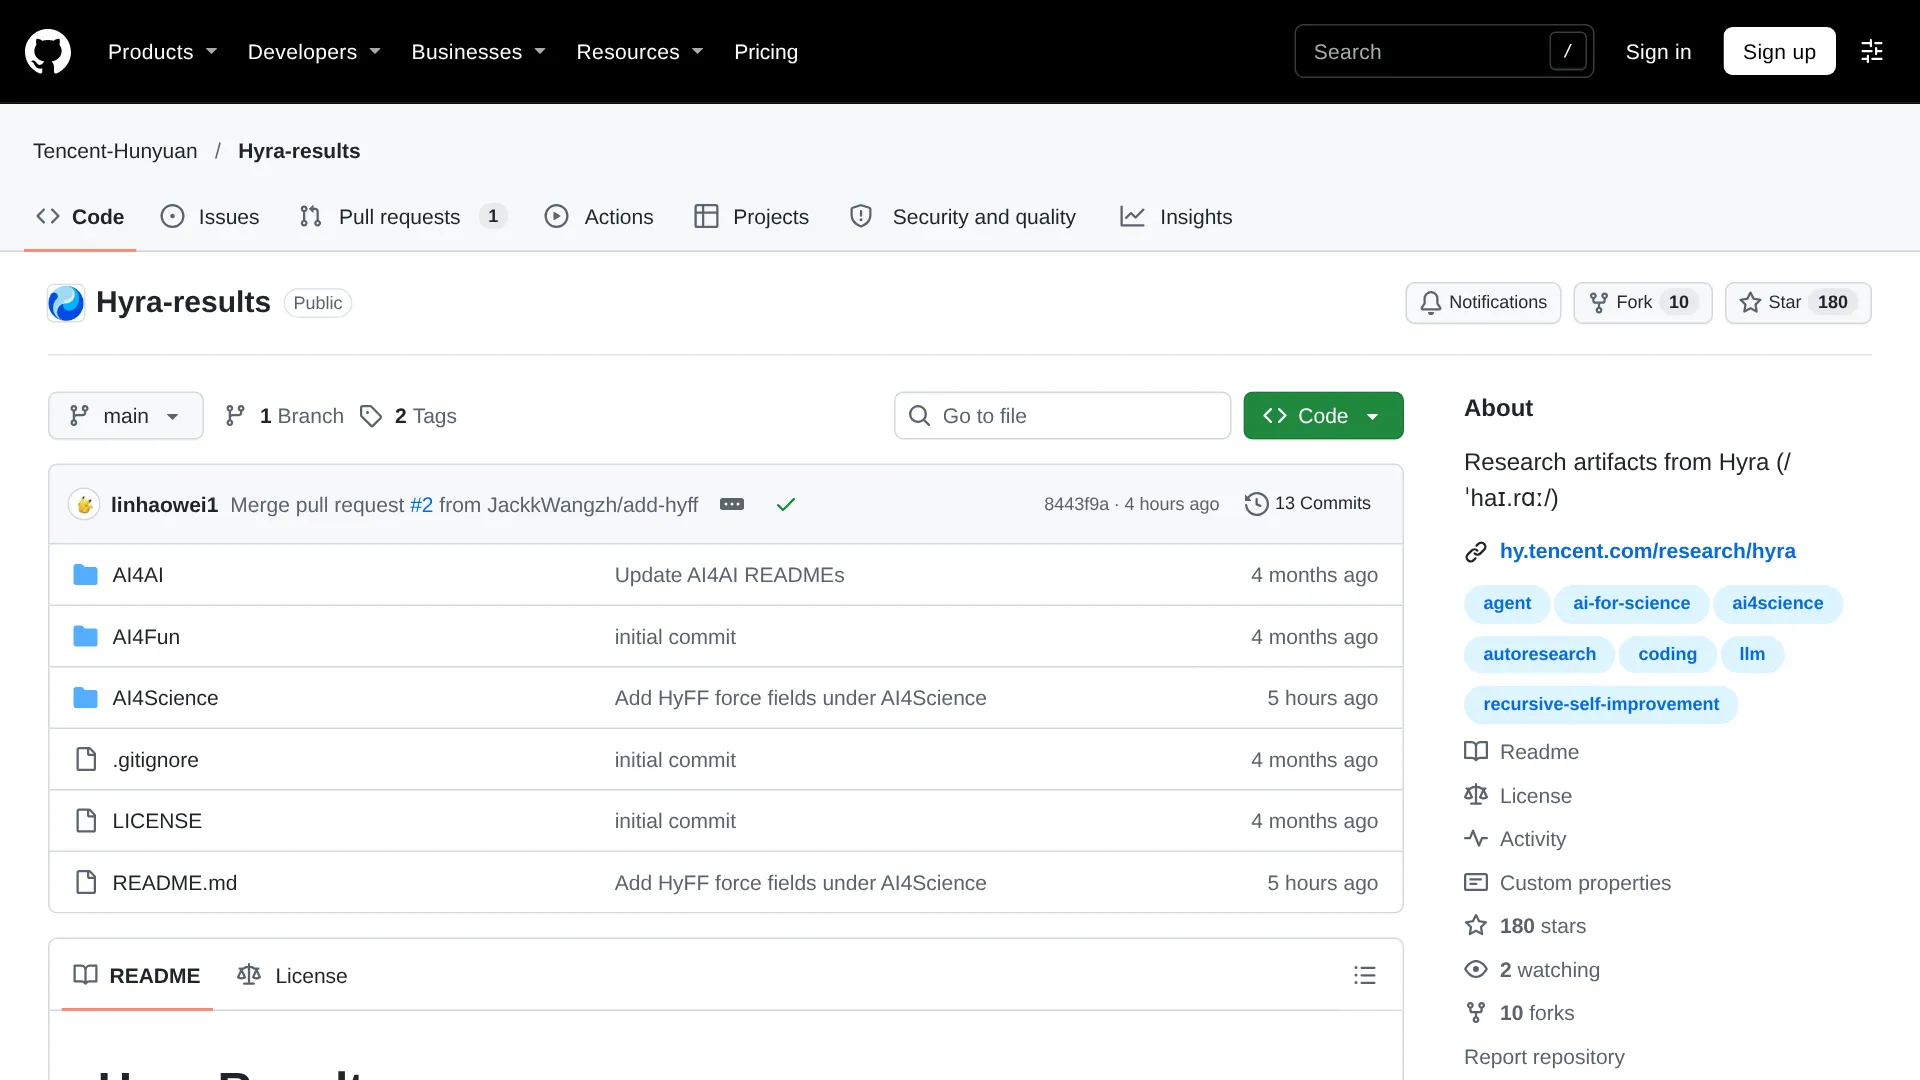
Hyra-results repository 把可下載的成果和只有發布消息、尚未提供完整驗證材料的項目分開列出。這個差異,也是理解 Hyra 2.0 時最重要的起點。
先搞懂 Hyra 2.0:它到底是什麼,又不是什麼?
Hyra 2.0 全名為 Hunyuan Research Agent 2.0,是 Tencent Hunyuan 用來自動化科學研究與工程工作的階層式系統。Tencent 將它定位成一套能開發可重複使用科學模型、驗證流程與多步驟工作流程的基礎設施,而不是另一個通用型 Hunyuan 聊天模型。
Tencent 的官方 X 公告 在 November 2, 2026 將 Hyra 2.0 稱為「the next evolution of Hunyuan Research Agent」,方向也從「solving problems」轉向「building reusable tools, models and workflows」。目前公開的 Hyra-results repository 放的是研究產出與部分訓練完成的模型,並不是完整的協調系統;公告和 repository 也都沒有列出公開 demo、安裝套件、API、價格或配額。比較準確的理解方式是:Hyra 2.0 像一座研究實驗室,而已發布的 HyInv 和 HyPLM-Flash 蛋白質模型,則是從這座實驗室產出的樣本。
Hyra 2.0 如何讓數週的研究不中斷?
Hyra 2.0 以三層代理、持久化儲存,以及獨立審查機制,來管理長時間運作的研究計畫。IT之家報導 引述 Tencent Hunyuan 官方微信帳號,說明 Overall、Mission 和 Worker 三層分工如何讓實驗持續數天甚至數週,而不會因上下文遺失而中斷。
Overall agents 負責與研究人員溝通、對齊目標並分配運算預算。Mission agents 各自負責一條研究方向,選擇實驗路線,並對最終結論負責。Worker agents 則會閱讀程式碼、執行即時實驗、分析失敗原因,也能對 Mission agent 的判斷提出質疑;多個 Worker 還可以搭配不同基礎模型並行運作。
底層則有三種持久化機制:
- Project state 記錄研究計畫目前進展,讓任務即使遭遇中斷,也能透過持久化佇列繼續執行。
- Layered agent memory 將短期觀察和較長期的研究發現分開保存,不把所有內容一股腦塞進同一個 context window。
- Shared Books 用證據等級整理知識,區分單次執行得到的觀察、經過重現的發現,以及人類確認過的慣例;如果某種方法證明能轉移到其他任務,系統就會把它提煉成小型、可重複使用的 skills,供後續研究採用。
系統還設有兩道防線。每個結論都會附上具體日誌和程式碼版本;在交給人類之前,另一個獨立的 review worker 會從全新起點重新檢查該主張。根據 Eyerys 的技術解析,大型運算工作仍需要人類核准,系統也能連接企業通訊、工作提交平台和程式碼 repository 等一般實驗室基礎設施。
但驗證並不是沒有代價。有實務工作者估計,讓 Worker 互相檢查工作階段,可能會大幅推高 token 成本(@d6355v)。Tencent 尚未公布 token 預算、運算成本、失敗率,也沒有說明獨立審查有多常抓出錯誤。因此,現階段應把這套架構視為一種面向長期可靠性的設計,而不是已經公開營運成本的成熟服務。
Hyra 2.0 目前究竟發布了哪些成果?
Hyra 2.0 的公開證據大致分成兩類:一類是提供權重和程式碼的可下載成果,另一類則是 Tencent 宣布、但仍等待外部重現的研究結果。下表各列都附上可查核的來源。
| 成果 | 內容 | 主要數字 | 證據狀態 |
|---|---|---|---|
| HyInv | 196 萬參數的蛋白質逆折疊模型,權重 7.8 MB,提供 CLI + Python API | 生成速度約為 ProteinMPNN 的 57 倍;在 1x H20 GPU 上處理 148-residue 蛋白質時,25 ms 對比約 1 s,數據來自 TSN 的評測 | 成果可檢視(MIT);基準測試可執行;主要性能結果尚未經獨立重現 |
| HyPLM-Flash | 6.5 億參數的 masked protein language model,權重 2.6 GB,提供 INT8 engine | 在 1x H20 上約每秒 130,000 個 residues;在 Tencent 對 12 個模型、35 項任務的測試中推論速度最快,平均排名第 3;ProteinGym Spearman 為 0.409,與 ESM-2 650M 級別並列,數據來自 TSN 的評測 | 成果可檢視(MIT);需要 CUDA GPU;兩項評測涵蓋的模型和任務數不同 |
| HyFF | 5 個機器學習力場模型(Presto、Vivace、Moderato、Andante、Largo),參數量 230 萬至 12 億,涵蓋 83 種元素 | Largo 的能量誤差為 0.364 meV/atom,對比 DPA4-Pro 的 0.380,速度快 9.7 倍;在 1x H20 上處理 2,586-atom MD 時,Andante 的速度是 UMA-S-1.2 的 29 倍 | 成果可檢視(Apache-2.0),並附有 hyff 套件;速度數字來自單一 H20 工作負載 |
| Petty conjecture dim-5 | 證明成果:每個 5-D real normed space 都包含 6 個等距點(此前最佳為 dim 4,Makeev 2005),資料來自 repository index | 解決 dimension 5 | 論文可檢視;未有期刊同儕審查紀錄 |
| Yau circle-action | 聲稱找到反例:一個封閉的 7-manifold,具有正 sectional curvature,且不存在 effective circle action,資料來自 repository index | 解決 unrestricted case;simply connected case 仍未解決 | 論文可檢視;未有期刊同儕審查紀錄 |
| HyQEC | 源自 qLDPC Challenge lineage 的量子錯誤修正碼,資料來自 Prompt Blueprints | 編碼效率比先前領先方案高約 48% | 已宣布;完整成果仍待 GitHub 發布 |
| XiangShan RISC-V | 開源處理器最佳化,資料來自 Prompt Blueprints | 每 GHz 分數提升 5.79%,面積增加幅度極小;修正多核心錯誤 | 已宣布;未公開基準測試名稱與基準值 |
| Robotic hand | 五指機械手,手指長度採階梯式設計,資料來自 Eyerys | 在固定預算模擬中,物體旋轉速度提升 28.6% | 已宣布;目前仍只有模擬結果 |
和 Hyra 1.0 相比,Hyra 2.0 的重點已從「答案」轉為「資產」。Hyra 1.0 先證明這個迴圈能運作:其中的 sums_diffs 項目將組合數學常數從 1.14489 提升到 1.21079,Tencent 也將一項 50 年歷史的加法組合學問題進展歸功於它。Prompt Blueprints 的發布分析 指出,Hyra 2.0 保留了這套反覆迭代引擎,進一步加入代理階層、持久化專案和 skill extraction,目標是讓每次成功都能被後續研究重複利用。
今天能執行什麼?哪些東西仍留在 Tencent 內部?
你可以執行 Hyra 2.0 產出的模型與工具,但協調器本身沒有公開安裝版本。Hyra-results repository 採 Apache-2.0 授權,各成果資料夾也預計提供最終產物和重現腳本。可以先從這裡開始:
git clone https://github.com/Tencent-Hunyuan/Hyra-results.git
ls AI4Science/hyinv
接著依照需求選一條路:
- HyInv(入門門檻最低): 開啟
AI4Science/hyinv,裡面有權重、推論程式碼和技術報告。參考流程可在 CPU 和 GPU 上執行;加速用的 BF16 路徑目前只在 Hopper 級 GPU 上完成驗證。 - HyPLM-Flash(需要 CUDA): 開啟
AI4Science/hyplm_flash,再執行weights/download.sh下載、合併並驗證 2.6 GB 權重。最好準備 H20/H100 級 GPU;表示提取使用 INT8,細粒度變異回歸則使用 BF16。 - HyFF(要重現宣稱的速度需要 H20): HyFF 區段提供 5 個力場模型,每個大小介於 9 MB 至 4.8 GB,並附有
hyff套件,支援單一結構、批次,以及 NVE/NVT/NPT 分子動力學。
目前仍未公開的部分包括 Overall/Mission/Worker 協調器、prompts、schedulers、evaluators,以及 Books/skills 儲存庫。大型運算工作需要人工核准,也代表系統在資源分配上並非完全自主。簡單說,代理本身沒有可安裝版本;但最容易拿來測試的成果只需下載 7.8 MB,因為 TSN 指出,在相同 backbone 上直接比較 HyInv 與 ProteinMPNN,建置成本並不高。
這些漂亮的性能數字,真的站得住腳嗎?
TSN 報導 指出,截至 November 2, 2026,所有性能數字都來自 Tencent 或模型文件,尚未有公開的獨立重現結果。閱讀這些數字時,別忘了連同它們的測試條件和分母一起看。
首先,速度不等於品質。HyInv 所謂的 57 倍,是在單張 Nvidia H20 上比較生成吞吐量(148 residues 約 25 ms 對約 1 s;402 residues 則為 54 ms 對 2.6 s),並不是濕實驗成功率。結構相似度是以預測結構作為評分基準,目前也沒有公布濕實驗驗證:
比 ProteinMPNN 快 57 倍、每秒約 2,500 個 designs,代表的是吞吐量,不是設計品質。接下來我想看到的是 self-consistency RMSD 和 sequence recovery……反向折疊通常也不是瓶頸,真正的瓶頸往往是後續的 refold。
其次,效率宣稱必須放回硬體和測試範圍來看。HyPLM-Flash 所謂「12 個模型中最快」,指的是 Tencent 對 12 個模型、35 項任務進行的部落格評測;repository 的對照評測則涵蓋 28 個 checkpoints 和 32 項任務,ProteinGym zero-shot Spearman 為 0.409,與 ESM-2 650M、ESM C 600M 和 E1-600M 統計上並列。HyFF 的 29 倍和 9.7 倍速度,都是在單張 H20 上處理 2,586-atom 系統所得;而 Andante 的力誤差為 7.65 meV/Å,略高於 UMA-S-1.2 的 7.55 meV/Å。這比較接近「準確度相近時速度更快」,而不是全面勝出。
第三,也是 Hyra 2.0 核心論點的「重複利用」,目前仍未被證明。發布材料沒有交代生成的 skill 在重用前如何驗證、由誰核准,也沒有公布跨專案重用的實際數據:
與其產出一次性的答案,打造可重複使用的工具確實是正確方向。大多數代理執行完任務後,就把過程中學到的一切丟掉了。我很好奇 Hyra 會如何判斷一個工具已經夠好,值得保留並重用。
另一位實務工作者也從 human-in-the-loop 的角度提出同樣的驗證疑問(@ModelPlaneHQ)。Tencent 的發布材料以及上方列出的第三方評測,沒有提供與 Google's AI Co-Scientist 或 Sakana AI Scientist 等同類系統的正面對比,因此目前若要排名,依據仍只能是 Tencent 自己公布的數字。面對任何由代理打造的模型,至少要追問四件事:使用什麼硬體、採用什麼品質設定、由誰重現,以及在哪些地方成功重用?
FAQ
Hyra 2.0 是開源的嗎?我可以試用嗎?
框架本身是封閉的,但產出成果採開放授權。目前沒有提供代理系統的公開 demo、API 或安裝版本。HyInv 和 HyPLM-Flash 的模型套件採 MIT 授權,HyFF 則適用 repository 的 Apache-2.0 條款;實際使用前仍應查看各資料夾的 README 和授權文件。
Hyra 2.0 和 Hyra 1.0 有什麼不同?
Hyra 1.0 著重於反覆迭代解題,包含一項長期未解的組合數學成果。Hyra 2.0 則加入 Overall/Mission/Worker 階層、持久化專案狀態、Books 知識庫、skill extraction,以及產出可重複使用模型與工作流程的明確目標。
這些數學成果經過同儕審查了嗎?
目前不是以期刊論文形式完成同儕審查。Petty dimension-5 和 Yau counterexample 論文已公開、可供檢視;repository index 也記錄了 3 項較早期 finite-core 結果(Beurling-Ahlfors、partial Hadamard、commutator)的 Lean 4 formalizations。現階段應將它們視為等待專家審查的研究主張。
要重現這些蛋白質模型,需要什麼硬體?
HyInv 的參考流程可在 CPU 和 GPU 上執行,下載大小為 7.8 MB。HyPLM-Flash 的 2.6 GB INT8 engine 需要 CUDA GPU,建議使用 H20/H100 級硬體;HyFF 的速度數字則以單張 H20 為前提。
如何評估 Hyra 2.0,才不會把話說過頭?
Hyra 2.0 的核心押注是:科學進步的基本單位應該是工具,而不是答案;可重複使用的 skills 會彼此累積,形成 Tencent 所說的 intelligence compounding returns(智能復利)。這次發布確實展示了歸因於該系統的模型和工具,但這些工具能否持續加速後續科學研究,仍要等到重用率、驗證成本和獨立重現結果一併公開後,才有辦法判斷。