 AIREITER
1450 億參數模型、每秒 80 個 token,還能在筆電上執行——Edge0-145B 的宣傳確實很吸引人。不過真正開始下載後,才會發現它比較像是為搭載 CUDA 13 的 NVIDIA 電腦設計,SSD 也要預留約 105GB。
這篇 Edge0-145B 評測會把官方宣稱,與發布文章、模型文件、Q3_K 模型卡及首批社群實測放在一起比較。你可以先判斷自己的設備是否適合,再決定要下載本機執行,還是直接使用 API。
11 月 12 日發布了什麼:模型權重、推論引擎與限制
Edge0 在 2026 年 11 月 12 日發布 Edge0-145B 與 Edge0-120B,模型權重分別放在 Edge0-145B-q3k 和 Edge0-145B-NVFP4,推論引擎則是 Edge0-AI/Edge0 裡的 edge0-strata。Edge0-145B 是純文字、採潛在式 Mixture-of-Experts 架構的模型,支援 256K context,源自 Qwen3.8-Flash-Next,並以原生 4-bit 方式訓練。每個 token 實際啟用約 10.12B 個參數,因此總參數達 145B 並不代表需要 145B VRAM。
整個模型大致由 84.6B 專家參數、從 SSD 以記憶體映射方式載入的 51.2B PLE n-gram 表、用於 speculative decoding 的 1.26B draft head,以及 6GB skeleton 組成。Q3_K 的權重大小為 40.81 GiB,但整個儲存庫達 105.4GB;NVFP4 的權重為 47.79 GiB,儲存庫則是 112.9GB。路由專家的權重放在自訂的 experts.bin 封裝中,而不是可攜式 GGUF 檔案。
所謂 29GB,並不代表只需要 29GB
官方文章某一段寫著峰值 29GB,另一段則寫 28GB;同時列出的還有每秒超過 1,100 個 token 的 prefill、超過 80 個 token 的 decode,以及 120W 功耗。Q3_K 模型卡則顯示,在 RTX 5090 D 上需要 23.14 GiB VRAM 加 31.28 GiB 主機 RAM;NVFP4 則是 23.25 GiB VRAM 加 38.27 GiB RAM。專家函式庫本身約佔 40GB RAM,另有約 48GB 的詞彙資料會從 SSD 串流載入。
常用的專家會留在 VRAM,較不常用的專家放在 RAM,而 51.2GB 的 PLE 表則會按需從 SSD 讀取。若只看狹義的活躍駐留量,數字確實可能接近 29GB;但要完成下載與串流推論,仍然需要整個儲存庫的空間。
| 這個數字代表什麼 | 大小 | 存放位置 |
|---|---|---|
| 官方文章的峰值記憶體宣稱 | 28-29GB | 活躍駐留量,測試方法未公開 |
| Q3_K 儲存庫下載量 | 105.4GB | NVMe SSD,包含 51.2GB PLE + 40.1GB experts.bin |
| NVFP4 儲存庫下載量 | 112.9GB | NVMe SSD,包含 51.2GB PLE + 47.6GB experts.bin |
| 5090 D 實測 Q3_K 駐留量 | 23.14 GiB VRAM + 31.28 GiB RAM | 推論期間使用的 VRAM + 系統 RAM |
| 5090 D 實測 NVFP4 駐留量 | 23.25 GiB VRAM + 38.27 GiB RAM | 推論期間使用的 VRAM + 系統 RAM |
實際執行 Edge0-145B 需要什麼設備
Edge0-145B 可透過 edge0-infer 在 Linux 或 Windows 上搭配 NVIDIA GPU 與 CUDA 13 執行。已發布的檔案沒有提供原生 llama.cpp、Ollama 或 LM Studio 載入方式:skeleton GGUF 缺少路由專家權重,而 Edge0 文件只列出 edge0-infer(詳見儲存庫說明)。因此,llama.cpp v1.0 指南中的操作流程並不適用。官方文章提到 macOS 與 MacBook Pro 首日支援,但平台表格針對 145B 和 120B 只列出搭配 CUDA 13 的 Linux 與 Windows。
最低測試配置是 16 GiB VRAM 加 20 GiB RAM,在 Q3_K 的 agent decode 測得每秒 44.9 個 token。官方建議則是 24GB NVIDIA 顯示卡、32GB 系統 RAM,若有 48GB 會更寬裕,另需 120GB 可用 NVMe 空間,以及 CUDA 13、CMake、Ninja 和 uv。依照儲存庫說明建置並啟動服務:
git clone https://github.com/Edge0-AI/Edge0.git edge0
hf download Edge0/Edge0-145B-q3k --local-dir ./Edge0-145B-q3k   # ~105 GB
export EDGE0_145B=$PWD/Edge0-145B-q3k
build/cpu/bin/edge0-infer serve --model "$EDGE0_145B"  # :8000
Windows 使用者也可以從 GitHub Releases 下載 Edge0 Chat app v0.2.0。AMD 顯示卡則需要手動修改:u/UghrUghr 在r/LocalLLaMA 討論串表示,Windows 11 搭配 RX 7900 XTX 約需修改 35 行建置與執行時程式碼,而且 CUDA 融合核心會改走較慢的備援路徑。
Q3_K 還是 NVFP4:該下載哪個版本
Q3_K 大小為 105.4GB,是預設選項;Edge0 表格顯示它在 5090 D 上的 agent decode 速度為每秒 121.2 個 token。NVFP4 大小為 112.9GB,主要針對 Blackwell 加速,在同一張顯示卡上的速度為 98.3。沒有 Blackwell 硬體的話,建議先從 Q3_K 開始。
實際顯示卡跑起來有多快
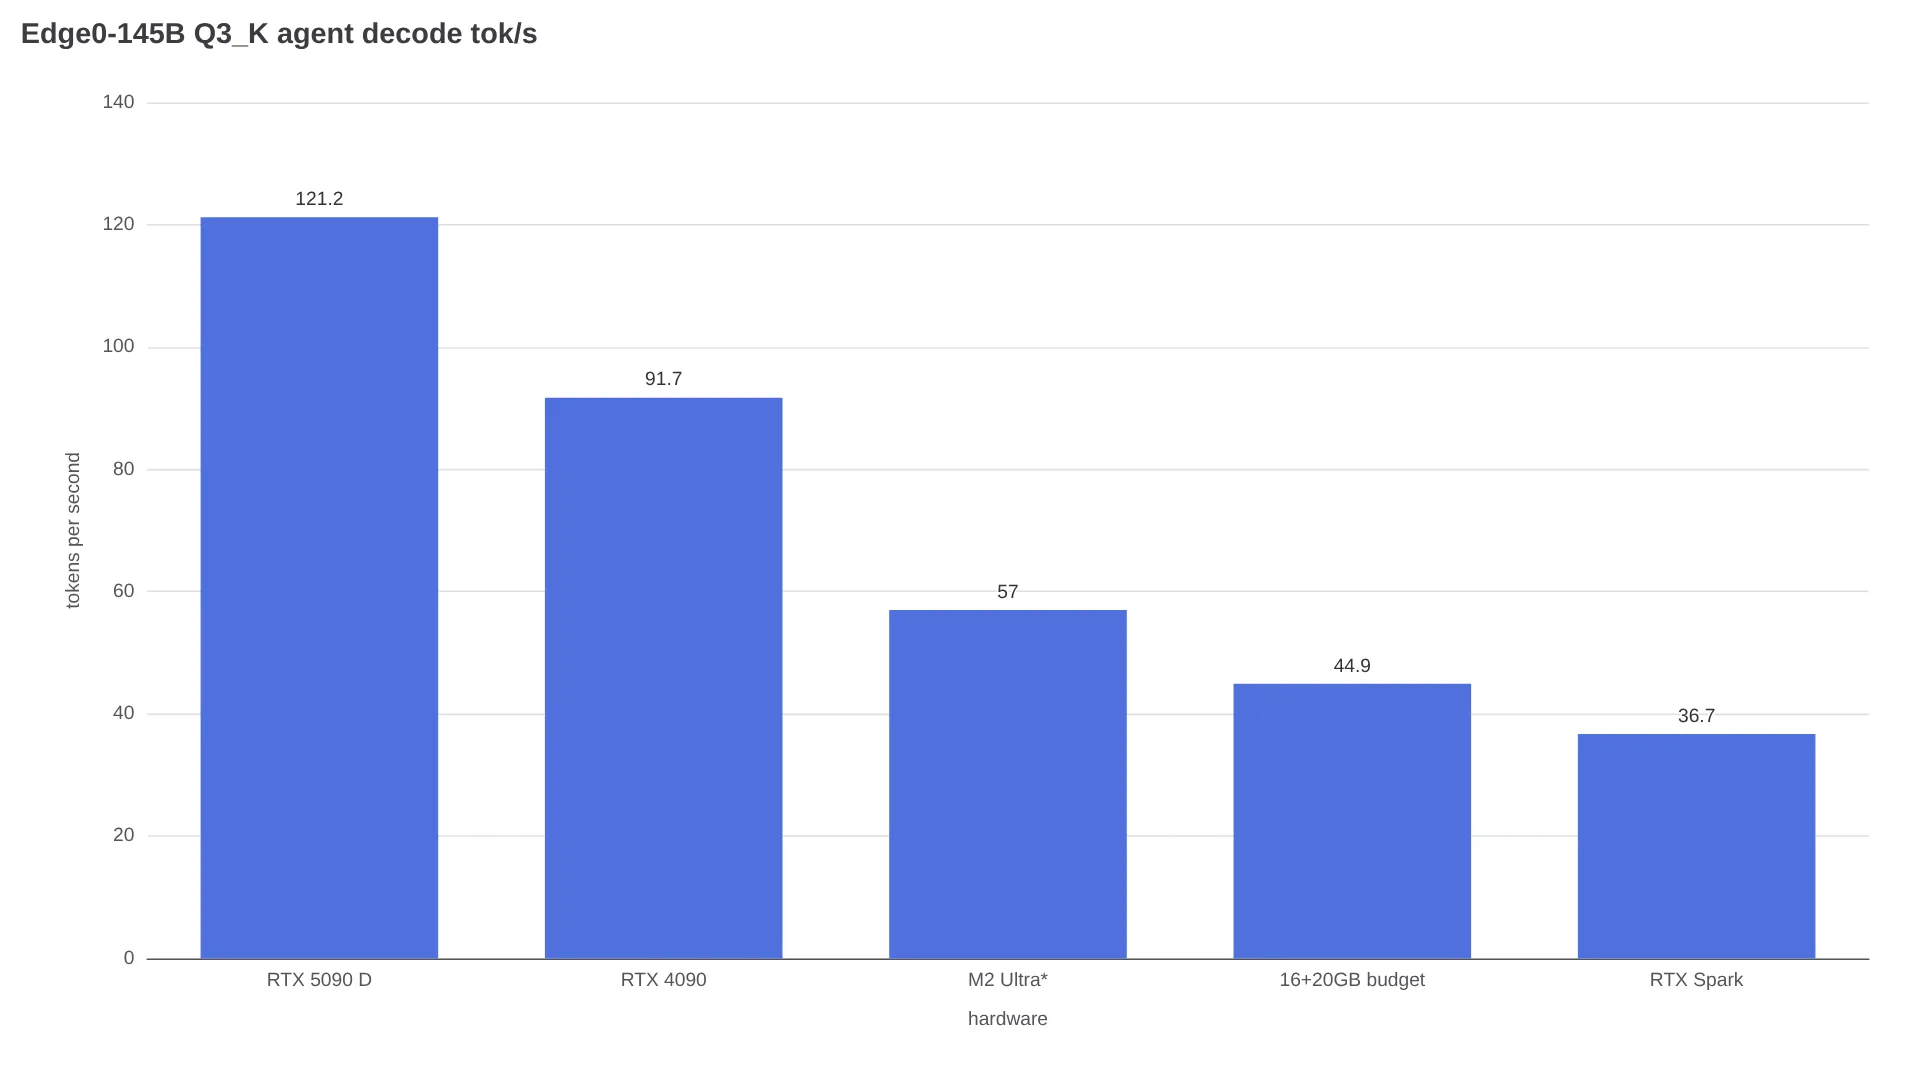
以下數據都是 Edge0 公布的 Q3_K 結果,除非另有註明,prefill 長度為 16K。M2 Ultra 那一列是 Metal 測試,不能據此證明已有 macOS 版本可用。
| 硬體 | Chat decode | Agent decode | 16K prefill |
|---|---|---|---|
| RTX 5090 D 24GB Q3_K | 99.7 | 121.2 | 3,554.9 |
| RTX 4090 24GB Q3_K | 69.9 | 91.7 | 3,179.4 |
| Apple M2 Ultra Metal Q3_K | 60.9 | 57.0 | 800.3 |
| 16 GiB VRAM + 20 GiB RAM 預算配置 Q3_K | 36.8 | 44.9 | 335.0 |
| RTX Spark 60GiB Q3_K | 37.7 | 36.7 | 770.3 |
一名 RTX 3090 使用者回報,Q3_K 的首 token 時間為 20.1 秒、prefill 為 1,583、decode 為 56.2,整體速度看來低於旗艦級顯示卡:
剛在我的 3090 配置上試了一下——Edge0-145B Q3_K 的 TTFT 是 20.1 秒,prefill 1,583 tok/s,decode 56.2 tok/s。
— u/LightBrightLeftRight,r/LocalLLM 討論串
在前述 AMD 配置上,u/UghrUghr 回報 decode 約 40;加入 ROUTE_TAIL_SKIP=7 與 ROUTE_PRIOR=1.5 後約為 54,prompt processing 則約為 320。這些都是單一使用者的實測紀錄,不是受控重現,速度大約只有 5090 D 的二分之一到三分之二。
基準測試:兩項領先,四項需要保留看法
根據模型文件,Edge0 的表格把 Edge0、Qwen、DeepSeek 和 Claude 的內部測試,以及其他模型的第三方數據混在一起。Edge0-145B 在兩項 coding-agent 測試中領先,但在知識與指令遵循測試中落後於它的 Qwen 基礎模型。截至 2026 年 11 月 13 日,我找不到附有連結的獨立重現結果;而且表中的成績代表完整模型,不是可下載的量化版本。
| 基準測試 | Edge0-145B | Qwen3.8-Flash-Next | DeepSeek V4 Flash | Claude Opus 4.6 Max |
|---|---|---|---|---|
| DeepSWE 1.1 | 64.6 | 58.7 | 54.4 | — |
| Terminal-Bench 2.1 | 86.52 | 83.3 | 82.7 | 78.2 |
| HLE | 35.4 | 35.9 | 33.8 | 40.0 |
| GPQA-Diamond | 90.4 | 91.7 | 90.8 | 91.3 |
| IFBench | 80.6 | 81.3 | 79.2 | 62.5 |
| AA-LCR | 79.3 | 79.1 | 79.7 | 78.0 |
依照 Edge0 的計算,Edge0-145B 平均分為 72.8,Qwen3.8-Flash-Next 為 71.7,DeepSeek-V4-Flash 為 70.1,而 120B 則是 68.9。我的結論是:兩種尺寸的峰值效能宣稱相近,除非 SSD 空間吃緊,否則選 145B。
授權:開放權重不等於開源
框架採 Apache 2.0 授權,Strata 基礎則是 MIT;但模型權重使用Edge0 Community Model License 1.0,同時也受 Qwen 條款約束。個人、研究、內部商業用途,以及輸出內容的商業使用都獲允許。不過,銷售或捆綁模型、提供付費服務,或將它做成商用程式碼/辦公助理產品,都需要另行取得書面許可。
該下載,還是直接呼叫 API
如果你有符合要求的硬體,而且希望程式碼留在本機,便值得下載。若只是想試用一次,先比較託管 API 的價格,再決定是否要為此添購硬體。正在比較託管推論服務的開發者,也可以先查看DeepSeek V4.1 Flash API 頁面,再決定是否要為模型拿出 105GB 磁碟空間。
| 你的情況 | 建議 |
|---|---|
| 24GB NVIDIA + 32-48GB RAM + 120GB NVMe,使用 Linux/Windows | 下載 Q3_K,透過 edge0-infer 提供服務 |
| 使用 Blackwell 顯示卡,偏好 NVFP4 路徑 | 下載 NVFP4 版本 |
| 只有 Mac、8-16GB 筆電,或需要 Ollama/LM Studio | 先不要下載,改用託管 API |
| 要用這些模型權重提供付費 API 或助理服務 | 先取得書面授權;或改用 API |
| 想要模型成績,但不想處理部署工作 | 使用 Qwen 類型或前沿模型 API,等獨立重現結果出現後再評估 |
這次的取捨在於來源透明度與實用性:專家串流確實降低了 100B 以上模型的 VRAM 門檻,但筆電、macOS 和 29GB 的說法都跑在已發布程式碼前面;此外,Edge0 公開的表格也沒有分別列出 Q3_K 的品質數據。
常見問題
Edge0-145B 可以在筆電上執行嗎?
只有配備約 24GB VRAM、32GB 以上 RAM 和 120GB NVMe 的高階 NVIDIA 筆電,並且在搭載 CUDA 13 的 Linux 或 Windows 上,才有機會執行。8GB 或 16GB 的輕薄筆電無法執行 145B 版本;該版本需要下載 105.4GB,VRAM 駐留量也超過 23 GiB。
Edge0-145B 能在 Mac 上執行嗎?
截至 2026 年 11 月 13 日,平台表格中沒有看到受支援的 macOS 版本。M2 Ultra 的數據只有 Metal 測量結果。
它支援 Ollama、llama.cpp 或 LM Studio 嗎?
不支援。標準版本無法載入自訂的 experts.bin 封裝,而 skeleton GGUF 也缺少路由專家權重。請使用 edge0-infer serve 或 Windows Chat app。
Edge0-145B 比 Qwen3.8-Flash-Next 更好嗎?
在 Edge0 的測試中,DeepSWE 以 64.6 對 58.7 領先,Terminal-Bench 則以 86.52 對 83.3 領先;但 HLE 以 35.4 對 35.9 落後,GPQA-Diamond 也以 90.4 對 91.7 落後。獨立測試仍在等待中。
我可以把 Edge0-145B 用於商業用途嗎?
輸出內容可以,但依照社群授權,銷售模型、提供付費服務,或推出商用程式碼/辦公助理,都需要另行取得書面許可;同時也必須遵守 Qwen 條款。