 AIREITER
原始的 facebookresearch/demucs repository 自 2025 年 1 月 1 日起就已設為唯讀。不過,Demucs 依然是目前最強的一批免費本機音軌分離工具之一;前提是你要從推出 v4.1.0 的 fork 安裝,並接受它最先露出破綻的通常是吉他與鋼琴。
先從仍在維護的 Demucs Repo 開始,別再用封存版本
GitHub 上有兩個使用相同 README 的 repository,但現在只有其中一個還會收到修正。facebookresearch/demucs 已經封存並設為唯讀,README 也明確指向另一個位置。仍在維護的版本位於 adefossez/demucs。作者 Alexandre Défossez 表示,這裡是「我離開 Meta、加入 Kyutai 後,目前官方維護的 Demucs」,但也提醒大家「目前回覆會比較慢,也暫時不會加入新功能」。
這不只是 GitHub 網址換了而已,連安裝方式都跟著改變。
v4.1.0 改了什麼
日期標示為 11/07/2026 的 release notes,將 Demucs v4.1.0 描述為具備「現代化套件封裝、更輕量的推論依賴、許多修正,以及託管於 Hugging Face 的預訓練模型」。實際上會影響你的地方如下:
| 項目 | 封存 repo | 仍在維護的 repo(v4.1.0) |
|---|---|---|
| 最低 Python 版本 | 3.8 | 3.10 |
| 最快執行方式 | pip install -U demucs | uvx demucs MY_TRACK.mp3(不用先安裝) |
| 永久安裝 | pip install -U demucs | uv tool install demucs(pip 仍可使用) |
| ffmpeg | 必要 | 選用;輸出 FLAC,以及處理 sphn 無法解碼的格式時才需要 |
| 量化模型 | 內建 | 需要額外安裝:uvx "demucs[quantized]" -n mdx_q MY_TRACK.mp3 |
| 模型權重託管位置 | dl.fbaipublicfiles.com | Hugging Face |
還有一個在回報問題前值得先知道的陷阱:PyTorch 在 2.2 之後停止支援 Intel Mac,這也讓你最多只能使用 Python 3.12。因此 Intel Mac 使用者需要執行 uvx --python 3.12 demucs。
模型怎麼選:htdemucs、htdemucs_ft、htdemucs_6s 與 mdx
-n 參數用來指定模型,而預設值不一定適合每種工作。Demucs 提供四音軌模型(鼓、貝斯、其他、人聲)、一個六音軌實驗模型,以及較早期的 MDX 挑戰賽模型。
| 模型 | 音軌數 | 速度 | 官方提醒 | 適合什麼情況 |
|---|---|---|---|---|
htdemucs | 4 | 基準(預設) | 沒有特別說明 | 第一次處理、批次工作,以及重視處理量的情況 |
htdemucs_ft | 4 | 約慢 4 倍 | 「可能會好一點」 | 在乎品質的歌曲,做最後輸出時使用 |
htdemucs_6s | 6 | 介於兩者之間 | 吉他表現「尚可」;鋼琴「效果不太好」,而且「有大量串音與瑕疵」 | 你確實需要吉他音軌,而且能接受結果不乾淨 |
hdemucs_mmi | 4 | 基準 | v3 架構,重新訓練 | v4 在某個特定混音上表現不對時,用來 A/B 比較 |
mdx / mdx_extra | 4 | 基準 | mdx_extra 的訓練資料包含 MUSDB 測試集 | 較早期的素材,或你受不了 v4 的瑕疵時 |
mdx_q / mdx_extra_q | 4 | 最快、體積最小 | 「品質可能稍差」 | 儲存空間有限的機器,以及快速預覽 |
請留意 htdemucs_ft 的保守說法:計算量增加四倍,品質提升卻只是作者本人認為「可能」存在。在 CPU 上,這個代價非常明顯,使用者也毫不避諱地這樣反映。
9.00 與 9.20 dB SDR 數字到底代表什麼
這兩個數字出現在 README 的同一段文字裡,但不能混為一談。Hybrid Transformer Demucs 在 MUSDB HQ 測試集上達到 9.00 dB SDR。較高的 9.20 dB 則需要稀疏注意力核心加上逐音源微調,而且那個稀疏模型「目前沒有提供,因為它需要尚未準備好公開的自訂 CUDA 程式碼」。
換句話說,沒有任何可下載的模型能重現 9.20 dB。在 README 自己的比較表中,已發布的 v4 微調模型整體 SDR 為 9.0,與使用 1.7k 組混音訓練的 Band-Split RNN 並列。
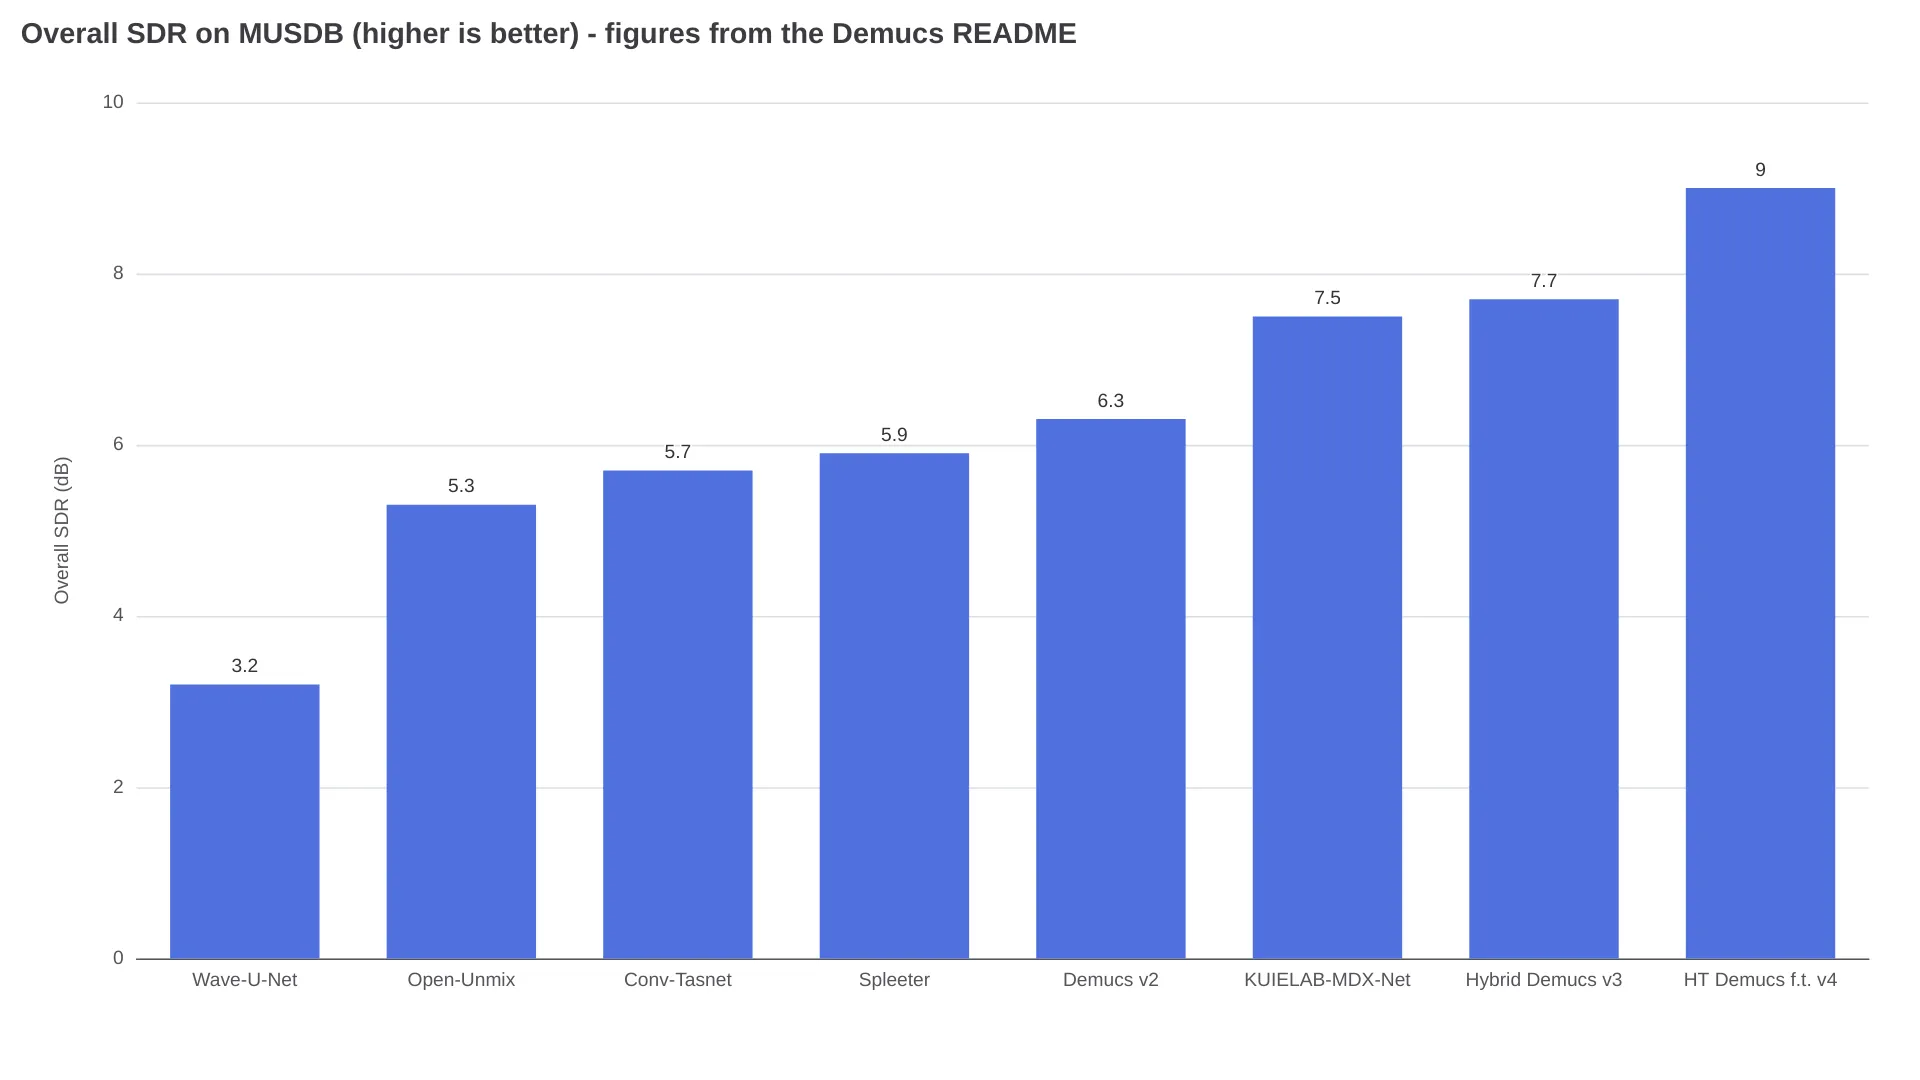
同一張表中,Spleeter 即使使用 25k 首歌曲訓練,仍只有 5.9 dB,與微調版 v4 之間大約差了 3 dB。
真正會改變輸出的參數
大多數 Demucs 工作只需要做三個決定:要分出多少音軌、願意投入多少計算量,以及最後要用什麼格式輸出。
--two-stems=vocals會進入卡拉 OK 模式,輸出vocals.wav與no_vocals.wav。它仍會先分離完整混音,之後再混回去,因此不會比一般執行更快,也不會更省記憶體。--shifts=N會對隨機平移過的輸入進行 N 次預測,再取平均。處理速度會變成原本的 N 倍慢;README 的建議是「除非你有 GPU,否則不要使用」。論文使用 10 次 shifts,而 Replicate 託管版本的預設值是 1。--overlap預設為 0.25,降到 0.1 可以換來小幅速度提升。--segment N是處理 OOM 的主要開關,但這裡有個常被複製貼上的指令忽略的細節:Hybrid Transformer 模型的最大 segment 長度是 7.8 秒,因此較長的--segment數值只對非 HT 模型有作用。- 輸出參數包括
--mp3(預設 320 kbps)、--flac(需要 ffmpeg)、--int24與--float32。預設輸出是 44.1 kHz、int16 編碼的 WAV,位置在separated/MODEL_NAME/TRACK_NAME。 --clip-mode的影響比看起來更大:Demucs 預設會重新縮放各音軌來避免 clipping,但這可能破壞音軌之間的相對音量;改用clamp則會以硬限制處理。
同一份文件給出的硬體需求是:至少 3 GB GPU 記憶體,使用預設參數時約需 7 GB;如果只有 3 GB 或更少,則使用 --segment 8,並設定 PYTORCH_NO_CUDA_MEMORY_CACHING=1。CPU 方面,文件表示「處理時間大約會是歌曲長度的 1.5 倍」。相較於使用者回報的 htdemucs_ft 實測時間,這個估算算是相當樂觀。
Demucs 最容易串音的地方,以及使用者採用的兩階段修正法
「串音」幾乎是最常見的抱怨,尤其當人聲和主奏樂器落在相近音域時更明顯。Ryan Herr(@rrherr)在一次提取嘗試後,直接這樣形容:
demucs 讓很多薩克斯風聲漏進了「vocals」音軌。
有經驗的使用者最後通常不是再找一個參數,而是改用第二個模型。日本製作人夜凪P(@yonagip,145 個讚)分享的做法,是先在 UVR5 裡用 MelBand Roformer 分離人聲與伴奏,再只把伴奏送進 htdemucs_ft,處理鼓、貝斯與其他音軌:
Demucs単体だとVoが他に漏れるんだけど(只用 Demucs 的話,人聲會漏到其他音軌裡)
另外兩則使用者回報也指向同一個方向:一位製作人表示 htdemucs_ft 能帶來更清晰的貝斯,但 CPU 處理速度慢了四倍(@hachi_vm);另一位則發布吉他提取比較,顯示 htdemucs-6s 明顯輸給 BS-RoFormer 模型(@junon_12)。這些都是個人回報,不是正式基準測試,但與官方說法一致:Défossez 在 2022 年 12 月宣布六音軌模型時,就提到自己觀察到「一些串音與瑕疵」。
實用判斷:如果素材裡有薩克斯風、主奏吉他,或負責旋律線的鋼琴,第一次 Demucs 分離通常只能算起點,還不到可以直接交付的程度。需要第二階段處理時,可以透過 UVR5 介面使用 Roformer 系列替代模型。
不想安裝 Demucs?直接用 API 呼叫
如果你不想準備 Python 環境,目前廣泛使用的託管版本之一是 Replicate 上的 cjwbw/demucs:使用 Nvidia T4 硬體,累計執行約 150 萬次;頁面估算每次約 0.020 美元(每 1 美元約可執行 50 次),而且預測通常能在 90 秒內完成。
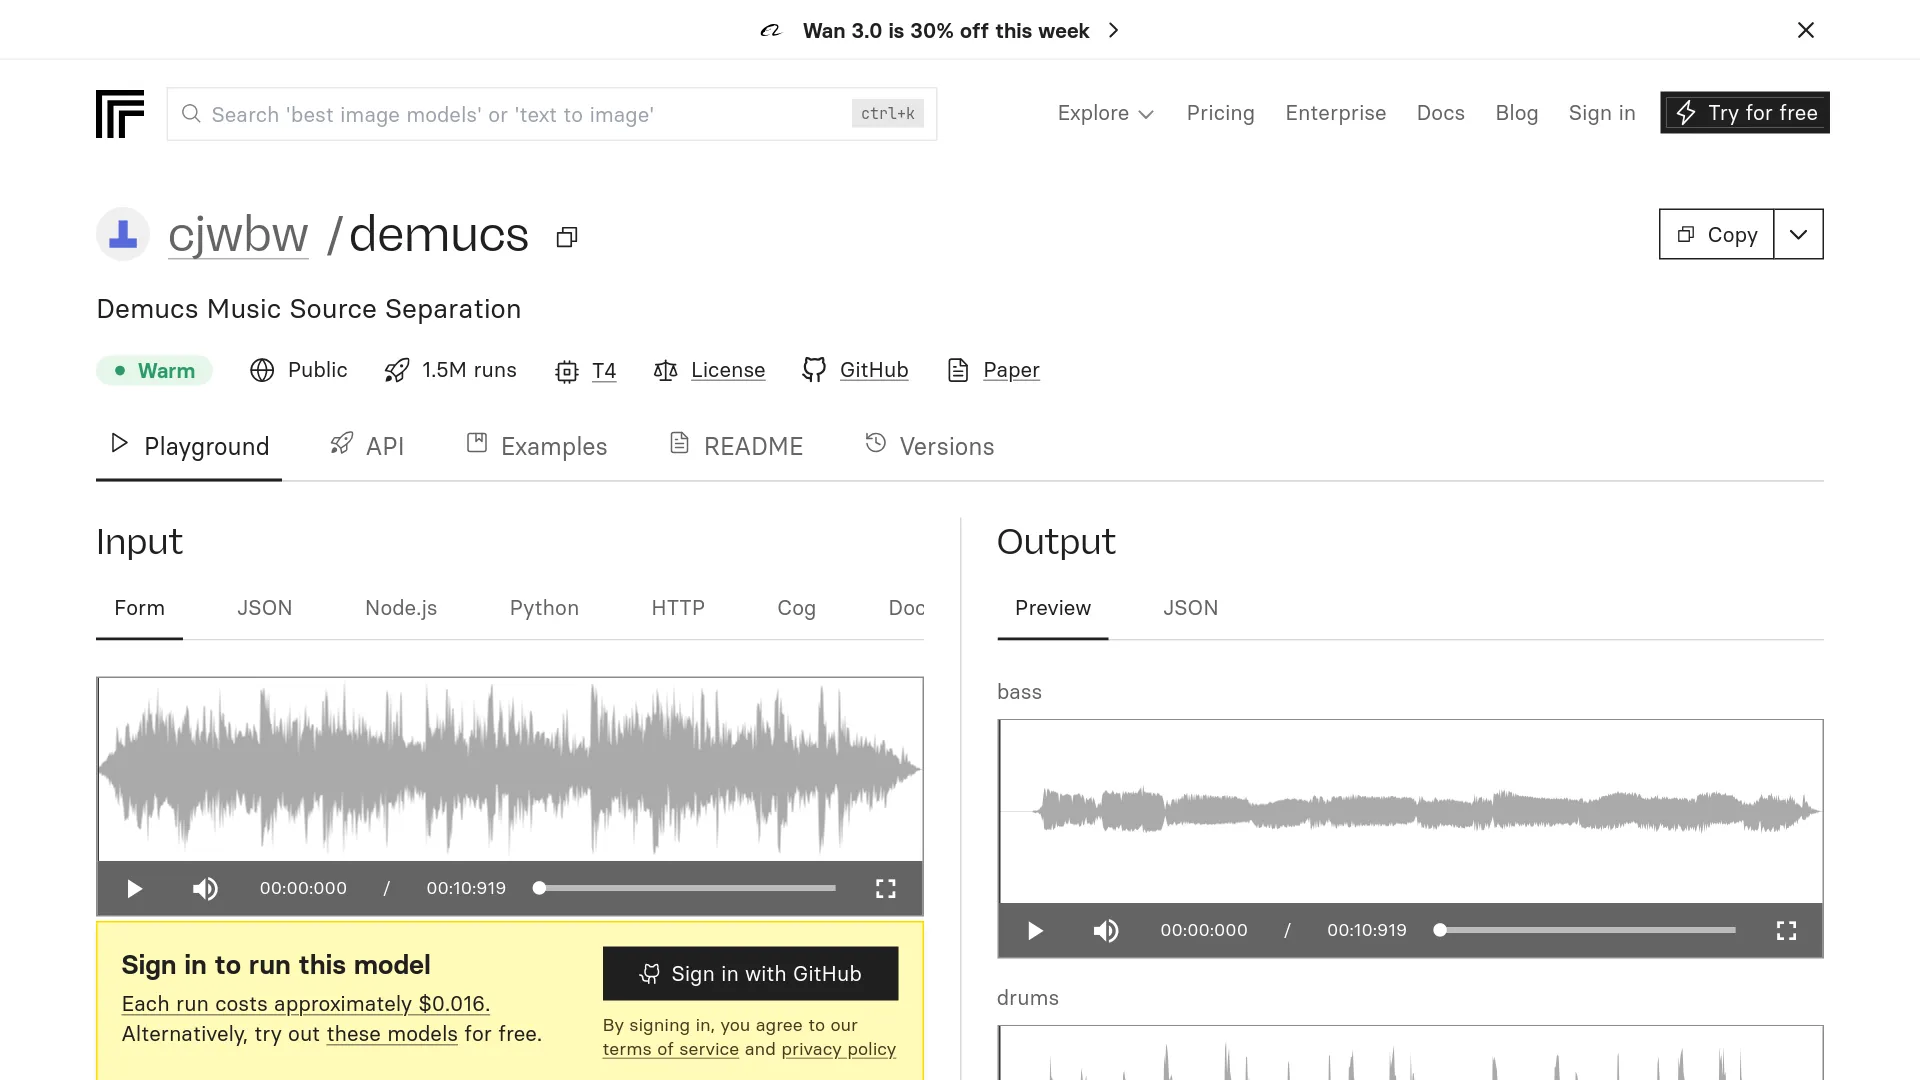
它的輸入 schema 基本上對應 CLI:model_name(預設 htdemucs)、stem、shifts(預設 1)、overlap(0.25)、clip_mode(rescale)、mp3_bitrate(320)、float32、output_format(mp3)。
但有一點頁面不會主動替你標示:它的最新版本大約已是三年前的版本,而託管 endpoint 會鎖定某個 snapshot。你實際呼叫的是那個版本,不是 2026 年 7 月 v4.1.0 的套件封裝與依賴更新。執行時間也比標示的平均數字更飄,一個公開範例中,同一模型的預測就花了 6 分鐘 18 秒。
一首 4 分鐘歌曲實際要花多少錢
真正會決定工作流程的,是每首歌的成本;而這又取決於一個很多人訂閱後才發現的計費細節。
LALAL.AI 的用量計算方式是檔案長度 × 選取的音軌分離類型數量。一首 4 分鐘的歌曲如果分成四個音軌,消耗的是 16 分鐘,不是 4 分鐘。
同一個定價頁面列出的單次加購方案(於 2026 年 9 月 25 日查閱)為:750 分鐘 Fast Queue 售價 50 美元、3,000 分鐘售價 190 美元、5,000 分鐘售價 300 美元。按這些價格計算,一首 4 分鐘歌曲分成四個音軌,成本約落在 0.96 至 1.07 美元之間。
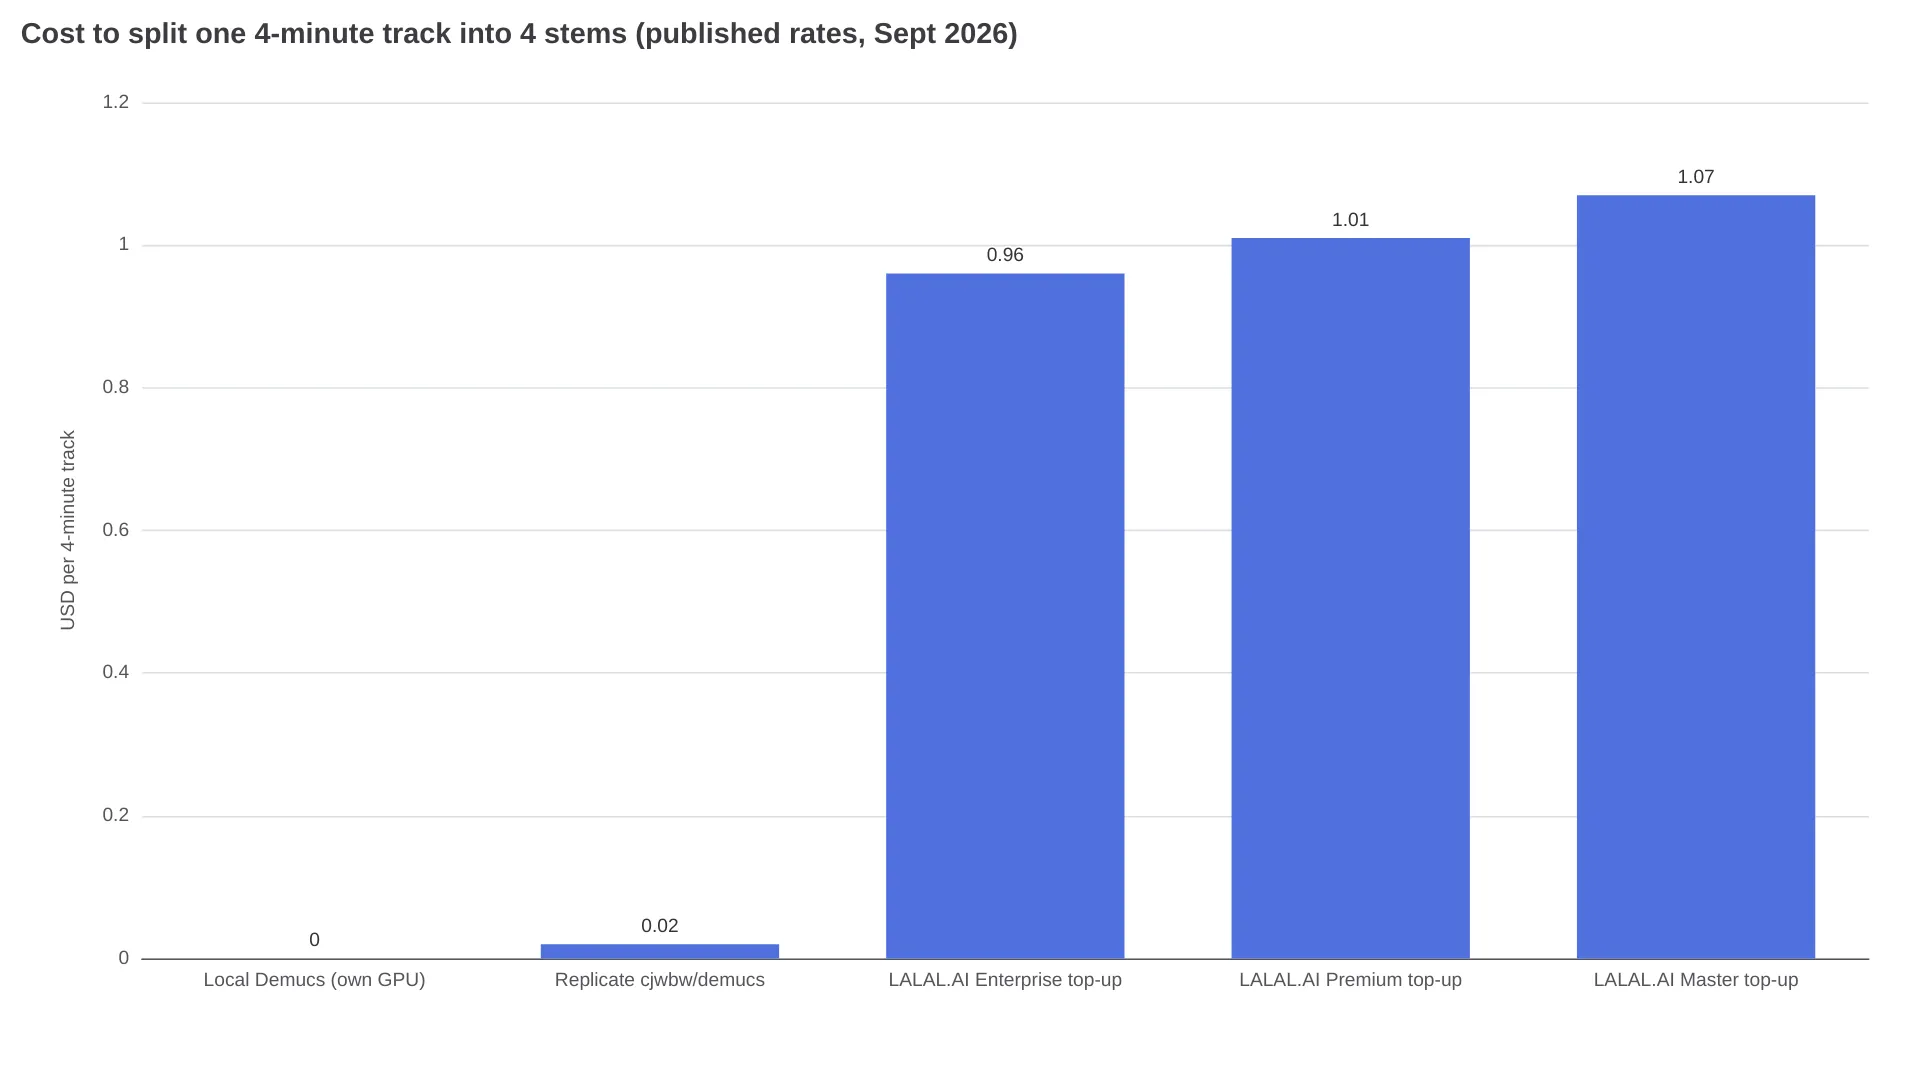
不過,讀這張圖時要記得補上一個前提:LALAL.AI 的這些數字是優先處理的價格。付費方案包含不限量的 Relaxed Queue 分鐘數,而公司表示兩種佇列「提供完全相同的分離品質」。Fast Queue 買到的只是更短的等待時間。
| 方案 | 價格 | 包含內容 | 主要限制 |
|---|---|---|---|
| LALAL.AI Starter | 免費 | 10 分鐘 Relaxed Queue | 上傳上限 200 MB |
| LALAL.AI Lite | €6.75/月,年繳 €81 | 不限量 Relaxed、90 分鐘 Fast | 沒有批次、VST 或 API;分鐘數不會累積 |
| LALAL.AI Pro | €13.50/月,年繳 €162 | 不限量 Relaxed、250 分鐘 Fast | 唯一提供 API、VST 外掛與批次處理的方案 |
| Moises | 未公開公布 | 免費方案,但每月上傳次數有限 | 定價表需登入後才能查看;宣稱提供 27 種音軌類型 |
Replicate cjwbw/demucs | 約 0.020 美元/次 | T4,通常低於 90 秒 | 版本約在 3 年前鎖定 |
| 本機 Demucs | 免費(MIT 授權) | 不限量、離線處理 | 需要自行負擔 GPU 時間與設定成本 |
Lite 方案的 90 分鐘 Fast Queue,每月大約能處理五首四音軌歌曲,之後就會落到 Relaxed Queue。如果你每週處理的不只幾首歌,按分鐘計費很快就不划算;而這正是安裝 Demucs、花一個下午完成設定開始回本的使用量門檻。
不同需求,該走哪條路
| 你的情況 | 建議方案 | 理由 |
|---|---|---|
| 偶爾分離歌曲、沒有 GPU,也不想碰終端機 | LALAL.AI Starter,之後再考慮 Lite | 先用 10 分鐘免費額度測試品質,不必立刻花錢 |
| 扒歌、以手機為主練習 | Moises | 提供 27 種音軌類型,還有速度與和弦工具;價格需登入後確認 |
| 大量處理,手上有自己的 GPU | 使用 htdemucs 執行 uvx demucs | 沒有單次成本、可不限量執行,檔案也不必離開自己的機器 |
| 一首重要歌曲的最後輸出 | htdemucs_ft,在 GPU 上使用 --shifts 2 | 以四倍計算量換取最後一點品質提升 |
| 需要吉他音軌 | 先用 htdemucs_6s,再和 UVR5 裡的 Roformer 系列模型比較 | 官方文件也承認六音軌模型會有串音 |
| 未公開或受 NDA 保護的素材 | 只用本機 Demucs | 不必上傳,採 MIT 授權,可離線處理 |
| 要做 App 後端,但沒有維運預算 | Replicate cjwbw/demucs | 約 0.020 美元/次,不必自行管理 GPU 基礎設施 |
Demucs 音軌分離 FAQ
哪個 Demucs 模型的人聲效果最好?
htdemucs_ft 是目前提供的人聲四音軌模型中表現最強的選擇,處理時間約是 htdemucs 的四倍。面對較難處理的混音,使用者回報兩階段流程效果更好:先用 Roformer 系列模型分離人聲,再用 Demucs 拆解伴奏中的其他音軌。
Demucs 能分離吉他與鋼琴嗎?
只能透過 htdemucs_6s。官方 README 在快速測試中把吉他品質形容為「尚可」,並表示鋼琴來源「效果不太好」,而且「有大量串音與瑕疵」。
執行 Demucs 一定需要 NVIDIA GPU 嗎?
不需要。CPU 可以搭配 -d cpu 使用,文件估計處理時間約為歌曲長度的 1.5 倍。Apple Silicon 使用者可以指定 -d mps。GPU 加速至少需要 3 GB VRAM,使用預設參數時約需 7 GB。
為什麼分離後的音軌重新混回去,無法還原原始混音?
Demucs 會重新縮放各音軌,以避免分離瑕疵造成 clipping,但這可能破壞音軌之間的相對音量。你可以使用 --clip-mode clamp 改用硬限制,或在處理前先降低輸入混音的音量。
Demucs 會把分離後的音軌存在哪裡?
檔案會放在 separated/MODEL_NAME/TRACK_NAME/,格式是 44.1 kHz、int16 編碼的立體聲 WAV:drums.wav、bass.wav、other.wav 與 vocals.wav。除非你另外要求輸出 MP3、FLAC、int24 或 float32。
CUDA out-of-memory 錯誤要怎麼解決?
降低 --segment(3 GB 顯示卡的文件建議下限是 8)、設定 PYTORCH_NO_CUDA_MEMORY_CACHING=1,或改用 -d cpu。另外要記住,Hybrid Transformer 模型的 segment 長度上限是 7.8 秒,因此把數值調高到超過這個上限對它們不會有任何作用。