 AIREITER
2026 年 7 月 29 日,我們把四道相同題目交給 Claude Opus 5、GPT-5.6 Sol、Terra 與 Luna。結果收到的 16 份回答全部正確。至少在這四項小型驗證裡,準確度並不足以讓你在它們之間做出取捨。
真正拉開差距的,是兩項會直接反映在帳單上的因素:Opus 5 計費了 1,642 個輸出 token,Sol 則是 480 個;而當輸入超過 272,000 個 token,GPT-5.6 會切換至更高的長上下文費率,Claude Opus 5則在完整 1M 上下文視窗內維持固定單價。以 200K 輸入、20K 輸出的請求型態來看,兩款旗艦模型的定價相差不到 7%;但輸出量提高、或跨過 272K 門檻後,差距就會擴大。因此,選擇關鍵在於你的請求結構與模型行為。
四款模型在同一組任務下實測
四個模型都收到完全相同的使用者提示,涵蓋四項可機械驗證答案的測試:修正有 bug 的 Python median 函式、計算固定字串中的字母出現次數、算出時鐘在 3:15 時呈現的 7.5 度夾角,以及重構一個刻意寫得雜亂、但行為不可改變的 JavaScript 函式。程式碼題目不是憑肉眼判斷,而是實際執行並以邊界案例驗證。
四個模型全數過關。Python 修正版本都能正確處理偶數長度的串列;字母計數與時鐘夾角題,全都答出正確的 9 和 7.5;所有重構結果也都通過行為差異比對,其中包含 falsy 欄位與 null 類別篩選條件。
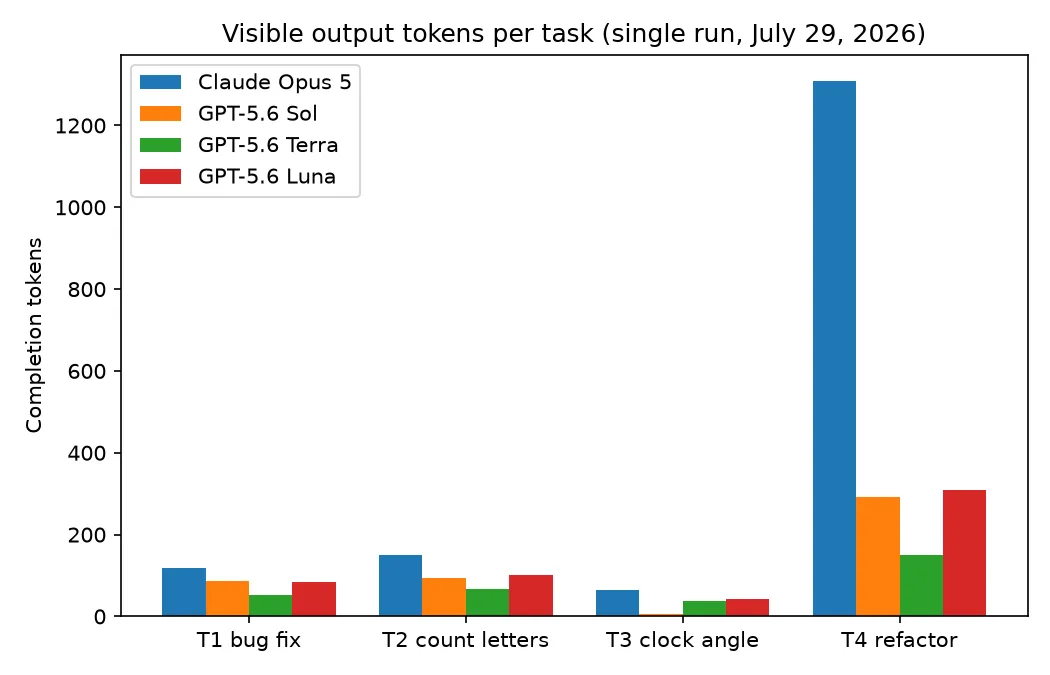
引用這些數字前,有三點限制要先說明。第一,這是每個模型、每項任務各跑一次,屬於冒煙測試而非完整 benchmark。第二,請求是經由會注入自有系統提示的 gateway 發送,因此不同請求的輸入 token 在 35 至 4,415 之間跳動,我們完全不採計這項數據。第三,兩家供應商都將隱藏的推理 token 視為輸出計費,因此本文的「輸出 token」是你付費的 token,不等於你實際讀到的文字。
雖然結果同分,仍有一項質化差異值得一提:Opus 5 交出了四者中最好的重構版本。它把原本兩個迴圈合併為單次處理、將 1.2 倍乘數抽成具名常數,還留下註解,說明為了維持原有行為而刻意保留寬鬆相等比較。Sol、Terra 與 Luna 的結果同樣正確,但都較接近原始兩迴圈寫法的直譯版本。
差別不在答對與否,而在 token 與速度
既然 16 次執行的正確性完全一致,接下來要比較的就是每份答案的成本。Opus 5 完成四項任務共花 32.4 秒,計費 1,642 個 completion token。Sol 花了 19.7 秒、480 個 token;Terra 為 11.7 秒、308 個;Luna 則是 15.3 秒、537 個。
| 單次執行,2026 年 7 月 29 日 | 正確 | 輸出 token | 總耗時 | 僅輸出成本 |
|---|---|---|---|---|
| Claude Opus 5 | 4/4 | 1,642 | 32.4s | $0.0411 |
| GPT-5.6 Sol | 4/4 | 480 | 19.7s | $0.0144 |
| GPT-5.6 Terra | 4/4 | 308 | 11.7s | $0.0046 |
| GPT-5.6 Luna | 4/4 | 537 | 15.3s | $0.0032 |
差距來自推理量,而不是最終回答的篇幅。Opus 5 的重構題,最終答案只有 492 bytes,卻計費了 1,308 個 token;回答「7.5」時,它花了 64 個 token,Sol 則只用了 7 個。Anthropic 文件指出,Opus 5 在 API 中預設採用 high effort,因此部分差異來自預設設定,而非模型不可改變的特性;我們量測的是預設行為,不是它的最低用量。
社群數據也呈現相同趨勢。我們在 7 月 29 日查詢時,Google 搜尋此主題的第一個結果是 r/Anthropic 的圖表貼文:兩者的程式能力分數幾乎打平,但 Opus 花得更久、消耗的 token 也明顯更多。一位 r/ClaudeCode 使用者的說法更不客氣:
GPT 5.6 Sol 就是直接去做你要它做的事。Opus 5 會先寫出 12 卷本的《戰爭與和平》,然後才去做你要它做的事。
不過,調整 effort 設定可能會翻轉成本結論。一位閱讀 Artificial Analysis 數據的 Hacker News 留言者指出,Opus 5 在 high effort 下,每次 intelligence-index 執行的成本約為 $1.06;Sol 設為 max 時則為 $1.04。當兩個模型都全力推理時,成本幾乎持平。
GPT-5.6 不只一款:Sol、Terra、Luna 的定位
GPT-5.6 並不是單一模型。OpenAI 提供三個 SKU,而未加後綴的 gpt-5.6,文件明確標示為 gpt-5.6-sol 的別名,也就是三者中最昂貴的版本。若設定檔只寫 gpt-5.6,會按該系列的最高費率計費;在做成本比較前,這點值得先確認。
OpenAI 的模型文件將 Sol 定位為「適合複雜專業工作的 frontier model」、Terra 為「在智慧與成本之間取得平衡」的級距,Luna 則「針對成本敏感型工作負載最佳化」。三者都提供 1.05M-token 上下文視窗、128K 最大輸出、2026 年 2 月 16 日知識截止日期,以及從 none 到 max 的六種可選推理強度。
| 規格,於 2026 年 7 月 29 日確認 | Claude Opus 5 | GPT-5.6(三款皆同) |
|---|---|---|
| 上下文視窗 | 1M tokens | 1.05M tokens |
| 最大輸出 | 128K(Batch API beta 可達 300K) | 128K |
| 可靠知識截止日期 | 2026 年 5 月 | 2026 年 2 月 16 日 |
| 推理控制 | Adaptive thinking,effort 預設為 high | none / low / medium / high / xhigh / max |
| API ID | claude-opus-5 | gpt-5.6-sol / -terra / -luna |
其中兩項規格會直接影響選型。Opus 5 的知識截止日期是 2026 年 5 月,比整個 GPT-5.6 系列新約三個月;凡是涉及 2026 年春季發布內容的工作,這項差異就很重要。兩者的推理控制也不只是選項數量不同:GPT-5.6 可透過 none 完全關閉推理,Opus 5 則會自適應管理自己的思考預算,並額外提供 effort 等級。
價格分水嶺:固定 1M 視窗對上 272K 級距
兩家供應商公布的 token 單價都很清楚,而且在 272K 輸入以下相當接近:兩款旗艦模型的輸入都是每百萬 token $5;Opus 5 的輸出為 $25,Sol 為 $30;快取輸入皆為 $0.50;Batch 也都提供 50% 折扣。依此計價,一筆 200K 輸入、20K 輸出的請求,Opus 5 成本為 $1.50,Sol 為 $1.60。
| 每 1M tokens,2026 年 7 月 29 日牌價 | 輸入 | 快取輸入 | 輸出 | Batch |
|---|---|---|---|---|
| Claude Opus 5 | $5.00 | $0.50 | $25.00 | $2.50 / $12.50 |
| GPT-5.6 Sol | $5.00 | $0.50 | $30.00 | $2.50 / $15.00 |
| GPT-5.6 Terra | $2.50 | $0.25 | $15.00 | $1.25 / $7.50 |
| GPT-5.6 Luna | $1.00 | $0.10 | $6.00 | $0.50 / $3.00 |
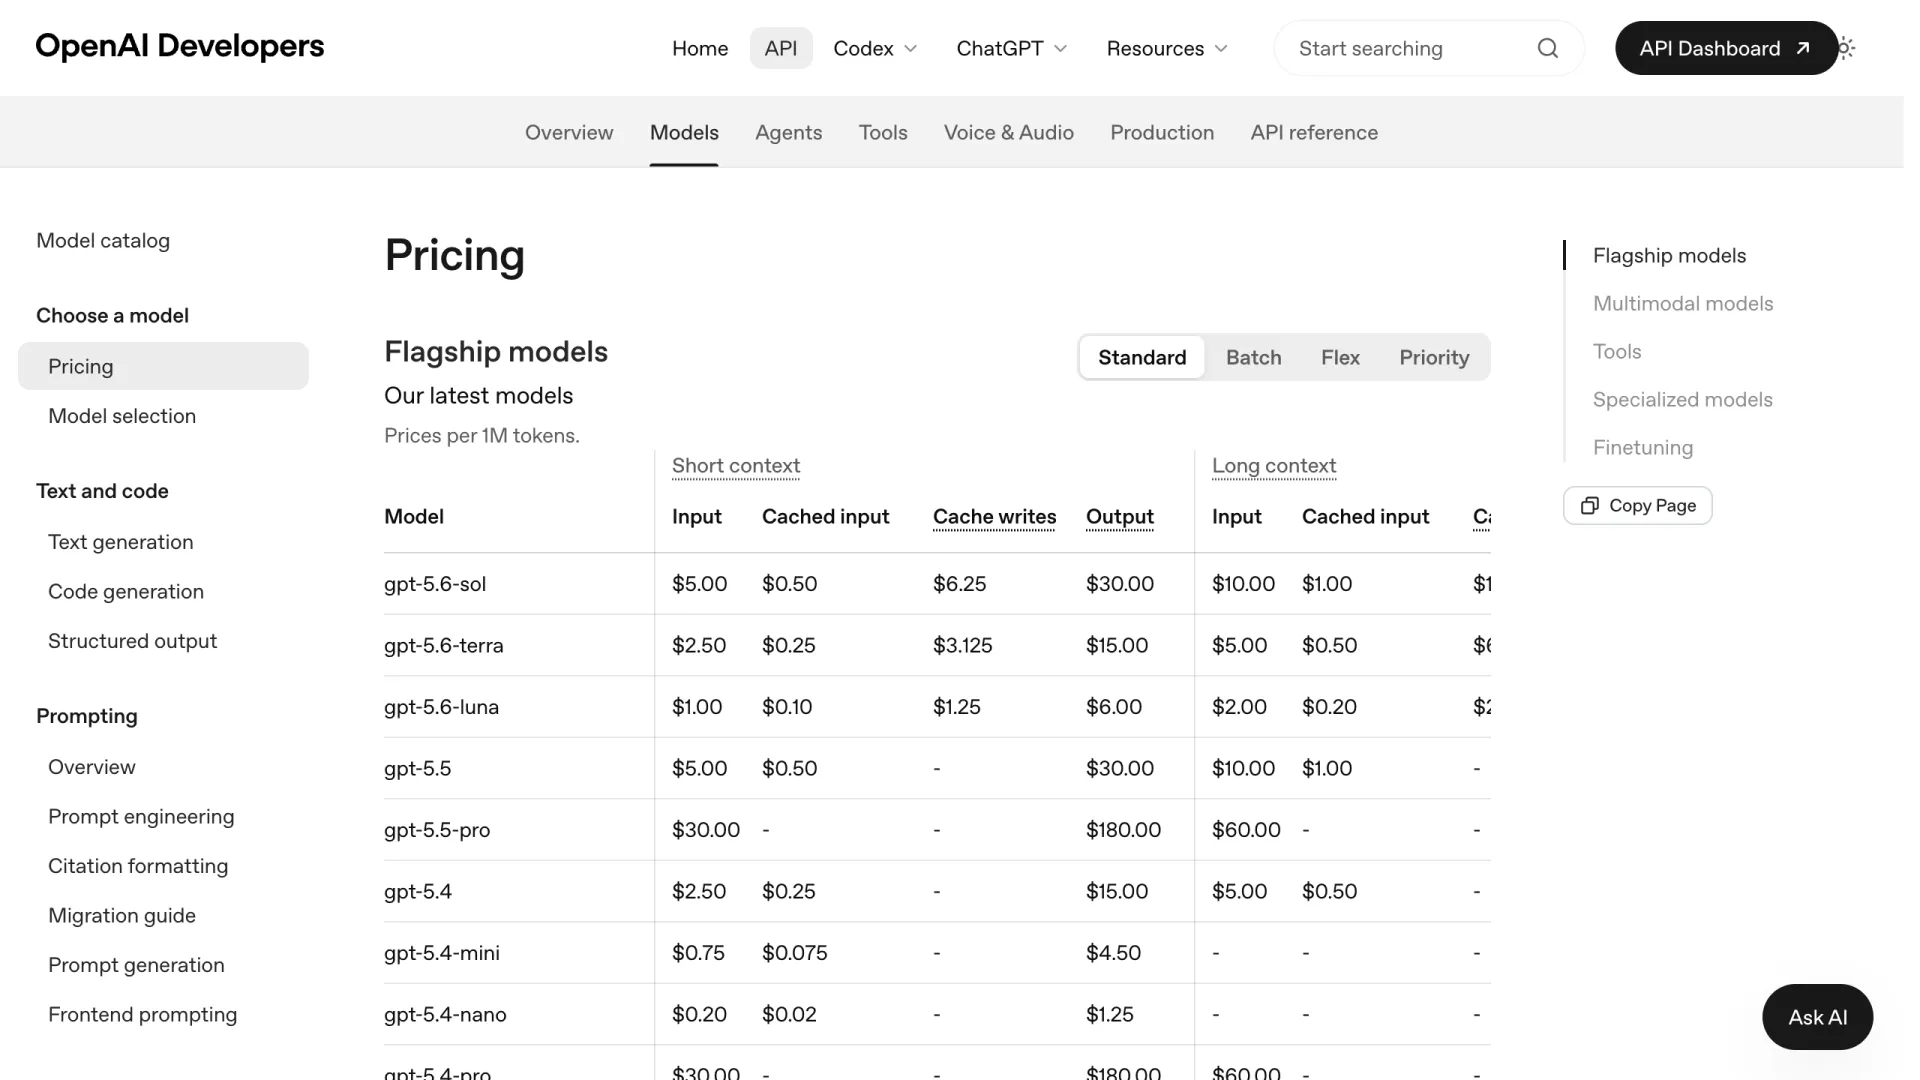
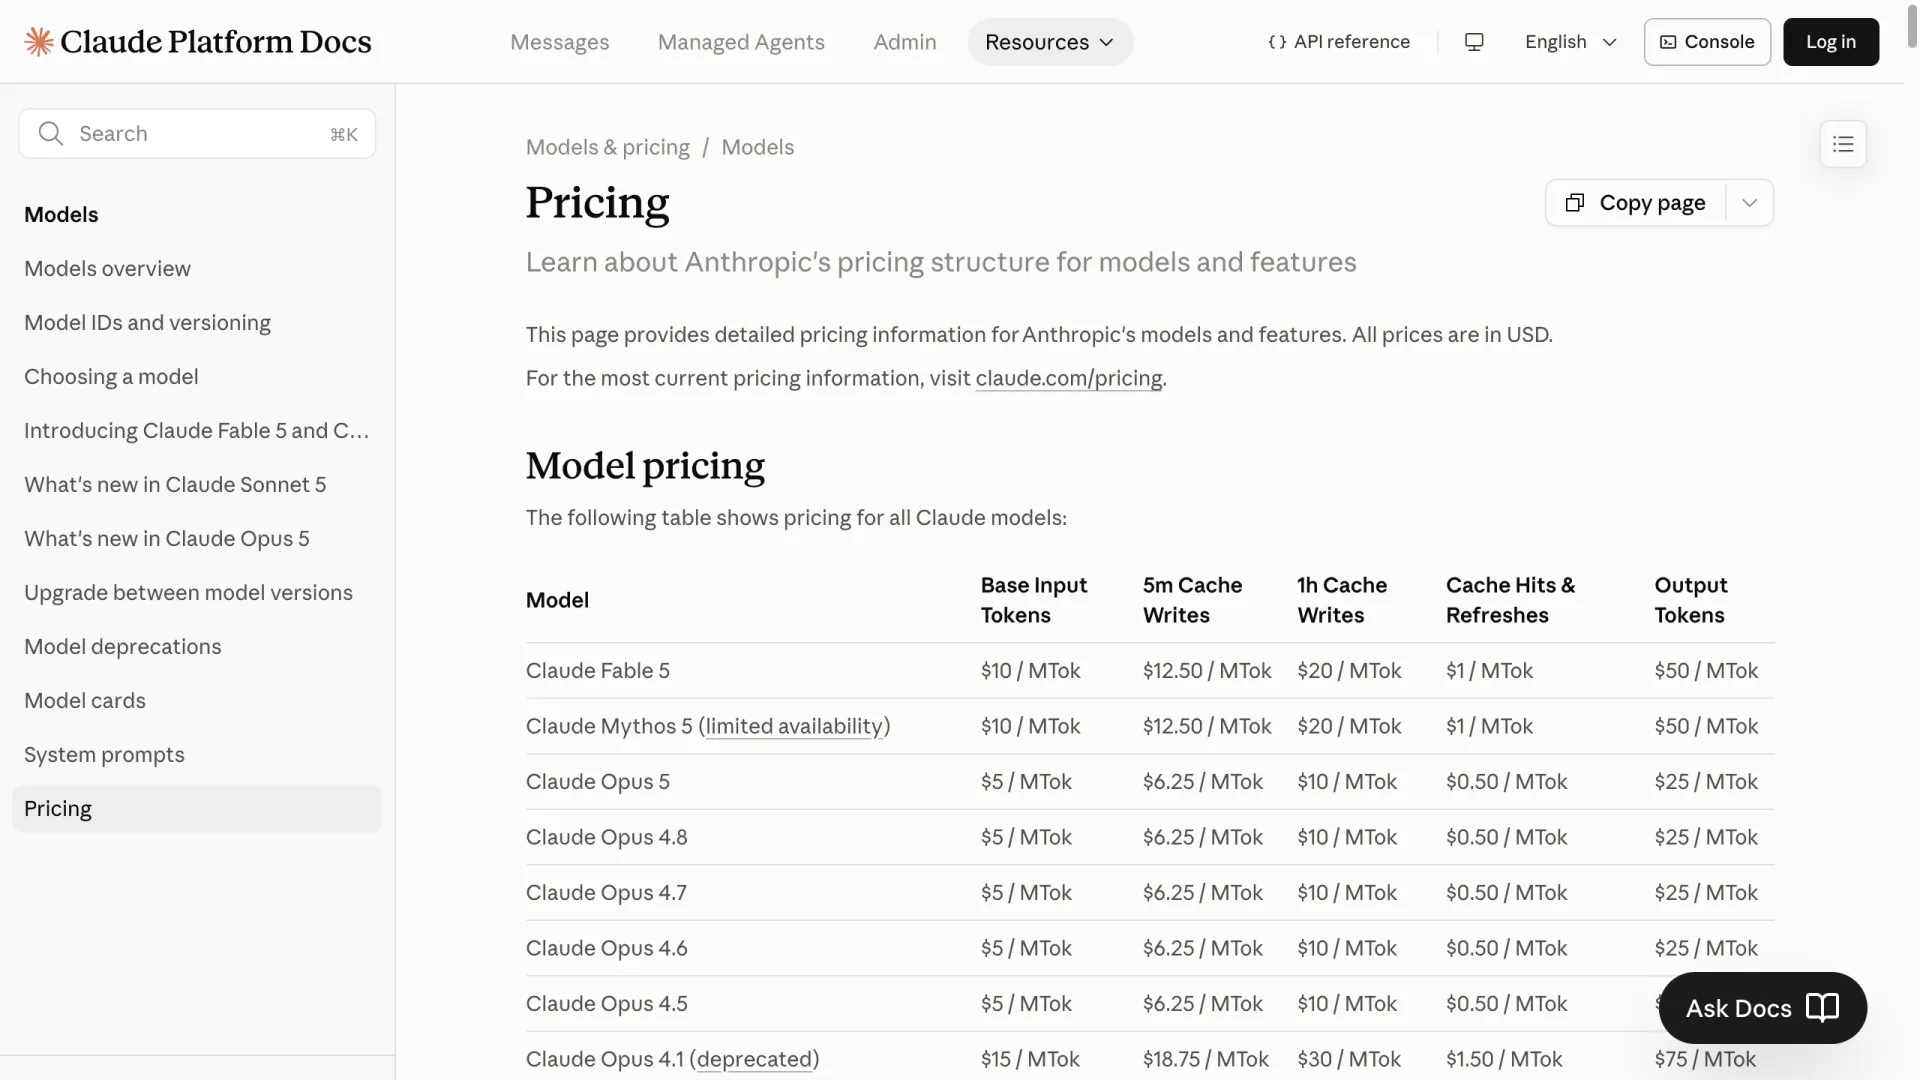
結構性的差異就在 272K 輸入 token 這個門檻。OpenAI 定價頁將每款 GPT-5.6 的費率拆成短上下文與長上下文兩欄:輸入超過 272K 後,輸入價格變為 2 倍、輸出變為 1.5 倍,Sol 因此升至 $10 與 $45。Anthropic 的定價文件則用一句話說明相反的設計:「900k-token request 與 9k-token request 的每 token 計費相同。」
換算成金額,在每個情境都輸出 20K token 的前提下:300K 輸入時,Opus 5 為 $2.00,Sol 為 $3.90;500K 時是 $3.00 對 $5.90;900K 時則為 $5.00 對 $9.90。跨過這個級距後,同樣請求結構下,Opus 5 的價格約為 Sol 的一半。
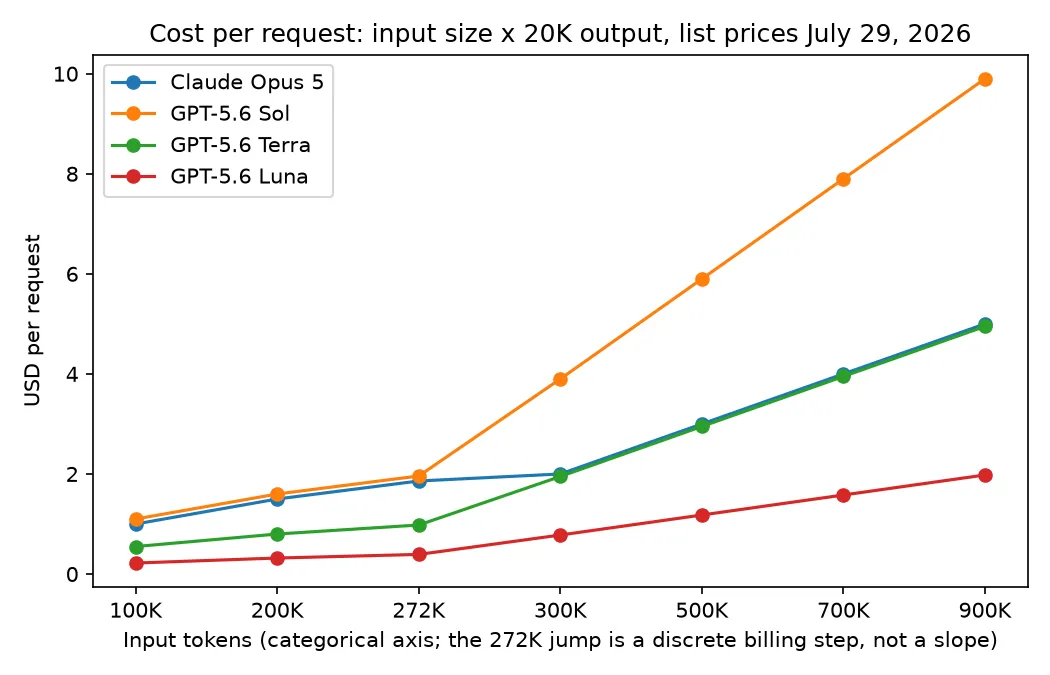
不過,圖表裡有一個不利於 Anthropic 完勝的意外結果。超過 272K 後,Terra 加倍後的輸入費率是 $5,正好等於 Opus 5;其長上下文輸出費率 $22.50 也低於 Opus 5 的 $25。若輸出為 20K token,Terra 在 300K、500K、700K 與 900K 輸入時,每次請求都固定比 Opus 5 少 $0.05。這 $0.05 是隨輸出量而非輸入量縮放:每百萬輸出 token 的差額為 $2.50。
做預算規劃時,還有三個註記。Anthropic 為 Opus 5 提供研究預覽中的 fast mode,價格為輸入 $10、輸出 $50;OpenAI 也有 priority 層級,但僅適用短上下文,費率為標準價格的 2 倍。美國區域資料落地在兩家供應商都約增加 10%。此外,依Anthropic 自身說明,Claude 目前的 tokenizer 處理相同文字時,產生的 token 約比 4.7 之前的模型多 30%;因此,最誠實的做法是在套用費率前,先用兩家的 tokenizer 跑一次具代表性的提示。
依工作負載選模型
正確性打平後,路由策略就取決於請求型態與工作方式。r/ClaudeCode 的開發者會將 Sol 設為 high effort,作為審查與 QA agent,理由是它夠徹底、也擅長搭配瀏覽器工作;另一些 r/codex 使用者則把大部分工作分派給採用 medium reasoning 的低價 GPT 級距,並認為那是成本效益最好的選擇。
| 請求型態 | 建議呼叫 | 原因 |
|---|---|---|
| 輸入低於 272K、輸出密集的 agent 迴圈 | Claude Opus 5 | 輸出 $25 對 $30;本次測試的重構判斷最佳 |
| 低於 272K、重視延遲或高請求量 | GPT-5.6 Terra | 我們測到最快、也最便宜的過關模型 |
| 輸入高於 272K | Claude Opus 5 或 Terra | Sol 的長上下文費率翻倍;Terra 比 Opus 5 固定低 $0.05 |
| 審查、QA 與瀏覽器驅動的驗證 | GPT-5.6 Sol | 六種 effort 等級可調整審查深度;應以自家 QA 集驗證 |
| 一次性的分類與擷取 | GPT-5.6 Luna | $1/$6,且四項測試全部通過 |
並非所有人都認為 Sol 適合擔任 QA 主力。一篇 r/codex 討論串認為 Sol 相較 GPT-5.5 是退步,同時肯定 Opus 5 每份計畫能完成更多任務。預設值的測試成本很低:四個模型都在 AIReiter 目錄中(Opus 5、Sol),你可以並排重跑自己的任務。
若這篇比較只帶走一個數字,那就是 272,000 個輸入 token。低於此門檻,請依行為、延遲與 $5 的輸出費率差額來選;高於此門檻,對上 Sol 時價格優勢在 Anthropic 一方,但 Terra 仍比 Opus 5 低 $0.05,而 Luna 則遠低於兩者。
常見問題
gpt-5.6 和 GPT-5.6 Sol 是同一個模型嗎?
是。OpenAI 的模型文件將未加後綴的 gpt-5.6 列為解析至 gpt-5.6-sol 的別名,因此會依 Sol 的費率計費:輸入低於 272K 時,每百萬 token 輸入 $5、輸出 $30;高於該門檻則為 $10 與 $45。
Claude Opus 5 的長上下文請求會更貴嗎?
不會。在一般 API 中,Anthropic 對完整 1M 視窗採用標準費率,並表示 900K-token 請求與 9K-token 請求的每 token 成本相同。只有選用 fast mode 才需支付溢價,輸入 $10、輸出 $50。
Claude Opus 5 與 GPT-5.6,哪個比較便宜?
要看級距。輸入低於 272K 時,Opus 5 的每百萬輸出 token 比 Sol 少 $5,其他費率則相同;Terra 和 Luna 都遠比兩者便宜。超過 272K 後,Opus 5 每次請求的成本約為 Sol 的一半,而 Terra 仍略低於 Opus 5。
Claude Opus 5 寫程式比 GPT-5.6 好嗎?
在我們 7 月 29 日的測試中,兩者都正確完成修正、計數與重構;當天 Google 對此查詢排名第一的 r/Anthropic 圖表貼文,也顯示兩者的程式分數幾乎持平。Opus 5 展現出最好的重構判斷,但在預設設定下,輸出 token 計費量是 Sol 的 3.4 倍,因此程式開發時的選擇更像是成本與回答冗長度的取捨。
Opus 5 與 GPT-5.6 的知識截止日期是什麼?
Anthropic 將 Claude Opus 5 的可靠知識截止日期訂為 2026 年 5 月。三款 GPT-5.6 模型則都採用 2026 年 2 月 16 日,約早三個月。