 AIREITER
Ağustos 2026 itibarıyla Qwen 3.8 mi, Kimi K3 mü sorusunun tek bir yanıtı yok. Her iki ailenin ağırlıkları indirilebilir durumda, amiral gemisi modeller de genel kullanıma açıldı; fakat tercih doğrudan dağıtım senaryonuza bağlı. Kimi K3, doğrulanmış ajan tabanlı kodlama performansında en güçlü kayda sahip. Qwen 3.8 Max token maliyetinde öne çıkıyor. Apache-2.0 lisanslı Qwen 27B ise tek bir tüketici GPU'sunda çalışıyor. Kimi tarafındaki önemli ayrım şu: “açık” amiral gemisinin bildirilen checkpoint boyutu 1,56 TB. Yani ağırlıkların açık olması, pratikte kolayca self-host edilebileceği anlamına gelmiyor.
Qwen 3.8 ve Kimi K3 ailesinde hangi modeller çıktı?
Kimi K3, Moonshot AI tarafından 16 Temmuz 2026'da tek bir amiral gemisi olarak yayınlandı. Model; toplam 2,8 trilyon parametreye, token başına 104B aktif parametreye, Kimi Delta Attention ve Gated MLA mimarisine, 1.048.576 token bağlam penceresine ve yerleşik görüntü desteğine sahip bir MoE. Ağırlıklar ve teknik rapor 27 Temmuz'da, özel Kimi K3 License ile geldi. Emergent karşılaştırmasının özetlediği koşullar, büyük ölçekli ticari yeniden satıcılar ile aylık 100 milyon kullanıcıyı aşan ürünler için ek şartlar içeriyor.
Alibaba'nın yanıtı tek bir model değil, bir model ailesiydi. Qwen 3.8 Max 19 Temmuz'da ön izlemeye açıldı; 3 Ağustos'ta QwenCloud üzerinde genel kullanıma ulaştı. Model 2,4T toplam / yaklaşık 95B aktif parametreye sahip. Ağırlıkları da yaklaşık 12 Ağustos'ta Hugging Face'e Qwen/Qwen3.8-2.4T-A95B adıyla, özel qwen3.8-max lisansı altında yüklendi. Birkaç gün sonra ise Qwen/Qwen3.8-27B yayınlandı: Apache-2.0 lisanslı, yoğun yapıda 27B parametreli bir görüntü-dil modeli. Yerleşik olarak 262K bağlam sunuyor; YaRN ile 1M'e genişletilebiliyor. Yotta Labs bunu 13–14 Ağustos tarihlerinde kayıt altına aldı.
| Kimi K3 | Qwen 3.8 Max | Qwen3.8-27B | |
|---|---|---|---|
| Toplam / aktif parametre | 2,8T / 104B | 2,4T / ~95B | 27B yoğun |
| Bağlam | 1.048.576 | 1M (991,8K maksimum girdi) | 262K yerleşik, YaRN ile 1M |
| Lisans | Kimi K3 License (özel) | Özel qwen3.8-max lisansı | Apache-2.0 |
| Ağırlıkların yayınlandığı tarih | 27 Temmuz 2026 | ~12 Ağustos 2026 | ~13–14 Ağustos 2026 |
| Görüntü girdisi | Metin + görüntü (resmî) | API üzerinden metin, görüntü, video | Metin, görüntü, video |
Moonshot'ın, K3 yayınlandıktan sonraki 48 saat içinde GPU kapasitesini aşan talep nedeniyle yeni tüketici aboneliklerini duraklattığı bildirildi. Ürününüzü tek bir sağlayıcı üzerine kurmayı düşünüyorsanız bu ayrıntıyı hesaba katmakta fayda var.
Benchmark sonuçları: Kimin ölçtüğüne göre ayırmak şart
İki üretici de yüksek benchmark skorları yayımlıyor, ancak tablolardaki test düzenekleri aynı değil. Kimi'nin model kartı, rakip skorların farklı ajan harness'lerinden geldiğini; bazı satırlarda H100 yerine H20 donanımı kullanıldığını açıkça belirtiyor. Bu yüzden aşağıdaki ortak satırlar bağımsız olarak denetlenmiş veriler değil, üreticilerin kendi beyanları olarak okunmalı.
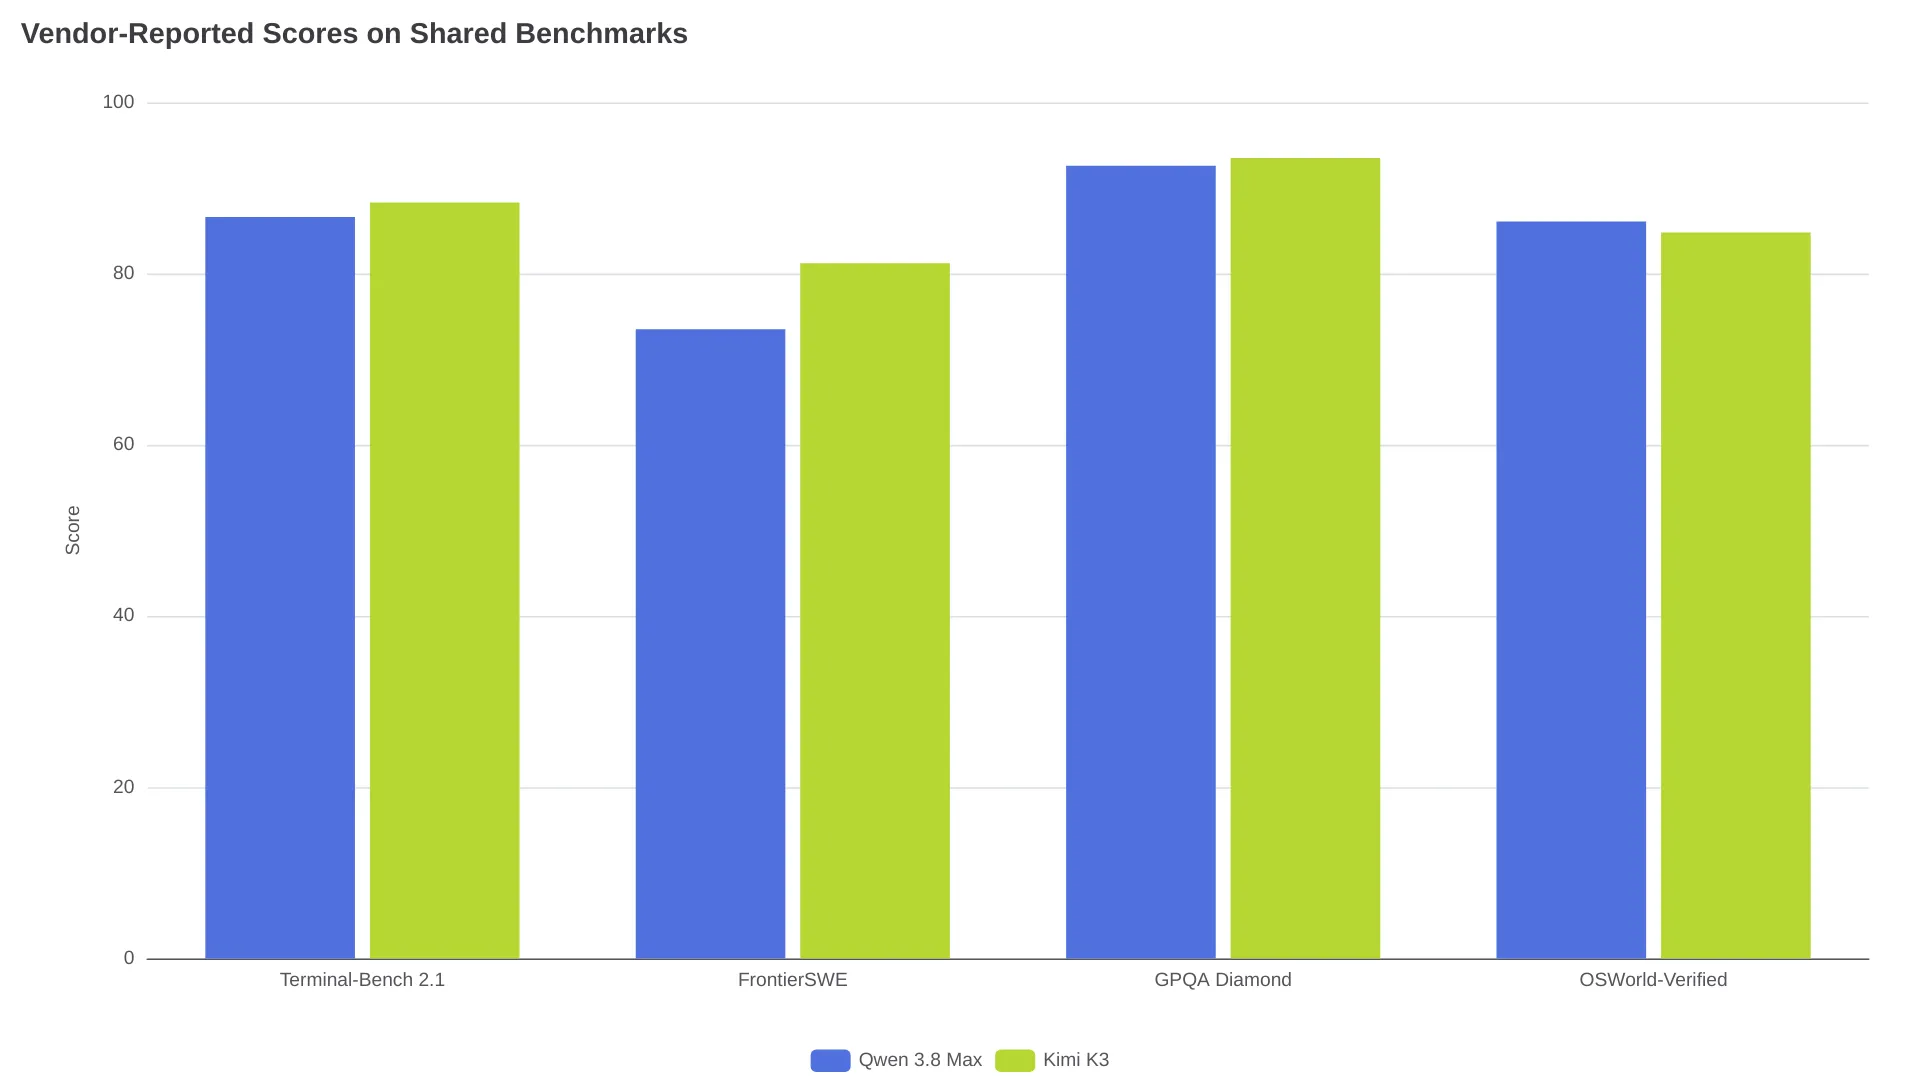
Bu ortak satırlarda Kimi K3, ajan tabanlı kodlama için kritik alanlarda önde. Model kartına göre FrontierSWE skoru 81,2'ye 73,5; Terminal-Bench 2.1 skoru ise 88,3'e 86,6. Qwen tarafındaki rakamlar için 2,4T model kartına bakılabilir. Qwen'ın lansman materyalleri, K3 kartındaki 84,8'e karşı OSWorld-Verified 86,1 iddiasında bulunuyor. Qwen kartında ayrıca PaperBench 93,0, IFBench 82,8 ve SWE-bench Pro 67,7 gibi tekil güçlü sonuçlar var. K3 ise Qwen'ın raporlamadığı satırlarda SWE-Marathon 42,0, BrowseComp 91,2 ve MCPMark-Verified 94,5 paylaşıyor.
Bağımsız sonuçlarda ise şimdilik Kimi K3 belirgin biçimde önde. Emergent takibine göre Kimi K3, çıkışında Artificial Analysis Intelligence Index'te 57 aldı; endeksin güncel sürümünde 60'a ulaştı ve Claude Fable 5 ile GPT-5.6 Sol'un arkasında sıralandı. Orcarouter karşılaştırması da Frontend Code Arena'da 1.679 Elo ile #1 derecesini ekliyor. Qwen 3.8 Max çıkışında bağımsız olarak endekslenmedi. cheapestinference.com üzerindeki takipçi, Artificial Analysis endeks değeri olarak 53 bildirdi; topluluk paylaşımlarında geçen 56'ya yükseltme iddiası ise doğrulanmış değil.
Aynı görev üzerinde yapılan tek doğrudan karşılaştırma, TrilogyAI'ın StackPerf mimari analizi. Orcarouter tarafından belgelenen bu çalışmada K3, ön izleme endpoint'indeki Qwen'ın 80/100 skoruna karşı 83/100 aldı. Qwen 354 repository alıntısına ulaşırken Kimi 274'te kaldı; gateway isteği sayısı Qwen'de 22, Kimi'de 53 oldu. Başarısız araç çağrısı ise Qwen'de sıfır, Kimi'de iki olarak kaydedildi.
Ortak tablolarda atlanan satıra da bakalım: Qwen'ın kendi model kartında, 27B sürümü OSWorld-Verified'da K3'ün 84,8 puanına karşı 84,3 alıyor. Yoğun yapıda 27B parametreli bir model, bilgisayar kullanımı testinde 2,8T'lik bir amiral gemisinin yalnızca yarım puan gerisinde. Kodlama performansı K3 seviyesinde değil; Terminal-Bench'te 73,0'a karşı 88,3 alıyor. Buna rağmen LiveCodeBench v6'da 90,3, SWE-bench Pro'da 61,7 puanla ciddi bir iş modeli olduğunu gösteriyor. r/AISEOInsider'daki uygulamalı karşılaştırma başlığı da verilerle aynı yönde bir sonuç sunuyor: Qwen tek seferlik geliştirmelerde daha sık kazanırken, bağlam ve revizyon derinliği arttıkça Kimi öne geçiyor.
API maliyeti: $15'lık çıktı fiyatı ve reasoning vergisi
Liste fiyatları açıkça Qwen tarafını işaret ediyor. Gerçek harcamada fark daha da belirginleşiyor; çünkü her iki model de varsayılan olarak reasoning kullanıyor. K3'te reasoning_effort: max, Qwen'da ise xhigh devrede ve reasoning token'ları çıktı token'ı olarak ücretlendiriliyor.
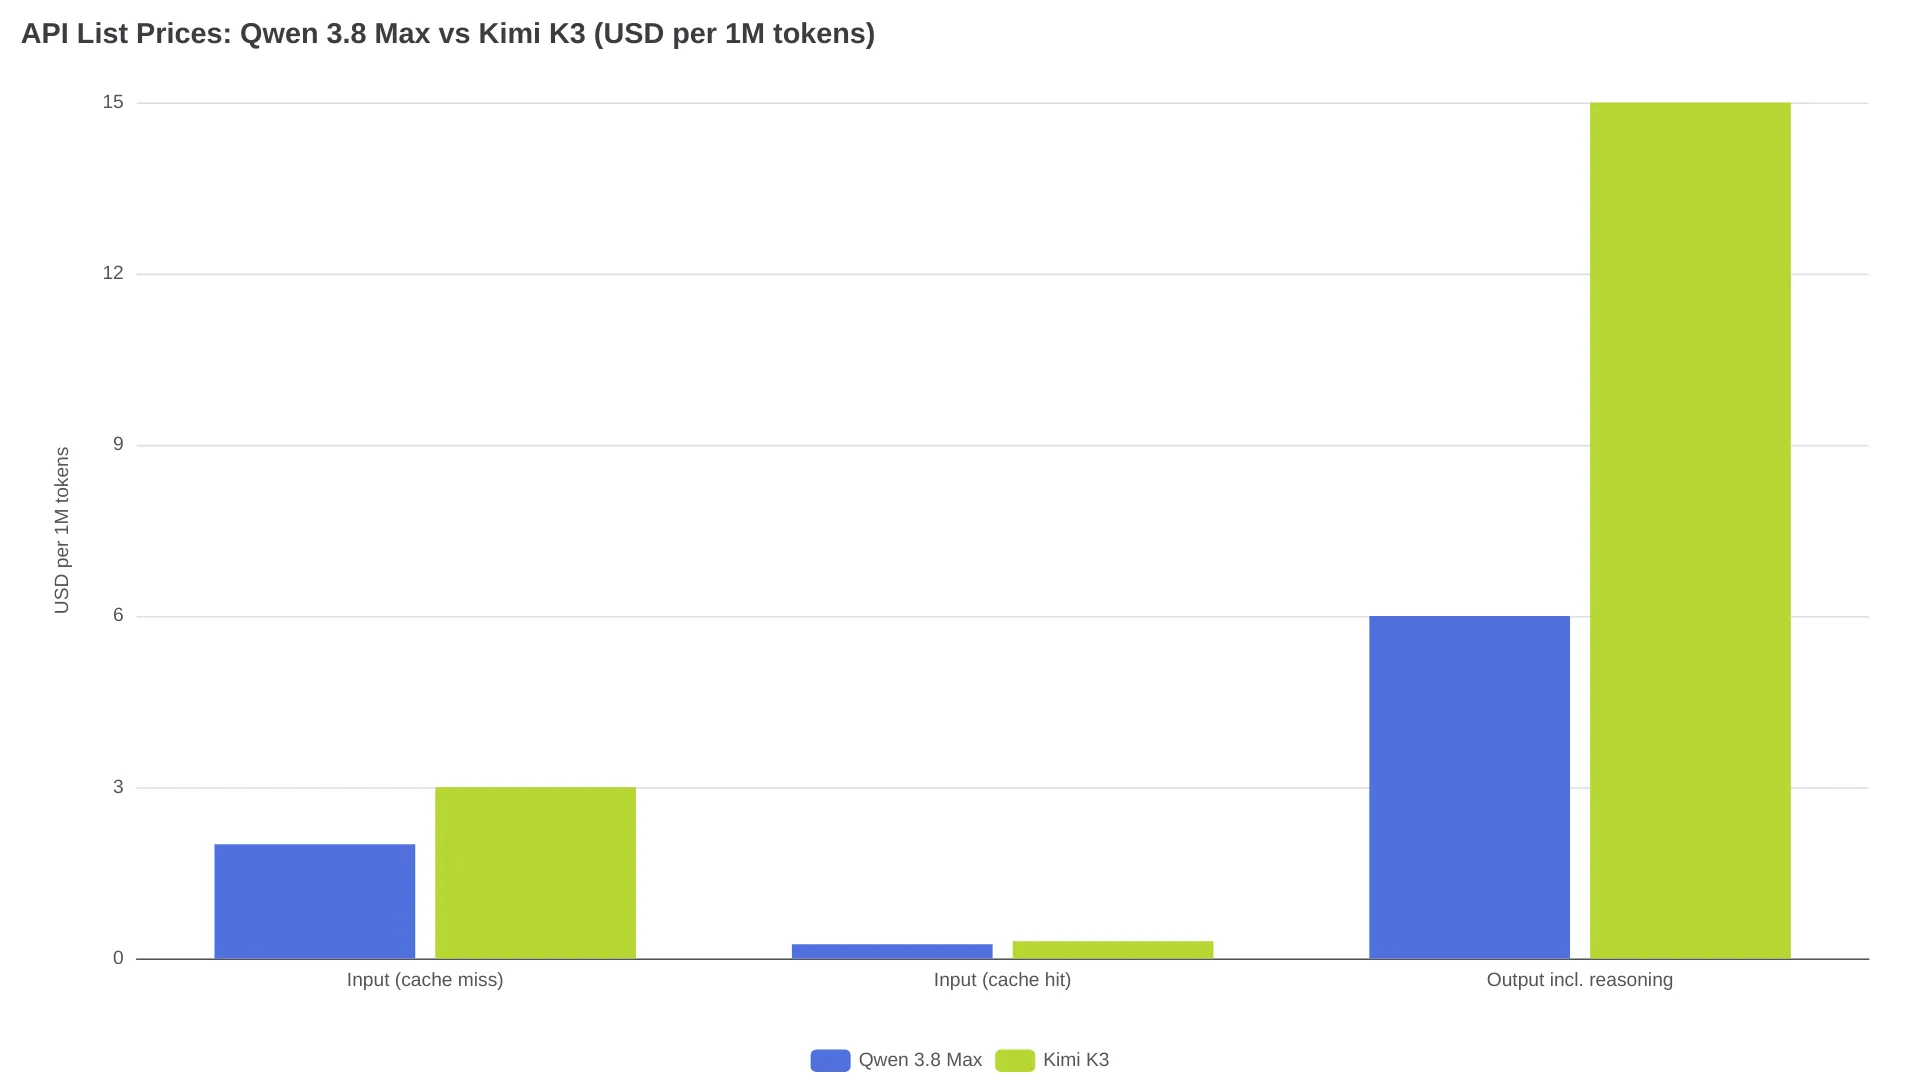
| 1M token başına | Qwen 3.8 Max (QwenCloud) | Kimi K3 (Moonshot) |
|---|---|---|
| Girdi (cache miss) | $2.00 | $3.00 |
| Girdi (cache hit) | $0.25 | $0.30 |
| Çıktı, reasoning dahil | $6.00 | $15.00 |
| Açık cache oluşturma / okuma | $2.50 / $0.17 | — |
Ağustos 2026 liste fiyatlarıyla iki örnek oturum:
| Oturum | Qwen 3.8 Max | Kimi K3 | Fark |
|---|---|---|---|
| Ajan tabanlı kodlama: 500K girdi (%60 cache), 40K çıktı | $0.72 | $1.29 | 1.8× |
| Yeni bağlamlı doküman hattı: 2M girdi, 100K çıktı | $4.60 | $7.50 | 1.6× |
Bu hesap basit bir yönlendirme kuralı veriyor: Bir görevi K3'e ancak kendi iş yükünüzdeki kabul oranı Qwen'ınkini yaklaşık 1,8× token maliyeti farkından daha fazla aşıyorsa gönderin. Moonshot'ın kendisi daha ekonomik alternatifi de sunuyor: 256K bağlamda Kimi K2.7 Code, $0.95 girdi / $4.00 çıktı fiyatına sahip. Dolayısıyla Kimi ailesindeki en ucuz kodlama rotası K3 değil. Bugün K3 yönlendirmesi yapıyorsanız, API endpoint'i burada Moonshot'ın yayımladığı fiyatlarla listeleniyor. İki tarafın ayrıntılı maliyet yapısı ise Qwen3.8-Max fiyatlandırma analizinde ve Kimi K3 fiyatlandırma rehberinde yer alıyor.
Self-hosting farkı: 1,56 TB veya tek RTX 4090
Açık ağırlık meselesinde iki model arasındaki fark yaklaşık iki büyüklük mertebesine ulaşıyor.
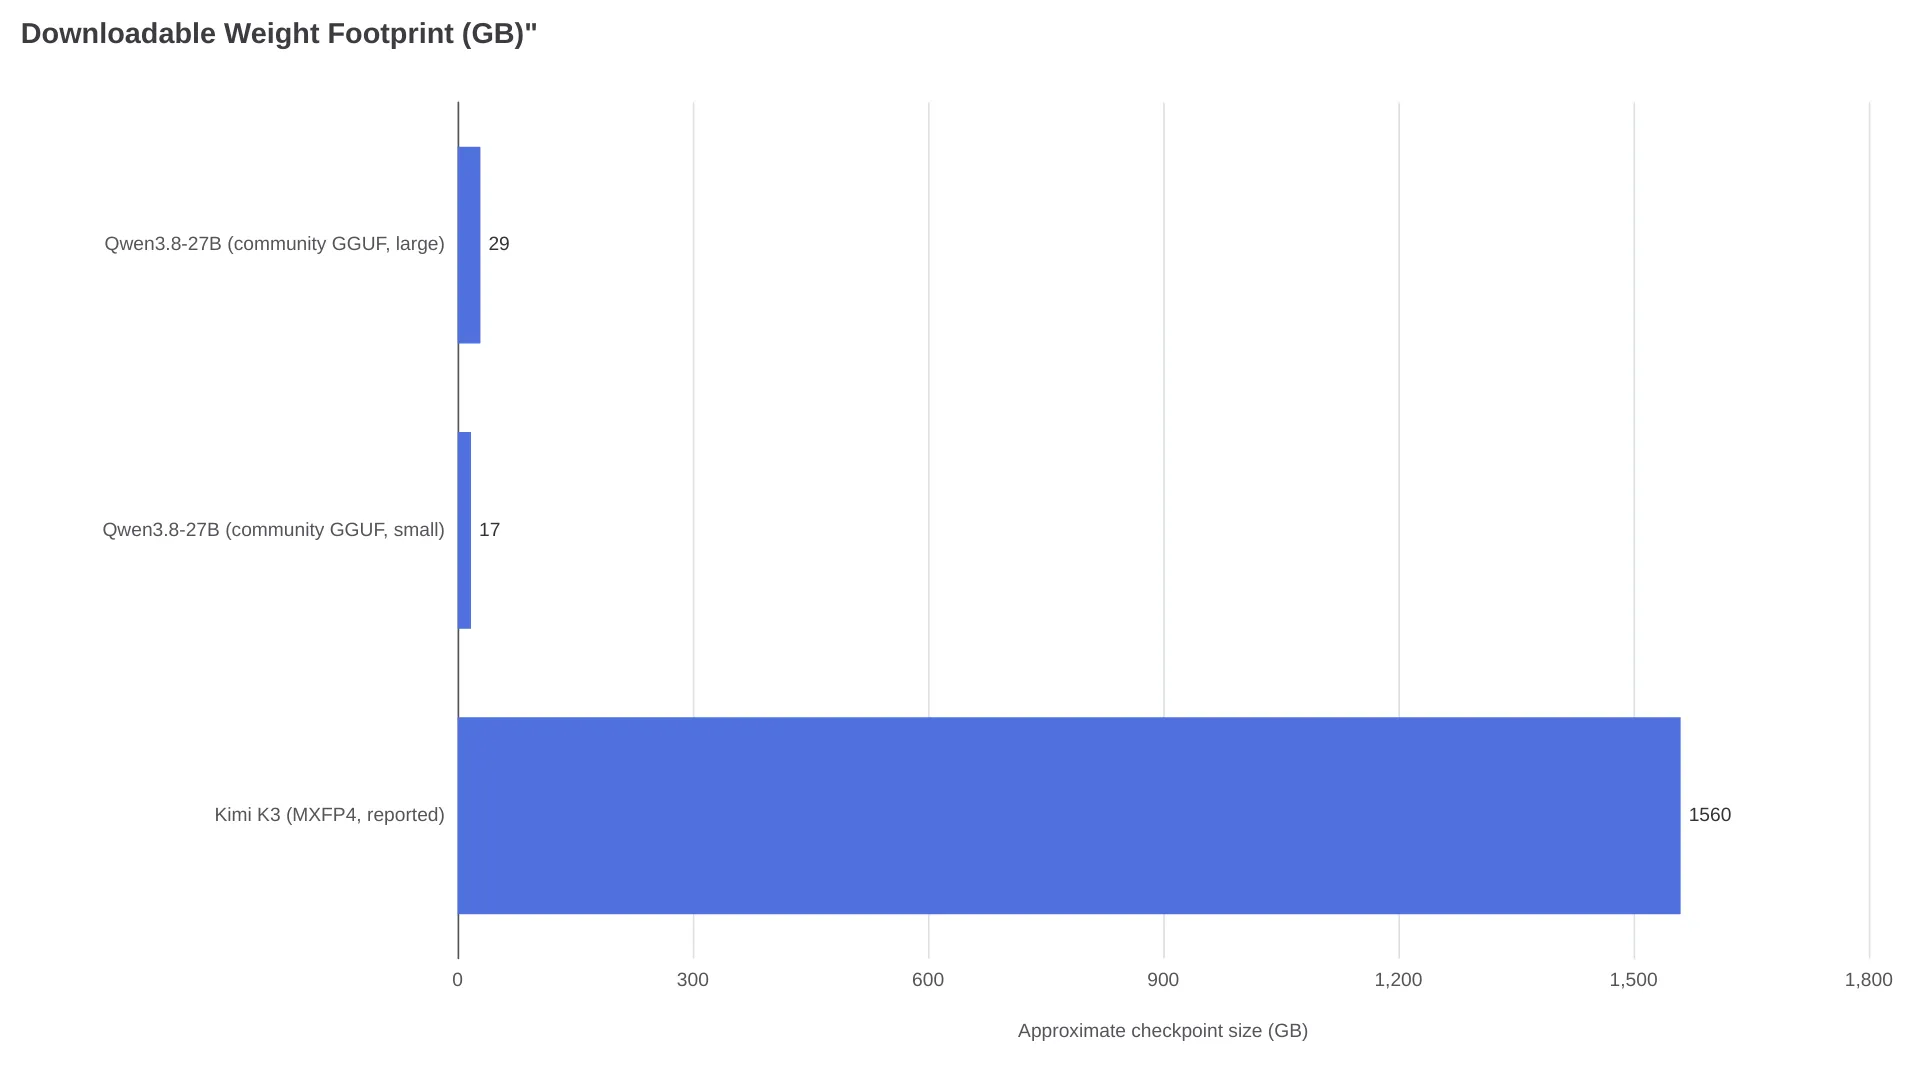
K3, quantization-aware MXFP4 ağırlıklarla geliyor (model kartı). Ancak 1,56 TB olarak bildirilen checkpoint, bir küme projesi demek. Aynı kaynak, vLLM'in 64 veya daha fazla hızlandırıcı üzerinde çalıştırılmasını öneriyor. Daha tek token sunmadan önce dahi kiralanabilir ama gerçek bir altyapı maliyetiyle karşı karşıyasınız; lisansın büyük ölçekli kullanım koşulları da buna ekleniyor.
27B'nin hikâyesi tam tersi. Topluluğun GGUF derlemeleri yaklaşık 8,5 GB ile 28,9 GB arasında değişiyor. Unsloth'un dinamik GGUF ve NVFP4 derlemeleri yaklaşık 17 GB minimum bellek gerektiriyor. Sunucu dağıtımı için resmî FP8 varyantı da mevcut. Yani insanların zaten sahip olduğu donanımlarda çalışabiliyor:
"Qwen3.8-27B, TEK bir RTX 4090 üzerinde 160K bağlamda — 47–57 tok/s, tam GPU offload" — r/Qwen_AI dağıtım paylaşımı
Max ağırlıkları bu ikisinin ortasında konumlanıyor. Qwen3.8-2.4T-A95B ve FP8 kardeşi, özel qwen3.8-max lisansı altında indirilebiliyor. Ancak açık artefakt yalnızca metin destekliyor ve thinking kapatılamıyor. Görüntü girdisi, non-thinking modu ve varsayılan 1M bağlam; checkpoint'te değil, QwenCloud API katmanında bulunuyor. 27B'nin her quant seviyesinde neleri yapabildiği ve yapamadığı için Qwen3.8-27B saha rehberinde çalışma zamanı ve VRAM tabloları var. K3 ağırlık sürümünün ayrıntılarıysa Kimi K3 açık ağırlık incelemesinde yer alıyor.
Ajan projelerinde sonucu belirleyen entegrasyon ayrıntıları
Model kartı düzeyindeki üç davranış, bunlarla production ortamında ilk kez karşılaşırsanız size bir gün hata ayıklatma potansiyeline sahip.
| Model | Davranış / sınır | Uygulama sonucu |
|---|---|---|
| Kimi K3 | Thinking her zaman açık; çok turlu ve araç kullanımlı istemciler, reasoning_content ile tool_calls dahil önceki asistan mesajının tamamını yeniden göndermeli (kart) | Reasoning izini çıkarırsanız ajan döngüleri zayıflar; saklarsanız maliyet döngü uzunluğuyla büyür |
| Qwen3.8-27B | preserve_thinking varsayılan olarak açık; reasoning_effort medium/low seviyesine indirilebiliyor; 262K üzerindeki YaRN statik ölçekleme kullanıyor (kart) | İstek bazında kapatma destekleniyor; kart, daha düşük eforun her zaman uçtan uca süreyi azaltmadığı konusunda uyarıyor çünkü yeniden denemeler tasarrufu tüketebiliyor; YaRN'i yalnızca uzun işler için açın |
| Qwen 3.8 Max ve K3 limitleri | Max: 991,8K girdi / 131,07K çıktı (QwenCloud); K3: 1.048.576 girdi / 131K varsayılan çıktı, 1M'e doğru yükseliyor | İki modeldeki “1M bağlam” ifadesi de 1M kullanışlı çıktı garantisi vermez; üçüncü taraf needle testinde 248K'da 18/18 bilgi bulundu, bunun ötesi test edilmedi |
SSS
Kodlama için Qwen 3.8, Kimi K3'ten daha mı iyi?
Mevcut verilere göre hayır. Kimi K3, kritik ajan tabanlı kodlama satırlarında önde: FrontierSWE'de 81,2'ye karşı 73,5, Terminal-Bench 2.1'de 88,3'e karşı 86,6. Ayrıca bağımsız endeks skorlarına sahip olan tek model o. Qwen 3.8 Max terminal işlerinde yakın performans gösteriyor, token başına ve modellenen oturumlarda daha ucuz kalıyor. 27B ise tamamen farklı bir ağırlık sınıfında yer alıyor.
Qwen 3.8 mi, Kimi K3 mü daha ucuz?
Tüm liste fiyatı kalemlerinde Qwen 3.8 Max daha ucuz: girdi için $2'a karşı $3, çıktı için $6'a karşı $15. Her iki modelde de varsayılan reasoning çıktı olarak ücretlendirildiğinden, görev zorlaştıkça Kimi'nin dezavantajı büyüyor. Yukarıdaki hesapta cache kullanılan ajan tabanlı bir oturumda fark yaklaşık 1,8×.
Bu modeller self-host edilebilir mi, lisansları nedir?
Evet, üç checkpoint de indirilebilir. Qwen3.8-27B Apache-2.0 lisanslı ve quantized halde tek bir 24 GB GPU'ya sığıyor. Kimi K3, yaklaşık 1,56 TB'lık MXFP4 checkpoint'i nedeniyle küme ölçekli donanım istiyor ve özel Kimi K3 License taşıyor. Qwen3.8-Max ağırlıkları ise Qwen3.8-2.4T-A95B olarak özel qwen3.8-max lisansı altında herkese açık.
İki modelde de 1M bağlam penceresi gerçekten var mı?
Yaklaşık olarak evet. Kimi K3, 1.048.576 token belirtiyor. Qwen 3.8 Max, 991,8K maksimum girdiyle 1M bağlam listeliyor. 27B'nin yerleşik sınırı 262.144; 1M'e ancak kısa bağlam kalitesinden ödün veren YaRN ölçeklemesiyle ulaşıyor. Bağımsız doğrulama yalnızca 248K seviyesinde mevcut.
Hangi senaryoda hangisi seçilmeli?
| Kullanım senaryosu | Tercih | Neden |
|---|---|---|
| API kodlama ajanları, kalite öncelikli | Kimi K3 | FrontierSWE 81,2, Terminal-Bench 88,3, AA tarafından doğrulanmış 60 |
| Maliyetin önemli olduğu API işleri, doküman/görüntü ağırlıklı kullanım | Qwen 3.8 Max | $6'a karşı $15 çıktı, OSWorld 86,1, $0.17/okuma açık cache |
| Sahip olduğunuz donanımda self-hosting | Qwen3.8-27B | Apache-2.0, ~17–29 GB quant sürümleri, tek RTX 4090'da 160K bağlam |
| Frontier sınıfı bir amiral gemisini self-host etmek | Kimi K3 | Buradaki bağımsız frontier sınıfı skorlara sahip tek açık checkpoint; küme bütçesi ayırın |
Bu tablonun bazı bölümlerini iki gelişme değiştirebilir: Qwen 3.8 Max'in bağımsız olarak skorlanması ve özel qwen3.8-max lisansının koşullarının yayımlanması. Takipçinin bildirdiği 53, K3'ün doğrulanmış 60 puanına karşı zayıf kanıta dayanıyor. Bu iki gelişmeden biri gerçekleşene kadar, Qwen 3.8 Max ve Kimi K3 API karşılaştırması yalnızca API kullanım senaryosunu daha ayrıntılı ele alıyor.
İlgili okumalar: Qwen3.8-27B: Doğrulananlar ve 17GB'ın Gerçekte Çalıştırabildikleri · Kimi K3 Açık Ağırlıkları · Qwen 3.8 Max ve Kimi K3: API Sürümü