 AIREITER
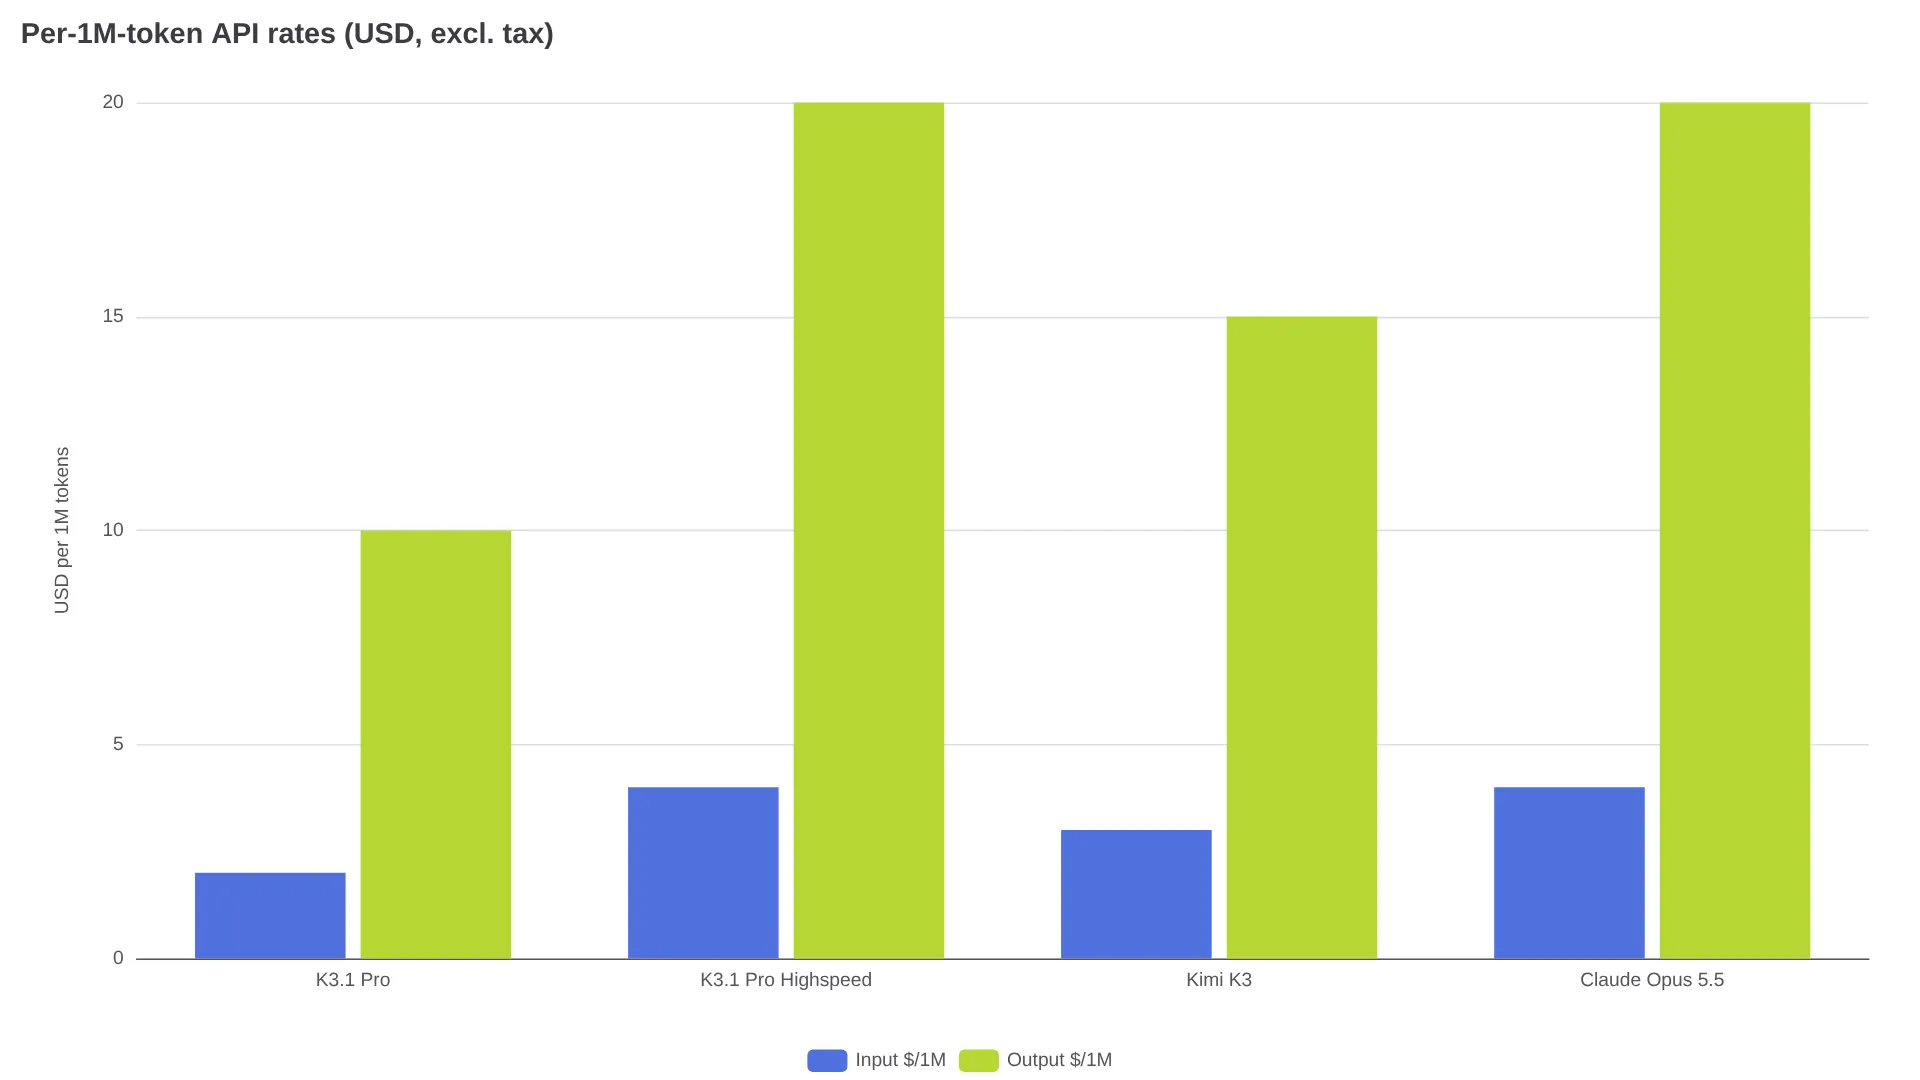
Kimi K3.1 Pro API fiyatını anlamanın en kolay yolu, standart $2/$10 tarifesiyle reasoning ve önbelleğin faturaya etkisini ayrı değerlendirmek. Standart sürümde 1 milyon giriş token'ı $2, çıkış token'ı $10; Highspeed katmanında ise her iki ücret de iki katına çıkıyor. Önbellekten okunan token'lar her iki seçenekte de 1 milyon başına $0.20 (platform.kimi.ai).
| Model | 1 milyon giriş | 1 milyon çıkış | 1 milyon önbellek isabeti okuması | 5 dakikalık önbellek yazımı / 1 milyon | 1 saatlik önbellek yazımı / 1 milyon |
|---|---|---|---|---|---|
Kimi K3.1 Pro (kimi-k3.1-pro) | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
Kimi K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed) | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (önceki nesil) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Ücretler, Kimi'nin resmi fiyatlandırma bilgilerine göre vergi öncesi ve 1 milyon token başına USD cinsinden hesaplanıyor. 1 milyon token'lık bağlamın tamamında uzun bağlam ek ücreti uygulanmıyor (kimi.ai).
100 bin token'lık bağlamın görünen maliyeti $0.30; faturaya başka kalemler de ekleniyor
Önbelleğe alınmamış 100.000 giriş token'ı ve 10.000 çıkış token'ından oluşan örnek bir istek, resmi $2/$10 tarifesiyle doğrudan hesaplandığında $0.20 + $0.10, yani $0.30 tutuyor. Gerçek isteklerde şu formülü kullanabilirsiniz. Bu hesap standart katman içindir; Highspeed'de giriş, çıkış ve yazma ücretlerini ikiyle çarpın:
Total = (uncached_in x 2 + cached_read x 0.20 + write_5m x 2
  + write_1h x 4 + (visible_out + reasoning_out) x 10) / 1M
  + searches x 0.004
Formül; Kimi'nin resmi maliyet dökümündeki önbelleksiz giriş, önbellek isabeti, TTL'e göre önbellek yazımı ve çıkış kalemlerini temel alıyor (kimi.ai). Buna her Web Search çağrısı için alınan $0.004 ücret de ekleniyor. Faturalandırma istek başına kullandıkça öde modeliyle yapıldığı için (kimi.ai) yeniden gönderilen bir istek aynı sayacı baştan çalıştırıyor. K3.1 Pro'da reasoning her zaman açık ve çıkış tarifesi üzerinden ücretlendiriliyor. Yani modelin kullanıcıya görünmeyen düşünme izleri de 1 milyon başına $10'lık çıkış bütçesinden tüketiyor. Örneğin 10.000 token'lık görünür yanıtın arkasında 40.000 gizli reasoning token'ı varsa toplam 50.000 çıkış token'ı, yani $0.50 faturalandırılır. 935 giriş ve 56.097 çıkış token'ı için $0.5628 ödeyen bir kullanıcının gerçek deneyimi de 1 milyon çıkış token'ı başına $10 tarifesiyle neredeyse birebir örtüşüyor (x.com).
Faturada sık gözden kaçan diğer kalem önbellek davranışı. Yeni bir önbellek öneki yazılırken ücret alınırken, pencere içinde değişmeden yeniden kullanılan öneklerde okuma maliyeti 1 milyon token başına $0.20'ye düşüyor. Varsayılan önbellek ömrü beş dakika; her çağrıda bir saatlik seçenek de kullanılabiliyor (kimi.ai). Bağlamın başlarına yakın bir önek değişirse, sonrasındaki tüm içeriğin yeniden kullanımı geçersiz hale gelebiliyor (kimi.ai). Önbellek isabetinin gerçekten gerçekleştiğini anlamak için istek bazındaki kullanım dökümünde cached-read ve uncached token sayılarını kontrol etmek gerekiyor; yalnızca benzer metin kullanılması isabet garantisi vermiyor.
Kimi K3.1 Pro API fiyatları: Standart ve Highspeed arasındaki fark
Highspeed, aynı iddia edilen zeka seviyesini ve 1 milyon token'lık bağlamı yaklaşık 2-3 kat daha yüksek hızla sunuyor. Bunun karşılığında giriş, çıkış ve önbellek yazma ücretleri tam iki katına çıkıyor (platform.kimi.ai). Moonshot'ın duyuru yazısında da tablo bu şekilde aktarılıyor (kimi.ai).
İki katına çıkmayan tek kalem önbellek isabeti okuması: Her iki sürümde de 1 milyon önbelleklenmiş giriş token'ı için ücret $0.20. Uzun sistem komutlarını ve araç tanımlarını sürekli yeniden oynatan ajan döngülerinde bu fark önem kazanıyor. Tekrarlanan içerik indirimi iki katmanda da aynı kalırken yeni token'lar ve reasoning Highspeed'de iki kat daha pahalı.
Her maliyet hesabının temelinde üç faturalandırma bilgisi var:
- API üyelikten ayrı ücretlendirilir: API kullanımı, ayrı giriş ve çıkış sayaçlarıyla kullandıkça öde modelinde çalışır. Kimi üyelikleri ve Kimi Code aboneliklerinden ayrıdır; dolayısıyla üyelik bakiyesi API çağrılarını karşılayamaz (kimi.ai).
- Model kimlikleri ve uç nokta: API,
kimi-k3.1-provekimi-k3.1-pro-highspeedmodel kimlikleriyle OpenAI uyumlu çalışır vehttps://api.moonshot.ai/v1adresinden erişilebilir. Ayrıca OpenRouter ve Vercel AI Gateway üzerindemoonshotai/kimi-k3.1-proadıyla sunulur. - Ek araç ücretleri: İsteğe bağlı Web Search çağrılarının her biri token ücretlerine ek olarak $0.004 tutar. Yüklenen dosyaların kendisi ücretlendirilmez; ancak ayrıştırılan içerik giriş token'ı olarak faturalandırılır. API erişimi, minimum $1 yükleme sonrasında ve kademeli hız limitleriyle açılır (kimi.ai).
Highspeed'in iki katı fiyatı ne zaman mantıklı, ne zaman gereksiz masraf?
Highspeed ancak bekleme süresinin token maliyetinden daha pahalı olduğu durumlarda öne çıkıyor. Etkileşimli kodlama oturumları, canlı asistanlar ve kullanıcının yükleme göstergesine baktığı demolar için $4/$20 tarifesi anlamlı olabilir; çünkü burada ürünün bir parçası da gecikme. Kimsenin beklemediği toplu işler, gece boyunca çalışan ajanlar ve değerlendirme taramaları ise yaklaşık yarı fiyatlı standart $2/$10 katmanında kalmalı. Kısacası Highspeed, yalnızca kazandırdığı bekleme süresinin değeri ek token ücretini aştığında mantıklı; giriş ağırlıklı çalışmalarda bu ek ücret yaklaşık standart faturanın tamamı kadar.
Maliyeti azaltmak için katman değiştirmekten önce reasoning seviyesini düşürmek daha ucuz bir seçenek. API, low, high ve max değerlerini destekliyor; varsayılan değer max ve Moonshot'ın bildirdiği benchmark sonuçları da bu ayarla elde edilmiş (datacamp.com). Kolay bir görevde max'ten high'a veya high'dan low'a inmek, Highspeed primini ödemeden reasoning token'ı miktarını azaltabilir. Oturum boyunca tek bir seviye kullanın; seviye değiştirmek bağlam önbelleğini geçersiz kılıyor (datacamp.com).
Topluluk paylaşımları bu seçimin hız tarafını da ortaya koyuyor. Aynı tür işlerde karşılaştırma yapan Japon bir kullanıcı, Opus 5.5'in 14:32'de, Kimi K3.1 Pro'nun ise 27:53'te tamamladığını ve çıktı kalitesinin birbirine yakın olduğunu söylüyor. Sonuç olarak Kimi'yi yalnızca beklemeye uygun işlerde kullanacağını belirtiyor:
Yarı fiyatına olması gerekirken bekleme süresi neredeyse iki katına çıktı. ... Opus 5.5 14 dakika 32 saniye, Kimi K3.1 Pro ise 27 dakika 53 saniye sürdü. Kalite açısından dürüst olmak gerekirse oldukça yakınlar. Ben olsam yalnızca bekleyebileceğim işleri Kimi'ye verirdim. — @rutinelabo (x.com)
Reddit kullanıcıları da benzer bir tablo çiziyor: Highspeed'de yaklaşık 80 tok/s, standart sürümde ise yaklaşık 30 tok/s. Hızlı katmanı ise oldukça pahalı buluyorlar:
Modelin yine kol ve bacak isteyen bir yüksek hız sürümü var; gözün okuyabileceğinden çok daha hızlı çalışıyor (80t/s). Normal sürüm ise canı isterse 30t/s hızında çalışıyor. — u/Kiverty (reddit.com)
Pratik kural şu: Varsayılan olarak standart K3.1 Pro'yu seçin, önce reasoning_effort seviyesini düşürün ve Highspeed için yalnızca başında insan bekleyen oturumlarda ödeme yapın.
4 Kasım sonrasında self-hosting: 3T sınıfının gerçek maliyeti
Moonshot, Kimi K3.1 Pro'nun tüm ağırlıklarını 4 Kasım 2026'ya kadar yayımlayacağını söylüyor. Model, 1 milyon token'lık bağlam penceresine sahip 3T sınıfında bir model olarak tanımlanıyor (kimi.com). 2 Kasım itibarıyla Moonshot'ın Hugging Face organizasyonunda resmi bir K3.1 Pro deposu görünmüyor; huggingface.co/moonshotai üzerinde hâlâ Kimi K3 ve daha eski modeller listeleniyor, arama sonuçlarında ise yalnızca resmi olmayan çatallar bulunuyor. Nihai lisans, dosya formatları ve quantization seçenekleri de doğrulanmış değil. Üçüncü taraf takipçileri, resmi yayımlama gerçekleşene kadar bu başlıkları bilinmiyor olarak işaretliyor (ctrlaltorion.com).
Self-hosting'in API'yi geçmesinin zor olmasının nedeni ölçek. K3.1 Pro, 2.8T parametreli bir mixture-of-experts modeli olan Kimi K3'ün post-training uygulanmış halefi. 3T sınıfı ifadesi de aynı ölçeğe işaret ediyor (datacamp.com). MoE'de toplam parametre sayısı token başına etkin parametre sayısıyla aynı olmadığı için mevcut bilgilerle güvenilir bir tek iş istasyonu VRAM hesabı yapılamıyor.
Tahmini bir GPU fiyatı uydurmak yerine sembolik bir başa baş hesabı kullanın:
API_month = monthly_tokens_1M x blended_$/1M (from formula above)
Self-host wins when cluster_monthly_cost < API_month at sustained utilization
1 milyon giriş token'ı için $2, 1 milyon çıkış token'ı için $10 tarifesiyle 1 milyar giriş token'ı ve 100 milyon çıkış token'ı toplamda $2.000 + $1.000, yani API kullanımında yaklaşık $3.000 tutar. Zaten uygun bir kümeye sahip olan, yüksek hacimli çıkarımı sürekli çalıştıran veya verilerini şirket içinde tutmak zorunda olan ekipler için self-hosting avantajlı olabilir. Böyle bir kümesi ve sürdürülebilir kullanım yoğunluğu olmayan ekiplerde ise yukarıdaki formül genellikle kullandıkça öde API lehine sonuçlanır; planlama yapmadan önce resmi checkpoint ve lisansı bekleyin.
Kullanıcıların sürekli takıldığı iki faturalandırma tuzağı
İlk tuzak, yukarıdaki formülde de görüldüğü gibi reasoning'in çıkış olarak ücretlendirilmesi. Çalışmaları max_completion_tokens ile sınırlayın, denemelere low ile başlayın, yalnızca başarısızlıkta high'a çıkın ve max'i zor final çalışmasına ayırın.
İkinci tuzak, abonelik kotasının hızlı tükenmesiyle API'nin öngörülebilir maliyetini birbirine karıştırmak. Birden fazla ücretli kullanıcı, zorlu kodlama işlerinde 5 saatlik kotayı dakikalar içinde tükettiğini bildiriyor. Üst seviye bir kullanıcı da aylık kotasının altı saatte bittiğini söylüyor (reddit.com). Moonshot, 25 Ekim'de hız limitleri ve gereksiz kota tüketimi için özür dileyerek sorunu kabul etti; tek seferlik %25 kota yenilemesi sağlarken gereksiz alt ajan çağrılarını ve çıktı uzunluğunu azaltacağını açıkladı (x.com). Yoğun reasoning ve kodlama işlerinde, 100K giriş ve 10K çıkış token'ından oluşan birim başına $0.30 tutan ölçümlü API kullanımı, tek bir görevde tükenebilen abonelik kotalarına göre daha öngörülebilir.
Kimi K3.1 Pro API fiyatlandırması hakkında sık sorulanlar
Kimi K3.1 Pro API'nin 1 milyon token başına fiyatı ne kadar?
Standart katmanda vergi öncesi 1 milyon token başına giriş $2.00, çıkış $10.00, önbelleklenmiş giriş okuması $0.20, 5 dakikalık önbellek yazımı $2.00 ve 1 saatlik önbellek yazımı $4.00 (kimi.ai).
K3.1 Pro ile Highspeed arasındaki fark nedir?
Highspeed aynı iddia edilen zeka seviyesini ve 1 milyon token'lık bağlamı koruyor; ancak yaklaşık 2-3 kat daha hızlı çalışıyor. Ücreti 1 milyon token başına $4.00 giriş ve $20.00 çıkış. Önbellek yazma ücretleri de iki katına çıkarken önbellek isabeti okumaları $0.20 seviyesinde değişmeden kalıyor (platform.kimi.ai).
API model kimlikleri nelerdir?
Moonshot'ın OpenAI uyumlu uç noktasında standart sürüm için kimi-k3.1-pro, hızlı katman için kimi-k3.1-pro-highspeed kullanılır. Gateway servislerinde model moonshotai/kimi-k3.1-pro olarak listelenir (openrouter.ai).
API kullanımı Kimi üyeliğine dahil mi?
Hayır. API faturalandırması Kimi üyeliklerinden ve Kimi Code planlarından ayrıdır; ayrı anahtarlar ve bakiyeler kullanılır. Bu nedenle üyelik kredileri API çağrılarını karşılayamaz (kimi.ai).
Maliyeti düşürmek için reasoning kapatılabilir mi?
Hayır. K3.1 Pro her zaman reasoning yapar. Maliyet kontrolü, düşünmeyi kapatmakla değil reasoning_effort (low, high, max; varsayılan max) ve max_completion_tokens ayarlarıyla sağlanır (datacamp.com).
Açık ağırlıklar ne zaman yayımlanacak, beklemeli miyim?
Moonshot hedef tarihi 4 Kasım 2026 olarak belirtiyor; ancak 2 Kasım itibarıyla resmi bir Hugging Face deposu veya nihai lisans yayımlanmış değil. Şimdilik API'yi kullanın; self-hosting seçeneğini ancak resmi checkpoint ve lisans yayımlandıktan sonra yeniden değerlendirin.
İlgili içerikler: Ayrıntılı benchmark dökümü için Kimi K3.1 Pro API: Fiyatlandırma, Benchmark'lar ve Highspeed Rehberi, önceki neslin tarifeleri için Kimi K3 Fiyatlandırması ve Kimi modellerini tek anahtarla çağırmak için Kimi K3 API sayfası.