 AIREITER
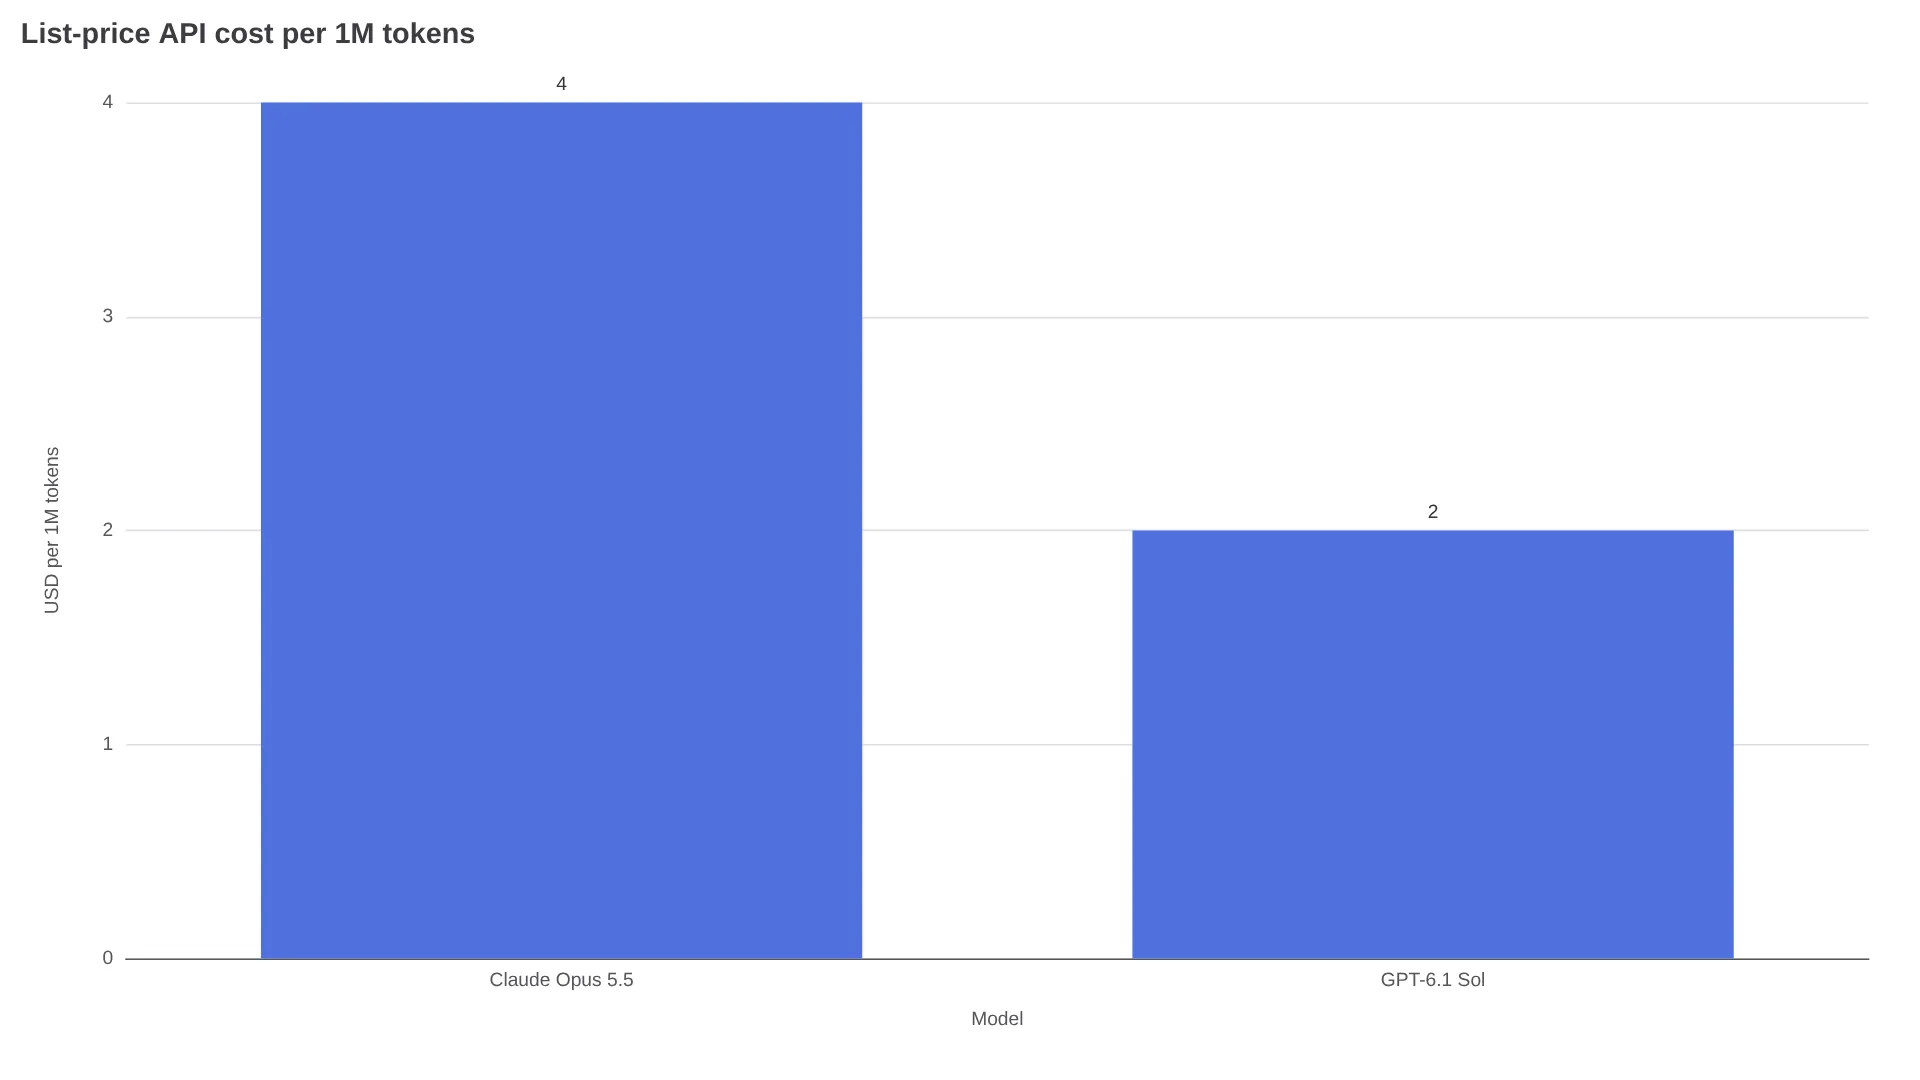
Kalite tarafında Opus 5.5, liste fiyatında ise GPT-6.1 Sol öne çıkıyor. Ancak Sol’un avantajı, istek başına 272K giriş token’ı sınırını aşmadığınız sürece geçerli. Bu eşiği geçtiğinizde uzun bağlam ek ücreti fiyat farkını büyük ölçüde eritiyor. Üstelik bazı Codex kullanıcıları Sol’u gerçek kullanım süresinde daha yavaş buluyor.
Her iki model de bugün kullanılabiliyor. Anthropic, ilk Claude 5.5 modeli olarak Claude Opus 5.5’i 22 Eylül 2026’da yayınladı. OpenAI ise GPT-6.1 Sol’u 29 Eylül 2026’da gpt-6.1-sol API kimliğiyle kullanıma sundu. Yalnızca teknik özellik tablolarına bakmak faturayı belirleyen üç kritik noktayı gözden kaçırıyor: uzun bağlam eşiği, efor ayarı ve abonelik kotalarının çalışma biçimi.
30 saniyelik cevap
Yanlış ya da gereksiz yere büyütülmüş bir yama token maliyetinden daha pahalıya patlayacaksa Claude Opus 5.5’i seçin: uzun süren migrasyonlar, birden fazla depoyu kapsayan denetimler ve başında insan olmayan ajanlar için daha uygun. İstek başına 272K giriş token’ının altında kalan, kapsamı iyi tanımlanmış ve yüksek hacimli işler çalıştırıyorsanız GPT-6.1 Sol daha mantıklı: talep otomasyonu, PDF çıkarımı ve kurumsal iş akışları buna örnek.
Kâğıt üzerindeki fark sınırlı: bağlam penceresi 1M’e karşı 1.05M, her iki modelde de maksimum çıktı 128K ve giriş/çıkış fiyatları sırasıyla 1 milyon token başına $4/$20 ve $2/$10. Davranış farkı ise daha belirgin. Opus 5.5 ajan tabanlı kodlama testlerinde daha yüksek sonuçlar alıyor (%66.4 Terminal-Bench 4.0, %54.4 FrontierCode v1.1, %57.8 CursorBench 4.0). Sol ise yaklaşık yarı fiyatıyla ve AutomationBench’te görev başına üçte bir maliyetle elde ettiği belgelenmiş galibiyetle karşılık veriyor. Abonelik kullanıcılarında tablo biraz daha karmaşık: Reddit’teki kota testleri, Sol’un API fiyatının düşündürdüğünden daha hızlı kota tükettiğini gösteriyor.
Fiyat, bağlam ve erişim seçenekleri
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| Sağlayıcı | Anthropic | OpenAI |
| Yayın tarihi | 22 Eylül 2026 | 29 Eylül 2026 |
| API kimliği | Çoğu ağ geçidinde claude-opus-5-5 ailesi | gpt-6.1-sol |
| 1 milyon token başına giriş / çıkış | $4.00 / $20.00 | $2.00 / $10.00 |
| 1 milyon token başına önbellekten okuma | $0.20 | $0.10 |
| Bağlam penceresi | 1,000,000 token | 1,050,000 token |
| Maksimum çıktı | 128K token | 128K token |
| Hızlı katman | Fast mode $8 / $40, 2.5 kata kadar hız | Codex’te 8 kata kadar Ultrafast, liste fiyatlarının yaklaşık 2 katı |
| Kullanılabildiği yerler | Claude Code, API, Bedrock, Vertex, Foundry, OpenRouter | Codex, ChatGPT Work, API, Azure, Bedrock, OpenRouter |
| Bulunmadığı yer | — | Çıkışta normal tüketici Chat’i |
Model değiştirmek için yalnızca model dizesini değiştirmeniz yeterli. AIReiter, iki modeli de tek bir konsoldan yönlendiriyor; böylece iki farklı sağlayıcının anahtarlarını ayrı ayrı yönetmeniz gerekmiyor.
Gerçek iş yüklerinde faturaya yansıyan maliyet
Manşet fiyatlara bakıldığında Sol %50 daha ucuz. Ancak gerçek maliyet, istek başına veri miktarına ve önbellek kullanımına göre değişiyor.
OpenAI’nin ek ücreti, istek başına 272K giriş token’ı aşıldığında uygulanıyor: söz konusu isteğin tamamı için giriş ve önbellek okuma ücretleri 2 katına, çıkış ücreti ise 1.5 katına çıkıyor. Anthropic, 1M’lik pencerenin tamamını aynı fiyatlarla listeliyor ve istek başına ek ücret açıklamıyor. Önbellekten okumada fiyatlar $0.20’a karşı $0.10 olduğu için, önbellek ağırlıklı döngüler Sol’un avantajının bir bölümünü koruyor.
| İş yükü | Opus 5.5 | GPT-6.1 Sol | Fark |
|---|---|---|---|
| Dengeli asistan: 1M giriş / 250K çıkış, istekler 272K’nın altında | $9.00 | $4.50 | Sol %50 daha ucuz |
| İstekler 272K’nın altında retrieval: 10M giriş / 1M çıkış | $60 | $30 | Sol %50 daha ucuz |
| Her isteğin 272K’yı aştığı retrieval: 10M giriş / 1M çıkış | $60 | ~$55 | Sol yalnızca ~%8 daha ucuz |
| Önbellek ağırlıklı döngü: 100K önek bir kez yazılıyor, ardından 1.000 kez (5K yeni + 100K önbellekten okuma + 1K çıkış) | ~$60.50 | ~$30.25 | Sol ~%50 daha ucuz |
Toplamlar, tokenizer farkları hesaba katılmadan liste fiyatlarıyla yapılan hesaplamalardır. Sol’un avantajı kısa ve yüksek hacimli isteklerde en güçlü, tek seferde yapılan dev retrieval isteklerinde ise en zayıf hâline geliyor.
Abonelik hesabı, API hesabından ayrılıyor. Sabit istemlerle GPT-6.1 Sol, GPT-6 Sol ve Opus 5.5’i karşılaştıran 128 istemlik bir kullanıcı testinde, Sol ailesinin abonelik tüketimi token fiyatının öngördüğünden yüksek bulundu. Ardından başka bir yorumcu durumu şöyle özetledi:
"my chatgpt just cited this. anyways they may be a match usage-wise but opus is way faster on the wall clock and i regret swapping this month." — u/ebrbrbr, r/ChatGPT kota test başlığı
Başka bir Codex kullanıcısı da benzer bir kota tüketiminden söz etti:
"I wouldn't mind using GPT 6.1 Sol if the usage was decent, but man, even though it's more 'efficient' I'm still getting drained on usage. It's unbelievable." — u/Longjumping_Stop6269, r/codex
Bütçe kuralı basit: ortanca isteğiniz 272K’yı aşıyorsa geçiş yapmadan önce ek ücreti hesaba katın. $20 veya $100’lık bir koltuk kullanıyorsanız kota payını dolar başına token’la değil, birleştirilen PR başına tüketilen kota ile takip edin.
Kodlama ve ajanlar: benchmark’lar ve iki görev testi
Aşağıdaki üçüncü taraf sonuçları yön gösterici nitelikte; test düzenekleri ve efor seviyeleri farklı. Kaynaklar: Anthropic, OpenAI, DataCamp build testi, OpenRouter aktarım hızı, SpringPrompt benchmark derlemesi.
| Benchmark | Opus 5.5 | GPT-6.1 Sol | Not |
|---|---|---|---|
| Terminal-Bench 4.0 | %66.4 | yayınlanmadı | Anthropic testi, xhigh |
| FrontierCode v1.1 Main | %54.4 | Fable 5.1 ile aynı, sayı verilmedi | Farklı raporlayanlar |
| CursorBench 4.0 | %57.8 | yayınlanmadı | Anthropic testi |
| DeepSWE v1.1 | yayınlanmadı | Astra ile aynı, GPT-6 Sol’un 6.4 puan üzerinde | OpenAI testi, maksimum efor |
| AutomationBench (47 araç) | %40.0 | Orta seviyede Opus’un 2.2 puan üzerinde, yaklaşık 1/3 maliyet | Bağımsız test, fallback yok; Anthropic’in Zapier testine ilişkin açıklamasına göre |
| OSWorld 2.0 kısmi | %81.8 | Çevrimdışı sette ~%60.5 | Farklı alt kümeler, sağlayıcı testleri |
| GDPval-AA v2.1 | 1,846 Elo | GDP.pdf üzerinde fallback’li Opus’u <1/2 maliyetle geçiyor | OpenAI’nin sağlayıcılar arası iddiası |
Opus 5.5, yayımlanmış ajan tabanlı kodlama sonuçları açısından daha kapsamlı bir tablo sunuyor. Sol’un en güçlü belgelenmiş tarafı ise daha düşük görev maliyetiyle kurumsal iş akışları ve doküman analizi. Anthropic, sonuçlarını üretim güvenlik önlemleri açıkken aldığını belirtiyor.
Üçüncü taraflardan gelen iki görev testi tabloya biraz daha fazla ayrıntı katıyor:
- Tek dosyalık Tetris geliştirme (DataCamp, OpenCode, aynı istem, yüksek efor, tek deneme). İki model de zor yerçekimi tersine çevirme mantığını geçti. Sol; mekanikler, eksiksizlik ve his başlıklarında 5.0 puan alırken Opus 4.3’te kaldı. Buna karşın Opus, 3 tur ve 2 araç çağrısıyla tamamladı; Sol ise 6 tur ve 9 çağrı kullandı. Maliyet, Sol’un 8.1K reasoning token’ına karşı Opus’un 22.5K token harcaması nedeniyle $0.26’ya karşı $0.87 oldu.
- 128 istemlik kota testi (Reddit, sabit istemler, kota ve süre kaydı). Aynı iş yükünde Sol, GPT-6 Sol’dan daha fazla abonelik kotası tüketirken Opus gerçek kullanım süresinde daha hızlı tamamladı.
Kullanıcı raporlarında sık tekrarlanan bir başka nokta da ölçülülük:
"The biggest win with Opus 5.5 for me isn't even raw coding speed, it's that it doesn't over-engineer simple fixes. Previous models would rewrite 4 files when you asked for a 3-line patch; 5.5 respects the existing architecture" — u/food_fatherr, r/ClaudeAI
Öte yandan aşırı üretim yönünde uç bir rapor da var: bir geliştirici, piksel hassasiyetinde bir istek için Sol’un 30.000 test yazdığını, kısaltması istendiğinde ise bunlardan yalnızca 25’ini sildiğini bildirdi.
Hissettiğiniz hız ile tabloda yazan hız aynı değil
Teknik özellik tabloları çözümleme hızında Opus’u öne çıkarıyor: SpringPrompt üzerinden Artificial Analysis verilerinde yaklaşık 96’ya karşı 53 token/sn, OpenRouter’da ortanca aktarım hızında 74’e karşı 29. SpringPrompt’a göre ilk token süresinde ise Sol az farkla önde: düşük efor seviyesinde 1.71 saniyeye karşı 6.89 saniye. Buna karşılık aktarılan Codex raporları, basit işlerde birkaç dakikayı ve uzun doküman görevlerini de kapsayan uçtan uca beklemelerde Sol’un tersine daha yavaş olduğunu söylüyor.
Bu iki sonuç birbiriyle çelişmek zorunda değil. Token/sn değeri ilk parça geldikten sonraki çözümlemeyi ölçer; gerçek süreye ise reasoning, kuyrukta bekleme ve test düzeneğinin ek yükü de dahil olur.
- Opus Fast mode, 2.5 kata kadar hız için $8/$40 (2 kat) ücretlendiriliyor. Sol Ultrafast ise Codex’te yaklaşık 2 kat ücretle 8 kata kadar hız vadediyor.
- Aktarılan Codex ve Work raporları API çözümleme hızını değil, gecikmeyi ölçmeye odaklanıyor. 40 dakikalık bir PDF işi, tek bir anekdotta 5 saatlik pencerenin yalnızca %6’sını kullandı; bu tipik bir oran değil.
- Döngünüz etkileşimliyse (Cursor, Claude Code, Codex CLI), karar vermeden önce her modelle üç gerçek ticket test edin.
Faturayı belirleyen ayarlar
Modelin adı ve rozeti kadar varsayılan ayarlar da önemli:
- Opus’u Medium veya High ile başlatın. Aktarılan kullanıcı raporları, Extra High ve Max seviyelerinin sıradan yamalarda çok az kazanım karşılığında kotayı hızla tükettiğini gösteriyor.
- Thinking kilitleri farklı çalışıyor. Opus’ta thinking kapatılamıyor, zorunlu araç kullanımı reddediliyor ve yeni hesaplarda düzenlenmiş bağlam 400 hatasına yol açabiliyor (DataCamp API notları). Sol’da
noneilemaxarasında ölçekleme yapılabiliyor; önbelleği geçersiz kılmadan konuşma sırasında efor seviyesi değiştirilebiliyor (DataCamp reasoning kontrolleri). Bu da maliyet sınırı olan döngüler için daha kullanışlı. - Güvenlik önlemleri işi başka modele yönlendirebilir. Opus’un siber güvenlik görevlerinin çoğu, Cyber Verification Program dışında Opus 4.8’e aktarılıyor. Biyoloji çalışmaları için Life Sciences programı gerekiyor (Anthropic). Bu görevlerde fallback nedeniyle kalite ve kota tarafında beklenmedik sonuçlara hazırlıklı olun.
İş yükünüze göre hangisini seçmelisiniz?
| Yaptığınız iş… | Seçim… | Neden? |
|---|---|---|
| 200K satırlık migrasyon, çoklu depo denetimi, 9 saatlik ajan çalışması | Opus 5.5 | Daha yüksek ajan skorları, daha az gereksiz yeniden yazım, sabit 1M fiyatlandırması |
| Günde 10K ticket, her biri 272K’nın altında; küçük parçalı RAG | GPT-6.1 Sol | Listenin yarı fiyatı, AutomationBench ve GDP.pdf testlerinde dolar başına güçlü sonuç |
| İstek başına 272K’yı aşan dev tek seferlik retrieval | Opus 5.5 veya Sol için parçalayın | Sol’un ek ücreti avantajını ~%8’e indiriyor |
| PDF ağırlıklı finans ve hukuk soru-cevapları | Önce Sol’u test edin | Fallback’li Opus’a karşı <1/2 görev maliyetiyle öne çıktığı iddia ediliyor; kendi dokümanlarınızda doğrulayın |
| $20’lık koltuk kullanan abonelik müşterisi, etkileşimli CLI | İkisini de test edin; aktarılan raporlar Opus’u destekliyor | Kullanıcılar Sol’un token hesabının öngördüğünden hızlı kota tükettiğini ve daha yavaş hissettirdiğini söylüyor |
Tek bir evrensel kazanan yok. Sol verimlilik seçeneği; Opus ise ölçülülük ve özerklik seçeneği. Pratik bir iş bölümü, planlama ve incelemeyi Opus’a, toplu yürütmeyi Sol’a bırakmak olabilir.
Opus 5.5 ve GPT-6.1 Sol SSS
API üzerinden hangisi daha ucuz?
Liste fiyatında Sol ($2/$10’a karşı $4/$20; önbellekten okumada $0.10’a karşı $0.20). Her isteğin 272K giriş token’ını aştığı durumda fark ~%8’e iniyor.
Kodlama ajanları için hangisi daha iyi?
Opus 5.5, yayımlanmış Terminal-Bench, FrontierCode ve CursorBench sonuçlarında önde. Sol ise DeepSWE’de Astra ile aynı seviyeye gelerek ve AutomationBench’te üçte bir maliyetle kazanarak karşılık veriyor.
Gerçek kullanımda hangisi daha hızlı?
Çözümleme hızında Opus önde (~74–96 tok/s’ye karşı ~29–53); ilk token süresinde ise Sol az farkla avantajlı. Ekim 2026 tarihli Codex raporları Sol’un daha yavaş olduğuna işaret ediyor.
API model kimlikleri neler?
gpt-6.1-sol ve çoğu ağ geçidinde claude-opus-5-5 slug’ları.
GPT-6.1 Sol normal ChatGPT’de var mı?
29 Eylül’deki çıkışta yoktu: ilk aşamada Work, Codex ve API ile sınırlıydı. Erişim sizin için önemliyse kullandığınız koltuğu yeniden kontrol edin.
Hangi efor ayarını kullanmalıyım?
Opus 5.5’i Max yerine Medium veya High ile başlatın. Sol’da medium ile başlayıp yalnızca yeniden denemeler arttığında seviyeyi yükseltin. Her iki modelde de reasoning token’ları aynı token başı ücretlendirmeye dahil (DataCamp faturalandırma notları).
İstem yazarak çözemeyeceğiniz tercih
Opus 5.5 depoya saygılı davranıyor ama düşünme maliyetini siz ödüyorsunuz. Sol ise token’ları ucuza getirirken incelemeniz ve tamamlanmasını beklemeniz gereken daha fazla iş üretebiliyor. Sessiz bir hata ürüne sızarsa Opus için ödeme yapmak mantıklı. Hataların maliyeti düşük, hacim ise önceliğinizse 272K sınırının altında Sol’un tasarrufunu kullanın.
İlgili içerikler: Claude Opus 5.5 incelemesi ve fiyatlandırması, GPT-6.1 Sol API fiyatlandırma incelemesi.