 AIREITER
19 августа 2026 года в репозитории LFM2.5-2.6B Liquid AI появился второй файл Q4_0 размером 1,59 GB. Размер тот же, имя почти не отличается — а модель внутри другая. Это версия с QAD, или quantization-aware distillation: такой подход компенсирует значительную часть потерь от 4-битной квантизации. Ошибиться при загрузке легко: если взять старый файл, запустится обычная, не дообученная под квантизацию версия.
Что QAD меняет в процессе обучения
QAD расшифровывается как quantization-aware distillation — дистилляция с учётом квантизации. Liquid AI обучила четыре модели — LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct и LFM2.5-2.6B — работать с округлением Q4_0. Во время обучения квантованный студент перенимал поведение высокоточной модели-учителя, заранее «видя» ошибки квантизации и подстраивая под них веса.
Старые Q4_0 в этих же репозиториях сделаны методом post-training quantization (PTQ): готовую BF16-модель просто округлили после обучения, без компенсации возникших ошибок. Согласно анонсу Liquid AI, все четыре QAD-чекпойнта «достигают примерно 97% от средних результатов BF16» на наборе тестов по рассуждению, следованию инструкциям, использованию инструментов и агентному поведению. Указано среднее по пяти прогонам. QAD — это не новый формат файлов, а изменение на стороне обучения: результатом всё равно остаётся обычный GGUF Q4_0, который уже умеет запускать llama.cpp.
Два одинаковых файла: как скачать именно QAD
В репозитории LFM2.5-2.6B одновременно лежат LFM2.5-2.6B-Q4_0.gguf и LFM2.5-2.6B-QAD-Q4_0.gguf; у обоих указан размер 1,59 GB. При этом стандартные примеры команд в репозитории ведут к Q4_K_M, а не к QAD. Простое копирование команды не скачает ни один из QAD-файлов — имя нужно указать явно.
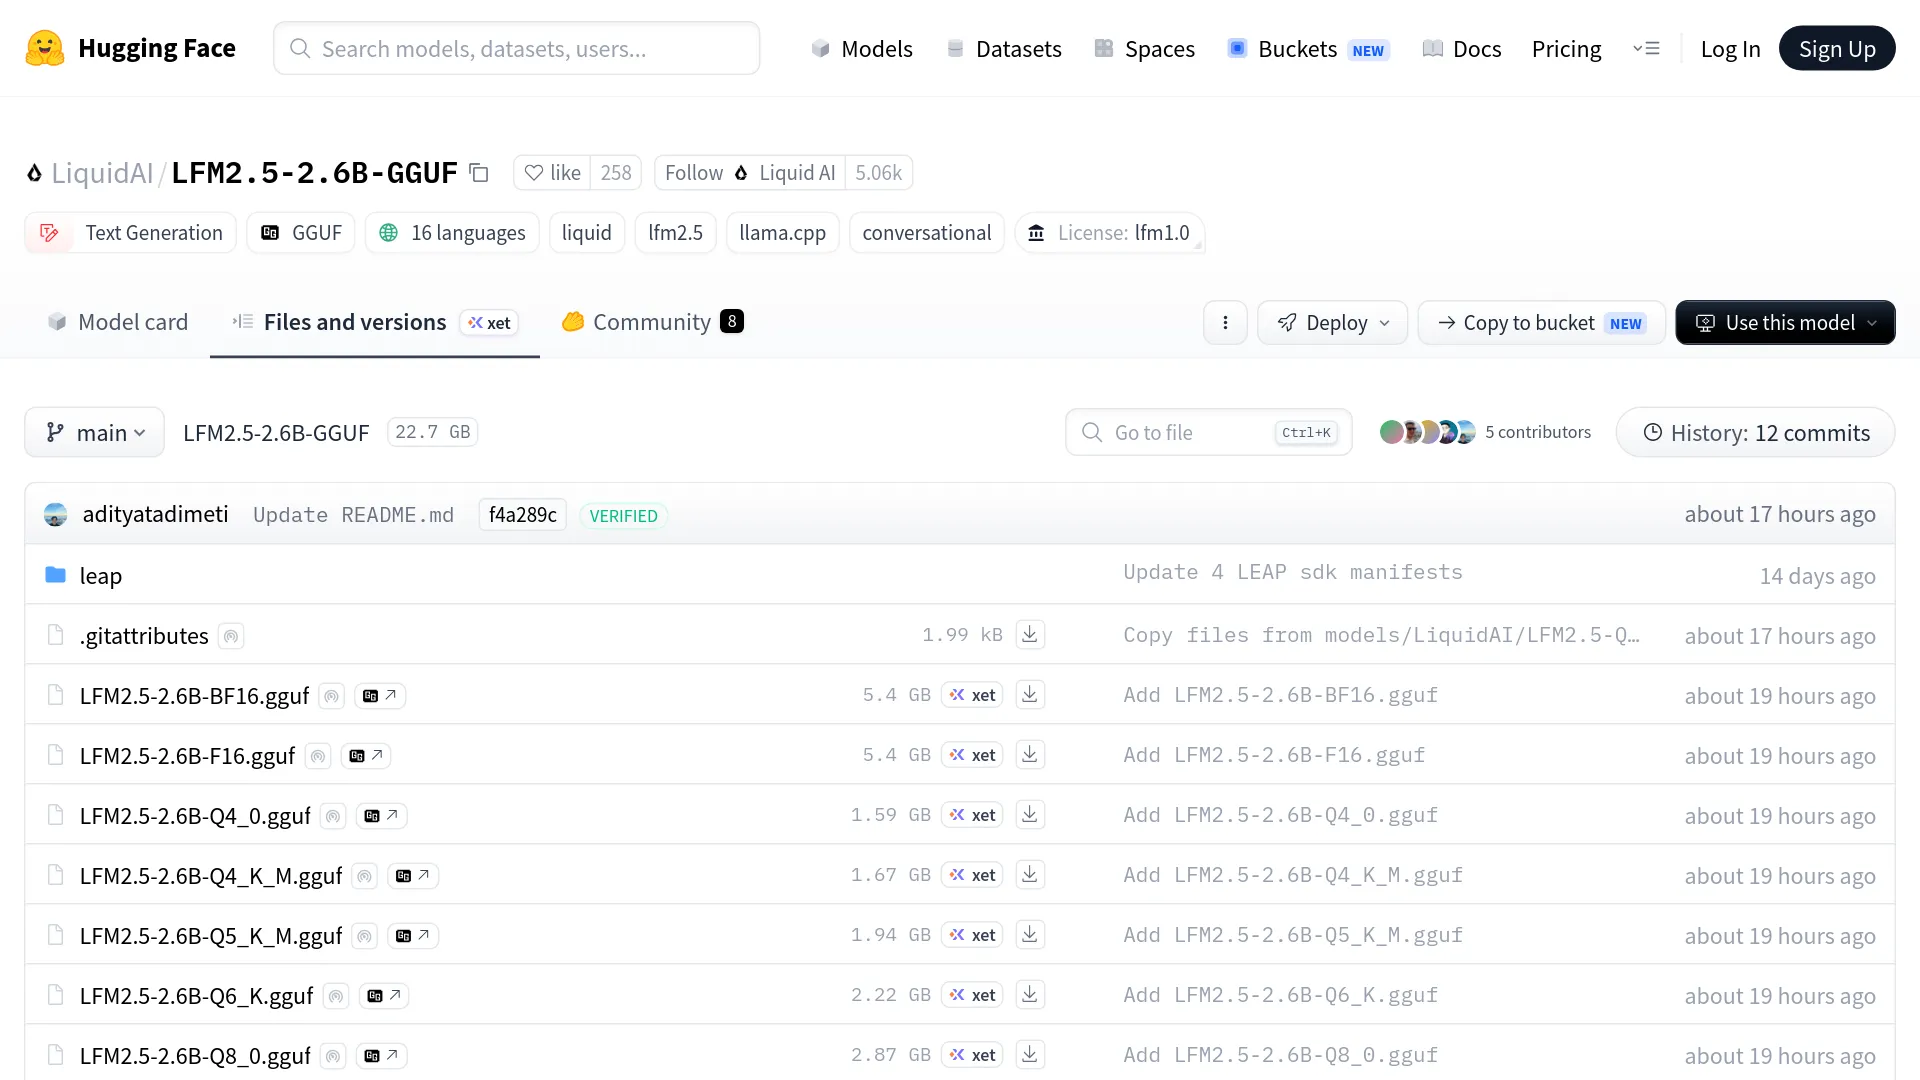
Путаница возникла уже в первые часы после релиза:
«Где его скачать? Вижу его на Hugging Face, но не понимаю, это обычная версия или QAD. Подскажите, пожалуйста?» — @Chitacc72 в X
Один из первых пользователей, @MarMarLabs, сравнил файлы в репозитории: старая и новая сборки Q4_0 отличаются примерно на 4 KB — в файловом менеджере разницы не увидеть. Решение одно: передать в --hf-file точное имя QAD-файла.
# официальный пример из анонса Liquid AI
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"

# 2.6B с параметрами сэмплирования из официальной model card
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1
Тот же принцип с --hf-file работает для репозиториев 230M и 1.2B-Instruct. Для серверного запуска @nicolasembleton опубликовал сокращённую рабочую команду после того, как обнаружил неполноту команд, сгенерированных HF: llama serve -hf LiquidAI/LFM2.5-2.6B-GGUF:QAD-Q4_0. Суффикс после двоеточия выбирает именно QAD-сборку.
Что говорят официальные тесты — и чего в них нет
В таблице бенчмарков Liquid AI каждый QAD-чекпойнт удерживает от 96,5% до 97,4% своего результата BF16. В набор входят GPQA Diamond, MMLU-Pro, IFEval, IFBench, Multi-IF и BFCLv4, а также GSM8K для двух младших моделей и AIME25 для двух старших. Все значения усреднены по пяти запускам.
| Чекпойнт | Сохранённое качество BF16 | Заявление по качеству | Скорость декодирования |
|---|---|---|---|
| LFM2.5-230M | 97,1% | соответствует Q5_K_M в пределах разброса | на 4–33% выше, чем Q5_K_M |
| LFM2.5-350M | 96,5% | соответствует Q5_K_M в пределах разброса | на 4–33% выше, чем Q5_K_M |
| LFM2.5-1.2B-Instruct | 97,4% | соответствует Q4_K_M | на 3–14% выше, чем Q4_K_M |
| LFM2.5-2.6B | 96,6% | соответствует Q4_K_M | на 3–14% выше, чем Q4_K_M |
Скорость измеряли на четырёх платформах: MacBook Pro и NucBox EVO-X2 с GPU, Samsung Galaxy S26 Ultra и Raspberry Pi 5 на Arm CPU. Для моделей 230M и 1.2B Liquid AI также заявляет, что QAD Q4_0 соответствует UD-Q4_K_XL от Unsloth — в анонсе этот вариант назван сильным внешним PTQ-чекпойнтом.
Но в публикации нет результатов по отдельным бенчмаркам, сырых значений токенов в секунду для устройств, размеров файлов, оценок RAM и полос разброса. Есть только проценты и заявления о сопоставимости. Сообщество сразу посчитало разницу в размере:
«То есть я могу заменить локальную LFM2.5-2.6B с F16 на QAD Q4_0 и перейти с 5,4 GB до 1,6 GB, с 21 до 64 tok/s … сохранив около 97% производительности BF16?» — @firedUp_Neyu, разбирая графики запуска Liquid
Часть расчёта с размером файлов верна: в официальном репозитории F16 занимает 5,4 GB, QAD Q4_0 — 1,59 GB. Значения tok/s пользователь считал с графиков, а не взял из текстовых данных Liquid AI.
Важные пробелы в анонсе
Если вы решаете, стоит ли переводить развёртывание на эти файлы, нужно учитывать три ограничения.
QAD есть только у четырёх чекпойнтов. На момент релиза QAD-сборок для LFM2.5-VL-450M и LFM2.5-8B-A1B не было; в ветке анонса на X пользователи уже просили Liquid AI выпустить версию для 8B. Если вы ориентируетесь на одну из этих моделей, QAD пока ничего не меняет.
Вопрос с imatrix остаётся открытым. QAD-файлы обучались под Q4_0, но были собраны без importance matrix. Наблюдатели за квантизацией обратили на это внимание сразу:
«GGUF QAD Q4_0 был создан без imatrix, хотя она также помогла бы качеству моделей, обученных под QAD». — u/Chromix_, r/LocalLLaMA
Модель меньше 3B всё ещё остаётся моделью меньше 3B. Компенсация потерь квантизации не поднимает потолок возможностей, и в обсуждении LocalLLaMA есть практические примеры. Один пользователь NPU пишет:
«Я только что реализовал LFM2.5 2.6B на своём NPU для саммари встреч. Для своего размера она впечатляет, но эти саммари всё же намного хуже того, что делают большие модели». — u/DerDave
Этот предел связан с самой моделью, а не с квантизацией. В отчёте KikoCis по квантизации у Q8_0 зафиксировано 0 из 6 решённых задач SWE-bench Verified. Пользователи 1.2B также сообщают, что качество заметно зависит от рантайма: в одной конфигурации Ollama модель выдавала бессмыслицу в 9 из 10 промптов, а в другой стабильно работала на одноплатном компьютере, потребляя менее 5W. Если для задачи критично качество уровня передовых моделей, проверить локальные ответы через большую модель с помощью недорогого LLM API будет стоить считаные центы даже для полного тестового набора.
QAD Q4_0 или Q4_K_M: что выбирать
Для развёртываний llama.cpp с ограниченной RAM на этих четырёх чекпойнтах QAD Q4_0 — основной 4-битный вариант от вендора, который стоит проверить первым. Файл занимает те же 1,59 GB, что и обычный Q4_0, но обучен достигать качества Q4_K_M у 1.2B и 2.6B либо Q5_K_M у 230M и 350M. При этом декодирование, по заявлению Liquid AI, быстрее на 3–14% или 4–33% соответственно. Если вы уже используете Q4_K_M и RAM хватает, менять ничего не обязательно: разница в 80 MB — не та проблема, которую решает QAD.
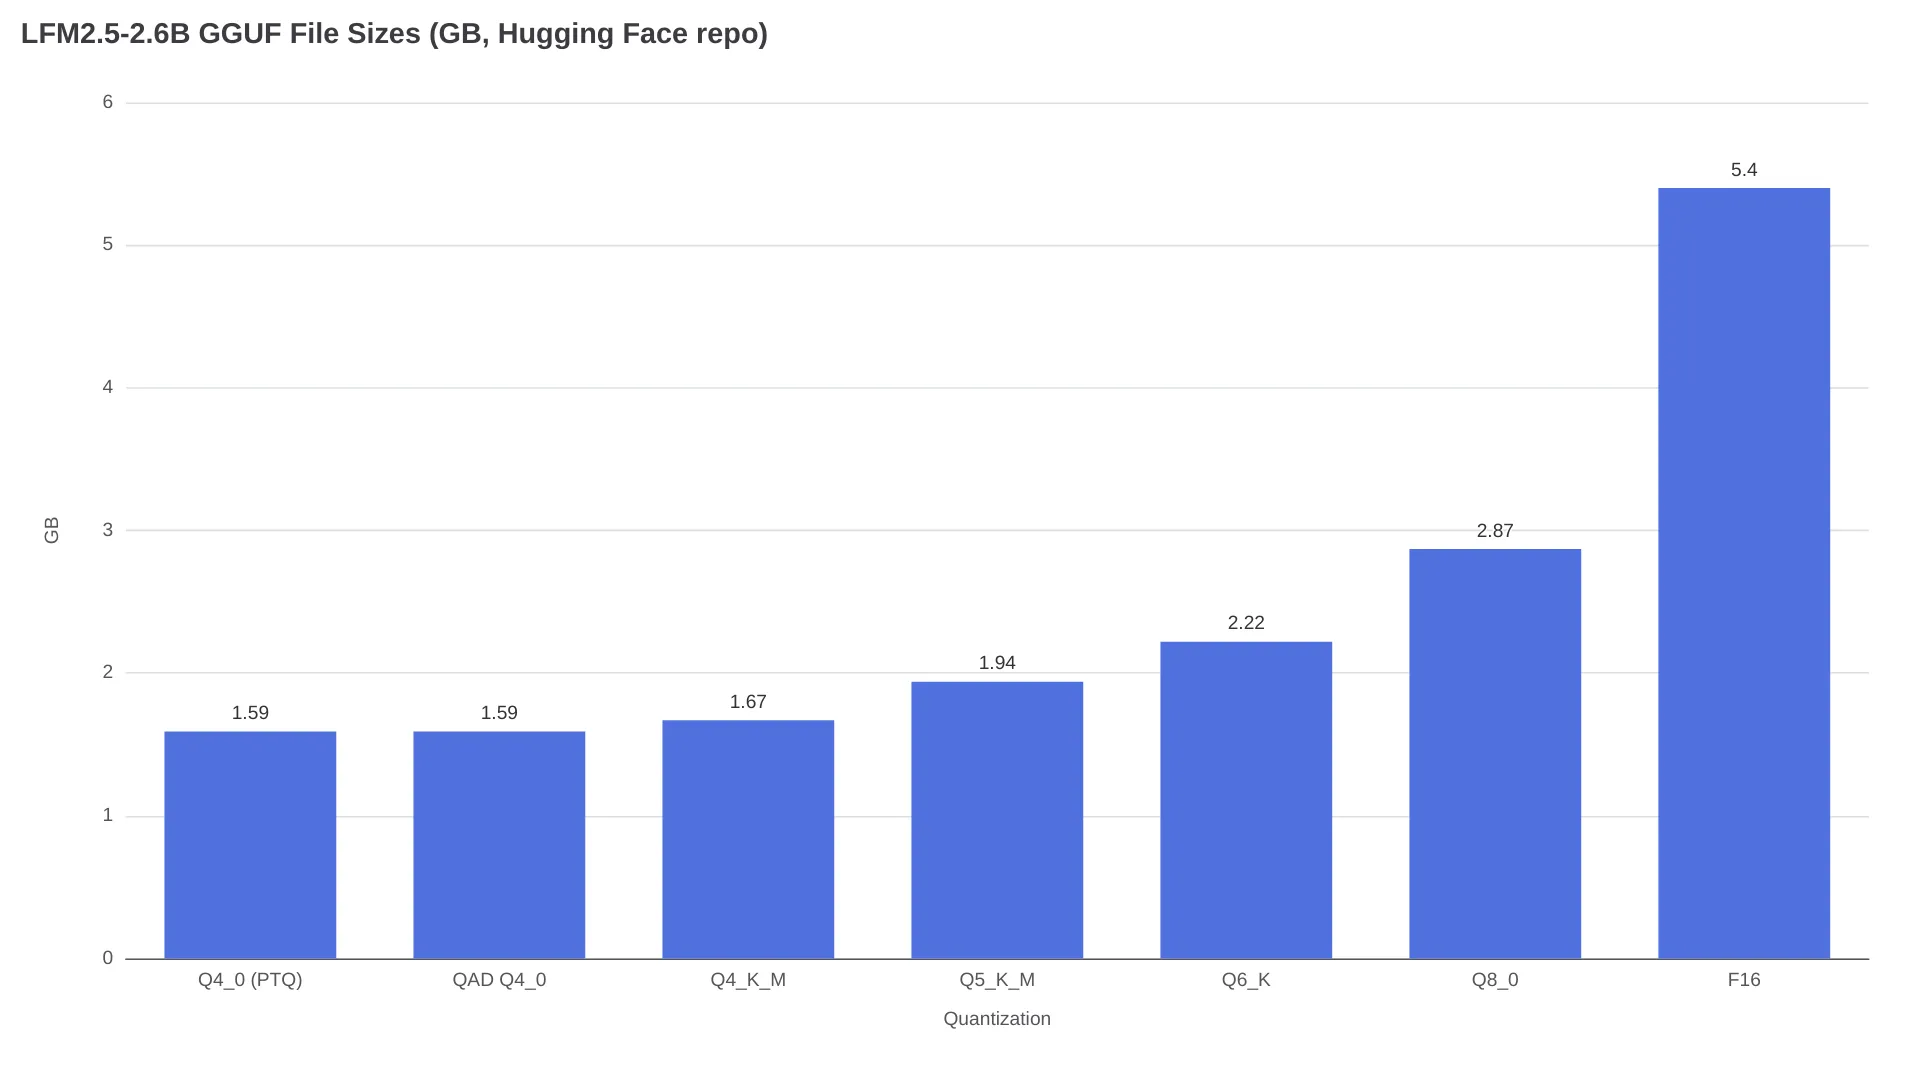
| Файл (2.6B) | Размер | Позиционирование | Когда выбирать |
|---|---|---|---|
| Q4_0 (старый PTQ) | 1,59 GB | базовая версия без исправлений | пропустить: теперь есть QAD |
| QAD Q4_0 | 1,59 GB | 96,6% от BF16, соответствует Q4_K_M | бюджет RAM 3–4 GB, декодирование на CPU, телефоны, Pi |
| Q4_K_M | 1,67 GB | выбор по умолчанию в документации Liquid | ваш рантайм не умеет выбрать QAD-файл |
| Q5_K_M | 1,94 GB | 91,4% top-1 относительно F16, по данным KikoCis | 6 GB+ RAM |
| Q6_K / Q8_0 | 2,22 / 2,87 GB | почти без потерь | 8 GB+, приоритет качества |
Для контекста: в PTQ-линейке KikoCis Q4_K_M показал 84,36% совпадения top-1 токена с F16 для этой модели, против 95,07% у Q6_K и 98,23% у Q8_0. Liquid утверждает, что QAD закрывает этот разрыв в 4-битной точности при том же объёме файла. Это их собственные результаты по пяти прогонам, без независимого подтверждения. Хорошая формулировка из обсуждения в день релиза:
«Это не “Q4_0 лучше K-квантов”. Просто эти четыре чекпойнта были обучены для Q4_0». — @MarMarLabs
Не стоит переносить этот вывод на другие модели. Их Q4_0-файлы по-прежнему являются обычным PTQ.
По памяти в анонсе цифр нет, поэтому можно ориентироваться на расчёты из репозитория KikoCis: KV-кеш 2.6B занимает около 16 KB на токен в f16, то есть примерно 0,54 GB при контексте 32K и 2,15 GB на нативном окне 128K. Параметры --cache-type-k q8_0 --cache-type-v q8_0 уменьшают это вдвое. Веса QAD Q4_0 на 1,59 GB вместе с окном 32K дают около 2,13 GB до накладных расходов рантайма; с 128K получается больше 3,7 GB. Поэтому 4 GB стоит считать пограничным вариантом и проверить реальное выделение памяти в вашем рантайме.
FAQ
QAD Q4_0 лучше Q4_K_M?
Для этих четырёх чекпойнтов, согласно данным Liquid AI, QAD Q4_0 соответствует по качеству Q4_K_M — либо Q5_K_M для двух младших моделей — при более высокой скорости декодирования и меньшем файле. Поэтому при ограничении по RAM ответ скорее да. Но это результаты вендора: пять повторов и пока без независимой репликации.
Ollama или LM Studio автоматически выберет QAD-файл?
Нет. Документированный вариант для Ollama — ollama run hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M, как указано на официальной странице репозитория; стандартные примеры Hugging Face тоже используют Q4_K_M. Любой рантайм с поддержкой GGUF может загрузить QAD-файл, но его нужно выбрать явным именем либо суффиксом :QAD-Q4_0.
Сколько RAM нужно LFM2.5-2.6B QAD Q4_0?
Веса занимают 1,59 GB. По расчётам KikoCis, f16 KV-кеш потребляет около 0,54 GB при контексте 32K и около 2,15 GB при 128K. Вместе с весами это примерно 2,13 GB на 32K и 3,74 GB на 128K до накладных расходов рантайма; квантизация KV-кеша в Q8_0 сокращает расход кеша вдвое.
У каких моделей LFM2.5 есть QAD-чекпойнты?
На 19 августа 2026 года — только у LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct и LFM2.5-2.6B. У вариантов VL-450M и 8B-A1B их нет, хотя пользователи уже просили Liquid AI о QAD-сборке 8B в ветке анонса.
Можно ли коммерчески использовать QAD-чекпойнты LFM2.5?
Репозитории помечены лицензией LFM Open License v1.0. В сообществах её условия резюмируют так: коммерческое использование разрешено организациям с годовой выручкой менее $10M USD; при $10M USD и выше потребуется отдельная коммерческая лицензия Liquid AI (сводка KikoCis). Перед выпуском продукта обязательно прочитайте полный текст лицензии.
Заявление о 97% подтверждено независимыми тестами?
Пока нет. Показатели сохранения качества в диапазоне 96,5–97,4% — это собственные средние Liquid AI по пяти прогонам, опубликованные вместе с релизом. На момент написания независимого бенчмарка QAD-файлов не появилось, а вопрос с imatrix всё ещё обсуждается на r/LocalLLaMA.
Сделайте свой A/B-тест сегодня
Важен не средний бенчмарк, а частота ошибок на ваших задачах. Возьмите десять реальных промптов — JSON для вызова инструментов, свою схему извлечения, свой язык — и прогоните оба файла с одинаковыми параметрами:
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"

llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-Q4_K_M.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"
Считайте для каждого файла ошибки парсинга и неверный выбор инструмента, а не ориентируйтесь на субъективное впечатление. Неразрешённый компромисс реален: по среднему качеству на гигабайт QAD Q4_0 выглядит предпочтительнее, но сбои именно в вашем развёртывании — пустые ответы, когда рассуждение съедает бюджет токенов, или уход от формата при заданной температуре — зависят от рантайма и задачи. Цену этому могут определить только ваши десять промптов.