 AIREITER
GLM-5.2 занимает второе место в Code Arena Frontend board с 1 595 Elo и отстаёт от Claude Opus 4.8 на FrontierSWE всего на один балл. Но разработчики всё равно ищут, на что с него перейти. Дело обычно не в качестве модели. После релиза в июне 2026 года в обсуждениях снова и снова всплывают три проблемы: квота Coding Plan заканчивается посреди задачи, в часы пик сервис выдаёт ошибки, а длинные агентные циклы съедают столько токенов, что ценник $1.40/$4.40 выглядит обманчиво. Выбор замены для GLM-5.2 зависит именно от того, с какой из этих проблем вы столкнулись.
Коротко: чем заменить GLM-5.2 в каждом сценарии
Сначала — пять выводов, а подробные обоснования будут ниже:
- Быстро уходят квоты / дорогие агентные циклы: DeepSeek V4 Flash — $0.14/M за входные и $0.28/M за выходные токены, контекст 1M.
- Нестабильные агентные циклы: Kimi K2.7 Code — $0.95/M за вход и $4.00/M за выход.
- Нужен максимум на самых сложных задачах: Claude Opus 4.8 — вдвое выше результат GLM-5.2 на SWE-Marathon, но и цены уровня закрытых моделей.
- Self-hosting или контроль над данными: Qwen3-Coder по Apache 2.0 либо собственные MIT-веса GLM-5.2, если для 4-битной сборки у вас есть 372–475 GB RAM.
- Вас всё устраивает, но хочется более свежую версию: GLM-5.3 — та же цена $1.40/$4.40, что Z.ai подтвердил в день запуска.
Сильные стороны GLM-5.2 и реальная цена эксплуатации
В официальной документации Z.ai GLM-5.2 описана как флагманская текстовая модель с контекстом 1M токенов, максимальным выводом 128K и API-тарифами $1.40/M за вход, $4.40/M за выход и $0.26/M за кэшированный вход. Веса распространяются по лицензии MIT. Они вышли 16 июня 2026 года, после запуска 13 июня, когда модель сначала была доступна только через GLM Coding Plan. В model card указаны такие результаты: Terminal-Bench 2.1 — 81.0 против 85.0 у Opus 4.8, SWE-bench Pro — 62.1 против 69.2, FrontierSWE — 74.4 против 75.1.
По качеству это почти закрытый передний край при ценах открытых весов. Однако на практике пользователи жалуются именно на эксплуатацию. Примерно в период запуска 5.2 тариф Pro в Coding Plan вырос с менее чем $35 до $65 в месяц — это изменение @bridgemindai зафиксировал в тот же день. Но сильнее, чем сама цена, раздражают ограничения по квотам:
«GLM 5.2 способна израсходовать ваш недельный лимит за один день». — u/intl_spy, r/opencode
«Мне нравится GLM-5.2, но, боже, сколько же она пожирает токенов». — @atomtanstudio
Один разработчик, использовавший GLM-5.2 для реальных задач с саморазвивающимися агентами, сообщил о расходах свыше $500 за одни выходные. Он отметил, что при смене модели в процессе теряется KV-кэш и приходится снова платить за тот же контекст (@Xianbao_QIAN). Другой пользователь чётко сформулировал предел ценности такого подхода:
«GLM 5.2 отличная, но моя подписка Codex за $200 в месяц даёт больше использования, чем API GLM 5.2 на те же $200. Это хорошая дополнительная модель... но точно не полноценная замена». — @mweinbach
Есть и проблема с доступностью в пиковые часы. @gengdaJ, подписчик плана ещё со времён GLM-4.5, рассказывает, что вечером серверы «взрываются» и приходится возвращаться к старым моделям. Вот почему альтернативы GLM-5.2 ищут даже те, кому сама модель нравится.
Альтернативы: цены и ситуации, когда стоит перейти
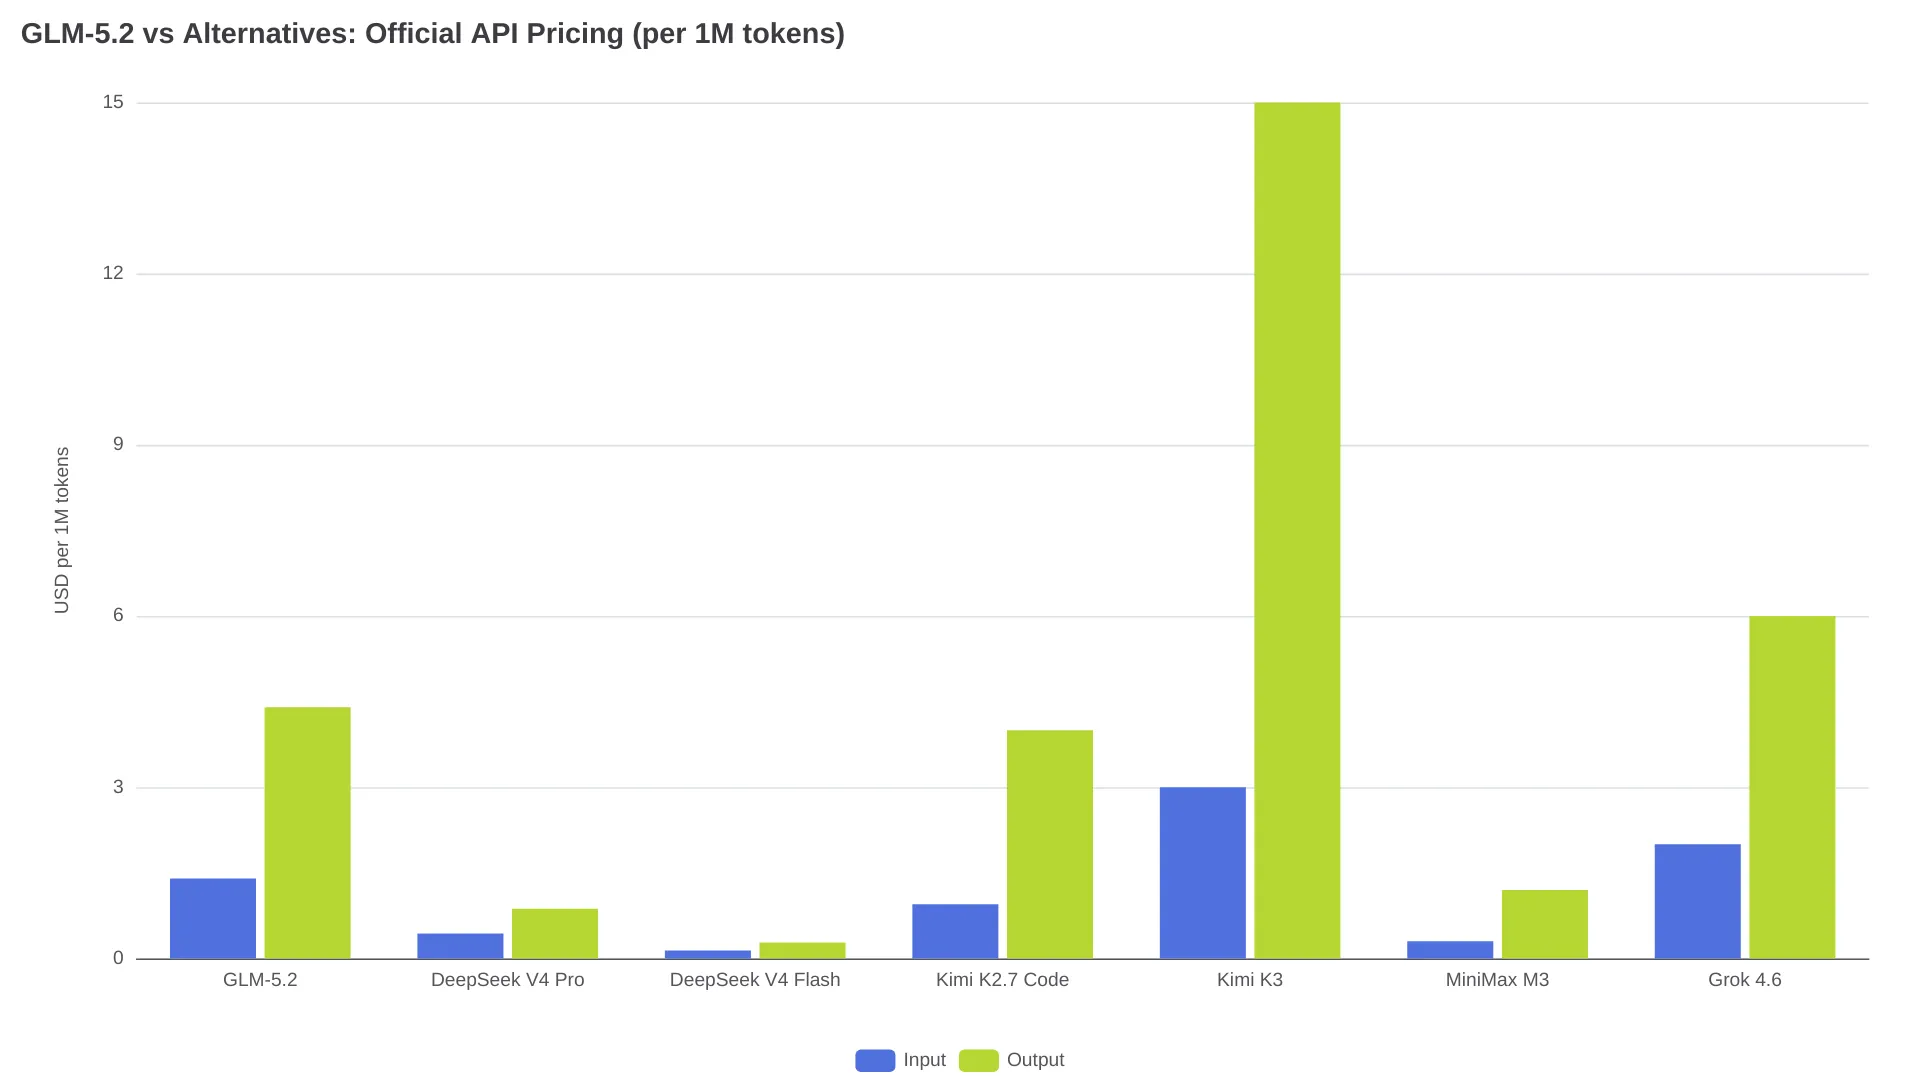
Все цены ниже взяты с официальных страниц поставщиков в августе 2026 года. Для Kimi K3 и MiniMax M3 указана цена входа без cache hit; при попадании в кэш тарифы значительно ниже.
| Модель | Контекст | Веса / лицензия | API-тариф ($/1M, вход / выход) | Переходите, если… |
|---|---|---|---|---|
| GLM-5.2 (база для сравнения) | 1M | MIT | $1.40 / $4.40 | — |
| DeepSeek V4 Pro | 1M | Открытые веса (MIT, по данным Layer3 Labs) | $0.435 / $0.87 | Нужно более дешёвое решение для сложных рассуждений с тем же контекстом |
| DeepSeek V4 Flash | 1M | Открытые веса | $0.14 / $0.28 | Главная проблема — расход квоты |
| Kimi K2.7 Code | 256K | Открытые веса (Modified MIT) | $0.95 / $4.00 | Стабильность агентных циклов важнее размера контекста |
| Kimi K3 | 1M | Закрытая | $3.00 / $15.00 | Нужна стабильность Kimi и контекст 1M |
| MiniMax M3 | 1M | Закрытая | $0.30 / $1.20* | Нужен мультимодальный вход или большой объём работы при чувствительности к цене |
| Qwen3.8 Max / Qwen3-Coder | 1M | Apache 2.0 | Веса бесплатны; hosted-варианты различаются | Цель — self-hosting или дообучение |
| Grok 4.6 | 500K | Закрытая | $2.00 / $6.00 | Важны скорость и большой, но управляемый контекст |
Помимо этих семи моделей, ниже есть ещё два пути обновления: Claude Opus 4.8 для команд, которым не даются самые сложные задачи, и GLM-5.3 для апгрейда внутри того же семейства по той же цене.
\* Тариф MiniMax M3 действует для входа ≤512K токенов; выше этого порога цены удваиваются. Согласно анонсу запуска Z.ai, GLM-5.3 стоит столько же, сколько GLM-5.2, поэтому в сравнении стоимости она не приведена.
Что выбрать в зависимости от проблемы
Квоты сгорают: отправляйте рутину в DeepSeek V4 Flash
Разница в цифрах огромна. Вход без cache hit у GLM-5.2 стоит $1.40/M, что в 10 раз дороже $0.14/M у DeepSeek V4 Flash. На выходе разрыв между $4.40 и $0.28 составляет 15.7 раза. В агентном цикле, где модель правит файлы, исправляет тесты и генерирует шаблонный код, эта разница накапливается на каждом шаге. При этом DeepSeek даёт тот же контекст 1M токенов и максимум вывода 384K. V4 Pro за $0.435/$0.87 сохраняет бо́льшую часть выгоды и рассчитана на более сложные задачи рассуждения; в нашем разборе GLM-5.2 vs DeepSeek V4 Pro показано, где сильнее каждая модель, а материал V4 Flash head-to-head посвящён бюджетному сегменту.
Пользователи OpenCode Go чаще приходят не к полной замене, а к разделению ролей: GLM-5.2 оставляют для планирования и ревью, а дешёвой модели отдают рутину. «Я использую OpenCode Go GLM 5.2 только для планирования», — пишет u/narkeeso. u/Endoky из того же сообщества формулирует это так: «используйте GLM 5.2 только как модель эскалации или для планирования».
Агентные циклы нестабильны: Kimi K2.7 Code
Если проблема в качестве сервиса, а не в возможностях модели, в изученных обсуждениях чаще всего называют Kimi. Один пользователь, изначально написавший это по-китайски, резюмировал ситуацию так:
«Возможности моделей примерно одинаковы, но именно неспособность обеспечить стабильную работу заставила меня выбрать Kimi вместо GLM». — @wonjder
Kimi K2.7 Code — профильный вариант для программирования: $0.95/M за вход, $4.00/M за выход и $0.19/M при cache hit. Контекст составляет 262,144 токена — четверть окна GLM-5.2, и это главный компромисс. Модель принимает текст, изображения и видео, поэтому закрывает и мультимодальный сценарий, который недоступен текстовой GLM-5.2. Если 256K недостаточно для вашего репозитория, у Kimi K3 есть окно 1M, но за $3.00/$15.00. Выход по $15 стоит в 3.4 раза дороже GLM-5.2: K3 выбирают ради стабильности, а не экономии. Бенчмарки разобраны в сравнении Kimi K2.7 Code vs GLM-5.2.
Нужен более высокий потолок на самых сложных задачах: Claude Opus 4.8
На SWE-Marathon, который включает сборки компиляторов, работу с ядром и многочасовые автономные задачи, Opus 4.8 набирает 26.0 против 13.0 у GLM-5.2. На NL2Repo результаты — 69.7 против 48.9, согласно model card Z.ai. В той же карточке GLM-5.2 названа самой высокорейтинговой открытой моделью на обеих досках, однако разрыв растёт именно по мере усложнения и удлинения задач. Opus — закрытая модель, её нельзя развернуть самостоятельно, а тарифы относятся к премиальному уровню. В материале GLM-5.2 vs Opus comparison подробно разобрано, когда эта переплата оправданна.
Self-hosting и контроль данных: Qwen3-Coder или собственные веса GLM
Qwen3-Coder и Qwen3.8 Max выходят по лицензии Apache 2.0, поддерживают контекст 1M токенов и имеют компактные варианты для запуска на одной GPU. И Layer3 Labs, и glm5.app рекомендуют их для self-hosting. Для дообучения и приватного развёртывания это наиболее практичный выбор среди перечисленных альтернатив; семейство разобрано в нашем материале Qwen 3.8 Max open-weights writeup.
Парадоксальный вариант — развернуть саму GLM-5.2, ведь лицензия MIT это разрешает. Но требования к железу суровые: веса в BF16 занимают 1.51 TB, а даже 4-битная квантизация из GGUF-релиза Unsloth требует для загрузки 372–475 GB памяти. На практике 4-битная сборка — это уровень многогпу-сервера, полный BF16 — уже кластера; локальный инструментарий пока молод: поддержку индексатора GLM-5.2 в llama.cpp добавили лишь 24 июля 2026 года, в PR #25407. Self-hosting GLM-5.2 — решение ради суверенитета данных, а не удобства. Если кластера нет, компактные варианты Qwen остаются альтернативой уровня рабочей станции.
Мультимодальность и недорогой поток задач: MiniMax M3
MiniMax M3 сочетает контекст 1M с мультимодальным входом при цене $0.30/M за вход и $1.20/M за выход в тарифе ≤512K. После этого порога обе ставки удваиваются, что стоит заложить в бюджет. Для команд у MiniMax есть токен-планы за $20/$50/$120 в месяц на линейку M3, M2.7, а также модели изображений и речи; квоты измеряются скользящими 5-часовыми и недельными окнами.
Когда главное — скорость: Grok 4.6
Grok 4.6 стоит $2.00/M за вход и $6.00/M за выход при контексте 500K. На странице API xAI заявлены лучшие в индустрии возможности для программирования и tool calling, но таблица бенчмарков не опубликована, поэтому это позиционирование стоит воспринимать именно как позиционирование. При этом пользовательский сигнал есть: @bourneliu66 пишет, что место GLM в его «большой тройке» заняла Grok — по его словам, более сильная, быстрая и дешёвая. Прежде чем принимать такую расстановку, проверьте её на собственной нагрузке.
Ничего не сломано, просто нужна свежая GLM: GLM-5.3
GLM-5.3 появилась в API 18 августа 2026 года по той же цене, что и GLM-5.2, согласно анонсу Z.ai. Если вы смотрите альтернативы не из-за реальной боли, а из опасения отстать от новой версии, в сравнении GLM-5.2 vs GLM-5.3 разобрано, что действительно изменилось.
Рабочая схема: оставить GLM-5.2, но понизить её роль
Во многих обсуждениях итогом становится не полный переезд, а новая роль для GLM-5.2: планировщик и ревьюер, тогда как исполнение берёт на себя более дешёвая модель. Это соответствует её профилю: Z.ai позиционирует её для долгих задач инженерных агентов, при этом в бюджетной группе она самая дорогая за токен.
У такой схемы есть два критичных нюанса. Первый — потеря KV-кэша: при смене модели или даже провайдера той же модели посреди запуска контекст оплачивается заново. Второй — разница между провайдерами: пользователи в r/opencodeCLI сообщают о большой разнице в скорости у Fireworks, NeuralWatt и OpenCode Go при обслуживании одной и той же модели.
Операционную часть решает единый OpenAI-совместимый endpoint: можно сохранить один формат запроса к GLM-5.2 API для обеих ролей, переключаться при деградации провайдера и получать один счёт. Но бесплатным контекст от этого не становится: кэш не переносится между моделями или провайдерами — именно это лежит в основе сообщения о $500 за выходные. Поэтому переключайте модель на границах задач, а не в середине запуска. Если ваша схема работает внутри Claude Code, настройка окружения описана в гайде GLM-5.2 in Claude Code guide.
Таблица выбора за 30 секунд
| Ваша проблема | Выбор | Чем придётся пожертвовать |
|---|---|---|
| Недельная квота уходит за день | DeepSeek V4 Flash | Часть качества агентного программирования по сравнению с GLM |
| Агентные циклы падают из-за ошибок провайдера | Kimi K2.7 Code | Контекст 1M: вместо него будет 256K |
| Не решаются самые сложные многочасовые задачи | Claude Opus 4.8 | Открытые веса, низкие цены, self-hosting |
| Веса должны работать на собственном железе | Qwen3-Coder | Лидирующее Elo качество GLM во frontend-кодинге |
| На обычных задачах модель съедает слишком много токенов | MiniMax M3 | После 512K входа цены удваиваются |
| Регулируемая сфера или требования закупок | Самостоятельно развёрнутые веса Qwen или GLM | Удобство управляемого сервиса |
| Нужна самая новая GLM | GLM-5.3 | Ничем: цена та же |
FAQ
Какая альтернатива GLM-5.2 лучшая в целом?
DeepSeek V4 Pro — наиболее близкая универсальная замена: контекст 1M, открытые веса и цена за токен в 3–5 раз ниже. Kimi K2.7 Code лучше подойдёт тем, для кого надёжность долгих агентных запусков важнее разницы в бенчмарках.
DeepSeek лучше GLM-5.2 для программирования?
Для сложных алгоритмических рассуждений в сравнении glm5.app выше ставят DeepSeek V4 Pro. Для долгих многофайловых агентных задач GLM-5.2 остаётся впереди благодаря контексту 1M и обучению на длительных агентных траекториях — это заявленная специализация Z.ai. На практике: DeepSeek исполняет, GLM планирует.
Какая альтернатива GLM-5.2 самая дешёвая?
DeepSeek V4 Flash: $0.14/M за вход и $0.28/M за выход. Вход при cache hit стоит $0.0028/M, то есть повторно используемый контекст обходится практически бесплатно.
Какие альтернативы имеют такой же контекст в 1M токенов, как GLM-5.2?
Окно в 1M токенов заявлено у DeepSeek V4 Pro, V4 Flash, Kimi K3, MiniMax M3 и Qwen3.8 Max. У Kimi K2.7 Code оно составляет 256K, у Grok 4.6 — 500K.
Можно ли запустить GLM-5.2 локально вместо перехода на другую модель?
Технически да: доступны веса по лицензии MIT. Но 4-битная сборка требует 372–475 GB RAM, а поддержка в llama.cpp была добавлена только 24 июля 2026 года. Для большинства команд hosted API остаётся единственным практичным вариантом.
Сколько альтернативы GLM-5.2 стоят в месяц по подписке?
Токен-планы MiniMax стоят $20–$120 в месяц. Code CLI от Kimi начинается от $19 в месяц, а Coding Plan от Z.ai — от $18 в месяц, согласно обзору тарифов Digital Applied; после июньского повышения тариф Z.ai Pro стоит $65.