 AIREITER
28 октября 2026 года Google представила Gemini 4 Carbon — свою самую мощную модель на сегодняшний день. Она возглавила Artificial Analysis Intelligence Index v5.0 с результатом 59. Но попробовать её прямо сейчас смогут далеко не все: на этой неделе доступ выдают только проверенным специалистам по киберзащите через программу Fairwind, а публичного идентификатора модели для API пока нет.
До анонса трекеры называли Carbon неподтверждённой утечкой. Теперь Google раскрыла результаты тестов и цены, а в этом материале мы сопоставим официальные заявления с независимой оценкой Vals.ai и планом, как продолжать разработку на Argon уже сейчас.
Можно ли вызвать Gemini 4 Carbon уже сегодня?
Нет. По состоянию на 28 октября 2026 года Gemini 4 Carbon анонсирована, но ещё не доступна разработчикам, компаниям и обычным пользователям. В течение недели анонса Google открывает доступ ограниченной группе специалистов по кибербезопасности, затем — проверенным партнёрам через программу Fairwind. Более широкий запуск обещают провести как можно скорее, но точной даты нет.
Такой поэтапный запуск нужен для тестирования модели в кибербезопасности без защитных ограничений и дополнительной проверки безопасности совместно с правительственными структурами США. Google продолжает дорабатывать защитные механизмы. Публичный ID модели, её карточка в AI Studio и лимиты запросов пока не опубликованы.
Это уже не тот статус, который был на прошлой неделе. До 28 октября документация Google для разработчиков указывала в качестве API-модели Gemini 4 только gemini-4-argon, а трекеры справедливо отмечали, что у Carbon нет собственного ID. Тогда это было верно, но теперь устарело: Carbon существует как анонсированный продукт, просто вызвать его через endpoint пока нельзя.
Если сегодня какой-то провайдер предлагает модель с именем gemini-4-carbon, относитесь к такому предложению с осторожностью. До подтверждения провайдер должен указать исходную модель, тип маршрута — публичный, ограниченный, экспериментальный или алиас — и необходимые разрешения. Одна запись в каталоге ещё не доказывает, что провайдер действительно направляет запросы к этой версии модели.
Для каких задач предназначен Carbon
Gemini 4 Carbon создавали не для коротких диалогов, а для длительной инженерной работы, которая может занимать несколько дней. По словам Google, внутренние команды наблюдали, как модель продолжала работу после неудачных попыток: находила причины трудноуловимых ошибок, исправляла их в больших кодовых базах и решала задачи на низком уровне систем.
Такое позиционирование сформировалось из отзывов пользователей о программировании, агентных сценариях, научных задачах, full-stack-разработке и мультимодальном понимании. Из внешних рейтингов Google здесь ссылается на WebDev Arena: Carbon набрала 89 Elo и достигла 1768, заняв 4-е место. В Google связывают этот результат с более высоким качеством ответов и создаваемых артефактов.
Кроме того, Google заявляет более чем двукратный рост успешной генерации безопасного кода по сравнению с Gemini 4 Argon во внутренних тестах. Но абсолютные значения не раскрыты: неизвестны исходный показатель, размер датасета и распределение по языкам. Поэтому воспринимать этот множитель стоит как указание на направление развития, а не как достаточное основание для миграции. Похожая проблема есть и с заявлением команды Chrome о более чем десятикратном превосходстве над крупной frontier-моделью другой лаборатории по качественным патчам: конкурент не назван, а сама метрика не определена.
Argon вышла в середине октября 2026 года; Carbon занимает более высокую позицию в той же линейке и системе безопасности.
Кибербезопасность: что показывают цифры и чего в них не хватает
Главное отличие Carbon — полный цикл работы с киберугрозами: найти уязвимость, проверить возможность её эксплуатации и устранить первопричину. Google подчёркивает, что все три внешние оценки проводились без защитных ограничений. Они показывают базовые возможности модели, а не то, что разрешит защищённый production-endpoint.
| Этап | Бенчмарк | Результат Carbon | Что проверяется |
|---|---|---|---|
| Поиск | SEC-bench Pro | 88,2% | Автономный поиск реальных уязвимостей в настоящем ПО |
| Эксплуатация | ExploitGym | 54,8% | Проверка того, действительно ли уязвимость можно эксплуатировать |
| Исправление | CWE-bench | 71,0% | Устранение первопричин рабочим кодом |
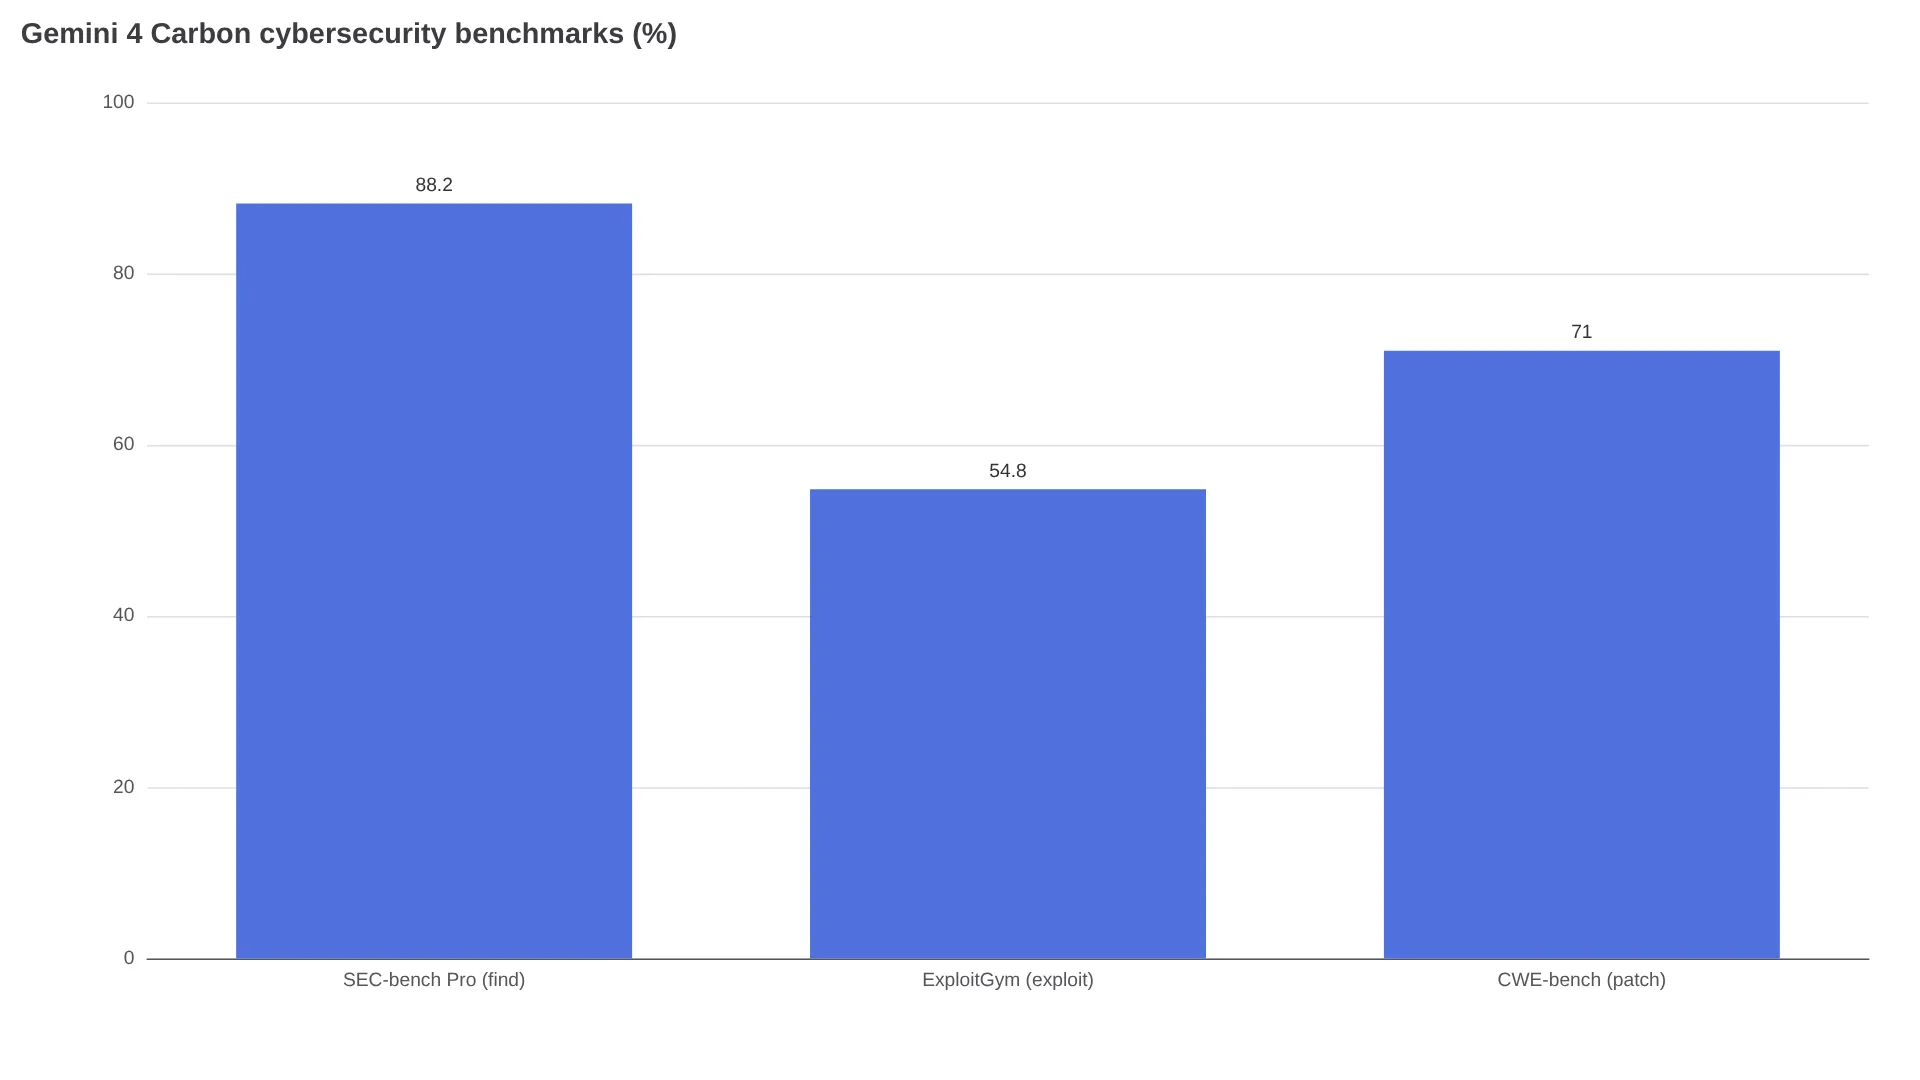
Здесь важнее самих процентов три оговорки. Во-первых, нельзя перемножать 88,2% × 54,8% × 71,0% и получать показатель сквозного успеха: каждый результат рассчитан на отдельном наборе задач. Во-вторых, обнаружение уязвимостей (88,2%) обычно проще автоматизировать, чем безопасное исправление (71,0%), а эксплуатация (54,8%) требует наибольшего планирования. Поэтому снижение показателей по этапам ожидаемо. В-третьих, заявление Google и Wiz о лидерстве в веб-пентестинге в рамках инициативы Scan for Good не содержит ни названия бенчмарка, ни результата, поэтому сравнивать его с остальными цифрами нельзя.
Практический вывод такой: Carbon выглядит особенно полезной как помощник для сортировки задач и исправления уязвимостей в командах с большими очередями, а не как полностью автономная red team. Именно возможность эксплуатации — одна из причин, по которым доступ к модели изначально ограничен.
Безопасность и надёжность: 0% читерства и 0% успешных prompt injection
Второе крупное заявление Google касается надёжности модели под нагрузкой, и здесь приведены необычно точные цифры. На Terminal-Bench 4.0 Carbon показала 0,0% успешных попыток читерства и 0,4% попыток читерства при сохранении общей точности на прежнем уровне. В живых внутренних средах разработки количество предупреждений о серьёзных проблемах согласованности снизилось почти на 80%.
Устойчивость к prompt injection также выросла в тесте Gray Swan Indirect Prompt Injection. Предыдущий лучший результат Argon составлял 0,7% успешных атак; для Carbon Google указывает 0,0%, то есть в опубликованной оценке успешных атак не зафиксировано. Также заявлено на 26% меньше выходов за рамки задачи и на 29% меньше недовыполнения по сравнению с предыдущим базовым уровнем — это трактуется как более надёжное выполнение многошаговых задач в заданных пределах.
Но для воспроизведения этих результатов не хватает исходных данных. Google не раскрывает число атак, стоящее за показателем 0,0%, базовую частоту предупреждений до снижения почти на 80%, правила оценки выхода за рамки и недовыполнения, а также методику обнаружения читерства. Направление выглядит обнадёживающим для агентных систем, однако собственные журналы вызовов инструментов и защиту веток всё равно нужно сохранять. Внутренний стек Google — обучение, защита от злоупотреблений в реальном времени, устойчивость к prompt injection и мониторинг рассуждений — автоматически не переносится в ваш harness.
Независимая проверка: у Vals.ai второе место, а не первое
Одних тестов производителя недостаточно, поэтому Vals.ai опубликовала собственную оценку 28 октября 2026 года. В общем рейтинге Vals Index Carbon заняла 2-е место из 29 с результатом 70,36% (±0,97): между Claude Sonnet 5.5 с 70,85% и Claude Opus 5.5 с 70,18%. Тестирование стоило $10,51, а оценка при высоком уровне рассуждений заняла 47 минут 45 секунд.
Разбивка по тестам здесь полезнее самого места в рейтинге. Carbon заняла 1-е место из 87 в Legal Research Bench и 1-е из 33 в Vals Finance Index, 2-е из 35 в EMB v1.1 и 4-е из 57 в Terminal-Bench 4.0 с результатом 63,13%. Самый слабый опубликованный результат — 17,50% в HLAB-Vals-1.1 (6-е место из 30). В Vibe Code Bench v1.1 модель получила 89,06%, но заняла только 8-е место из 121: показатель высокий, но конкуренция плотная.
Преимущество Carbon сосредоточено в исследовательских, финансовых и юридических агентных задачах, а также в программировании, но равномерного лидерства по всем направлениям нет. Vals указывает контекстное окно в 1 миллион токенов, закрытые веса и цену $4 за миллион входных токенов / $20 за миллион выходных после завершения вводного периода — эти цифры совпадают со стандартными тарифами Google ниже. Vals предупреждает, что для разных бенчмарков могли использоваться разные провайдеры или параметры, поэтому перед публикацией отдельных результатов стоит проверить конфигурацию каждого теста.
Трекеры, публиковавшие информацию до анонса, появились раньше обновлений с ценами и результатами Vals; в одном подробном разборе до сих пор сказано, что цена не опубликована.
Сколько будет стоить API после открытия
Google опубликовала цены Carbon одновременно с анонсом — они такие же, как у Argon на стартовом этапе. Срок действия вводных тарифов не указан, как нет пока и отдельной таблицы с подписками или лимитами запросов.
| Тип токенов | Вводная цена | Стандартная цена |
|---|---|---|
| Входные | $2,00 / 1M | $4,00 / 1M |
| Выходные | $10,00 / 1M | $20,00 / 1M |
| Кэшированные входные (скидка 95% на входные) | ~$0,10 / 1M | ~$0,20 / 1M |
Цены на кэшированные входные токены рассчитаны отдельно, а не приведены Google напрямую: скидка 95% от $2 даёт $0,10, а от $4 — $0,20. Такой дисконт особенно важен для длинных агентных сессий с повторно передаваемым контекстом кода, но выходные токены всё равно останутся главной статьёй расходов: они в 5 раз дороже входных.
Не стоит планировать бюджет только по тарифной таблице. Считайте стоимость одного принятого результата: общие расходы, включая повторы, отброшенные ответы, повторную передачу контекста и вызовы для исправлений, нужно делить на число принятых результатов. Более дешёвый маршрут, которому нужны три дополнительных прохода исправлений, регулярно оказывается дороже варианта, который выдаёт рабочий результат с первой попытки. Google не раскрыла задержку и пропускную способность Carbon, поэтому сравнения токенов в секунду пока будут спекуляцией.
По теме текущих расходов: цены и доступность Gemini 4 Argon API и что мы знаем о Gemini 4.
Почему первые тестировщики недовольны
В обзоре TestingCatalog от 23 октября ранние тестировщики описывают один и тот же компромисс: 3D-генерация заметно лучше, чем у Argon, но ответы приходят гораздо медленнее, а фронтенд и UI по-прежнему остаются слабыми. Один из тестировщиков оценил замедление примерно в 2–4 раза в зависимости от задачи.
В обсуждениях реальных пользователей доступ к модели вызывает больше раздражения, чем сами результаты бенчмарков:
Я действительно не понимаю стратегию Google по выпуску моделей. Gemini 4 Carbon впечатляет в бенчмарках, но люди снова не могут ею пользоваться. Доступ сначала ограничен, а даты общего запуска нет.
В разных обсуждениях повторяются одни и те же жалобы: непредсказуемый расход квоты у Argon, достижение часовых лимитов уже через пятиминутные сессии и фрагментация версий между Gemini App, AI Studio и Antigravity. Другой тестировщик сформулировал главную проблему проверки так:
Только проверенные специалисты по кибербезопасности получат доступ на этой неделе, более широкий выпуск обещают «скоро». Моё мнение: результат в рейтинге, полученный внутри собственного окружения производителя, — это лишь половина картины. Подождём, пока кто-нибудь прогонит модель в нейтральной системе.
Что делать с разработкой на этой неделе
Не стоит ставить разработку на паузу в ожидании Carbon. Практичный вариант — выпускать продукт на подтверждённой модели, а новую держать в качестве подключаемого кандидата.
- Начните с
gemini-4-argonи используйте её документированный API. Базовый URL, API-ключ и ID модели держите за пределами бизнес-логики. - Соберите набор из 30–50 задач на основе собственного репозитория: исправления ошибок, рефакторинг и проверки безопасности. До появления Carbon зафиксируйте долю успешных решений, время ревью и стоимость одного принятого результата.
- Заранее добавьте защитные механизмы, которые всё равно понадобятся для многодневных запусков: работу через отдельные ветки, лимиты расходов, аудит вызовов инструментов, контрольные точки и этапы обязательной проверки человеком.
- Когда для вашего аккаунта появится документированный маршрут к Carbon, добавьте его как кандидата, повторно прогоните тот же набор задач и сравните качество, задержку, стоимость и поддержку функций — потоковой передачи, изображений, function calling и структурированного вывода — прежде чем переводить трафик. Начинайте новые сессии, а не меняйте модель посреди задачи.
Командам с большими очередями AppSec стоит дополнительно записывать каждый вызов инструмента и проверять собственный репозиторий на читерство в стиле бенчмарков — например, жёстко заданные ответы или редактирование тестовых файлов. Показатель Google в 0,0% относится к их harness и не является гарантией для вашего.
| Ситуация | Что делать на этой неделе |
|---|---|
| Нужно выпустить агента или помощника по безопасности | Использовать Argon через API и собирать данные о стоимости и задержке |
| Единственное препятствие — результаты Carbon в кибербезопасности | Публичного способа подать заявку нет; следить за анонсом Fairwind от Google |
| Вы выбираете между Carbon, Opus 5.5 и GPT-6.1 Terra | Дождаться независимых повторных тестов; сейчас Vals ставит Sonnet 5.5 выше всех в общем рейтинге, а Opus 5.5 — сразу за Carbon |
| Важны цена и длинный контекст | С самого начала проектировать систему с учётом кэширования входных токенов; итоговый счёт определит объём выходных данных |
Gemini 4 Carbon: FAQ
Доступна ли Gemini 4 Carbon через API?
Публично — нет. На неделе анонса доступ ограничен специалистами по кибербезопасности, затем его расширят на проверенных партнёров Fairwind. Для разработчиков, компаний и обычных пользователей даты нет. Начинайте с Argon и оставьте ID модели настраиваемым.
Какой ID у Gemini 4 Carbon?
Google его не публиковала. Не предполагайте, что gemini-4-carbon заработает. Используйте только тот идентификатор, который провайдер явно документирует вместе с endpoint, разрешениями и ценами.
Сколько стоит Gemini 4 Carbon?
Вводная цена составляет $2 за миллион входных и $10 за миллион выходных токенов; кэшированные входные токены дешевле на 95% (~$0,10). После вводного периода стандартная цена составит $4 за входные и $20 за выходные токены (~$0,20 за кэшированные). Срок действия вводного периода не указан.
Чем Carbon отличается от Argon?
Google заявляет более чем двукратный рост в генерации безопасного кода, на 26% меньше выхода за рамки задачи, на 29% меньше недовыполнения и 0,0% успешных prompt injection против 0,7%. Независимые данные Vals опубликованы только для Carbon; разницу с Argon стоит считать внутренним результатом Google, пока не появятся нейтральные повторные тесты.
Превосходит ли Carbon Claude Opus 5.5 или GPT-6.1 Terra?
Прямого контролируемого сравнения пока нет. Один отзыв сотрудника до запуска, приведённый GetAICodingAgent, утверждал, что по программированию Carbon ощущается как Opus 5.5. В общем рейтинге Vals Carbon (70,36%) лишь немного опережает Opus 5.5 (70,18%), но уступает Sonnet 5.5 (70,85%). Результаты контролируемого сравнения Carbon с Terra не публиковались.
Когда состоится общий запуск?
Google обещает открыть доступ как можно скорее после этапов для специалистов по кибербезопасности и партнёров, но даты не называет. Следите за официальным блогом DeepMind и каталогом моделей своего провайдера, а не за обсуждениями утечек.