 AIREITER
Меню кафе с четырьмя ценами кажется простой задачей — пока модель не меняет одну цифру. MOSS Image заметно лучше своего размера справляется именно с таким текстом, но при одном условии: ей нужна чёткая структура, а финальный результат всё равно придётся вычитывать как дизайнерский макет.
В этом обзоре проверяется именно этот компромисс. MOSS Image — текст-в-изображение модель с 5B параметров под лицензией Apache 2.0: она принимает промпты до 4 096 токенов и опциональные JSON bounding boxes для текста и объектов. Команда OpenMOSS выпустила Base- и SFT-чекпойнты 16 октября 2026 года, а 20 октября на платформе MOSI заработал hosted API. Для постеров, меню, этикеток и инфографики с точными надписями модель стоит протестировать. Если же важнее постоянство персонажей или редактирование фотографий, лучше остаться на закрытых моделях.
Текст сохраняется, эстетика — не всегда
Главное достоинство MOSS Image — не универсальная красота картинок, а длинный и точный текст. В собственном бенчмарке LongLongTextBench разработчик заявляет среднее покрытие текста Mean-6 на уровне 96.3: 97.1 для длинного английского и 92.4 для длинного китайского в 240 заданиях со средней длиной около 1 340 символов. Для сравнения, GPT Image 2 получил 99.0, а Nano Banana Pro — 96.6. Это цифры разработчика на созданном им же тесте, поэтому их стоит воспринимать как проверяемое заявление, а не как гарантию.
Второй важный показатель — следование макету. В техническом отчёте, разобранном в этом обзоре, для теста 7Bench с bounding boxes указаны 0.88 mIoU и 0.70 Layout AUC. Это примерно вдвое выше Ideogram 4 с 0.44 и 0.20, а также заметно лучше GPT Image 2 с 0.30 и 0.16 в том же отчёте. На RealLayoutArena — 61 задаче со слепой оценкой постеров, инфографики и UI — полная система MOSS с улучшением промпта набрала 1 698.70 Elo и заняла второе место после GPT Image 2 с 1 844.35. При этом сам backbone вышел на первое место, когда все генераторы получали одинаковый улучшенный промпт. Но и эти результаты получены разработчиком и ждут независимой проверки.
Небольшой контролируемый тест хорошо показывает разницу на практике. Команда mossimage.run один раз запускала MOSS Image SFT и FLUX.1 dev на каждый промпт: одинаковый холст 1024x1024, одинаковые seed, без отбора удачных результатов; неудачные генерации тоже остались в выборке. В рамках этого обзора я не повторял тесты задержки MOSI hosted API: приведённые в таблице результаты — первые генерации той команды через endpoints fal, а сам MOSI API оценивается по документации и статусу бесплатного периода.
| Тест | Что требовалось в промпте | Первая генерация MOSS Image SFT | Первая генерация FLUX.1 dev |
|---|---|---|---|
| Меню кафе | MORNING MENU и Espresso 3.50, Flat White 4.20, Butter Croissant 3.80, Avocado Toast 8.50 с выравниванием по правому краю | Все четыре позиции и цены переданы без изменений | Макет понятный, но 3.80 превратилось в 3.60 |
| Этикетка мёда | WILDFLOWER HONEY, Raw & Unfiltered, Net Wt. 12 oz (340 g) по изгибу этикетки | Все три строки переданы без изменений | Заголовок и вес верны, но средняя строка стала Raw & Unfilterelrd |
| Двуязычный постер | 周末市集 / WEEKEND MARKET, Sat 10:00–18:00, Riverside Park, Free entry / 免费入场 | Китайские и английские детали переданы как задано | Сильная композиция, но китайский текст искажён, а время стало 10.00–178.00 |
Для MOSS использовались 50 шагов и CFG 3, для FLUX — 28 шагов и guidance 3.5, через fal-ai/moss-image и fal-ai/flux/dev. Как отмечает сама страница, по трём примерам нельзя объявлять победителя. Но важен тип ошибки: убедительная картинка с одной изменённой ценой или временем хуже, чем явно сломанная генерация.
"MOSS Image хорошо справился со структурированным макетом и английским текстом для модели на 5B параметров. Не идеально в каждой мелочи, но рабочий процесс наконец-то ощущается управляемым." — @Olaemmy1200, автор видео с полным workflow создания постера
Что скрывается за API: компактный генератор и большой текстовый энкодер
MOSS Image — однопоточный diffusion transformer с 42 слоями, обученный с нуля. Указанные 5B параметров относятся только к генератору. Вокруг него работают замороженный текстовый энкодер Qwen3.5-9B, который читает промпт, и VAE-декодер FLUX.2 small, отвечающий за пиксели. Этим объясняются и сильные стороны, и требования к железу: понимание длинного двуязычного запроса обеспечивает 9B-«читатель», а не denoiser на 5B параметров.
Практическое преимущество модели — контекстное окно. Обычный текст, последовательности тегов и JSON-макет вместе могут занимать до 4 096 токенов. Этого достаточно, чтобы расписать все строки постера, а не сводить задачу к короткой подписи. В документации MOSI API лимит hosted-версии описан как длинный текст до 4 000 символов; поддерживаются рендеринг текста, negative prompts и генерация макетов. Рекомендуемый размер результата — 1–2 мегапикселя, доступна экстраполяция от 512x512 до 2K, а размеры должны делиться на 16.
На результат влияют два чекпойнта:
- MOSS-Image-SFT — Base, дообученный supervised fine-tuning на отобранных данных. Команда OpenMOSS рекомендует его для прямой генерации: у него аккуратнее группировка текста и чище макеты. Hosted API по умолчанию отдаёт
moss-image-sft-1.0; для воспроизводимости доступен зафиксированный snapshotmoss-image-sft-1.0-2026-10-09. - MOSS-Image-Base не проходит post-training и CFG distillation, чтобы сохранить исходный обучающий сигнал. Официальное руководство адресует его тем, кто будет дообучать модель, и рекомендует замораживать text encoder. Выбирайте Base для обучения LoRA или работы с другим распределением стилей, а не для постера, который нужен сегодня.
Согласно model card на Hugging Face и официальной странице проекта, оба набора весов и поставляемый код инференса опубликованы по Apache License 2.0. Лицензия разрешает коммерческое использование и fine-tuning, но не очищает права на персонажей, логотипы или внешность людей, которые вы генерируете для кампании. Для любого коммерческого проекта сохраняйте файл лицензии и точную ревизию. Код опубликован в репозитории OpenMOSS на GitHub.
JSON-разметка — причина мириться с этим workflow
Обычные текстовые промпты тоже работают, но именно синтаксис макета заставляет дизайнеров пробовать эту модель. Структурированный промпт описывает всю сцену, а затем задаёт отдельные подписи и области для каждого текста или объекта. Boxes направляют генерацию, но не являются векторными слоями и не гарантируют попиксельную точность.
Система координат почти всегда вызывает ошибки при первом запуске. При bbox_coord_space: "abs_centralized" и bbox_format: "yxyx" каждый box задаётся как [y_min, x_min, y_max, x_max] в пикселях относительно центра холста. Для изображения 1024x1024 каждая ось идёт от -512 до +512. Не вставляйте сюда обычные координаты от верхнего левого угла или community-разметку 0–1000 без конвертации.
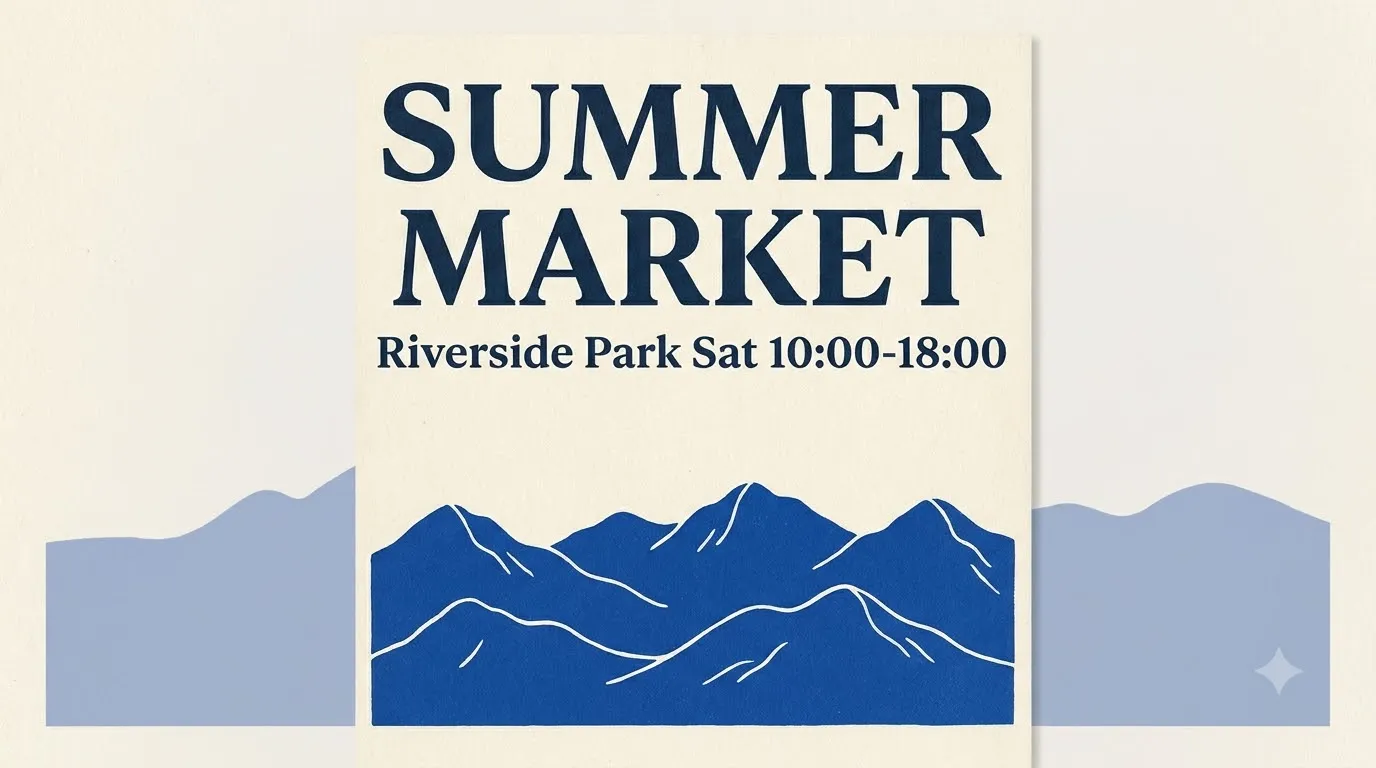
Минимальная структура выглядит так: заголовок сверху, иллюстрация снизу.
{
  "summary": {"meta": ["poster"], "canvas": "single",
    "caption": "A minimalist travel poster with cream background, blue mountain illustration below, and exact title SUMMER MARKET at top."},
  "items": [
    {"label": "text", "caption": "Large dark-blue title centered at top.",
     "text": "SUMMER MARKET", "bbox": [-416, -384, -288, 384]},
    {"label": "object", "caption": "A flat blue mountain illustration in lower center.",
     "bbox": [-192, -288, 384, 288]}
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
Никто не размечает вручную boxes для инфографики из 20 элементов. Практика ранних пользователей — поручить vision-capable LLM черновик JSON по брифу или эскизу, а затем поправить координаты перед генерацией. Японский тестировщик @chimolog7 сформулировал это прямо: формат bbox слишком сложен для человека, поэтому он генерировал его через Opus. После этого он увидел в японском тексте едва ли 1% заметных опечаток, тогда как Krea 2 всё ещё часто ошибался (пост).
Второй полезный приём — контролируемая перегенерация. Модель работает только в режиме text-to-image и не принимает reference images, поэтому нельзя сделать img2img фотографии с сохранением исходника. Зато можно изменить текст или положение одного box, оставить тот же seed и перегенерировать изображение: остальной макет в основном сохраняется. Пользователь @li9292 показал это на обложке еженедельного отчёта с тысячами китайских символов и 20 boxes: он менял один box с тем же seed, а оставшаяся компоновка не сдвигалась (пост). Для задач с точным текстом такой цикл «один box плюс тот же seed» важнее любого style preset.
Для более широкого контекста по генерации текста посмотрите наш тест лучших моделей изображений для рендеринга текста в 2026 году: он хорошо показывает, почему этой категории понадобился подход, где макет стоит на первом месте.
Как вызывать API и во что обходится «бесплатно»
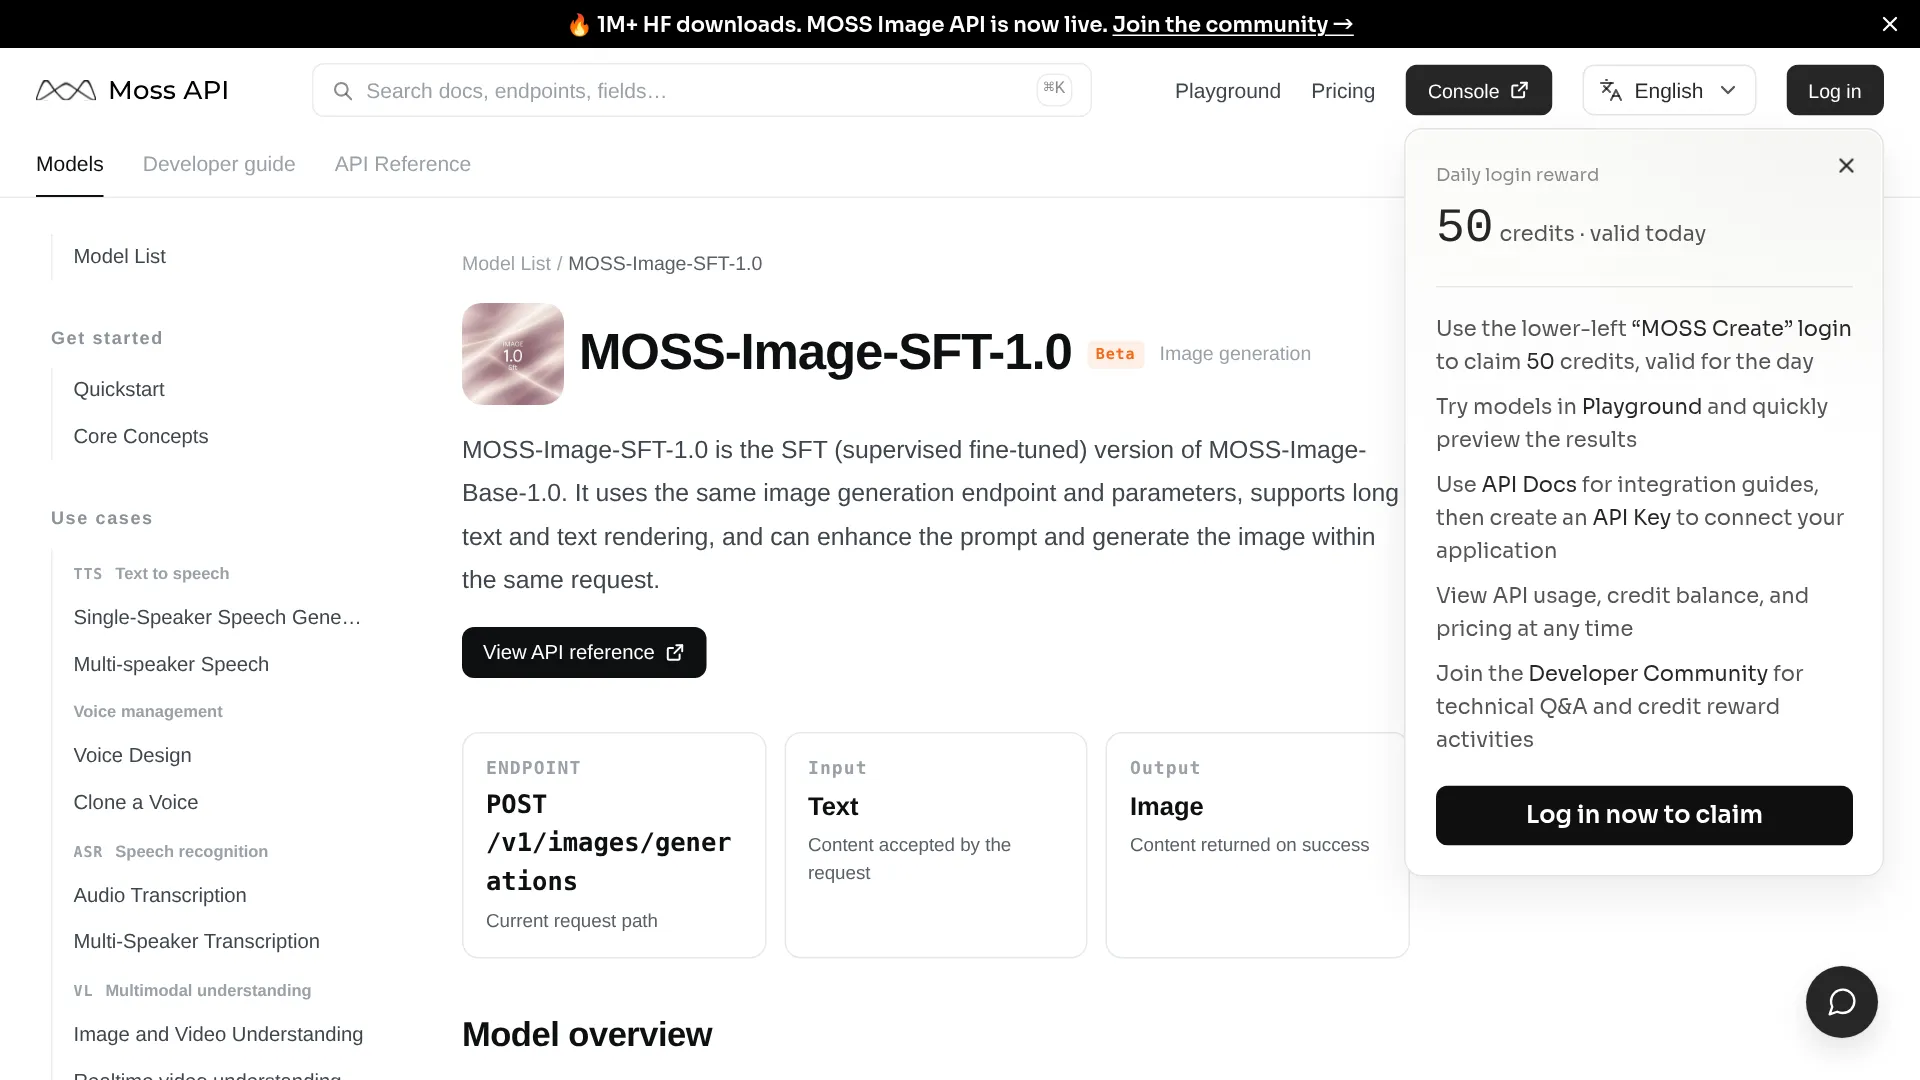
Hosted-вариант предлагает один endpoint. В документации MOSI API указан POST /v1/images/generations для moss-image-sft-1.0: на входе текст, на выходе изображение. Нет image input, аудио или видео, streaming и async task API. Улучшение промпта встроено, но по умолчанию отключено; его можно включить через prompt_enhance: true, а версию enhancer сервер выбирает сам.
curl https://platform.mosi.cn/v1/images/generations \
  -H "Authorization: Bearer $MOSI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moss-image-sft-1.0",
    "prompt": "A cafe menu card on a light oak table, exact heading MORNING MENU",
    "size": "1024x1024",
    "prompt_enhance": false
  }'
Если нужен контроль на уровне boxes, передавайте полной JSON-строкой значение prompt. Короткая текстовая форма выше — самый простой вариант для копирования и запуска.
На момент проверки биллинг указан как Free for a limited time при 0 credits, со ссылкой на полные тарифы для последующего периода. В руководстве по выбору Base и SFT отмечен тот же пробел: playground работает с 20 октября, но постоянная цена за изображение не опубликована. Планируйте бюджет соответственно: бесплатное окно — для прототипа, затем тарифы провайдера плюс стоимость отбракованных генераций с опечатками.
Локальный инференс не берёт плату за изображение, но предъявляет реальные требования к железу. В списке файлов Comfy-Org, проверенном 20 октября, указано около 29.72 GB BF16-весов без учёта окружения и кэша: backbone — около 10.16 GB, text encoder — около 19.31 GB, small VAE — около 0.25 GB. INT8 ConvRot примерно вдвое сокращает объём transformer-компонентов: backbone до ~5.41 GB, encoder до ~9.75 GB; вариант W4A8 GPTQ encoder занимает около 7.34 GB.
| Конфигурация | Что скачивать | Практическое замечание |
|---|---|---|
| Полный BF16 | 29.72 GB весов + рабочая память | Даже на 32 GB без offload будет тесно; важны системная RAM и длина промпта |
| INT8 quantized | Класс ~15 GB + offload | Документирован путь на 12 GB при ~1 MP, по одному изображению в batch (~9.7 GB пикового потребления в упомянутом здесь community-тесте); с него стоит начать на картах с 8–12 GB |
| Community 8-step DMD / 4-step | Adapter + совместимый workflow | ~24 секунды против ~137 секунд в том же отчёте для RTX 3060 при 1 MP, но ранние adapters теряли нюансы — сначала зафиксируйте базовый результат на 50 шагах |
Официальный baseline семплинга — Euler, 50 шагов, CFG 3.0, shift 5.0, skip-layer guidance на слое 22, при 1024x1024. Нативная поддержка ComfyUI появилась 16 октября (анонс здесь): обновите ComfyUI, найдите шаблоны MOSS-Image и используйте подходящий workflow для Base или SFT с файлами Comfy-Org, а не смешивайте граф plugin с native loader.
Если вы сравниваете расходы между провайдерами, наш разбор самых дешёвых API для генерации изображений поможет оценить стоимость GPU-времени вместе с математикой отбраковки.
В чём закрытые модели всё ещё сильнее
Ограничения модели сформулированы явно, и их стоит учитывать до того, как вы начнёте делать на этом стеке финальные материалы. Релиз поддерживает только text-to-image. Нет ни редактирования изображений, ни reference-image input; генерация на основе референсов обозначена как будущая работа. Если критично сохранить загруженную фотографию или удерживать одного персонажа между кадрами, используйте модель с нативным редактированием, например Qwen Image 2.1 для production-редактирования.
Вторая слабая зона — люди и визуальный вкус. При 5B параметрах лица могут получаться обобщёнными, пропорции — плыть, а руки страдают от привычных для генеративных моделей ошибок.
"Она также плохо справляется с пропорциями персонажей. И не слишком хороша с типичными проблемами вроде «плохих рук» и подобными вещами." — @SlipperyGem
Упомянутые практические тесты советуют проверять перед публикацией один и тот же список: короткие промпты, именованных персонажей, теги художников и точные ограничения модель соблюдает нестабильно; мелкий текст нужно вычитывать, а языки за пределами английского и китайского бенчмарков — проверять вручную. Официальная конфигурация на 50 шагов тяжела для скромного железа, а быстрые adapters меняют нюансы освещения и соблюдение ограничений на скорость. Для каждого удачного изображения записывайте checkpoint, encoder, VAE, precision, промпт, seed и время вместе с кодированием.
Локальный сервинг с упором на скорость показывает ту же картину со стороны железа. Lucebox измерил 2.7 секунды для 1024x1024 при 8 шагах и CFG 1 на Radeon AI PRO R9700 со своими kernels — в 1.8 раза быстрее end-to-end, чем ComfyUI на DGX Spark с теми же настройками. Однако при визуальной проверке у них оказалось 4 деформированных результата из 8 при CFG 1 против 1 из 8 при CFG 2.5, который занимает 5.2 секунды. Быстрее не значит практичнее.
FAQ по MOSS Image API
Можно ли бесплатно использовать MOSS Image в коммерческих проектаах?
Веса и поставляемый код выпущены по Apache 2.0: лицензия разрешает коммерческое использование и fine-tuning без лицензионных отчислений. Hosted endpoints устанавливают собственные цены и правила контента, а у сторонних quantizations или LoRAs действуют свои условия.
Base или SFT: что использовать через API?
Hosted API работает с SFT (moss-image-sft-1.0) — дообученным чекпойнтом, который команда рекомендует для генерации. Скачивайте SFT для постеров и информационной графики уже сейчас; Base нужен для fine-tuning или обучения LoRA.
Запустится ли модель на 12 GB VRAM?
Документированная конфигурация на 12 GB работает с quantized workflow и CPU offloading при ~1 MP и одном изображении в batch.
Можно ли редактировать фото или сохранить персонажа идентичным?
Нет. Выпущенный backbone не использует reference images как условие генерации. Повторное использование seed вместе с изменённым JSON направляет перегенерацию, но не сохраняет загруженную фотографию и не гарантирует идентичность.
Кому стоит вызвать MOSS Image следующим
| Ваша задача | Выбирайте MOSS Image, когда | Выбирайте что-то другое, когда |
|---|---|---|
| Постер, меню, слайд или UI-макет с точным текстом | Длинный двуязычный текст и размещение на уровне boxes важнее фотореалистичных людей | Нужны только однострочные слоганы — закрытую модель быстрее промптить |
| E-commerce или редакционный pipeline | Вы можете добавить шаг LLM-to-JSON и вычитку, а также хотите веса Apache 2.0 для self-hosting или fine-tuning | Вам уже сегодня нужны img2img, inpainting или персонажи, закреплённые по референсу |
| Локальный разработчик с ограниченным бюджетом | Вас устраивают 12 GB с quantization или бесплатное окно MOSI покрывает прототип | Нужны гарантированная пропускная способность, streaming или async tasks — hosted API пока не предлагает ничего из этого |
Для дизайна с большим количеством текста и заданным макетом MOSS Image — редкая открытая модель, в которой система ограничений сама становится продуктом. Во всех задачах, где лицо должно оставаться одним и тем же лицом, воспринимайте её как typography engine рядом с закрытой моделью изображений, а не как полноценную замену.