 AIREITER
145-миллиардная модель, которая якобы работает на ноутбуке со скоростью 80 токенов в секунду, звучит впечатляюще. Скачать веса действительно можно, но на практике вам понадобится NVIDIA-система с CUDA 13 и примерно 105 ГБ свободного места на SSD.
В этом обзоре Edge0-145B я сопоставляю заявления разработчиков с постом о запуске, документацией модели и карточкой Q3_K, а также с первыми запусками сообщества. Так вы сможете решить, стоит ли скачивать модель и запускать её локально или проще обратиться к API.
Что вышло 12 ноября: веса, движок и ограничения
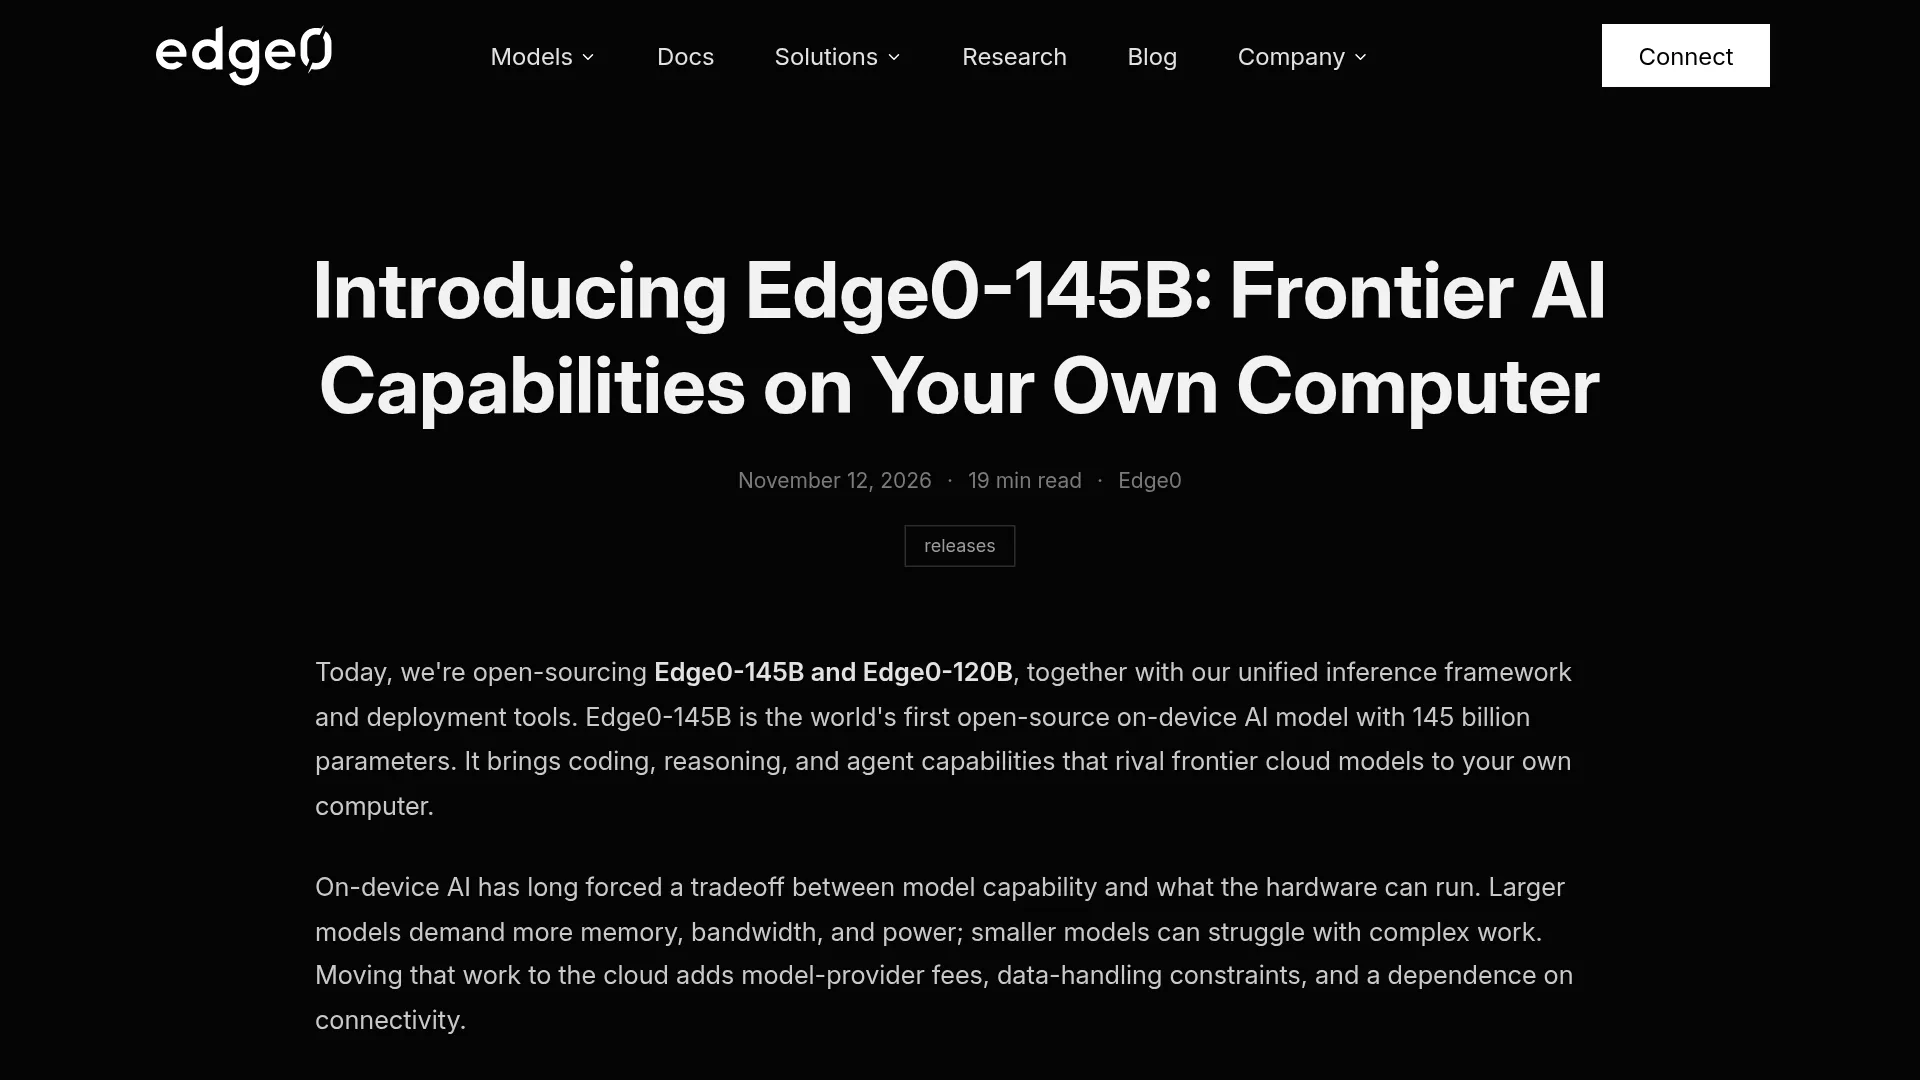
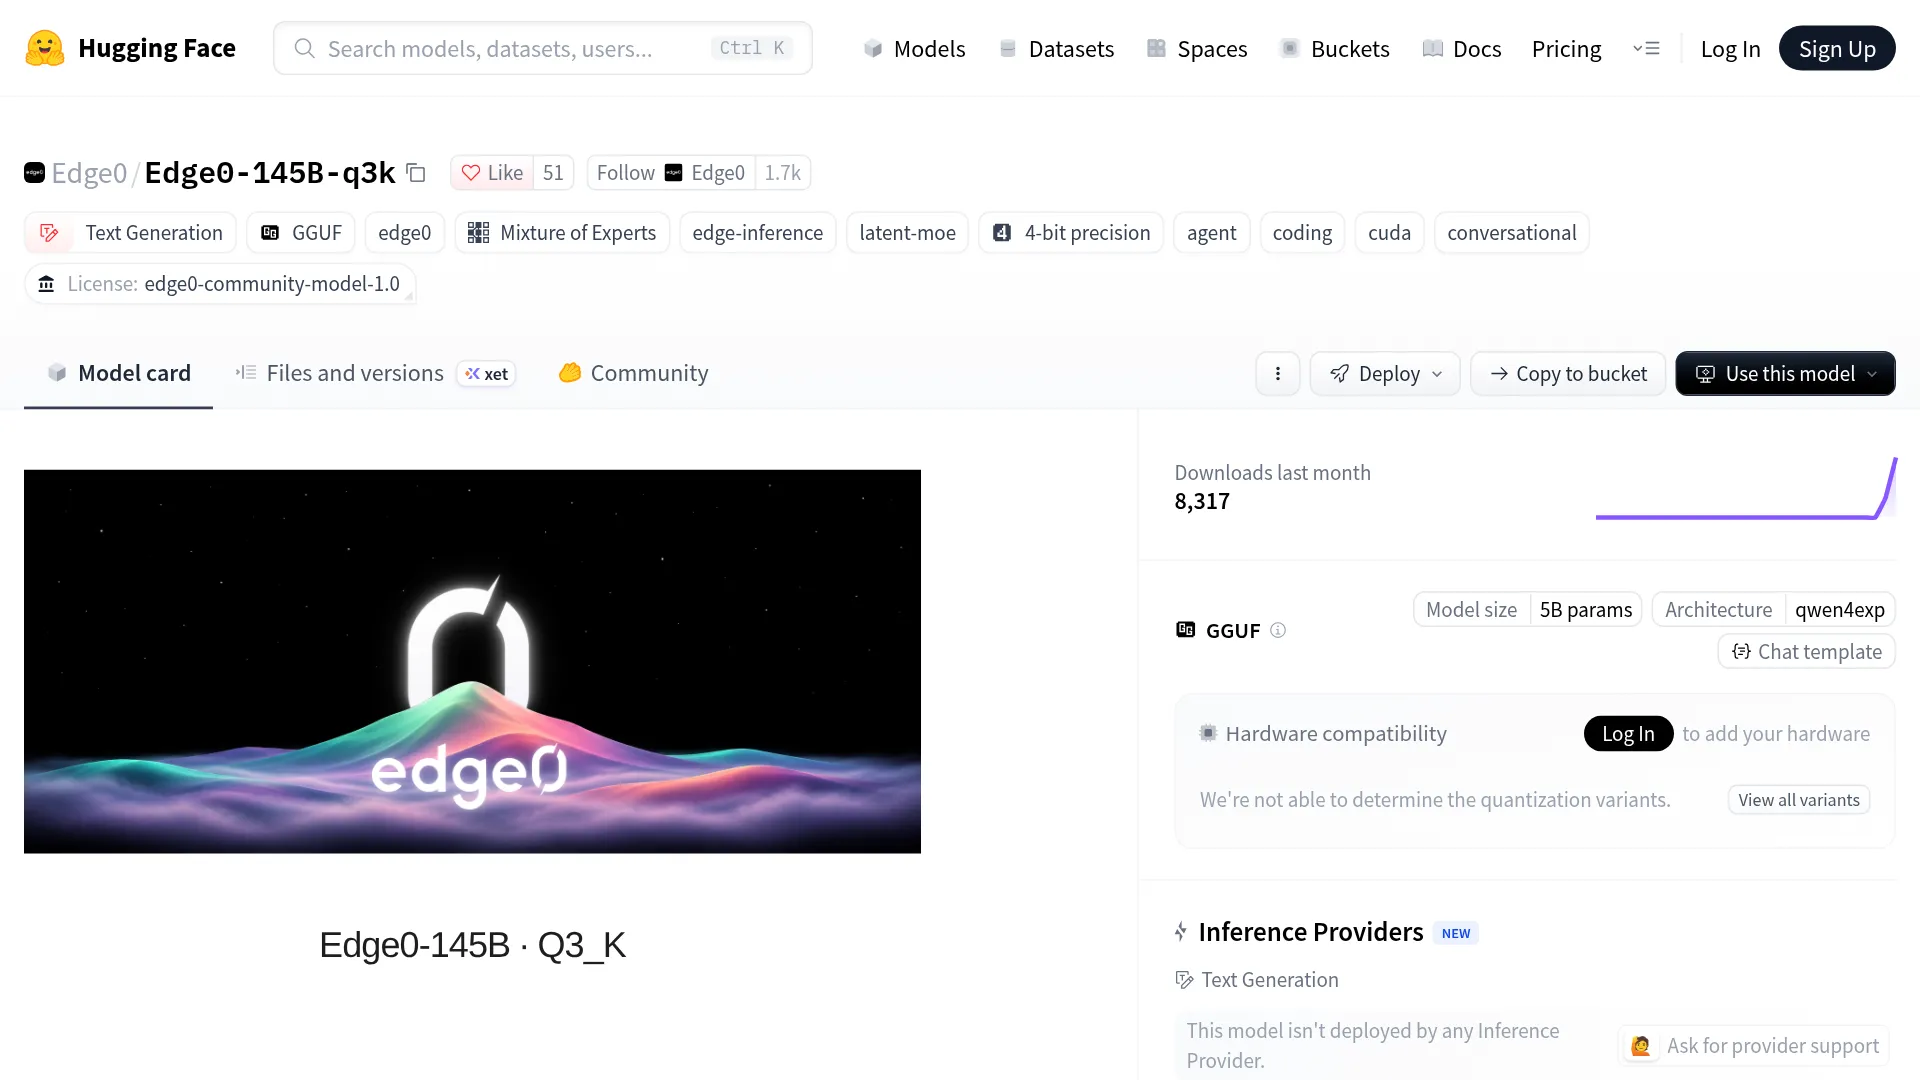
Edge0 выпустила Edge0-145B и Edge0-120B 12 ноября 2026 года. Веса доступны в репозиториях Edge0-145B-q3k и Edge0-145B-NVFP4, а движок edge0-strata — в репозитории Edge0-AI/Edge0. Edge0-145B — текстовая латентная Mixture-of-Experts-модель с контекстом 256K, созданная на базе Qwen3.8-Flash-Next и изначально обученная в 4-битном формате. На каждом токене активируется около 10,12 млрд параметров, поэтому всем 145 млрд параметров не требуется одновременно находиться в VRAM.
Всего модель включает около 84,6 млрд параметров экспертов, таблицу PLE на 51,2 млрд параметров, отображаемую в память с SSD, черновую голову на 1,26 млрд параметров для speculative decoding и 6-гигабайтный каркас. Вариант Q3_K содержит 40,81 GiB весов, а размер репозитория составляет 105,4 ГБ. У NVFP4 это 47,79 GiB весов и 112,9 ГБ на весь репозиторий. Маршрутизируемые эксперты хранятся в специальном пакете experts.bin, а не в переносимом формате GGUF.
Заявленные 29 ГБ — это не все 29 ГБ
В одном разделе блога указано пиковое потребление 29 ГБ, в другом — 28 ГБ. Там же фигурируют более 1100 токенов в секунду при заполнении контекста, более 80 токенов в секунду при генерации и энергопотребление 120 Вт. Согласно карточке Q3_K, на RTX 5090 D модель занимает 23,14 GiB VRAM и 31,28 GiB оперативной памяти. Для NVFP4 показатели составляют 23,25 и 38,27 соответственно. Библиотека экспертов требует около 40 ГБ RAM, а примерно 48 ГБ словаря подгружаются с SSD.
«Горячие» эксперты остаются в VRAM, «тёплые» размещаются в RAM, а таблица PLE размером 51,2 ГБ по запросу считывается с SSD. Если считать только активный рабочий набор, он действительно может приблизиться к 29 ГБ. Но для хранения модели и потоковой загрузки всё равно понадобится весь репозиторий.
| Что означает цифра | Размер | Где хранится |
|---|---|---|
| Заявленное пиковое потребление в блоге | 28-29 ГБ | Активный рабочий набор; методика не раскрыта |
| Загрузка репозитория Q3_K | 105,4 ГБ | NVMe SSD, PLE 51,2 ГБ + experts.bin 40,1 ГБ |
| Загрузка репозитория NVFP4 | 112,9 ГБ | NVMe SSD, PLE 51,2 ГБ + experts.bin 47,6 ГБ |
| Измеренный рабочий набор Q3_K на 5090 D | 23,14 GiB VRAM + 31,28 GiB RAM | VRAM + системная RAM во время инференса |
| Измеренный рабочий набор NVFP4 на 5090 D | 23,25 GiB VRAM + 38,27 GiB RAM | VRAM + системная RAM во время инференса |
Что действительно нужно для запуска Edge0-145B
Edge0-145B работает в Linux и Windows на NVIDIA GPU с CUDA 13 через edge0-infer. У выпущенных файлов нет штатного пути загрузки через llama.cpp, Ollama или LM Studio: каркасный GGUF не содержит весов маршрутизируемых экспертов, а Edge0 документирует только edge0-infer — см. инструкции в репозитории. Поэтому описанный в руководстве по llama.cpp v1.0 сценарий здесь не работает. В блоге также заявлена поддержка macOS и MacBook Pro с первого дня, однако в таблице платформ для 145B и 120B указаны только Linux и Windows с CUDA 13.
Минимальная протестированная конфигурация — 16 GiB VRAM и 20 GiB RAM: в режиме agent decode на Q3_K она показала 44,9 токена в секунду. Рекомендуемый вариант — NVIDIA-карта на 24 ГБ, 32 ГБ системной памяти, хотя с 48 ГБ будет комфортнее, 120 ГБ свободного места на NVMe, CUDA 13, CMake, Ninja и uv. Сборка и запуск выполняются по инструкциям репозитория:
git clone https://github.com/Edge0-AI/Edge0.git edge0
hf download Edge0/Edge0-145B-q3k --local-dir ./Edge0-145B-q3k   # ~105 GB
export EDGE0_145B=$PWD/Edge0-145B-q3k
build/cpu/bin/edge0-infer serve --model "$EDGE0_145B"  # :8000
Пользователи Windows могут скачать приложение Edge0 Chat v0.2.0 со страницы релизов на GitHub. Для AMD потребуются ручные исправления: пользователь u/UghrUghr сообщает примерно о 35 изменениях в сборке и запуске на RX 7900 XTX под Windows 11 в этой ветке r/LocalLLaMA. При этом CUDA-оптимизированные ядра заменяются более медленным резервным вариантом.
Q3_K или NVFP4: какой файл скачивать
Q3_K занимает 105,4 ГБ и является вариантом по умолчанию. В таблице Edge0 он показывает 121,2 токена в секунду в режиме agent decode на 5090 D. NVFP4 размером 112,9 ГБ рассчитан на ускорение Blackwell и на той же карте достигает 98,3. Если у вас нет оборудования Blackwell, начните с Q3_K.
Скорость на реальном железе
Все цифры ниже предоставлены Edge0 для Q3_K при заполнении контекста 16K, если не указано иное. Результат для M2 Ultra получен через Metal и сам по себе не подтверждает наличие релиза для macOS.
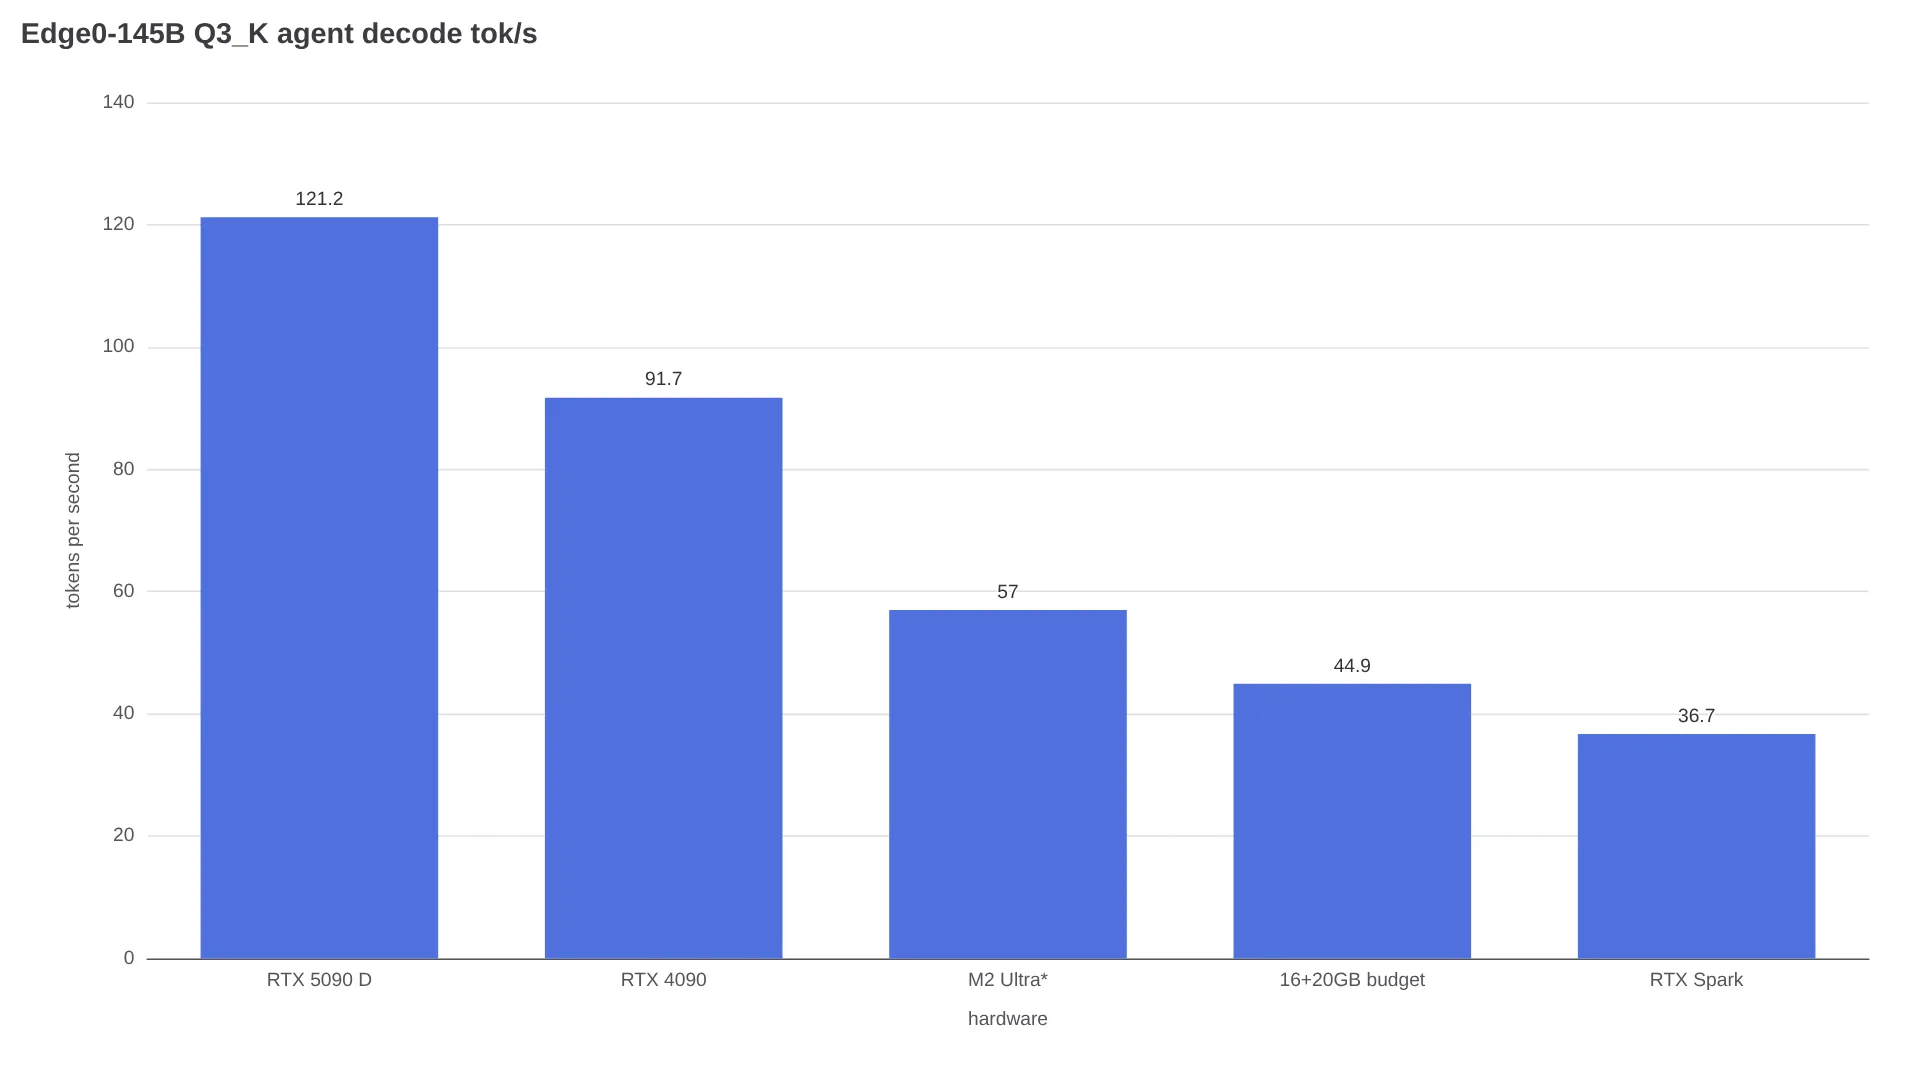
| Оборудование | Chat decode | Agent decode | Заполнение 16K |
|---|---|---|---|
| RTX 5090 D 24GB Q3_K | 99.7 | 121.2 | 3,554.9 |
| RTX 4090 24GB Q3_K | 69.9 | 91.7 | 3,179.4 |
| Apple M2 Ultra Metal Q3_K | 60.9 | 57.0 | 800.3 |
| Бюджет 16 GiB VRAM + 20 GiB RAM, Q3_K | 36.8 | 44.9 | 335.0 |
| RTX Spark 60GiB Q3_K | 37.7 | 36.7 | 770.3 |
Владелец RTX 3090 сообщает о 20,1 секунды до первого токена, скорости заполнения контекста 1 583 токена в секунду и генерации 56,2 токена в секунду на Q3_K. Это указывает на более низкую скорость по сравнению с флагманскими картами:
Только что попробовал на своей системе с 3090 — 20,1 с до первого токена, 1583 токена/с при заполнении контекста и 56,2 токена/с при генерации для Edge0-145B Q3_K.
— u/LightBrightLeftRight, ветка r/LocalLLM
На упомянутой выше AMD-системе u/UghrUghr сообщает примерно о 40 токенах в секунду при генерации и примерно о 54 с параметрами ROUTE_TAIL_SKIP=7 и ROUTE_PRIOR=1.5. Обработка промпта составляет около 320 токенов в секунду. Это единичные результаты без контролируемого воспроизведения — примерно от половины до двух третей скорости 5090 D.
Бенчмарки: два преимущества и четыре оговорки
В таблице Edge0 смешаны внутренние результаты для Edge0, Qwen, DeepSeek и Claude с данными сторонних тестов для остальных моделей — это указано в документации модели. Edge0-145B лидирует в двух тестах для coding-агентов, но уступает базовой Qwen в тестах на знания и следование инструкциям. По состоянию на 13 ноября 2026 года я не нашёл ссылок на независимое воспроизведение результатов. Кроме того, эти оценки относятся к полной модели, а не к доступным квантованным сборкам.
| Бенчмарк | Edge0-145B | Qwen3.8-Flash-Next | DeepSeek V4 Flash | Claude Opus 4.6 Max |
|---|---|---|---|---|
| DeepSWE 1.1 | 64.6 | 58.7 | 54.4 | — |
| Terminal-Bench 2.1 | 86.52 | 83.3 | 82.7 | 78.2 |
| HLE | 35.4 | 35.9 | 33.8 | 40.0 |
| GPQA-Diamond | 90.4 | 91.7 | 90.8 | 91.3 |
| IFBench | 80.6 | 81.3 | 79.2 | 62.5 |
| AA-LCR | 79.3 | 79.1 | 79.7 | 78.0 |
Средний результат в расчётах Edge0 составляет 72,8 у Edge0-145B против 71,7 у Qwen3.8-Flash-Next и 70,1 у DeepSeek-V4-Flash; у 120B — 68,9. Мой вывод простой: при сопоставимых заявленных требованиях к памяти стоит выбирать 145B, если место на диске не является проблемой.
Лицензия: открытые веса — ещё не open source
Фреймворк распространяется по Apache 2.0, а базовый Strata — по MIT. На веса распространяется Edge0 Community Model License 1.0, при этом также действуют условия Qwen. Личные, исследовательские и внутренние корпоративные сценарии, а также коммерческое использование результатов разрешены. Для продажи или встраивания самой модели, запуска платного сервиса либо выпуска коммерческого coding- или офисного ассистента потребуется отдельное письменное разрешение.
Скачивать модель или пользоваться API
Скачивайте модель, если у вас есть подходящее железо и код должен оставаться на вашем устройстве. Для разового эксперимента сначала сравните стоимость размещённого API с затратами на покупку оборудования. Разработчикам, которые выбирают между разными сервисами инференса, стоит посмотреть страницу API DeepSeek V4.1 Flash, прежде чем выделять на модель 105 ГБ диска.
| Ваша ситуация | Что выбрать |
|---|---|
| 24GB NVIDIA + 32-48GB RAM + 120GB NVMe, Linux/Windows | Скачать Q3_K и запустить через edge0-infer |
| Карта Blackwell, нужен вариант NVFP4 | Скачать сборку NVFP4 |
| Только Mac, ноутбук с 8-16 ГБ или необходимость в Ollama/LM Studio | Пока не скачивать; использовать размещённый API |
| Запуск платного API или ассистента на базе этих весов | Остановиться и получить письменное разрешение; использовать API |
| Нужны заявленные результаты без самостоятельной настройки | Использовать API класса Qwen или frontier API; вернуться к модели после появления воспроизводимых тестов |
Главный компромисс здесь — между происхождением модели и практичностью. Потоковая загрузка экспертов снижает требования к VRAM для моделей с более чем 100 млрд параметров, но заявления о запуске на ноутбуке, macOS и «29 ГБ» пока опережают выпущенный код. Кроме того, в опубликованной Edge0 таблице нет отдельных показателей качества для Q3_K.
FAQ
Запустится ли Edge0-145B на ноутбуке?
Только на производительном NVIDIA-ноутбуке примерно с 24 ГБ VRAM, как минимум 32 ГБ RAM и 120 ГБ на NVMe, под Linux или Windows с CUDA 13. Ультрабук с 8 или 16 ГБ не запустит сборку 145B: для неё требуется загрузка объёмом 105,4 ГБ и более 23 GiB VRAM во время работы.
Работает ли Edge0-145B на Mac?
По состоянию на 13 ноября 2026 года в таблице платформ нет поддерживаемого релиза для macOS. Результаты M2 Ultra — только измерения через Metal.
Работает ли модель с Ollama, llama.cpp или LM Studio?
Нет. Стандартные сборки не умеют загружать пользовательские пакеты experts.bin, а каркасный GGUF не содержит весов маршрутизируемых экспертов. Используйте edge0-infer serve или приложение Chat для Windows.
Edge0-145B лучше Qwen3.8-Flash-Next?
В тестах Edge0 модель опережает Qwen в DeepSWE: 64,6 против 58,7, а также в Terminal-Bench: 86,52 против 83,3. При этом она уступает в HLE: 35,4 против 35,9, и в GPQA-Diamond: 90,4 против 91,7. Независимые тесты ещё не опубликованы.
Можно ли коммерчески использовать Edge0-145B?
Результаты использовать можно, но продажа самой модели, запуск платного сервиса или выпуск коммерческого coding- или офисного ассистента требуют отдельного письменного разрешения по условиям community-лицензии. Также действуют условия Qwen.