 AIREITER
13 ноября 2026 года DeepSeek вынес возможности своего приложения в API-параметры. Встроенный поиск сам решает, когда обращаться к интернету, и тарифицируется по запросам с результатами. Отдельные Search/Fetch полностью контролируются кодом и оплачиваются за успешные запросы, а файлы загружаются через самостоятельный Files API и подключаются по file_id.
В режиме рассуждений один вызов может породить около 20 обращений к инструментам — каждое учитывается как поиск или загрузка страницы. В этом руководстве разберём активацию функций, загрузку файлов, расчёт стоимости и выбор подходящего варианта.
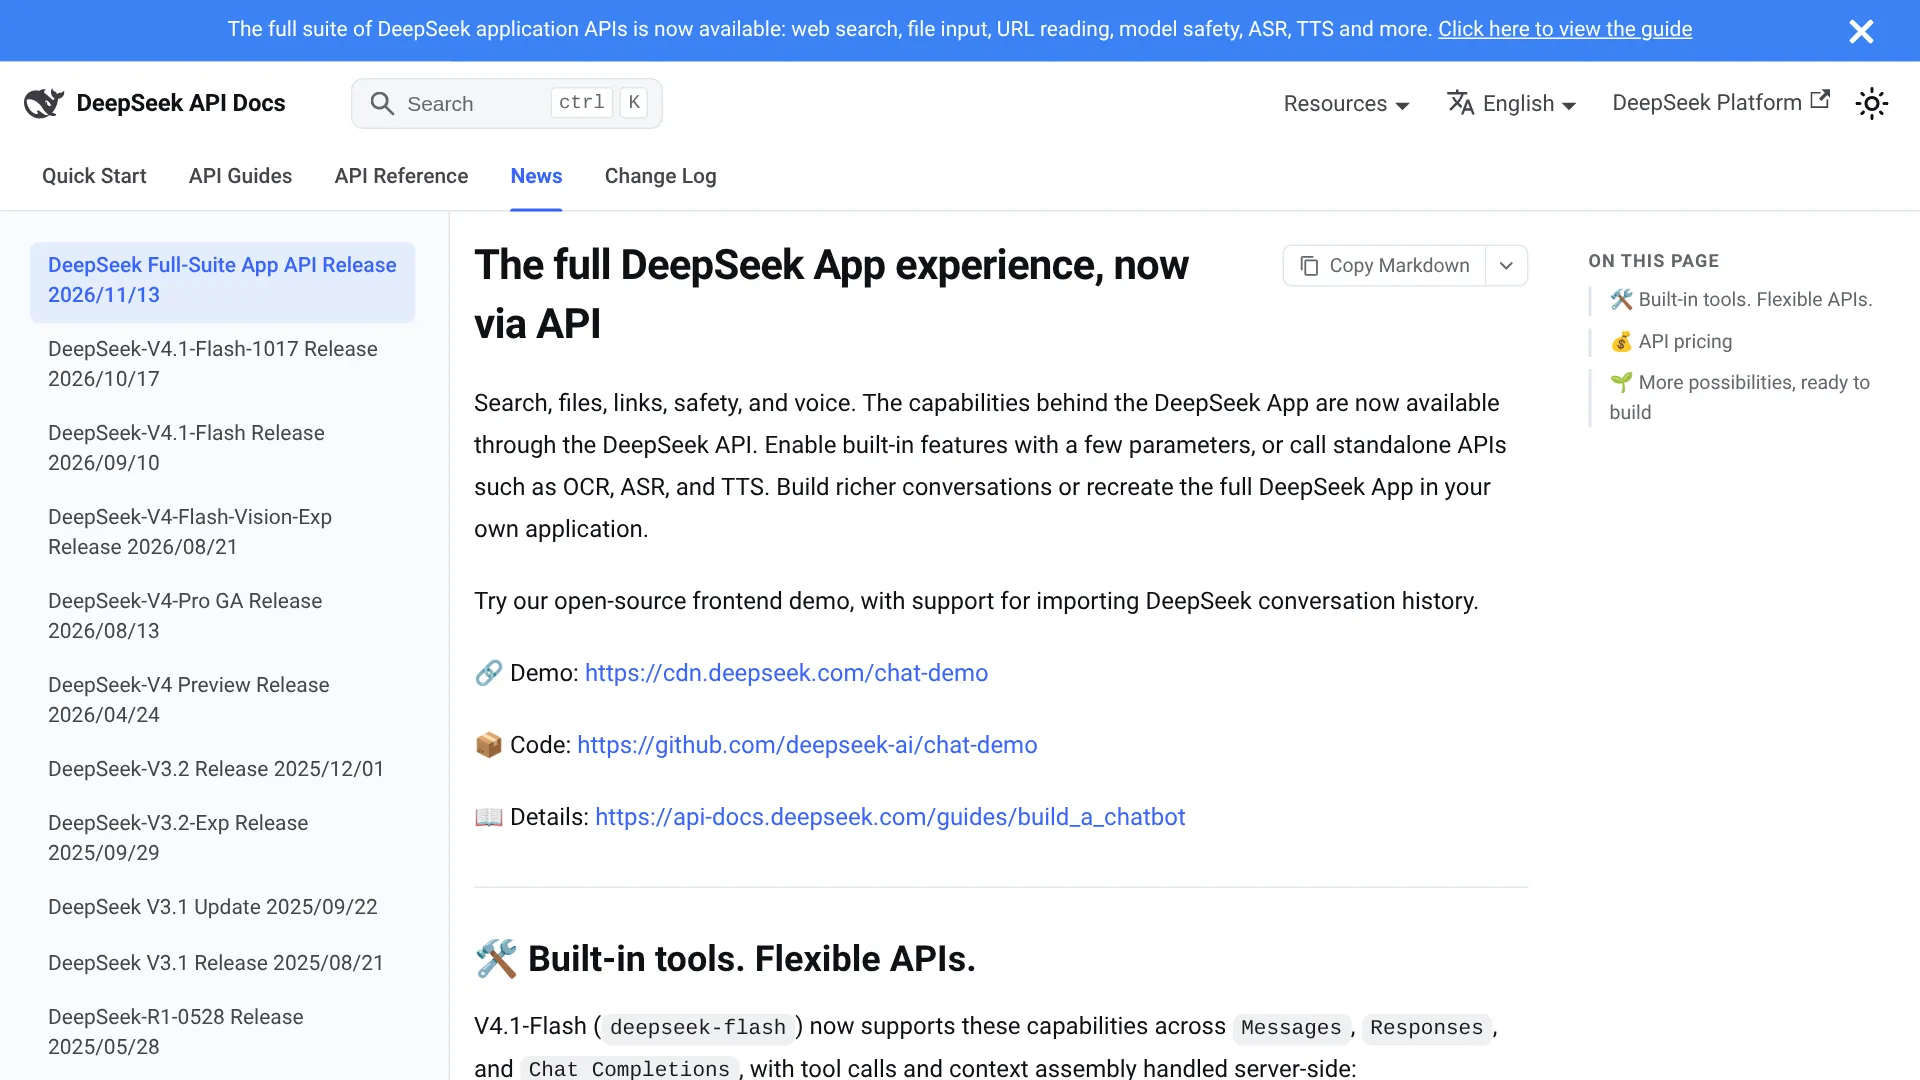
Что появилось в DeepSeek App API 13 ноября
В анонсе DeepSeek — The full DeepSeek App experience, now via API — веб-поиск, загрузка файлов и чтение URL стали доступны через API для модели deepseek-flash (DeepSeek-V4.1-Flash).
Один и тот же набор возможностей доступен через три интерфейса: Messages API, Responses API и Chat Completions API — это описано в руководстве по созданию чат-бота. Вызовы инструментов и сборка контекста выполняются на стороне сервера, поэтому клиенту остаётся отобразить структурированные блоки и передать их обратно без изменений. В демо браузерного приложения с открытым исходным кодом показана соответствующая схема, но сам проект предназначен только для демонстрации.
Как включить веб-поиск и чтение URL
В запросе к deepseek-flash объявите два инструмента в массиве tools — именно так показано в руководстве по Web Tools:
"tools": [{"type": "deepseek_web_search"}, {"type": "deepseek_read_url"}]Если рассуждения отключены, deepseek_web_search работает как поиск в чате: модель сама решает, нужен ли поиск, один вызов может содержать несколько запросов, а ответ приходит с цитатами. При включённых рассуждениях тот же инструмент превращается в поиск для глубокого анализа: между шагами рассуждения чередуются open_page и find_in_page, а до финального ответа может произойти около 20 обращений к инструментам.
В том же руководстве по Web Tools указаны четыре важных ограничения:
- Учитываются только URL из последнего сообщения пользователя — максимум первые 10 уникальных адресов. Какие именно страницы читать, выбирает модель.
- Принудительно вызвать инструмент через
tool_choiceнельзя: указание конкретного инструмента приводит к HTTP 400, а значение"none"заодно отключает чтение URL. - При включённых веб-инструментах, повышенном уровне безопасности или генерации заголовка параметры
temperature,top_pи несколько полей управления инструментами игнорируются без предупреждения. - Ответ, в котором использовались веб-инструменты, нельзя продолжить — запрос придётся отправить заново.
«При цене $0.75 за 1000 запросов хочется понимать, сколько обращений агент делает в фоне. Кто-нибудь считал стоимость типичной исследовательской задачи?» — u/Glum-Guitar-5083 на r/DeepSeek
Тарификация зависит от выбранного пути. Встроенный веб-поиск оплачивается за каждый запрос, который вернул результаты: если в одном вызове было три запроса, это считается как три. Встроенный fetch оплачивается за каждую загруженную страницу, включая страницы, которые позже заменяются на url_not_allowed или unavailable после проверки безопасности. Недоступные для загрузки ссылки не тарифицируются. Для отдельных Search/Fetch оплата возникает только при HTTP 200 и непустых результатах либо возвращённом содержимом. Ошибочные и пустые поисковые запросы в обоих вариантах бесплатны.
Загрузка файлов без собственного парсера
Files API позволяет загрузить файл один раз, а затем обращаться к нему по file_id. Минимальный сценарий выглядит так:
curl https://api.deepseek.com/files \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -F purpose="rich_layout_recognition" \
  -F file="@report.pdf"
# -> {"id": "file-api-xxxxxxxxxxxxxxxx", ...}

# then reference it in chat (Chat Completions shape):
# {"model": "deepseek-flash", "messages": [{"role": "user",
#   "content": [{"type": "text", "text": "Compare this with today's numbers"},
#   {"type": "file", "file_id": "file-api-xxxxxxxxxxxxxxxx"}]}]}
Параметр purpose определяет способ обработки, а для документов его нужно передать до поля file. Значение user_data подходит для изображений (JPEG, PNG, GIF, WebP), обычного текста, таблиц и электронных книг. text_recognition извлекает только текст из PDF, Word, PowerPoint и изображений. rich_layout_recognition возвращает текст и фигуры, сохраняя информацию о таблицах и колонках. Загрузка PDF как user_data заканчивается HTTP 400, а обработанные документы нельзя повторно использовать как изображения или скачать после загрузки.
| Категория | Лимит |
|---|---|
Изображение через file_id | 64 MiB (против 32 MiB для inline Base64) |
| PDF / Word / PowerPoint | 100 MiB, 120 с на разбор при загрузке |
| Текст / таблица / электронная книга | 32 MiB, 10 минут на загрузку |
| Квота аккаунта | 25 GiB, 10 000 файлов; срок хранения от 1 ч до 30 дней или бессрочно |
Файлы принадлежат аккаунту, а не API-ключу. Один и тот же идентификатор работает в семействах OpenAI- и Anthropic-совместимых API; для второго требуется заголовок anthropic-beta: files-api-2025-04-14. Разбор выполняется во время загрузки, поэтому file_id возвращается только после успешного завершения операции.
Встроенные инструменты или отдельные Search и Fetch
Встроенные инструменты подходят, когда модель должна сама решить, искать ли информацию или читать страницу внутри диалога. Отдельные API из руководства Search & Fetch выбирайте, если решение принимает ваш код: POST https://api.deepseek.com/v1/tools/search выполняет ранжированный поиск максимум по 50 результатам (rerank_score от 0 до 3, где 1.5+ означает высокое качество, authority — от 0 до 4), а POST https://api.deepseek.com/v1/tools/fetch превращает один URL в Markdown. Отдельный Search пока не умеет искать изображения, тогда как веб-инструменты умеют.
| Вариант | Кто управляет | Единица тарификации | Лучше всего подходит для |
|---|---|---|---|
Встроенные deepseek_web_search / deepseek_read_url | Модель, на стороне сервера | За запрос с результатами / за загруженную страницу | Чаты с цитатами, глубокое исследование |
| Отдельные Search + Fetch | Ваш код | $0.75 за 1 000 успешных запросов каждого типа | Агенты, RAG-конвейеры |
Лимиты запросов задаются на уровне аккаунта и не зависят друг от друга: 100 QPS для Search, 25 QPS для Fetch плюс отдельный лимит Fetch на домен. При превышении квоты API возвращает HTTP 429. Повторяйте запросы после 408, 429 и 5xx, а для остальных ошибок 4xx сначала исправьте сам запрос. В отдельном Search работают операторы site:, -site:, "exact phrase", lang:, after:/before:.
Во сколько это обходится на практике
Плата за инструменты добавляется к стоимости токенов: Search и Fetch стоят $0.75 за 1 000 успешных запросов каждого типа. Для OCR, ASR и TTS действуют отдельные цены на инструменты и ограниченные по времени промоакции, описанные в анонсе. Параметр count меняет количество результатов, но не цену.
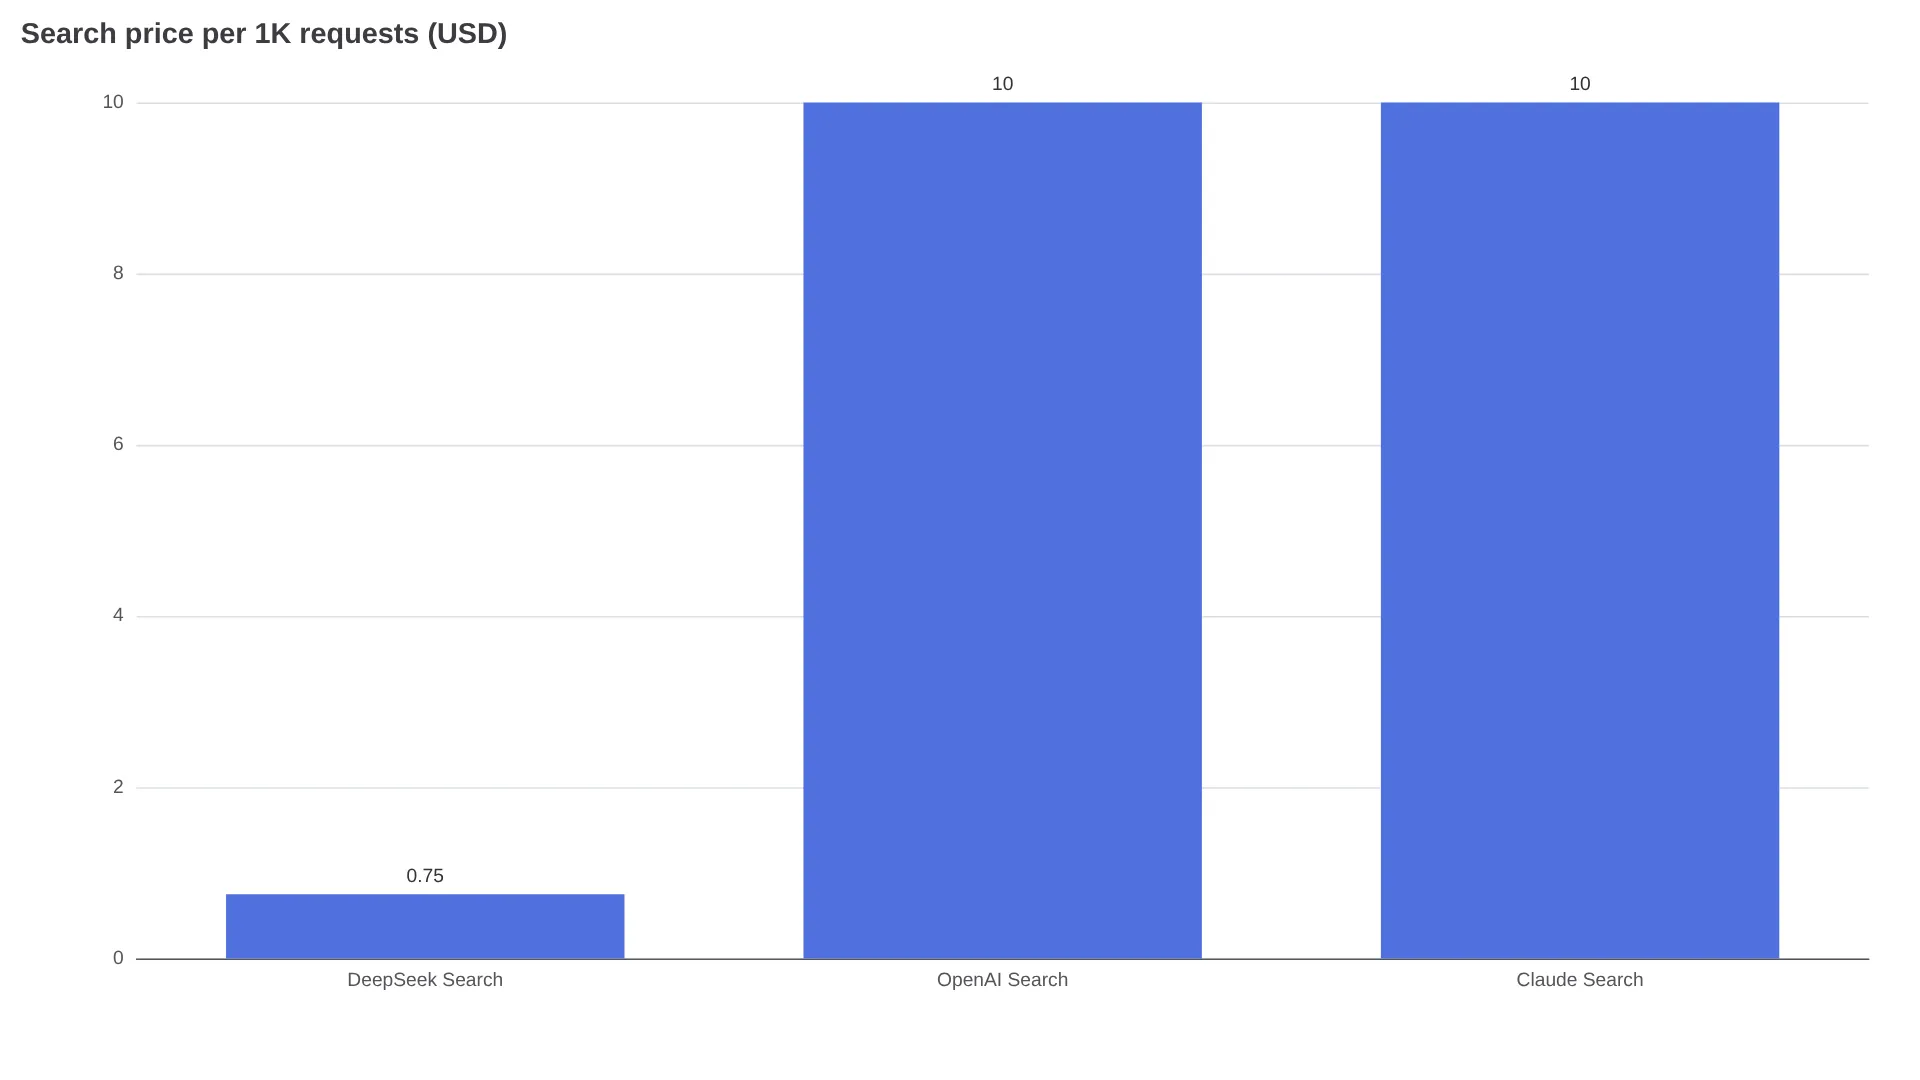
По замерам сообщества, поиск DeepSeek стоит около $0.75 за 1 000 запросов против примерно $10 за 1 000 у поиска OpenAI и Claude, как сообщают разработчики (@berryxia). Только по стоимости инструментов разница составляет примерно 13 раз.
Ответ с одним поисковым запросом обходится по инструментам дешевле одной десятой цента. Исследовательский запуск с глубоким анализом, восемью запросами и шестью открытиями страниц потребует оплаты примерно за 8 поисков и 6 загрузок — всё ещё меньше двух центов без учёта токенов. Главная опасность — объём: агент, который запускает десятки поисков подряд, быстро увеличивает расходы по $0.75 за единицу. Планируйте бюджет по успешным вызовам, ограничивайте глубину поиска и записывайте значения tool_search и tool_fetch из итогового объекта usage. Поле web_search_requests в нём служит только для отображения и не показывает оплачиваемое количество.
Чек-лист перед запуском: цитаты, безопасность и демо
Цитаты приходят в блоках web_search_result_location с URL, заголовком и процитированным текстом — это описано в руководстве по Web Tools. В потоковом режиме они передаются событиями citations_delta: на один текстовый блок приходится не более одного URL, а при повторной отправке цитаты игнорируются. Поля signature и блоки инструментов нужно сохранять между ходами без изменений: страницы восстанавливаются по подписи. Если подпись недействительна или отсутствует, запрос всё равно выполнится, но страница будет отброшена. В примере из руководства по чат-боту контекст увеличивается с 40 входных токенов до 9 078 после работы инструментов, причём 4 096 токенов берутся из кэша. Поэтому заранее закладывайте запас на историю, раздувающуюся из-за поиска.
Для публичных приложений DeepSeek требует проверку безопасности, но оставляет модерацию, регистрацию модели и маркировку AI-контента разработчику. Встроенную проверку стоит воспринимать как первый фильтр, явно обрабатывать причину остановки refusal и быть готовым к url_not_allowed, если страница не прошла проверку. Такие заблокированные загрузки всё равно оплачиваются. Демо чата показывает схему интеграции, но выполняет всё в браузере — перед выходом в продакшен нужен собственный бэкенд.
Частые вопросы
Можно ли заставить модель искать информацию в каждом запросе?
Нет. Когда запускать инструменты, решает модель, а указание веб-инструмента в tool_choice приводит к ошибке 400.
Какая модель и какие эндпоинты поддерживают веб-поиск и загрузку файлов?
deepseek-flash во всех трёх интерфейсах: Messages, Responses и Chat Completions. Ссылки на файлы через file_id работают и в OpenAI-, и в Anthropic-совместимых семействах.
Можно ли одновременно использовать загруженные файлы и веб-поиск?
Да. Именно такой сценарий описан для чат-бота: контекст из файла дополняется серверным поиском и цитатами.
Сколько поисковых запросов обычно выполняет агент за одну задачу?
Для простого ответа достаточно одного вызова с несколькими запросами, а исследование с включёнными рассуждениями может потребовать до примерно 20 обращений к инструментам. Считайте tool_search и tool_fetch для каждой задачи: встроенные инструменты тарифицируются за запрос или страницу, отдельные API — за успешный запрос, в обоих случаях по $0.75 за 1 000.
Начните с одного встроенного поискового запроса и одной загрузки файла в демо. Проверьте в итоговом объекте usage счётчики tool_search и tool_fetch, и только после этого решайте, выгоднее ли такая оплата для конкретной задачи, чем собственный слой на базе Tavily или SearXNG.