 AIREITER
"Sonnet 5 is close to Opus 4.8, but cheaper" — это собственная подача Anthropic. Мы хотели понять, где это перестаёт быть правдой, поэтому прогнали четыре одинаковые задачи через обе модели посредством Claude Code CLI и зафиксировали реальную стоимость, длительность и количество вызовов инструментов из каждого ответа API. Самый важный момент: мы повысили Sonnet 5 до уровня xhigh effort, чтобы он соответствовал тому, что Opus 4.8 делает по умолчанию, и разница в цене, которую мы измерили, почти исчезла — при этом Opus 4.8 завершил работу примерно вдвое быстрее.
Sonnet 5 против Opus 4.8 вкратце
Claude Sonnet 5 | Claude Opus 4.8 | |
|---|---|---|
Выпуск | 30 июня 2026 | |
Окно контекста | 1M токенов | 1M токенов |
Макс. вывод | 128K токенов | 128K токенов |
Цены (вх./исх. за 1M токенов) | $5/$25 | |
Быстрый режим | Не поддерживается | Поддерживается (предварительная исследовательская версия), до ~2.5x скорости вывода при премиальном ценообразовании |
Уровни усилий | low / medium / high / xhigh / max | low / medium / high / xhigh / max |
Позиционирование | Более дешёвая модель уровня Sonnet, ориентированная на agentic-задачи | Флагман Anthropic, вариант с наивысшей точностью |
Окно контекста и максимальный вывод идентичны — здесь это не является отличительным фактором. А вот что является: Sonnet 5 работает на новом токенизаторе, который, по словам Anthropic, для того же текста выдает «примерно на 30% больше токенов», чем Sonnet 4.6, поэтому бюджет max_tokens или оценка стоимости, перенесенные из Sonnet 4.6, не будут напрямую сопоставимы.
Официальное сравнение бенчмарков
Согласно собственным раскрытиям Anthropic, собранным вместе с внешним анализом от llm-stats.com, картина последовательна: Sonnet 5 выигрывает или сравнивается в нескольких бенчмарках, а Opus 4.8 лидирует в большинстве остальных, обычно на однозначные величины.
Бенчмарк | Sonnet 5 | Opus 4.8 | Разрыв |
|---|---|---|---|
Terminal-Bench 2.1 | 80.4% | 74.6% | Sonnet 5 +5.8 |
Humanity's Last Exam (с инструментами) | 57.4% | 57.9% | Почти ничья |
Humanity's Last Exam (без инструментов) | 43.2% | 49.8% | Opus +6.6 |
SWE-bench Verified | 85.2% | 88.6% | Opus +3.4 |
SWE-bench Pro | 63.2% | 69.2% | Opus +6.0 |
Toolathlon | 54.3% | 59.9% | Opus +5.6 |
OSWorld-Verified (computer use) | 81.2% | 83.4% | Opus +2.2 |
CursorBench | 61.2% | 63.8% | Opus +2.6 |
USAMO 2026 problems | 79.5% | 96.7% | Opus +17.2 |
Две вещи выделяются. Самое большое преимущество Opus 4.8 — в сложной математике (USAMO), а не в программировании — разрыв в программировании (SWE-bench, Terminal-Bench) везде составляет всего несколько пунктов, и Sonnet 5 на самом деле в одной из них одерживает полную победу. В общем рассуждении с использованием инструментов (HLE with tools) эти двое настолько близки, что это можно назвать ничьей.
Есть также показатель безопасности, на который стоит обратить внимание, хотя это и не бенчмарк возможностей: согласно тем же раскрытым данным, в сценариях browser-use без дополнительных мер защиты измеренная у Sonnet 5 успешность атак с prompt injection составила 0,93% против 31,5% у Opus 4.8. Anthropic не публиковала подробного объяснения этого конкретного разрыва. Если вы создаёте что-то агентное, что без присмотра просматривает открытый веб, стоит протестировать собственные меры защиты, а не предполагать, что флагманская модель автоматически является более безопасным выбором по умолчанию.
Мы сами провели четыре прямых сравнения
Большая часть того, что доступно сейчас, либо компилирует официальную таблицу бенчмарков выше, либо делится субъективными впечатлениями от одной модели. Мы не нашли контролируемого сравнения стоимости и задержки при одном и том же промпте, поэтому провели собственное.
Методология: четыре задачи, выполненные 2026-07-01, каждый раз один и тот же запрос отправлялся claude-sonnet-5 и claude-opus-4-8 через Claude Code CLI (claude -p --model <id> --effort <level> --output-format json). Стоимость, длительность и количество ходов считываются напрямую из API-ответа каждого запуска, а не оцениваются по количеству токенов. Каждая конфигурация модели/уровня effort была запущена по одному разу для каждой задачи — реальные числа из одного запуска, а не статистически усреднённая выборка. Размер каждого разрыва следует воспринимать как ориентировочный, а не точный; направление сохранялось одинаковым во всех тестах, которые мы провели.
Тест 1: Проверка обратимости затрат
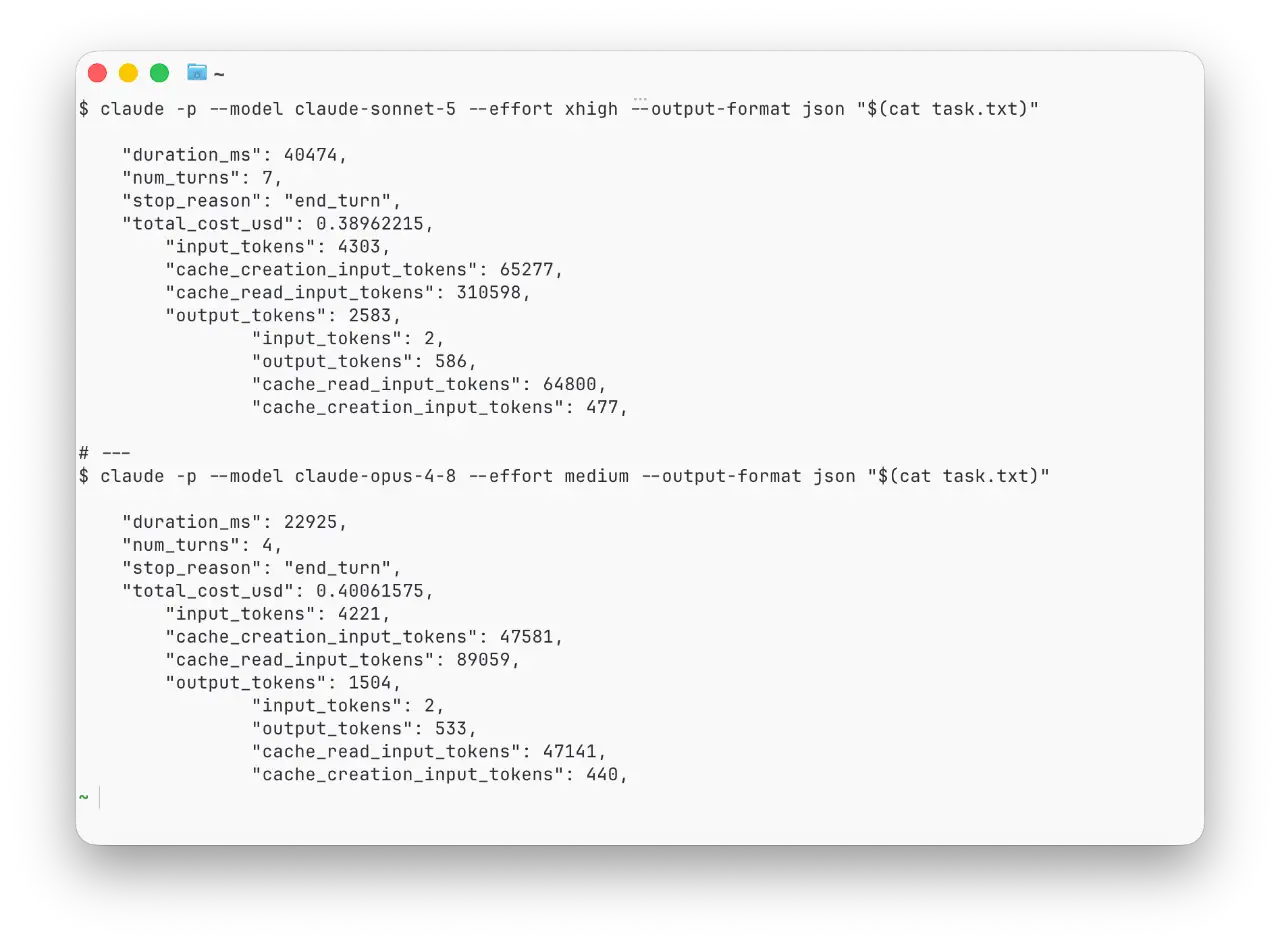
Вопрос, на который мы больше всего хотели ответить: остаётся ли Sonnet 5 дешевле, если повысить уровень его усилий, чтобы компенсировать более сложную задачу? Мы выполнили ту же задачу кодирования, что и в Test 2 (ниже), на Sonnet 5 xhigh против Opus 4.8 medium.
Настройка | Стоимость | Длительность | Ходы | Результат |
|---|---|---|---|---|
Sonnet 5, effort | $0.390 | 40.5s | 7 | 8/8 tests pass |
Opus 4.8, effort | $0.401 | 22.9s | 4 | 7/7 tests pass |
Разница в стоимости 3% — по сути, ничья — и Opus 4.8 на своем низком уровне усилий завершил задачу за 57% времени, используя почти вдвое меньше ходов. Оба сгенерировали правильный, рабочий код. Это совпадает с тем, на что уже указывают люди на Hacker News: один комментатор там оценил стоимость Opus 4.8 примерно в $0.45 на medium reasoning против Sonnet 5 примерно в $0.52 на xhigh/max для сопоставимой работы.
Тест 2: Задача по программированию при сопоставимых усилиях
Тот же промпт, обе модели с усилием high : напишите эффективную функцию longest-palindromic-substring, сгенерируйте тестовые случаи, покрывающие крайние случаи, запустите их, исправьте всё, что не проходит.
Настройка | Стоимость | Длительность | Ходы | Результат |
|---|---|---|---|---|
Sonnet 5 (high) | $0.378 | 37.4s | 7 | 8/8 pass |
Opus 4.8 (high) | $0.439 | 28.9s | 5 | 8/8 pass |
Оба пришли к одному и тому же подходу expand-around-center и прошли все тесты с первого раза. Opus 4.8 добрался до этого быстрее и за меньшее число шагов, примерно на 16% дороже. Когда качество идентично, в этом случае победа за Opus только за счёт скорости.
Тест 3: Письмо / Работа с информацией
Запрос на деловое решение без единственного правильного ответа: посоветуйте SaaS-компании из 12 человек, стоит ли потратить 3–4 недели на миграцию во второй регион AWS для аварийного восстановления за шесть недель до закрытия их раунда Series A.
Настройка | Стоимость | Длительность | Ходы |
|---|---|---|---|
Sonnet 5 (high) | $0.072 | 14.7s | 1 |
Opus 4.8 (high) | $0.084 | 22.7s | 1 |
Оба дали по сути одинаковую рекомендацию — пропустить полную миграцию и вместо этого выпустить облегчённый резервный план/runbook — с сопоставимым качеством аргументации. Sonnet 5 пришёл к этому примерно за две трети времени и на 14% дешевле. Это единственный тест, где фраза «Sonnet 5 вполне справляется с интеллектуальной работой» проявилась особенно отчётливо.
Тест 4: Агентный поиск — действительно ли Sonnet 5 «переобдумывает»?
Некоторые треды на Reddit описывают Sonnet 5 как более склонный к чрезмерному усложнению простых запросов, чем Opus 4.8. Мы протестировали действительно простой: просуммировать размер байтов каждого файла .py в дереве каталогов и сообщить, в каком подкаталоге их больше всего.
Настройка | Стоимость | Длительность | Ходы |
|---|---|---|---|
Sonnet 5 (high) | $0.119 | 18.5s | 3 |
Opus 4.8 (high) | $0.120 | 12.1s | 2 |
Оба пришли к одному и тому же правильному ответу. Стоимость отличалась на величину, укладывающуюся в погрешность округления, но Sonnet 5 потребовал на один дополнительный цикл вызова инструмента и примерно на 50% больше времени. Это действительно, пусть и не слишком большой, показатель в пользу жалобы на «переобдумывание» — и он согласуется с Тестом 1: Sonnet 5, как правило, делает больше шагов, чтобы прийти к тому же результату.
Так какой же из них вам действительно следует использовать?
Выбирайте Opus 4.8 для задач программирования, где важна скорость, агентных рабочих процессов с множеством вызовов инструментов или любых случаев, когда вы иначе могли бы соблазниться повысить effort Sonnet 5 выше
high, чтобы доверять результату — именно в такой ситуации ценовое преимущество Sonnet 5 исчезает.Выбирайте Sonnet 5 для больших объёмов работы, чувствительной к бюджету, и для общих задач на знания/письмо, но оставляйте его на уровне
mediumилиhigheffort. Не повышайте его рефлекторно доxhigh«на всякий случай» — именно здесь история с ценой рушится.Подходит любой вариант для простых поисковых запросов и одноходовых запросов; на практике мы измерили лишь один дополнительный ход и несколько секунд, а не неверный ответ.
FAQ
Действительно ли Claude Sonnet 5 дешевле, чем Opus 4.8?
При одинаковых уровнях усилий — да, заметно. Но если поднять Sonnet 5 до xhigh в качестве компенсации за более сложную задачу, разрыв может сократиться до нескольких процентов, в то время как Opus 4.8 на более низком уровне усилий завершит работу быстрее. Проверьте, какой уровень усилий у вас на самом деле используется, прежде чем считать, что вы экономите деньги. Полный прайс-лист по Haiku, Sonnet и Opus см. в нашем руководстве по ценам Claude API.
Как насчёт Claude Sonnet 5 по сравнению с Sonnet 4.6?
Поколенческое обновление, а не выбор между уровнями модели — и стоимость тоже не движется в том же направлении. Sonnet 5 опережает Sonnet 4.6 на двузначный процент в Terminal-Bench, но в наших собственных прямых тестах на стоимость Sonnet 5 оказался дороже, чем Sonnet 4.6, на каждом уровне effort, который мы попробовали, главным образом из-за нового tokenizer. Полные тесты и цифры в Sonnet 5 vs Sonnet 4.6: Is It Actually Cheaper?
Справедливо ли сравнивать Claude Sonnet 5 и Opus 4.6?
Не совсем — Opus 4.6 на одно поколение отстаёт от Opus 4.8. Если вы решаете, что использовать сегодня, сравнивайте с Opus 4.8, а не с его предшественником.
Отличается ли контекстное окно между ними?
Нет — оба предлагают контекстное окно на 1 млн токенов и максимальный объем вывода 128K.
Почему показатель prompt-инjection у Opus 4.8 значительно выше при использовании в браузере?
Согласно раскрытиям Anthropic, 31,5% без дополнительных мер защиты против 0,93% у Sonnet 5, в частности в сценариях использования браузера без надзора. Anthropic не публиковала подробного объяснения. Рассматривайте это как повод протестировать именно ваши конкретные меры защиты, а не предполагать, что флагманская модель автоматически является более безопасным вариантом по умолчанию.
Приложение: Точные промпты и необработанный вывод
Для тех, кто хочет воспроизвести это, вот точные подсказки, которые мы отправили для каждого теста (в Test 1 и Test 2 использовалась одна и та же подсказка для кодирования, только на разных уровнях усилий).
Тесты 1 & 2 — кодовый запрос:
Напишите функцию Python `longest_palindromic_substring(s: str) -> str`, которая возвращает
самую длинную палиндромную подстроку s, используя подход, более эффективный, чем
brute-force O(n^3) (например, расширение от центра или алгоритм Манакера). Сохраните её
в solution.py.

Затем напишите test_solution.py как минимум с 6 тестовыми случаями, покрывающими: пустую строку,
один символ, строку из одинаковых символов, отсутствие палиндрома длиннее 1, палиндром
чётной длины и палиндром нечётной длины.

Запустите тесты с pytest и убедитесь, что все они проходят. Если какие-либо не пройдут, исправьте
код и запускайте снова, пока все не пройдут. Сообщите итоговый вывод pytest.
Тест 3 — запрос для письма/умственной работы:
Вы консультируете небольшую SaaS-компанию (12 сотрудников, $80k MRR, сейчас работает в
одном регионе AWS) по вопросу, стоит ли расширяться во второй регион AWS для disaster
recovery до их раунда финансирования Series A, который закроется через 6 недель.
Engineering оценивает, что миграция займет 3–4 недели и будет использовать большую часть
возможностей команды в течение этого окна, задерживая две запрошенные клиентами
функции.

Напишите исполнительную рекомендацию примерно на 350 слов: следует ли им сделать это сейчас, отложить
или найти промежуточный вариант? Обоснуйте с учетом tradeoffs. Без вступления, только
рекомендация.
Тест 4 — prompt для agentic lookup:
В текущем дереве каталогов найдите все файлы с расширением .py, суммируйте их
общий размер в байтах и скажите мне, какой единственный подкаталог (непосредственный дочерний элемент
рабочего каталога) содержит больше всего файлов .py по количеству. Только два
числа/ответа, не нужно создавать какие-либо новые файлы.
Вот фактический ответ API для запуска Sonnet 5 (xhigh) из Test 1, сокращённый до полей, относящихся к стоимости и времени:
{
  "duration_ms": 40474,
  "num_turns": 7,
  "stop_reason": "end_turn",
  "total_cost_usd": 0.38962215,
  "usage": {
    "input_tokens": 4303,
    "cache_creation_input_tokens": 65277,
    "cache_read_input_tokens": 310598,
    "output_tokens": 2583
  }
}
Это неотредактированные total_cost_usd, duration_ms и количество токенов, которые Claude Code CLI вернул для этого запуска — числа в таблице Test 1 выше берутся напрямую из таких полей, по одному JSON-ответу на каждый запуск.