 AIREITER
Gerar 38,5 segundos de áudio localmente em 2,81 segundos, sem depender da nuvem nem acumular cobrança por uso, é uma proposta difícil de ignorar. Foi isso que um Mac mini fez com o ZONOS3-Mini, modelo de conversão de texto em fala da Zyphra lançado em 9 de novembro de 2026. Ele tem 800 milhões de parâmetros em uma arquitetura mixture-of-experts, mas mantém cerca de 100 milhões ativos a cada etapa. Há uma ressalva importante: a demonstração foi feita em inglês e em hardware potente. Na prática, o resultado depende do seu texto, idioma e GPU.
O que é o ZONOS3-Mini e como executá-lo
O ZONOS3-Mini é um modelo de TTS com clonagem de voz zero-shot da Zyphra. Basta fornecer um texto e um clipe de referência curto para que ele fale com aquela voz. Também há 27 vozes prontas, cujas características de idade, sotaque e textura podem ser ajustadas. Os pesos usam licença Apache 2.0 e o código de execução é MIT, permitindo uso local e comercial. Clone apenas vozes que sejam suas ou para as quais você tenha autorização.
Por baixo do capô, há uma MoE esparsa com 64 especialistas e roteamento top-2. São 11 camadas, em uma proporção de 3:1 entre Gated DeltaNet e atenção global, além do novo Zyphra Audio Codec 1 (ZAC-1). O codec opera a 15 frames por segundo, em vez dos 86 Hz do DAC empregado pelo ZONOS2. Segundo a Zyphra, essa mudança reduz os tokens de fala de 774 para 150 por segundo e, com dados equivalentes, entrega uma taxa de erro de palavras cerca de 10x menor que a do DAC.
As especificações principais incluem saída em 44,1 kHz, geração de até 10 minutos, referências de até 60 segundos para clonagem a partir de áudio bruto e de até 120 segundos para clonagem por embedding. O treinamento usou 112 GPUs NVIDIA H100 durante 2,5 dias.
Há cinco formas de rodar o modelo:
- Playground WebGPU no navegador, sem instalação
- C++/ggml nativo em CPU, CUDA, Metal ou Vulkan
- Servidor Apple MLX
- SGLang ou vLLM em servidores NVIDIA
- API hospedada da Zyphra, usando
zyphra/zonos3-miniem um endpoint/v1/audio/speechcompatível com OpenAI
Os números de latência divulgados pela fabricante são inferiores a 570 ms até o primeiro áudio em um navegador no Pixel 9 e inferiores a 150 ms em um M3 MacBook Air. Em uma H100 com SGLang, a mediana fica entre 57 e 80 ms, com pico de até 457 segundos de áudio gerados por segundo. Trate os dados de celular e notebook como cenários ideais. A própria thread de lançamento da Zyphra citava números mais conservadores, abaixo de 800 ms e de 450 ms para os mesmos aparelhos. Teste no seu hardware antes de fazer promessas.
Há ainda duas lacunas nos materiais de lançamento. O post técnico fala em 800M de parâmetros totais, enquanto a página do modelo informa 886M. Nenhum dos dois explica como funcionam marca-d'água, controles contra abuso ou retenção de dados das vozes de referência enviadas.
Teste no navegador antes de instalar
O playground no navegador executa a inferência na sua própria GPU via WebGPU, sem servidor e sem etapa de instalação. O detalhe pouco divulgado está na primeira visita: um dos primeiros testadores relatou que a página baixou cerca de 920 MB entre modelo e codec antes de gerar qualquer coisa. Depois disso, o navegador mantém os arquivos em cache.
Use o playground como uma avaliação inicial sem custo: experimente a clonagem e os controles por trechos de texto, depois compare a latência no dispositivo-alvo mais fraco. O comportamento do WebGPU varia entre navegadores, drivers e GPUs.
"Não comemore que 'o TTS em nuvem morreu' toda vez que um modelo pequeno roda no navegador! A compatibilidade do WebGPU entre navegadores e drivers está cheia de armadilhas! Uma demo em inglês que parece ótima não diz nada sobre a sobrevivência do seu texto de produção!" — @GKev1n, usuário real alertando contra substituir TTS hospedado apenas com base em uma demonstração
Se seu público usa celulares antigos, gráficos integrados ou navegadores que não são baseados em Chromium, não extrapole o número do Pixel 9 sem testar.
Clonagem sem transcrição e ajustes palavra por palavra
- Clonagem zero-shot: aceita até 60 segundos de áudio de referência, sem exigir transcrição. O modo de clipe bruto busca o resultado mais natural, enquanto o embedding de locutor pode ser reutilizado e remodelado depois.
- Criação de voz: permite direcionar idade, apresentação masculina ou feminina, sotaques americano, britânico e australiano, além de combinar texturas como suave, rouca, brilhante e grave.
- Controle de interpretação: ritmo, emoção, projeção, vivacidade, excitação e sussurro podem ser ajustados até em trechos de palavras. É possível sussurrar apenas "I didn't say" e manter o restante da frase neutro.
- Edição após a geração: um modelo no estilo VoiceCraft troca palavras depois da síntese preservando voz e configurações. Assim, um nome pronunciado incorretamente não obriga a gerar tudo de novo.
A ressalva da própria Zyphra vale para todos esses recursos: valores de emoção e interpretação são metas, não garantias. Ajustar o ritmo também pode alterar volume e tom; mexer na vivacidade pode modificar tom e duração.
Testes de hardware publicados: velocidade, VRAM e duas armadilhas no Windows
| Configuração | Resultado medido | Fonte |
|---|---|---|
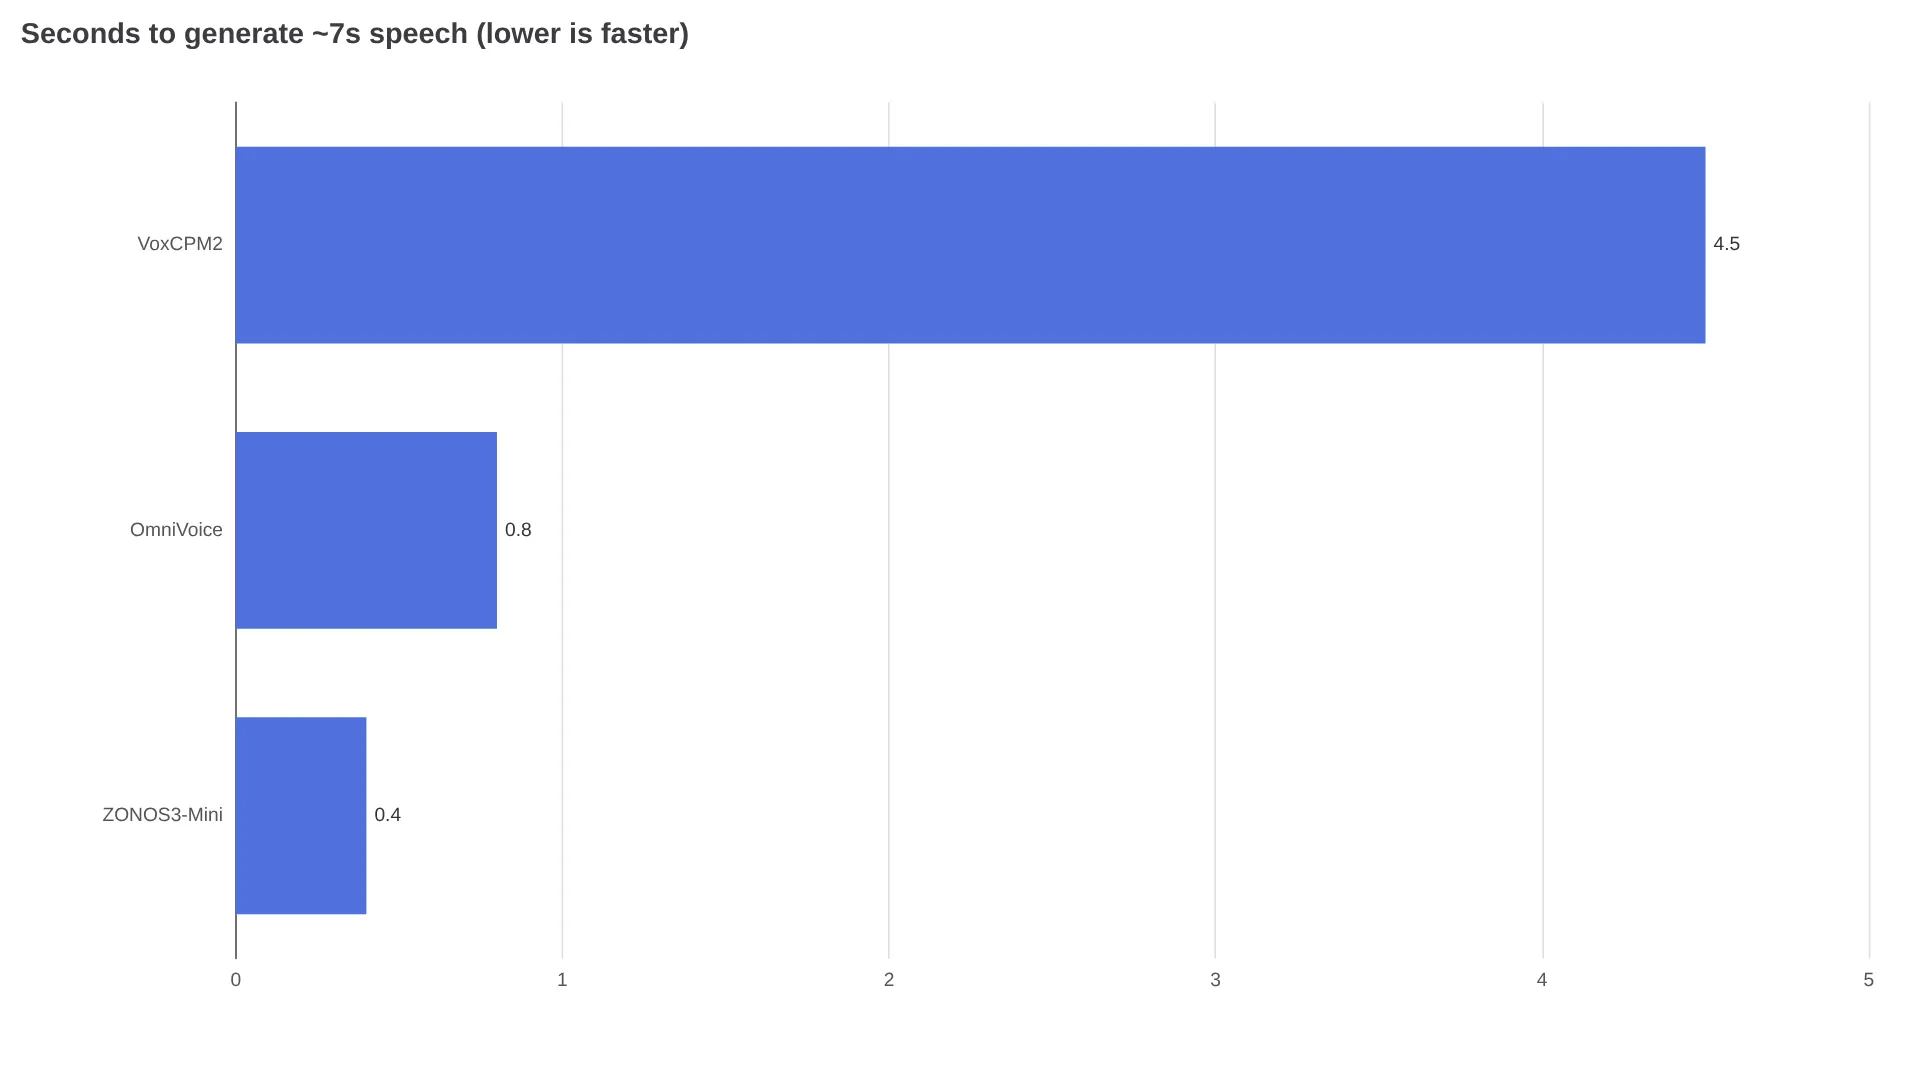
| RTX 5080, ggml quantizado (backbone de 0,66 GB + decodificador de 0,45 GB) | ~7,1 s de fala em japonês em 0,40 s; 2,4 GB de VRAM total — fator de tempo real de 0,056, ~18x mais rápido que o tempo real | Benchmark do VRAM16 |
| Mesmo equipamento: trecho de 31 s; clipe de 7,2 s apenas em CPU | 1,50 s com 2,5 GB na GPU; a CPU levou 1,45 s de processamento (2,38 s do início ao fim) | Benchmark do VRAM16 |
| Mac mini M5 Pro com 64 GB, servidor MLX | 38,5 s de áudio em 2,81 s; 75–100 ms até o primeiro áudio; pico de ~16 GB na primeira clonagem | @pratikg |
O resultado na GPU foi cerca de duas vezes mais rápido que a medição anterior de OmniVoice no mesmo benchmark e ficou muito à frente do fator de 0,63x registrado para o VoxCPM2.
O decodificador completo de 2,2 GB elevou o consumo para 4,2 GB, sem uma conclusão audível que o testador pudesse confirmar. As transcrições feitas pelo Whisper large-v3 corresponderam aos textos pretendidos em japonês e inglês. Isso comprova inteligibilidade, não naturalidade nem semelhança com a voz de referência.
O relato local mais rápido veio de um testador de Apple Silicon, usando o servidor MLX em um Mac mini M5 Pro com 64 GB:
"BENCHMARKED: ... roda até 13,7X mais rápido que o tempo real. Isso foi no meu Mac mini M5 Pro de 64GB, totalmente local com o servidor MLX deles: ~75-100 ms de Time-to-First-Audio (TTFA) usando vozes prontas. Gerou um clipe de áudio de 38,5 s em 2,81 s. Clonou uma nova voz a partir de um clipe de 11-13 s, que então falou após ~1,3 s. ... WER de 0-4%. Usou apenas alguns GB de memória (~16 GB de pico para a clonagem inicial de voz)." — @pratikg, usuário real com conjunto de dados e observações publicados
Há uma condição importante nesse resultado: a clonagem inicial chegou a cerca de 16 GB de memória, enquanto clones em cache rodaram tão rápido quanto as vozes prontas. Para clonar muitos locutores em lote, dimensione a infraestrutura para o pico, não para o consumo estável.
Quem compila o código-fonte no Windows encontra duas armadilhas documentadas pelo testador do VRAM16, que também publicou patches. O compilador da Microsoft rejeitou uma struct cujo membro também se chamava head, embora GCC e Clang a aceitassem. Portanto, com o patch de renomeação fornecido, compile apenas zonos3-cli, zonos3-server e spk-encoder-cli. Separadamente, o Windows japonês envia texto de linha de comando em CP932, e não UTF-8, gerando áudio corrompido até que o programa releia a linha via GetCommandLineW. As requisições JSON para zonos3-server deveriam já estar em UTF-8, mas isso não foi verificado.
Na prática, use um caminho sem espaços ou caracteres não ASCII, como C:\zonos3. Instale o Visual Studio 2022 com ferramentas de C++, além de Git e FFmpeg. Em uma instalação CUDA limpa, espere cerca de cinco minutos, aproximadamente 1,2 GB dos pesos padrão e cerca de 2 GB de CUDA local (notas de instalação).
Quanto custa a API: entendendo os US$ 10 por milhão de bytes UTF-8
A opção hospedada usa um endpoint de fala compatível com OpenAI em https://api.zyphracloud.com/api/v1/audio/speech, com o modelo zyphra/zonos3-mini e um bearer ZYPHRA_API_KEY. O exemplo abaixo inicia um servidor SGLang-Omni local, seguindo o guia do SGLang, e usa o mesmo formato de requisição da API em nuvem. Essa compatibilidade é o ponto central: desenvolva contra localhost e depois troque a URL-base pela Zyphra Cloud.
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
A cobrança é por bytes, não por caractere nem por minuto de áudio: US$ 10,00 por 1 milhão de bytes UTF-8. O plano permite 1 requisição simultânea, 100 gerações por dia, caracteres de entrada ilimitados e os limites de clonagem de 60/120 segundos mencionados acima. Em inglês simples, cada caractere ocupa aproximadamente um byte. Considerando cerca de 800–900 caracteres por minuto falado, US$ 10 rendem algo em torno de 1.100–1.250 minutos, menos de um centavo por minuto. O cálculo pesa mais em textos CJK, porque cada caractere custa cerca de três bytes: aproximadamente 3x por caractere. Execute seus próprios scripts para chegar a um valor por minuto para conteúdo em chinês, japonês ou coreano.
A inferência local ou no navegador tem custo marginal quase zero depois do investimento em hardware. Já o plano hospedado serve bem para protótipos e picos de demanda, mas não sustenta produção em escala com apenas uma requisição simultânea e 100 gerações diárias. Equipes que precisam de volume devem calcular o custo de uma implantação própria em SGLang ou vLLM, em vez de extrapolar a partir dos US$ 10.
Comparação com ElevenLabs, Fish, Qwen e o selo de nº 1
As páginas da Zyphra comparam o ZONOS3-Mini a Fish Audio, Qwen, Cartesia, ElevenLabs e OmniVoice em três roteiros: um monólogo dramático de trailer, um longo trecho cômico de "straight to jail" para testar consistência e uma passagem conversacional no estilo de podcast. Há também um gráfico de Pareto cruzando latência e throughput. Ouça as amostras por conta própria. As páginas oferecem players, mas não declaram um vencedor por escrito, não informam as versões dos modelos concorrentes, as seeds ou se houve configurações equivalentes.
O ranking numérico merece o mesmo cuidado. A avaliação ZTTS2-Eval da Zyphra abrange 35 idiomas limpos e 20 idiomas em contexto real, com 420 itens de métrica por conjunto e idioma. Seu Capability Index coloca o ZONOS3-Mini em primeiro entre os modelos abertos, à frente de Fish S2 Pro e MOSS TTS v1.5. É a fabricante avaliando o próprio trabalho com um teste novo que ela mesma criou. O método é público, mas esta análise não encontrou reprodução independente até a data de publicação. As comparações com modelos fechados são apenas em áudio, sem pontuação compartilhada.
Como a Zyphra não fornece resultados por idioma nem vitórias em testes de escuta independentes, ainda não há comprovação para precisão tonal em mandarim, acento tonal em japonês, caracteres polifônicos e emoção em conteúdos longos. Teste esses pontos antes de assumir um compromisso. A leitura mais honesta é que o ZONOS3-Mini se destaca em eficiência e flexibilidade de implantação, enquanto a liderança em qualidade permanece não comprovada.
Quem deve migrar agora
| Equipe | Veredito | Motivo |
|---|---|---|
| Aplicações offline, no dispositivo ou sensíveis à privacidade, como jogos, leitores e quiosques | Teste agora | Apache 2.0, download padrão de 1,2 GB, 2,4 GB de VRAM, viável em CPU e sem cobrança por minuto |
| Pipeline de audiobooks ou NPCs que exige muitas vozes | Faça um piloto | Controle por palavra e edição após a geração reduzem o custo de refazer o áudio, mas valide a semelhança da clonagem para cada locutor |
| Produção em outros idiomas, sobretudo chinês | Aguarde sua própria avaliação | Não há pontuações da fabricante por idioma; alegações sobre erro de palavras e prosódia são inclinadas ao inglês até que você teste polifonia e tons |
| TTS hospedado com alta simultaneidade | Hospede por conta própria ou mantenha a solução atual | O plano em nuvem limita a 1 requisição simultânea e 100 gerações/dia; SGLang/vLLM é o caminho real para produção |
| Equipes que precisam de marca-d'água ou trilha de auditoria | Espere | Os materiais de lançamento não descrevem marca-d'água nem política de retenção para clipes de referência |
Siga esta ordem de teste: playground no navegador, build local no dispositivo mais fraco e, por fim, API hospedada. Migre apenas se seu hardware atender aos requisitos de 2,4 GB de VRAM e WebGPU, e se seu idioma passar em testes de escuta às cegas. Caso contrário, mantenha sua API fechada e reavalie quando surgirem benchmarks multilíngues independentes.
Perguntas frequentes
Quanta VRAM o ZONOS3-Mini precisa?
Cerca de 2,4–2,5 GB no setup testado com RTX 5080. Com o decodificador completo, foram 4,2 GB; a clonagem inicial no Mac chegou a um pico de ~16 GB.
Ele roda no navegador ou em CPU?
Sim. Via WebGPU, há um download de ~920 MB na primeira visita. No único teste publicado, a síntese apenas em CPU levou cerca de um terço do tempo real, incluindo a inicialização.
Qual é a qualidade da clonagem de voz?
É zero-shot, com até 60 segundos de referência e sem transcrição. Um teste independente registrou 0–4% de erro de palavras, mas a semelhança por locutor exige seu próprio teste de escuta.
O uso comercial é permitido?
Os pesos são Apache 2.0 e o código é MIT, mas você precisa ter direitos ou consentimento para qualquer voz clonada.
Qual é o endpoint e o custo da API?
É o endpoint compatível com OpenAI POST https://api.zyphracloud.com/api/v1/audio/speech, com o modelo zyphra/zonos3-mini, por US$ 10 por milhão de bytes UTF-8 (1 requisição simultânea, 100/dia).
Leitura relacionada: Best Text-to-Speech API, Best Voice Cloning API 2026, Kokoro 82M TTS Local Guide