 AIREITER
Uma descrição “cinematográfica” de uma linha deixa o modelo decidir tudo o que ficou implícito. Sem instruções de câmera, as notas de prompting do provedor indicam que o resultado tende a ser um plano estático; sem campos de som bem definidos, falas e música indesejadas podem aparecer. No MiniMax H3, o prompt funciona mais como um roteiro técnico compacto: os guias oficiais definem um formato fixo de três campos, com timestamps de cenas, IDs consistentes para os locutores e dois campos exclusivos para áudio. Tudo isso ainda precisa caber em um limite de aproximadamente 7.000 caracteres, que varia conforme o provedor, e em vídeos de até 15 segundos.
Antes de escrever: escolha o formato de prompt do H3
O MiniMax mantém dois guias distintos de escrita de prompts no repositório MiniMax-H3 no Hugging Face, cada um voltado a um fluxo de trabalho. O guia base trata de quatro tarefas de geração sem referências enviadas; o guia de referências entra em cena quando uma imagem, vídeo ou áudio enviado influencia o resultado. As quatro tarefas do guia base correspondem a estes modos:
| Modo | Entrada | Instrução de alinhamento obrigatória no prompt |
|---|---|---|
| T2VA | Apenas texto | Nenhuma; comece diretamente pelos campos principais |
| I2VA | Uma imagem de primeiro quadro | "Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1]" |
| FL2VA | Primeiro quadro + último quadro | Picture 1 em 0.00 segundos, Picture 2 no tempo exato de encerramento |
| L2VA | Uma imagem de último quadro | Picture 1 se alinha ao fim do vídeo e à cena final |
Os dois guias terminam com exemplos completos, e o post de lançamento do MiniMax apresenta o modelo sob a mesma lógica: você descreve as relações entre entradas de texto, imagem, vídeo e áudio, em vez de escolher tarefas em um menu. Endpoints hospedados simplificam isso em três fluxos — minimax/h3/text-to-video, image-to-video e reference-to-video no fal —, mas a estrutura do prompt continua igual.
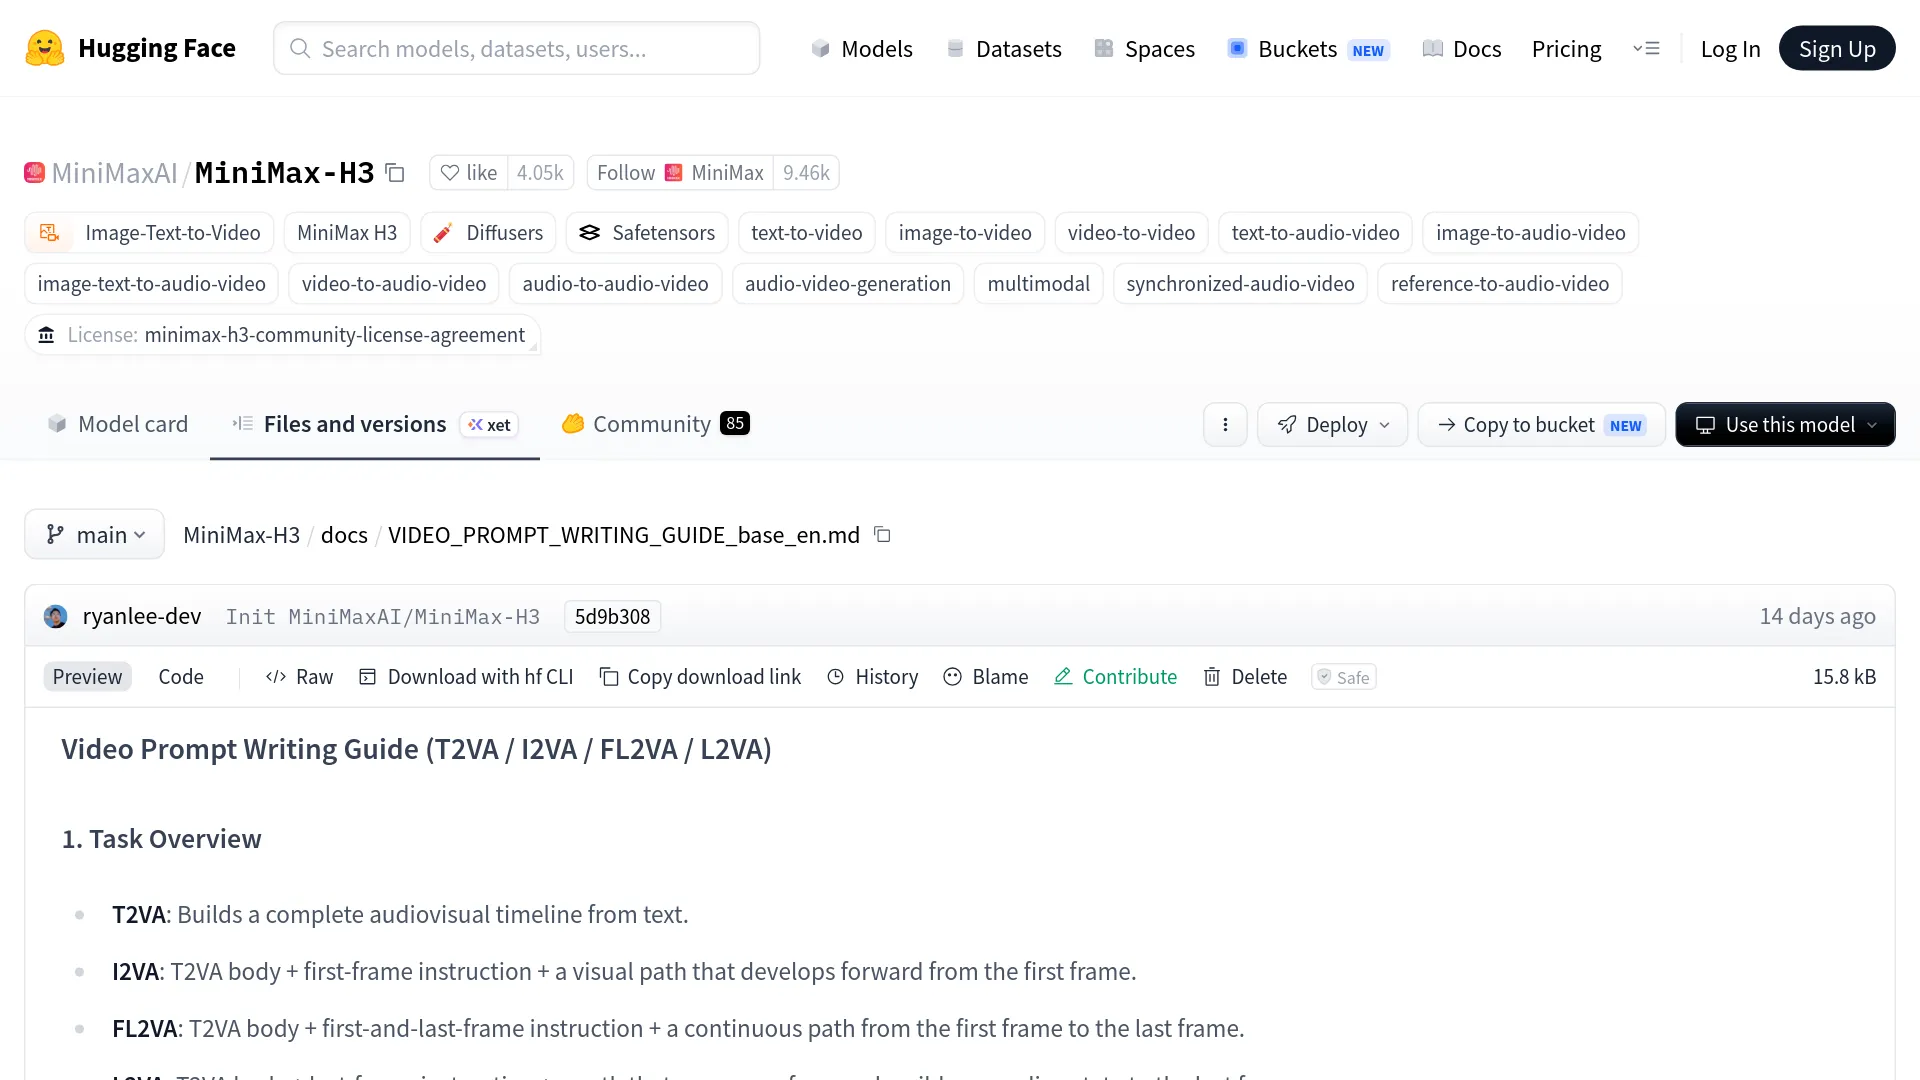
Prompt base do MiniMax H3, campo por campo
Depois da instrução de alinhamento, um prompt MiniMax H3 no modo base tem exatamente três campos obrigatórios, separados por uma linha em branco. A estrutura é esta:
[alignment instruction if I2VA/FL2VA/L2VA]

integrated_multimodal_description: [Shot 1] ...

overall_soundscape: ...

non_diegetic_music: ...integrated_multimodal_descriptioncontém a linha do tempo: estilo visual, composição, ações, mudanças de cena, locutores, diálogos e som diegético — em resumo, tudo o que aparece ou é ouvido na cena.overall_soundscaperesume a ambientação e os sons físicos em 1 a 4 frases, em um único parágrafo e sem diálogo.non_diegetic_musicdescreve a trilha que só o público ouve em 1 a 3 frases, ou recebeN/Aquando não houver música.
Exemplo preenchido, adaptado do caso T2VA do guia oficial, em uma padaria antes do amanhecer:
integrated_multimodal_description: [Shot 1] Live-action, cinematic. A medium-wide
shot of a small bakery interior before sunrise; warm tungsten light, flour dust in
the air. A middle-aged baker (S1), grey apron, rolled sleeves, lifts the security
shutter. The camera pushes in with small amplitude at slow speed as he places
fresh bread on a wooden counter. (S1) says in a warm, mid-pitch voice <d>[English]
First batch of the day.</d> At 00:05.000, the camera cuts to a close-up of his
hands slicing a loaf; (S1)'s words carry over from the previous shot, <scenetrans>
continuing seamlessly across the cut.

overall_soundscape: The rattling shutter, metal trays set down on stone, a doorbell
chime, footsteps on tile, and the crusty sound of a knife slicing bread.

non_diegetic_music: Acoustic guitar and upright bass at a slow tempo, gentle
dynamics fading out before the final shot.
Segundo as regras oficiais, cada trecho controla o seguinte:
| Elemento do prompt | Controla | Regra |
|---|---|---|
[Shot 1] Live-action, cinematic. | Estilo global | O rótulo de estilo abre a Shot 1; exemplos da lista do guia, parcialmente: Cinematic, live-action, 2D-animated, 3D CG, claymation, watercolor, vintage film |
A middle-aged baker (S1), grey apron, rolled sleeves | Identidade do locutor | Os atributos de identidade vêm antes do ID; o ID deve permanecer estável entre as cenas |
The camera pushes in with small amplitude at slow speed | Câmera | Tipo de movimento + amplitude + velocidade, escritos como uma ação natural |
<d>[English] First batch of the day.</d> | Diálogo | Apenas a tag de idioma e as palavras exatas, sem tradução e de forma literal |
At 00:05.000, the camera cuts to... | Momento do corte | Deve aumentar estritamente; a própria [Shot 1] nunca recebe timestamp |
<scenetrans> continuing seamlessly across the cut | Continuidade de áudio | Indica diálogo que atravessa um corte, nos dois pontos conectados |
Como definir cenas, cortes e movimentos de câmera
A sintaxe das cenas no MiniMax H3 depende da posição: [Shot 1] nunca leva timestamp, enquanto todas as cenas seguintes começam com um horário de corte estritamente crescente, como At 00:03.500,. As expressões aprovadas para corte são curtas — “the camera cuts to”, “the shot transitions to” e “the shot switches to”. Dissolvências, fades e wipes só devem aparecer quando você realmente quiser esses efeitos. Se o enquadramento muda pouco, o guia recomenda indicar movimento de câmera em vez de um corte, pois um corte deve introduzir uma nova informação de sujeito, espaço, estado ou tempo.
Descreva o movimento de câmera como uma ação natural em inglês, usando até três dimensões: tipo de movimento, amplitude e velocidade.
| Dimensão | Expressões aceitas |
|---|---|
| Tipo de movimento | Zoom In/Out, Push In/Pull Out, Pan Left/Right, Truck Left/Right, Tilt Up/Down, Pedestal Up/Down, Arc Shot, Tracking Shot, Static Shot, Shake Slightly/Strongly, POV, Roll Clockwise/Counterclockwise |
| Amplitude | "with small amplitude", "with large amplitude" |
| Velocidade | "at slow speed", "at fast speed" |
Por convenção, amplitude média e velocidade normal são omitidas. A diferença entre os termos importa: “Zoom In” altera a distância focal sem mover a câmera, enquanto “Push In” leva a câmera fisicamente para a frente. O guia mantém essa distinção de propósito.
IDs de locutor e regras de diálogo
Todo personagem que fala em um prompt do MiniMax H3 recebe um ID estável — (S1), (S2) ou um composto como (S1,S2) para fala sincronizada — e mantém esse mesmo ID em todas as cenas. Personagens que nunca falam não recebem ID. Na primeira aparição, vale definir identidade suficiente para uma geração consistente: se está em cena ou fora dela, faixa etária, gênero, altura da voz, timbre, ritmo de fala e sotaque.
A sintaxe exata para uma fala é:
A woman in her 30s (S2), on-screen, mid-pitch voice, says with quiet anger
<d>[English] You promised me the 15th.</d>
Quatro regras documentadas evitam os erros mais comuns. Identidade, ação e interpretação ficam fora de <d>; dentro de <d> entram somente a tag de idioma e as palavras exatas, com a pontuação preservada. Para narração, use literalmente a expressão “says in an off-screen voiceover”, seguida imediatamente da informação de que os lábios do personagem em cena permanecem fechados. Um diálogo que cruza um corte precisa de <scenetrans> nos dois pontos ligados, além de uma frase de continuidade como “continues seamlessly across the cut” ou “carries over from the previous shot”. Se a fala for interrompida pelo fim do vídeo, use <cutoff>.
As aspas têm uma única função reservada: todo texto visível no vídeo — banners, placas, rótulos, néon ou legendas — deve aparecer entre aspas duplas em inglês, literalmente e sem tradução. Colocar falas entre aspas é, segundo a documentação, o motivo de o H3 renderizá-las como legendas gravadas no vídeo em vez de fala.
Os dois campos dedicados ao áudio
O post de lançamento do MiniMax informa que todo o áudio do H3 é estéreo nativo e gerado junto com o vídeo. Por isso, o som recebe dois campos próprios em vez de meros adjetivos na descrição. overall_soundscape cobre ambiente e sons físicos — vento, chuva, trânsito, passos, movimento de tecidos, impactos, respiração e risadas — em 1 a 4 frases; N/A fica reservado para um pedido explícito de silêncio completo. Já non_diegetic_music define a trilha que os personagens não escutam, com instrumentação, velocidade, ritmo e mudanças de dinâmica. Palavras abstratas de clima, como “epic” e “emotional”, são explicitamente desaconselhadas; quando não quiser trilha, o valor correto é N/A.
Áudio diegético, como alguém cantando, um rádio na cena ou um músico de rua, não pertence a nenhum desses campos. Ele deve ficar em integrated_multimodal_description, onde está a linha do tempo. Essa divisão não é apenas estética: o guia da APIMODELS observa que resultados confiáveis exigem restrições explícitas de som, e deixar non_diegetic_music indefinido pode introduzir música que você nunca pediu.
Prompts com referências: rótulos e retenção
O guia de referências deve ser usado assim que arquivos enviados passarem a orientar a geração. Ele exige seis seções, nesta ordem fixa: subject_definitions, summary, retention_analysis, detailed_description, overall_soundscape, non_diegetic_music. Em tarefas de geração, o corpo de detailed_description normalmente tem de 350 a 500 palavras em inglês. Prompts com muito diálogo devem acomodar toda a linha do tempo falada, mesmo que isso altere a contagem esperada.
O trabalho é feito por quatro tipos de rótulo:
| Rótulo | Uso |
|---|---|
<Subject N> | Conteúdo visível usado de fato na saída: pessoa, produto, cenário, roupa, estilo ou ação abstraída de qualquer ativo |
<Picture N> | Imagem usada como âncora concreta de quadro — primeiro quadro, keyframe, último quadro ou âncora de composição |
<Video N> | Relação com um vídeo inteiro: fonte de edição, ponto de continuação, estrutura de câmera ou cortes, ritmo |
<Audio N> | Sinal de áudio copiado ou referenciado: timbre de voz, letra, batidas ou efeitos sonoros |
A numeração é independente para cada tipo. Assim, um vídeo enviado pode ser <Video 1>, enquanto sua faixa de áudio é <Audio 2>. Quando um sujeito fala, combine o rótulo com o ID de locutor: <Subject 3> (S1).
A seção summary começa com um prefixo de tarefa entre colchetes, como [reference generation] ou [video editing + audio reuse]. Em uma edição de vídeo, ela deve começar com “The target video is an edited version of <Video 1>.” Depois, retention_analysis atribui um marcador a cada rótulo: para elementos visuais, fully_preserved, partially_preserved, attribute_transfer ou weak_reference; para áudio, fully_copy, partially_copy, reference ou weak_reference. São esses marcadores que informam ao H3 que o rosto precisa ser preservado, mas a roupa pode mudar.
Estrutura mínima documentada para o modo de referências:
subject_definitions:
<Subject 1>: the woman from Picture 1, long blonde hair, light-pink shirt
<Picture 1>: first frame of [Shot 1], café window seat
<Audio 1>: voice-timbre reference for <Subject 1> (S1)

summary: [reference generation + audio reference] One short paragraph naming the
task, the target video, and each reference relationship.

retention_analysis:
<Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved, same face, hair, outfit
<Picture 1> ([Shot 1] first frame): fully_preserved
<Audio 1> (S1 voice): reference, timbre only, no copied words

detailed_description: [1–2 style sentences.] [Shot 1] ... [350–500 words, dialogue
in <d> tags, <scenetrans> across cuts]

overall_soundscape: [Ambience and physical sounds.]

non_diegetic_music: N/A
Quando o H3 erra: causas e correções
| Sintoma | Possível causa no prompt | Como corrigir |
|---|---|---|
| Áudio sem sentido ou “idioma de The Sims” inventado | Diálogo sem estrutura, ausência de IDs de locutor ou personagens silenciosos não descritos | Adicione IDs (S1)/(S2), envolva as palavras exatas em <d>[Language] ...</d> e descreva explicitamente personagens silenciosos como não falantes |
| Legendas gravadas sobre o diálogo | Falas escritas entre aspas | Deixe aspas exclusivamente para texto visível em cena e mova o diálogo para tags <d> |
| Diálogo atribuído ao personagem errado | ID de locutor não vinculado a uma pessoa descrita | Na primeira aparição, informe atributos de identidade do locutor — idade, presença em cena e voz — e mantenha o ID nas demais cenas |
| Trilha ou música não solicitada | non_diegetic_music ausente ou vago | Use non_diegetic_music: N/A quando não quiser música; discussões da comunidade apontam isso como uma solução para eliminar áudio indesejado |
| Cortes não planejados | Mudanças de cena sugeridas sem timestamps | Use [Shot N] At 00:03.500 com frases explícitas de corte; em tomadas únicas, peça “no cuts” |
| Rosto, roupa ou produto mudam ao longo do vídeo | O papel da referência nunca foi declarado | Adicione uma linha em retention_analysis com fully_preserved para esse rótulo e repita o rótulo a cada aparição |
As linhas sobre áudio sem sentido e legendas vêm diretamente das regras de sintaxe oficiais. Discussões da comunidade no r/StableDiffusion relatam de forma independente que as mesmas correções funcionam na prática, incluindo non_diegetic_music: N/A como uma das soluções mais citadas para áudio indesejado.
Limites do modelo e custo para testar prompts
O limite de geração importa porque o espaço do prompt é finito e cada tentativa tem custo. Estes são os limites documentados na API oficial e em provedores hospedados:
| Parâmetro | Valor | Observação |
|---|---|---|
| Duração do clipe | Até 15 s, em segundos inteiros | O mínimo é 5 s nos endpoints fal/EvoLink; alguns documentos da API V2 indicam 4 s |
| Resolução | 768p e 2K, 24 FPS | Segundo o MiniMax, 2K é a resolução padrão de saída |
| Arquivos de referência | Até 9 imagens, 3 vídeos e 3 áudios | 12 arquivos no total; áudio nunca pode ser a única referência |
| Tamanho do prompt | ~7.000 caracteres | Documentação do fal e da API V2; a APIMODELS informa 20.480 — confirme com seu provedor |
| Proporções de tela | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16, adaptativa | Image-to-video segue a proporção da imagem de entrada |
Os preços variam por provedor, então considere estes valores como registros pontuais, não como tabela permanente. No fal, uma geração em 2K custava US$ 0,26 por segundo em um registro de preços de 1º de agosto — US$ 1,30 por 5 segundos e US$ 3,90 por 15 —, com as cinco primeiras imagens de referência grátis e imagens extras a US$ 0,08 cada. Na APIMODELS, o H3 custa US$ 0,088 por segundo — US$ 1,32 por um clipe de 15 segundos — e cobra apenas requisições bem-sucedidas. Como contexto, veja os preços por segundo no mesmo marketplace:
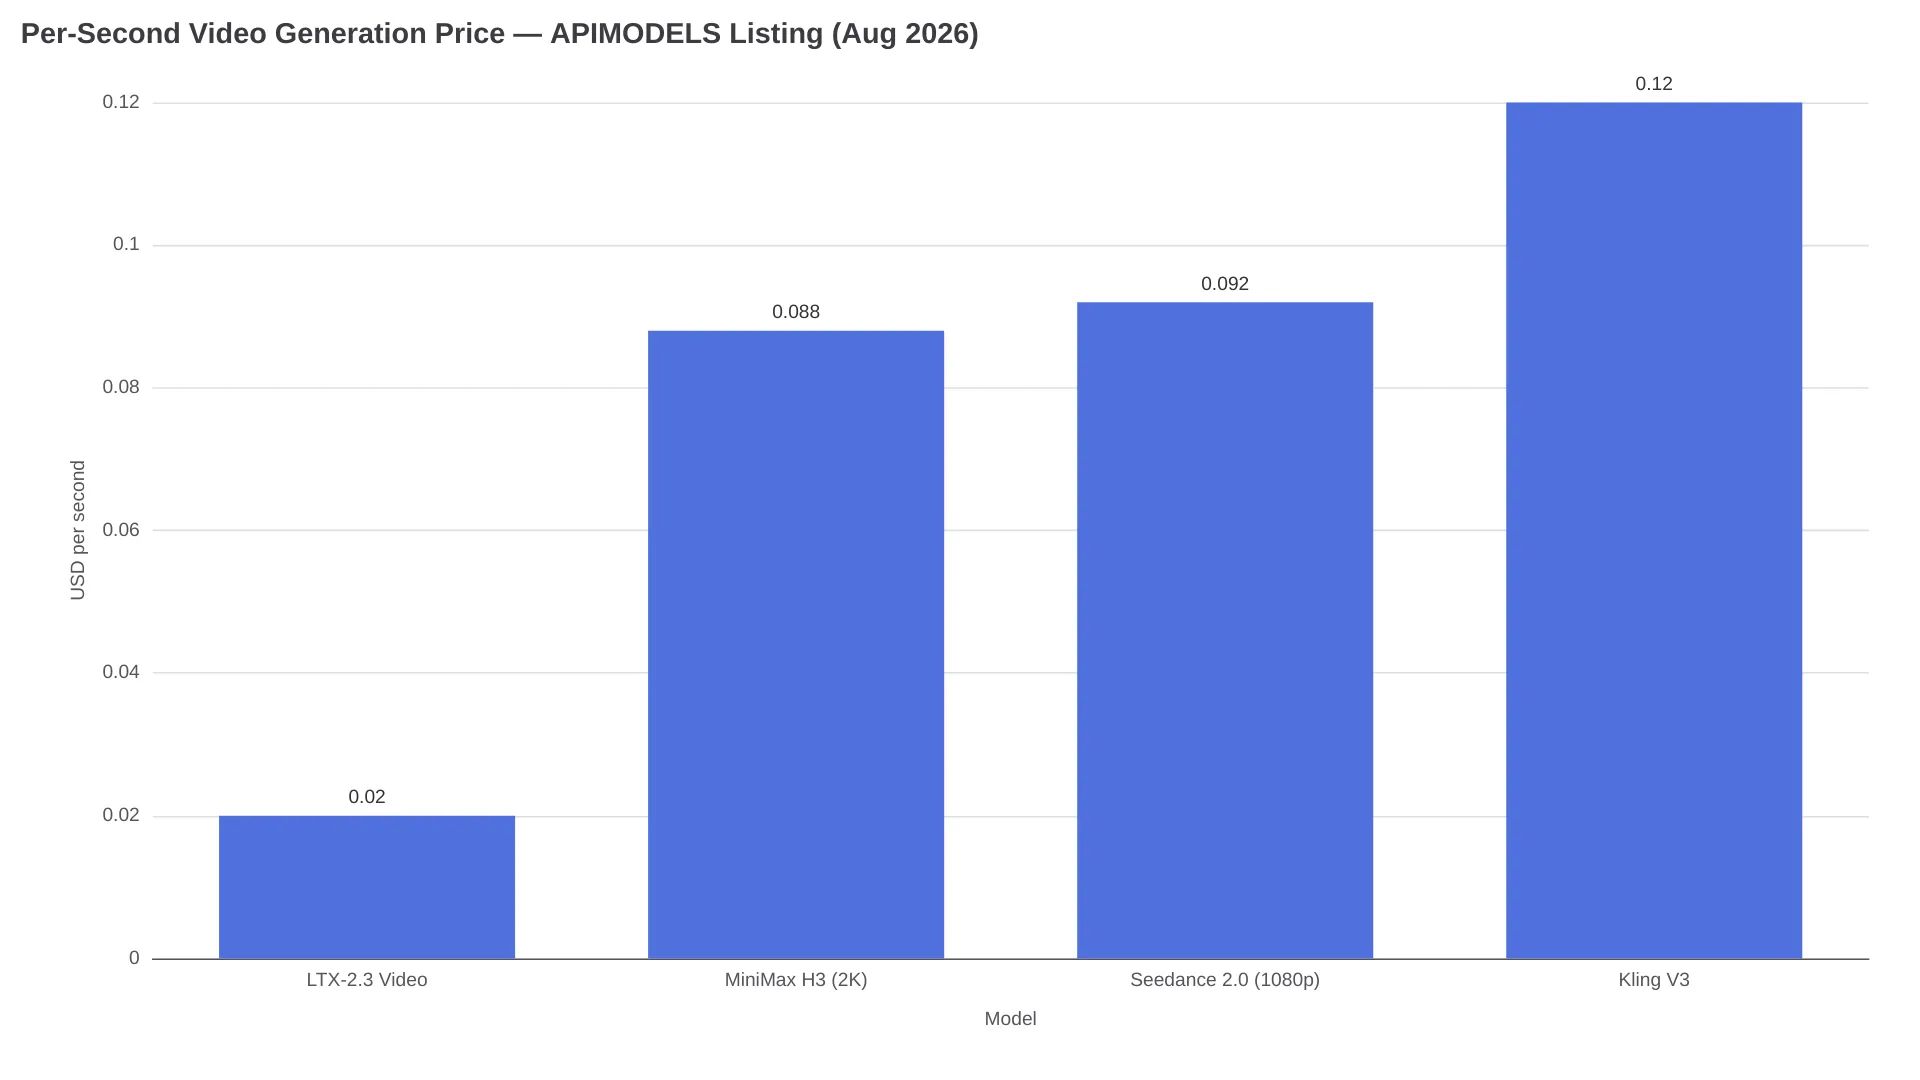
O custo real está nas tentativas: um prompt estruturado de diálogo com 15 segundos que acerta na segunda geração custa US$ 2,64 na APIMODELS. Já um prompt sem estrutura que exige cinco tentativas para render uma tomada aproveitável chega a US$ 6,60. Para iterar prompts em um endpoint H3 hospedado, a página da API MiniMax H3 da AIReiter executa o modelo e mostra os preços atuais na própria página.
Modelos prontos para copiar e colar
Estas duas estruturas base cobrem a maioria dos trabalhos curtos. Preencha os colchetes e mantenha os nomes dos campos e as linhas em branco exatamente como estão:
integrated_multimodal_description: [Shot 1] [style label]. [Composition and
subject with 1–2 identity details]. [One primary action with physically
plausible pacing]. The camera [motion type] with [amplitude] at [speed].
[Character description] (S1) says in [voice description] <d>[Language]
[exact line]</d>. At [MM:SS.mmm], the camera cuts to [new subject or space],
[continuity phrase if dialogue crosses the cut].

overall_soundscape: [Ambience + physical action sounds, 1–4 sentences.]

non_diegetic_music: [Instrumentation, tempo, dynamics] or N/A
Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1].
integrated_multimodal_description: [Shot 1] [Style consistent with Picture 1].
The scene, subject, colors, and spatial relationships of Picture 1 remain
consistent. [Action developing forward from the first frame → result or
reaction]. The camera [motion type] with [amplitude] at [speed].
overall_soundscape: [Ambience and action sounds grounded in the image.]
non_diegetic_music: N/APara encontrar prompts testados, e não apenas campos em branco, há três bibliotecas que mantêm links para as fontes. ecomimagelab/awesome-minimax-h3-prompts: 58 prompts, sendo 39 oficiais e 19 testados pela comunidade, todos acompanhados de vídeo de resultado para download sob a regra “No video, no entry.” imagineVid/Awesome-minimax-h3-prompts-and-skills: 28 casos verificados em seis fluxos, da continuidade de identidade por omni-reference ao diálogo com áudio nativo. A galeria da APIMODELS: 226 prompts navegáveis por caso de uso e acompanhados de clipes; sua regra em uma linha é “References carry identity, the prompt carries action.”
Também há dois atalhos para escrever os roteiros. Usuários do Reddit relatam bons resultados ao colar um guia oficial em um LLM e informar o modo desejado, como “rewrite this idea as T2VA using the base guide”. E a extensão para ComfyUI MiniMax H3 Prompt Writer v0.3 monta o formato estruturado dentro de um fluxo baseado em nós.
Perguntas frequentes
Qual é a diferença entre os guias base e de referências do MiniMax H3?
O guia base cobre quatro modos sem referências — T2VA, I2VA, FL2VA e L2VA — construídos sobre três campos principais. Já o guia de referências adiciona seis seções obrigatórias e rótulos <Subject>/<Picture>/<Video>/<Audio> sempre que imagens, vídeos ou áudios enviados orientam a geração.
Como identificar locutores em um prompt do MiniMax H3?
Atribua IDs estáveis, como (S1) e (S2), na ordem do primeiro evento vocal; mantenha o mesmo ID entre as cenas; use (S1,S2) para falas simultâneas; e deixe dentro das tags <d> somente a tag de idioma e as palavras exatas.
Como evitar áudio sem sentido no MiniMax H3?
Estruture os diálogos com IDs de locutor e tags <d> literais, descreva personagens que não falam como silenciosos e defina non_diegetic_music: N/A quando não quiser trilha. Essas são as correções documentadas e confirmadas pela comunidade.
O diálogo do MiniMax H3 deve ficar entre aspas?
Não. As aspas são reservadas para texto visível no vídeo. Falas devem ficar em <d>[Language] ...</d>; caso contrário, o H3 pode renderizá-las como legendas na tela.
Qual é o tamanho máximo de um prompt no MiniMax H3?
Cerca de 7.000 caracteres no fal e nos documentos oficiais da API V2, embora a APIMODELS informe 20.480. Confirme o limite do endpoint específico antes de escrever um roteiro de 10.000 caracteres.
O que a sintaxe ainda não resolve
Estrutura aumenta a taxa de acerto, mas não torna a geração determinística. Fidelidade exata de identidade, logotipo e produto continua sendo probabilística: wrappers de API mantidos pela comunidade se recusam explicitamente a prometer consistência em nível de quadro, e os melhores exemplos de bibliotecas de prompts reforçam identidade com blocos extensos de restrições, não com garantias mensuradas. Tags inline <tags> para sons não verbais são experimentais na comunidade e podem variar entre gerações. Avalie o resultado pelo custo por segundo aprovado, não pelo custo por requisição, e mantenha os guias oficiais base e de referências abertos enquanto escreve.
Leitura relacionada: a visão geral do lançamento do MiniMax H3 explica o que é o modelo, e MiniMax H3 vs LTX 2.3 o compara à alternativa mais barata por segundo.